


はじめに
Markdown は AI との相性もよく、文書作成に幅広く用いられています。
しかし、お客さまへの納品を行うことを考えると、PDF が選択されることが多いです。
この Markdown to PDF 処理について、npm でも多数公開されており、 node.js などのプログラムから利用可能となっています。
今回、セキュリティ事業部でもレポートの自動生成にあたり、これらのライブラリを調査しました。
そのなかで、問題がいくつか判明しました。
課題に対応するため、新しく PDF 変換ライブラリ remark-pdfmake を公開したので、それを紹介します。
サンプル
詳細: https://github.com/iret-m-nakamura/remark-pdfmake/tree/main/sample
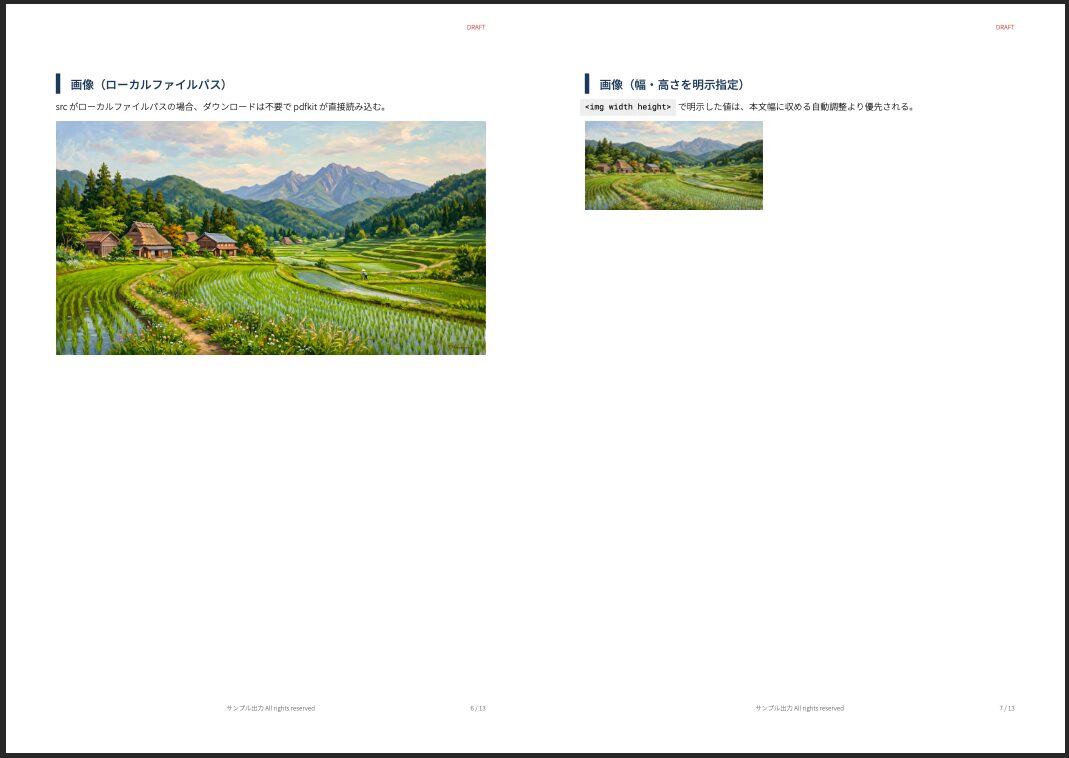
実際に、テストで提示している Markdown と、それが変換された後の画像を載せます。
Markdown から適切に PDF 変換されていることがわかります。
## 画像(ローカルファイルパス) src がローカルファイルパスの場合、ダウンロードは不要で pdfkit が直接読み込む。  ## 画像(幅・高さを明示指定) `<img width height>` で明示した値は、本文幅に収める自動調整より優先される。 <img src="sample.jpeg" width="200" height="100">
PDF 変換について
PDF 変換は、大きく2つの変換過程を行わなければなりません。
Markdown to HTML および HTML to PDF です。
Markdown は、その内部要素に HTML を記述できます。
例えば <br> や <small>...</small> などです。
そもそも、Markdown が表現できない要素は HTML として表すという設計思想であるため、HTML を経由することは必須であると考えています。
Markdown 自体も多くの方言があり、それらに対応する必要も出てきています。
Markdown to HTML を実現するライブラリとして有名なのが、remark などの汎用ライブラリです。
HTML to PDF は、HTML として出力された文書を PDF に変換する過程です。
HTML 要素になるということは、CSS によるスタイル指定が含まれるため、これらを正確に表現するにはブラウザの力を借りる必要があります。
そのため、調査したなかで多くのライブラリでは Headless Browser (puppeteer 等) を利用して HTML レンダリングによる変換を行っていました。
PDF 変換の問題について
これらの変換において、大きく2つの問題が顕在化しました。
それらについて説明します。
自動処理との相性
Markdown to PDF をプログラムで実施したいニーズの背景には、自動処理で実施したいというものがあります。
しかし、Headless Browser は、多くの共有ライブラリやフォントなどの依存が存在し、コンテナ内での実行と相性がよくありません。
そのため、自動化処理を前提で考えるならば、Headless Browser との依存を無くすことが必要でした。
ライセンス関係の不備
次に発覚したのが、フォントのライセンス違反です。
Markdown to PDF を手元で実施し、調査したところ、Hiragino や Osaka などの組み込み禁止のクライアント側フォントを PDF に組み込んでいました。
これは、Headless Browser が HTML の表示に組み込みフォントを利用し、組み込みフォントの見た目自体を PDF に変換したための不備です。
お客さまへ PDF を納品することを考えると、これらのライセンス違反状態は見過ごせないものでした。
ライブラリ化の方針
今回、自動化のためのライブラリを検討するにあたり、車輪の再発明を行わないことを大方針としてプログラムを作成しました。
具体的には、既存の枠組みの中で、あるものは使う、ないものは作るという方針です。
その方針に従い、以下の切り分けを行いました。
- Markdown 変換、方言の吸収、HTML 変換などの前処理
- unified エコシステム内のライブラリを直接利用
- HTML 変換された構造木 (
hast) だけを唯一の入力にする
- 組版などの PDF 化を含む後処理
- pdfmake による組版システムをそのまま利用
- PDF 作成、フォント組み込みなど、変換をそのまま利用する
この枠組みのため、今回作成するレイヤーは unified hast から pdfmake docDefinition に対する変換処理だけとなります。
markdown --(remark-parse, remark-gfm)--> mdast
        --(remark-rehype + rehype-raw)--> hast
        --(rehypeToDdast)--> ddast
        --(styleTransform + theme)--> ddast (styled)
        --(pdfmakeCompiler)--> docDefinition
        --(pdfmake)--> PDF
この決定により、作成する領域の明確化および省力化が行えました。
開発及び公開
開発は、Claude Code を用いて、テストドリブンおよび、意味による明確な分離をもって実施しました。
これにより、ライブラリは以下の公開パッケージにより構成されました。
- remark-pdfmake
- Markdown から PDF に対する変換
- ddast
- pdfmake の定義に対する unified ast 構造
- rehype-ddast
- hast から ddast に対する構造変換のみ
- ddast-util-style
- 文書としての Style による変換
- ddast-util-to-pdfmake
- ddast から pdfmake docDefinition に対する変換
- pdfmake-render
- pdfmake による PDF 生成
利用方法は簡単で、実行するプログラム側で依存ライブラリに追加し、利用するだけです。
問題になった組み込みフォントライセンスも、SIL OFL など PDF への埋め込みが許可されたフォントを指定すれば、違反を避けられます。
npm i remark-pdfmake
import { markdownToDocDefinition, renderToFile, loadFonts, DEFAULT_THEME } from "remark-pdfmake";

// fonts
const fonts = await loadFonts(fontCacheDir, {
  MyFont: { normal: { filename: "MyFont-Regular.ttf", url: "https://example.com/MyFont-Regular.ttf" } },
});

// Markdown to docDefinition
const dd = markdownToDocDefinition(markdown, {
  defaultStyle: { font: "MyFont", fontSize: 10 },
  theme: DEFAULT_THEME,
});
dd.pageSize = DEFAULT_THEME.page.size;
dd.pageMargins = DEFAULT_THEME.page.margins;

// Output
await renderToFile(dd, fonts, "output.pdf", {
  localAccessPolicy: (path) => path.startsWith(fontCacheDir),
  urlAccessPolicy: () => false,
});
まとめ
Markdown を PDF に変換するため、HTML から docDefinition に変換して処理するというアイディア自体はかなり前から持っていました。
しかし、その実装は unified エコシステムに対する理解や、単調なコードを記述するといったコストの高い作業で後回しになっていました。
Claude Code を用いることで、これらのコードを簡単に作成することができました。
Markdown を組版システムで PDF 化する手段として、ぜひご活用いただければと思います。
 簡単30秒