


記事のポイント
- AIエージェントごとに個別のRAGを構築する方法から、企業全体でナレッジベースを共有し、エージェントが必要なコンテキストを取得するアーキテクチャへの変化が紹介された
- Foundry IQのKnowledge GraphではEntity GraphとTopic Graphを利用し、従来の検索では回答が難しかった集計や関係性の分析、複数文書を横断した情報の取得を支援する
- Microsoft Retriever 1による検索の低遅延化やFoundry IQ Serverless、SharePointのアクセス権限継承など、検索品質とコスト、エンタープライズ運用に関する機能が発表された
はじめに
この記事ではMicrosoft Ignite 2026のBRK297セッション「The shift from RAG to context: Grounding agents with Foundry IQ」の内容を整理しています。実際にセッションを視聴した内容をもとに、個人の見解を交えて紹介します。
本セッションの注目ポイントはAIエージェントごとに個別のRAGを実装するのではなく、企業全体で知識を共有するアーキテクチャへの変化です。
従来のRAGでは、特定のアプリケーションやAIエージェントが参照する文書を用意し、検索インデックスを構築して利用する方法が多く採用されてきました。
しかし、複数のAIエージェントを利用するようになるとそれぞれのエージェントが独立したナレッジベースを持つ構成ではデータの重複や検索ロジックの管理が課題になります。特に汎用的なAIエージェントの場合、最初から参照先のデータを固定することが難しく、タスクに応じて適切な情報源を選択する必要があります。こうした課題に対してMicrosoft IQとFoundry IQを組み合わせた構成が紹介されました。
さらにKnowledge Graphや専用の検索モデルを利用することで、従来のRAGでは回答が難しかった質問に対応し、検索品質とトークン効率を改善する取り組みも発表されています。
なお、セッション内に登場するサービスには一般提供が開始されたものやプレビュー段階のものが含まれます。本番環境での利用を検討する際には最新の公式ドキュメントで提供状況や制約を確認してください。
セッション概要
- セッション名:BRK297 The shift from RAG to context: Grounding agents with Foundry IQ
- 時間:16:30〜17:15
- 会場:Moscone West / Level 3 / Room 3004
BRK297:The shift from RAG to context: Grounding agents with Foundry IQ
従来のアプリケーション単位で構築するRAGから複数のAIエージェントが共有できるコンテキスト基盤への変化を扱うセッションです。Foundry IQを中心に検索技術、Knowledge Graph、専用モデルなどを利用して、AIエージェントに信頼できる企業内の情報を提供する仕組みが紹介されました。
ナレッジベースの構築方法やServerlessによるコスト管理、SharePointなどのデータソースからアクセス権限を継承する機能についても説明がありました。
このセッションを知るための前提知識
RAG(Retrieval-Augmented Generation)
検索拡張生成、RAGは外部の知識ベースやドキュメントを検索し、その情報をもとに生成モデルが回答を生成する手法です。生成モデルが事前学習で獲得した知識に加えて、検索した情報をコンテキストとして与えることで、企業固有の情報や更新頻度の高い情報を回答へ反映できます。
代表的な構成では文書をチャンクに分割して検索インデックスへ登録し、ユーザーからの質問に関連するチャンクを取得してLLMへ渡します。
ただし、回答に必要な情報が複数の文書へ分散している場合や、すべての関連情報を網羅する必要がある場合には、単純な検索だけでは正確に回答できないことがあります。
Knowledge Graph(ナレッジグラフ)
Knowledge Graphはエンティティと関係性を使い、知識をグラフ構造で表現する仕組みです。例えば、組織、製品、担当者などをエンティティとして定義し、それぞれが提供する製品や所属する組織などの関係性を管理できます。文書内に存在する情報を構造化することで、複数の文書にまたがる関係の検索や集計などに利用できます。
Microsoft IQ
Microsoft IQは、組織が保有するデータや業務コンテキストをAIエージェントから利用できるようにするためのエンタープライズ向けプラットフォームです。Work IQ、Fabric IQ、Foundry IQ、Web IQなどの仕組みを組み合わせ、さまざまな情報源をAIエージェントへ提供します。
Opening Keynoteでは総称だったMicrosoft IQですが、今回は製品として語られていました。Microsoft IQが組織全体の知識基盤への入口として紹介され、その中でも非構造化データを扱うFoundry IQについて詳しく説明されました。
Foundry IQ
Foundry IQは企業内の知識をナレッジベースとして整理し、AIエージェントが利用できるようにするコンテキスト基盤です。キーワード検索やベクトル検索、セマンティックランキング、Agentic Retrievalなどを組み合わせ、質問に必要な情報を取得します。今回のMicrosoft Ignite 2026では、Knowledge Graphや専用検索モデル、Serverlessなどの機能が紹介されました。
Azure AI Search
Azure AI Searchは、フルテキスト検索、ベクトル検索、ハイブリッド検索などを提供するフルマネージドの検索サービスです。以前はAzure Cognitive Searchという名称で提供されていましたが、2023年11月にAzure AI Searchへ名称が変更されました。
本セッションではAzure AI Searchで培われた検索技術をFoundry IQの一部として提供し、より広いコンテキスト取得の用途へ拡張していることが説明されました。
セッション本編
アプリケーションごとのRAGから企業全体のコンテキストへ
セッションの冒頭ではAIエージェントの構築方法がどのように変化しているのかについて説明がありました。これまでのAIエージェントは特定の目的に合わせて構築されることが多くありました。
FAQへ回答するエージェントであれば、FAQに関連する文書を用意して検索インデックスを構築し、エージェントからそのインデックスを参照する構成です。別の業務を担当するエージェントを作る場合には、そのエージェントに必要なデータと検索処理を改めて構築することになります。
しかし、AIモデルやAgent Harnessの進化によってさまざまなタスクに対応する汎用的なエージェントも登場しています。こうしたエージェントは、特定のデータセットだけを利用するとは限りません。
例えば、Microsoft Copilotが企業内の業務を支援する場合、Microsoft 365の文書やメール、会議の記録だけでなく、業務システムのデータや外部サービスの情報なども参照する必要があります。そのため、あらかじめエージェントごとに利用する情報源を固定する方法では対応しにくくなります。
ここで登壇者が説明したのが、エージェントとコンテキストを分離するという考え方です。
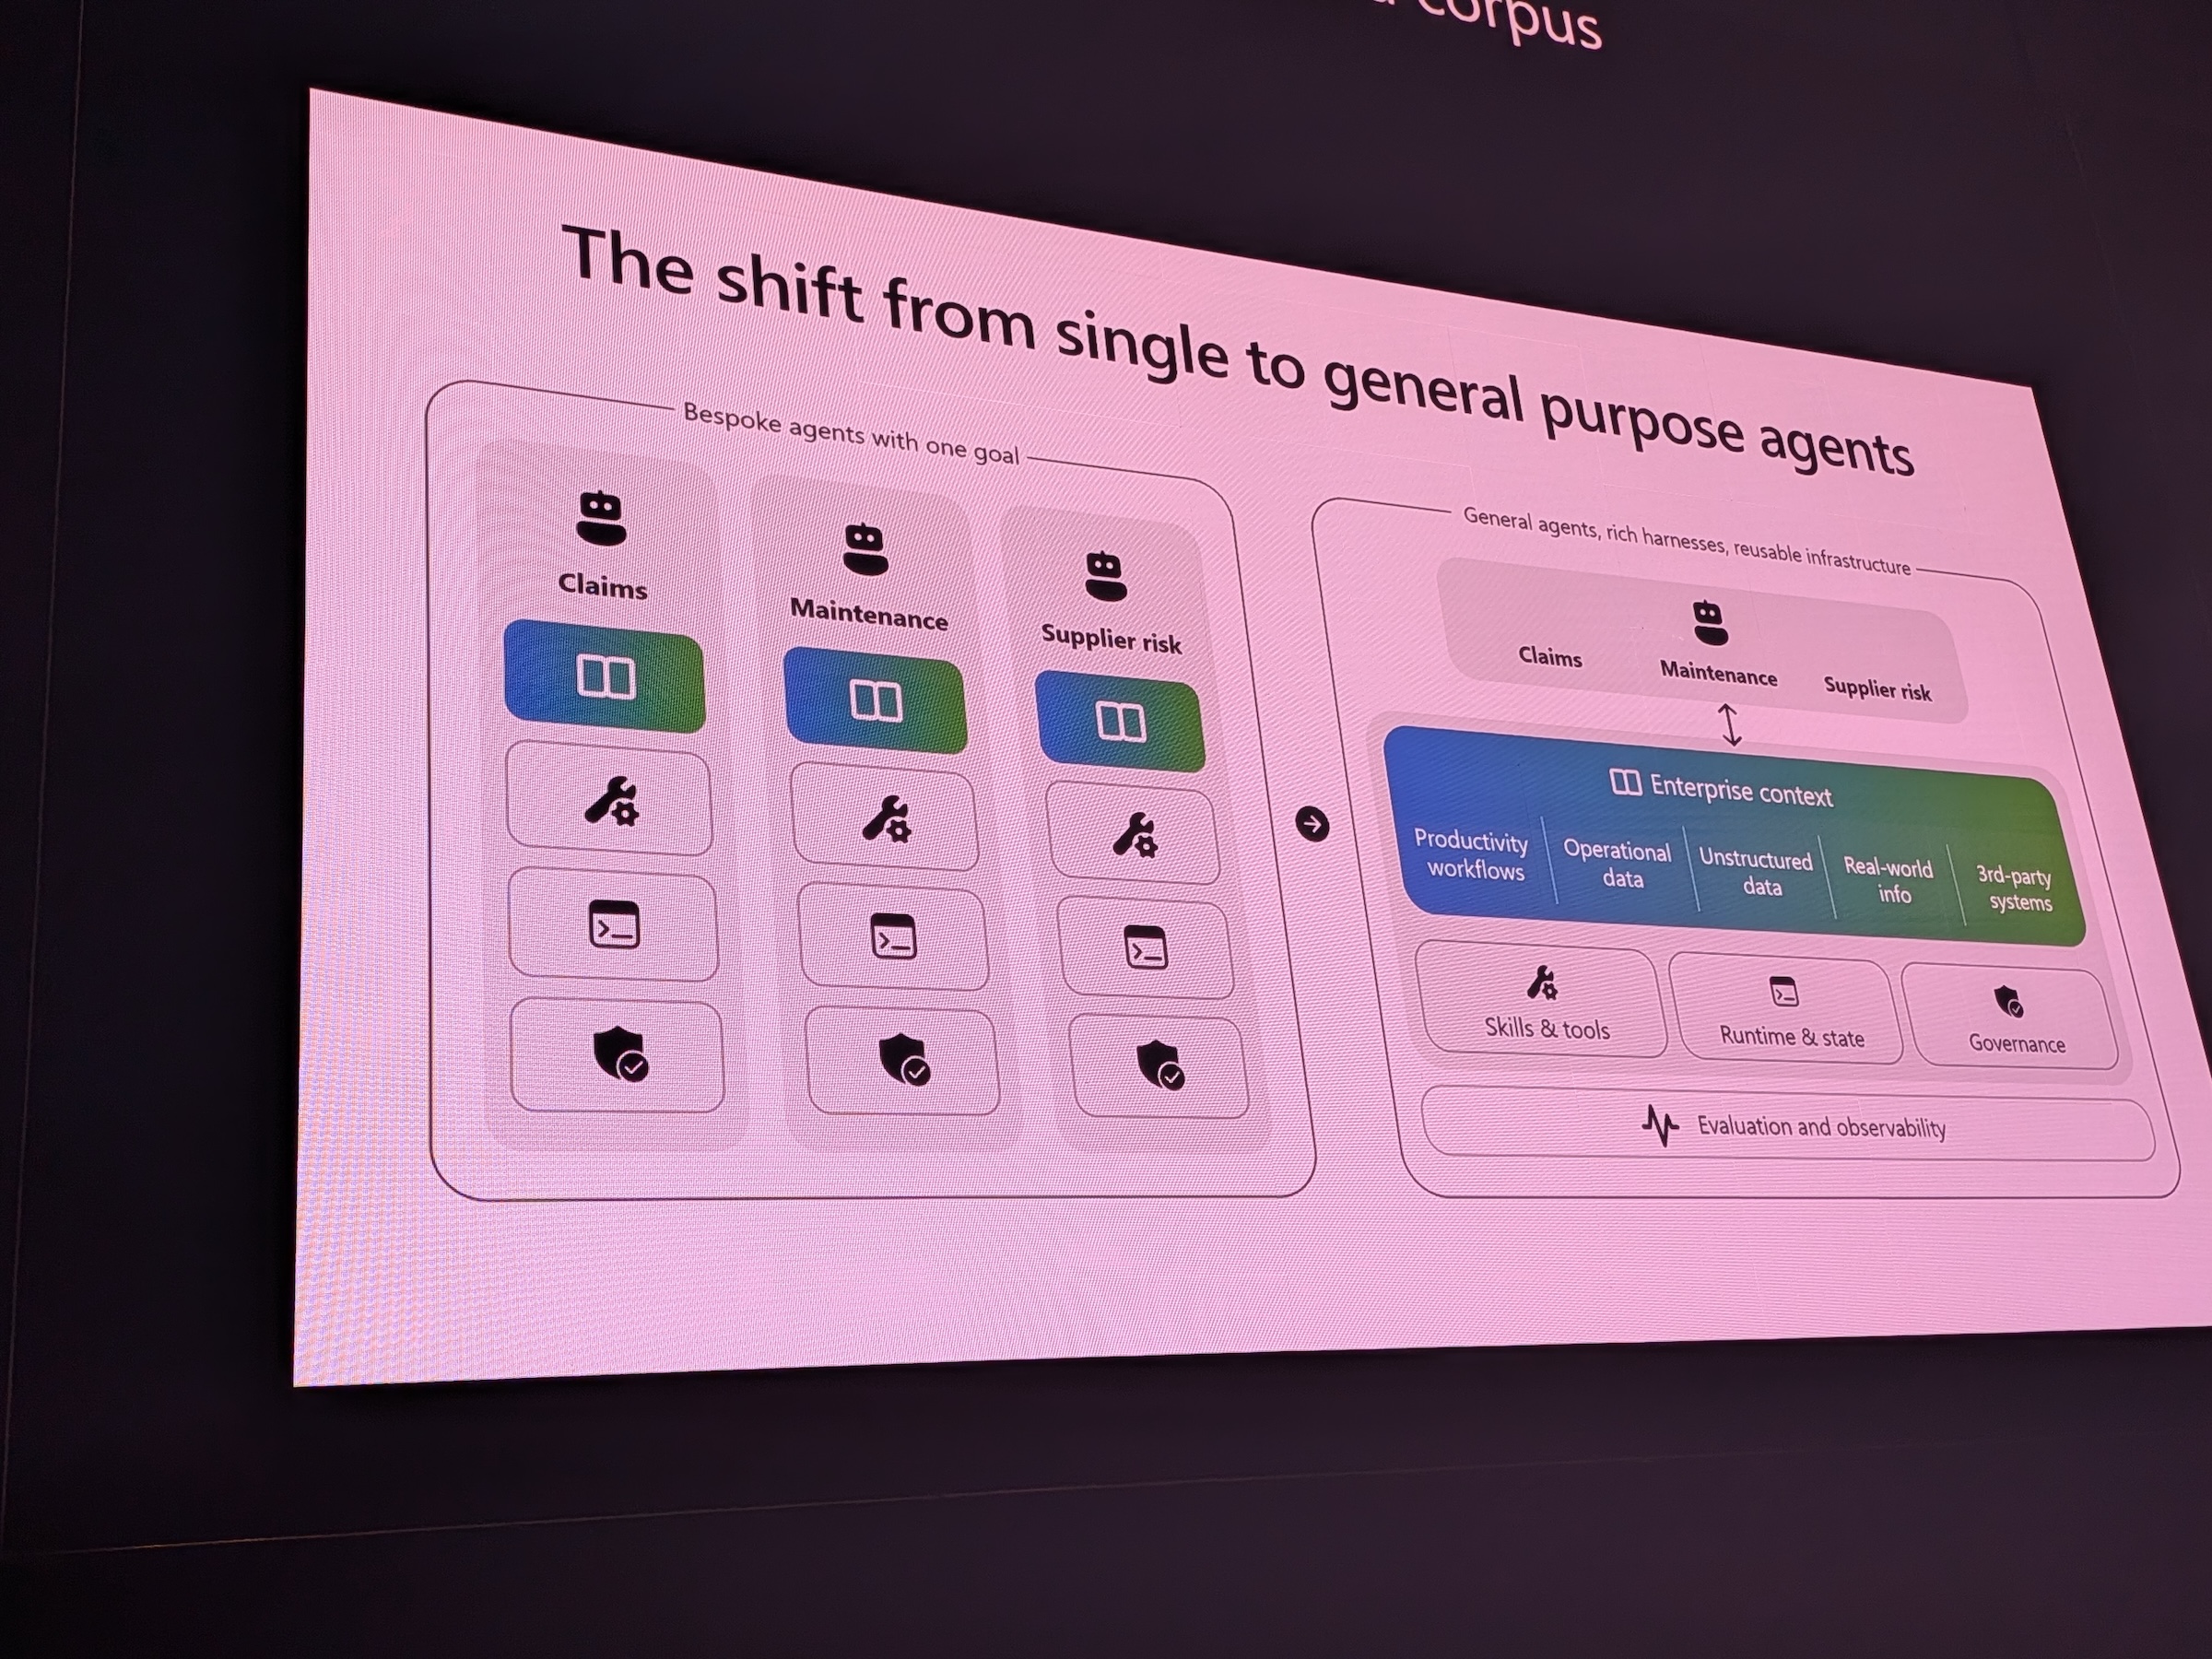
組織全体の知識を共通の基盤として整理し、AIエージェントが必要に応じて適切な情報源を発見して利用できるようにします。このような構成であれば、ナレッジベースを複数のエージェントから共有できます。
Microsoft IQとFoundry IQの関係
Microsoft IQは、企業内のさまざまな情報源をAIエージェントへ提供するための入口として紹介されました。その中でFoundry IQは、主に非構造化コンテンツをナレッジベースとして管理する役割を担います。
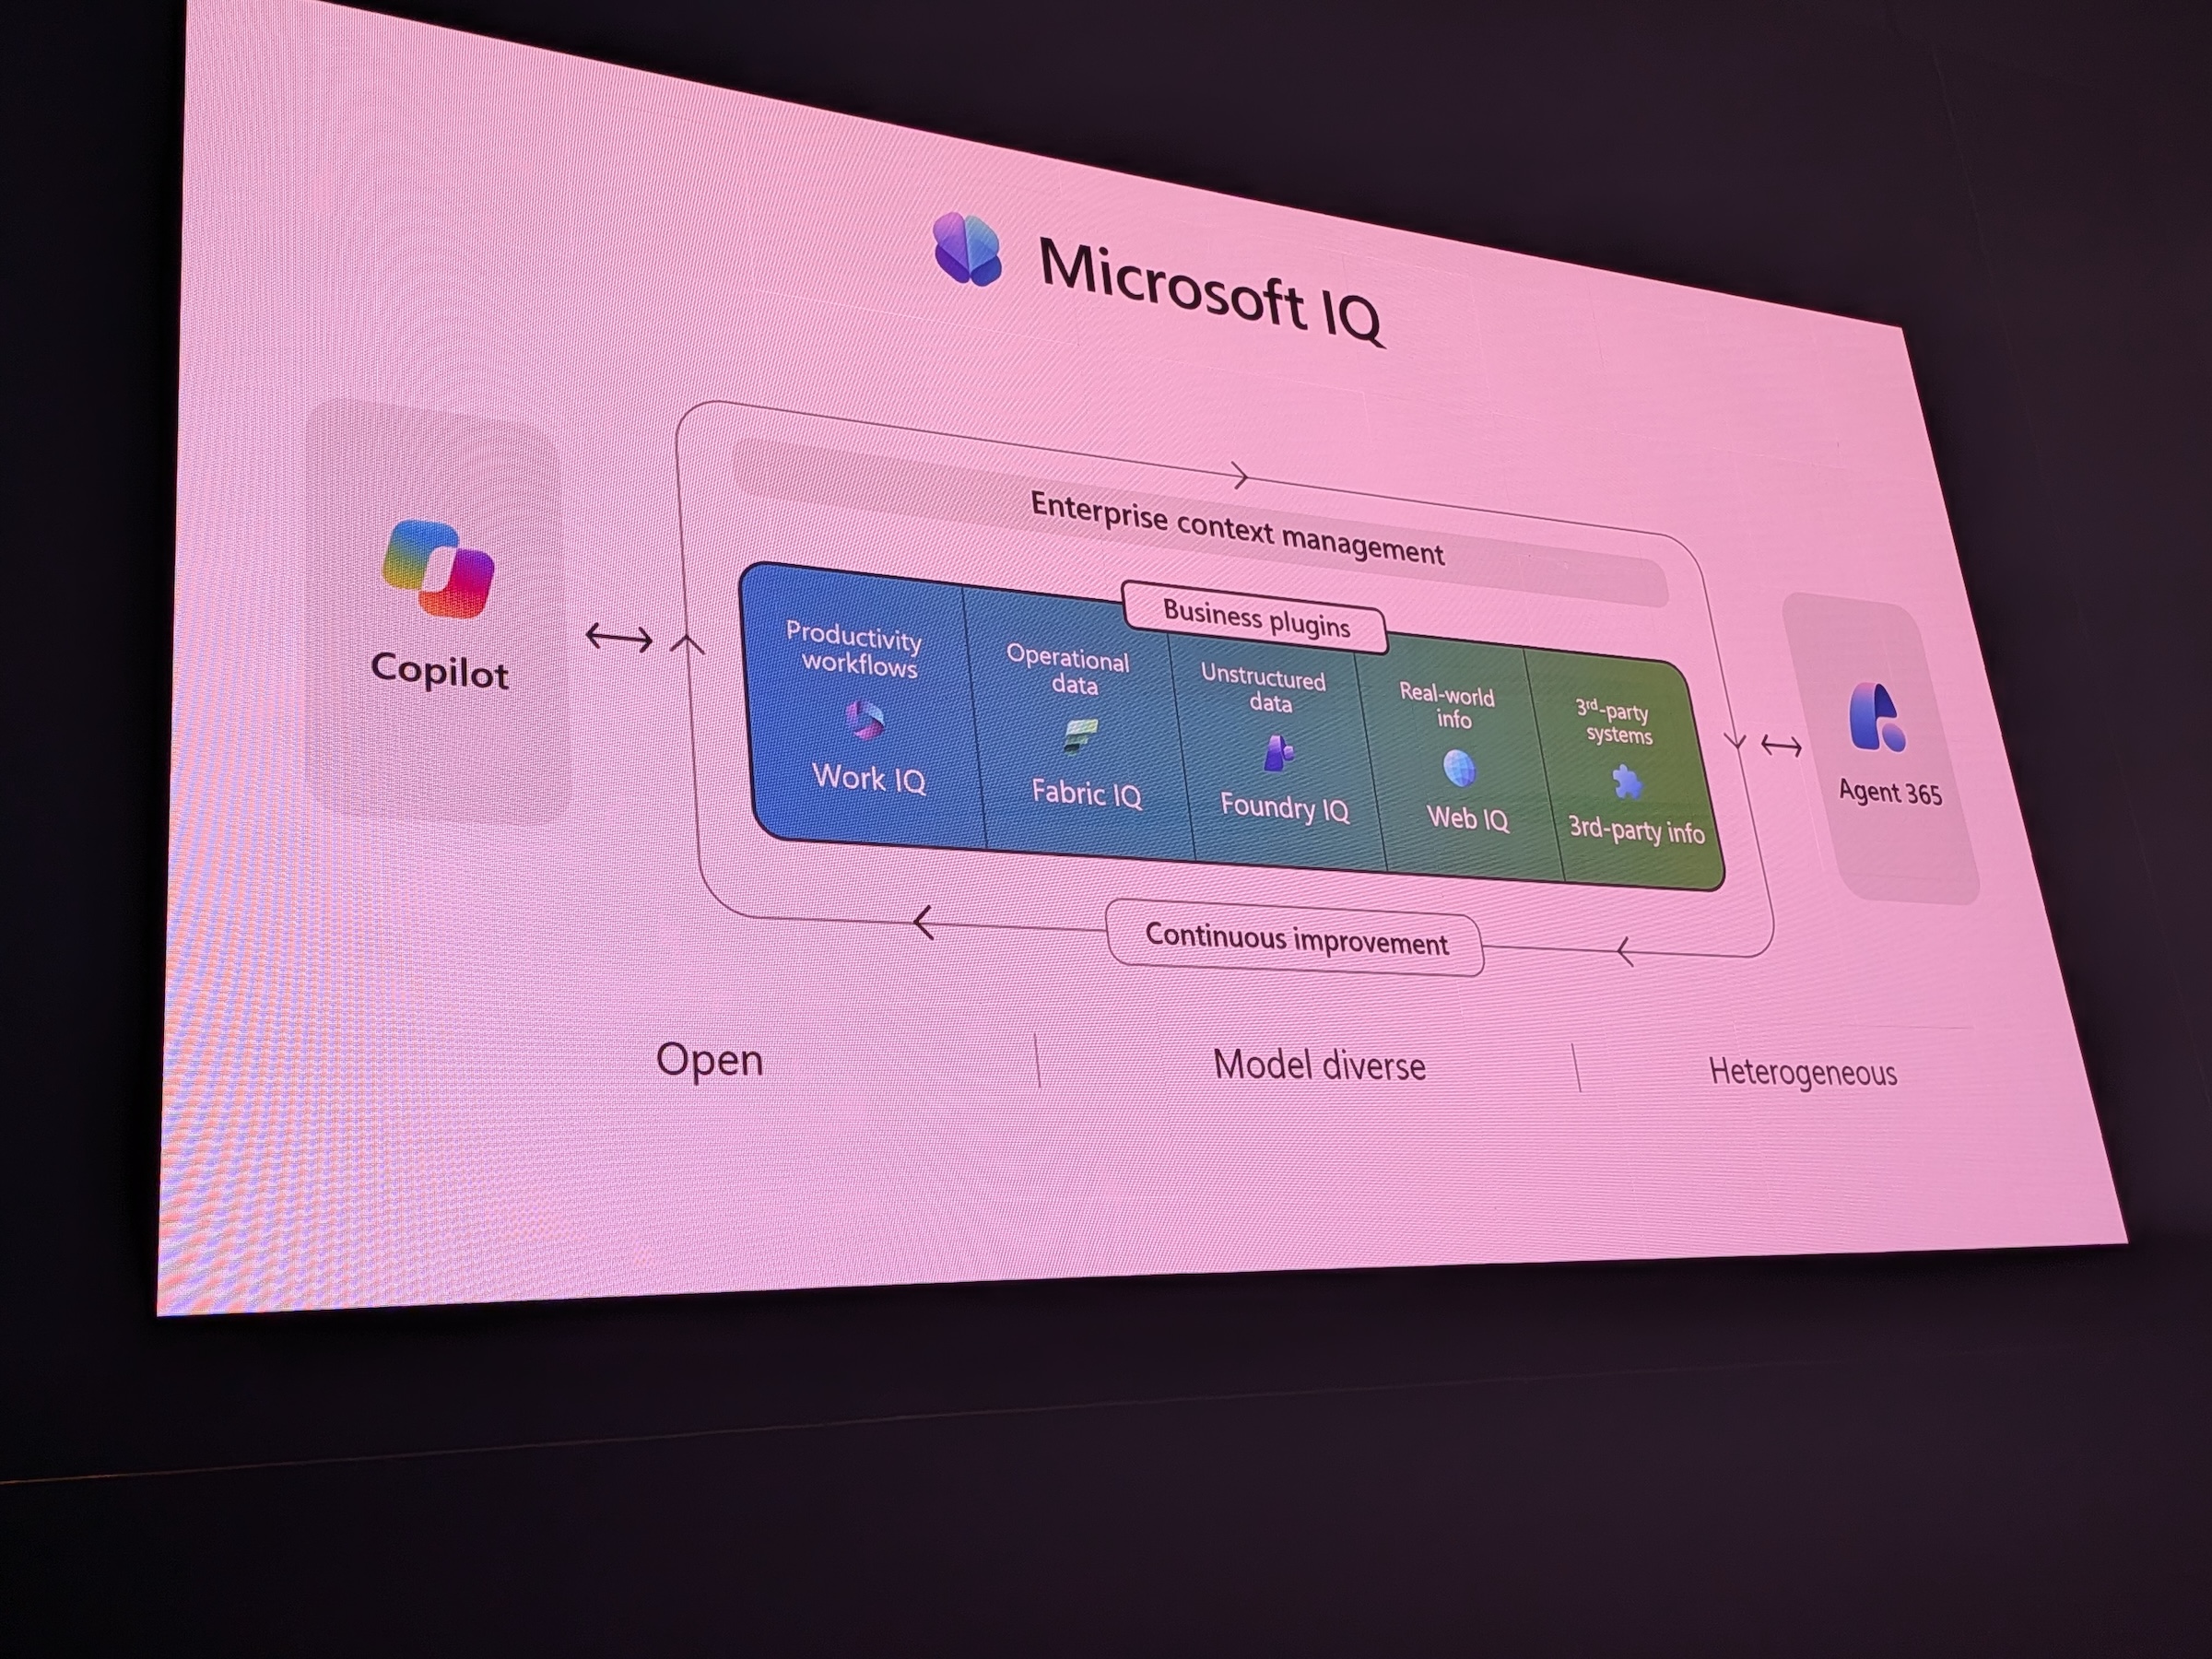
Microsoftの過去約10年分の決算説明会の文字起こしを利用したデモが行われました。まず、Foundry IQで文字起こしをナレッジベースとして管理します。
続いてMicrosoft IQの管理画面から架空の財務分析向けBusiness Pluginを作成し、その中へFoundry IQのナレッジベースを追加しました。
ナレッジベースを追加する際には、組織内の利用可能なナレッジベースを検索し、どのような情報が格納されているのか、いつエージェントが利用すべきなのかを定義します。
その後、Copilotから財務情報に関する質問を実行するとMicrosoft IQが適切なBusiness Pluginを選択し、Foundry IQに保存された情報を参照する流れが紹介されました。
このデモでは利用者が情報の保存先を直接指定していない点が特徴的でした。利用者は質問を入力するだけで、必要な情報源の選択はMicrosoft IQとエージェント側の仕組みが担当します。
Foundry IQのナレッジベースを簡単に構築する
続いてFoundry IQのナレッジベースを構築するデモが行われました。従来、Azure AI Searchで検索インデックスを作成する場合、Azure PortalやAPIを利用して検索サービスやインデックスを設定する必要がありました。
Foundry IQではMicrosoft Foundryの画面からナレッジベースを作成できます。デモでは既存の検索サービスを指定する方法に加え、Foundryへ管理を任せる方法も紹介されました。
後者では開発者が検索サービスの構成を細かく意識せずにナレッジベースを作成できます。具体的には決算説明会の文字起こしファイルを登録し、チャンク分割、ベクトル化、インデックス作成などの処理を実行していました。
作成したナレッジベースはFoundryのエージェントから利用できるだけでなく、MCPサーバーとしてほかのAgent Harnessやフレームワークからも利用できます。また、ナレッジベースは単一のインデックスに限定されず、複数のインデックスやデータソースを組み合わせることもできます。
個々のAIエージェントが検索インデックスを独立して構築するのではなく、共通のナレッジベースを作成して再利用する構成が考えられます。
Foundry IQ Serverlessによる検索基盤の運用
今回のセッションではFoundry IQ Serverlessについても発表がありました。Foundry IQ Serverlessは、利用量に応じて課金されるサーバーレス型の検索基盤です。2026年12月に一般提供が予定されています。
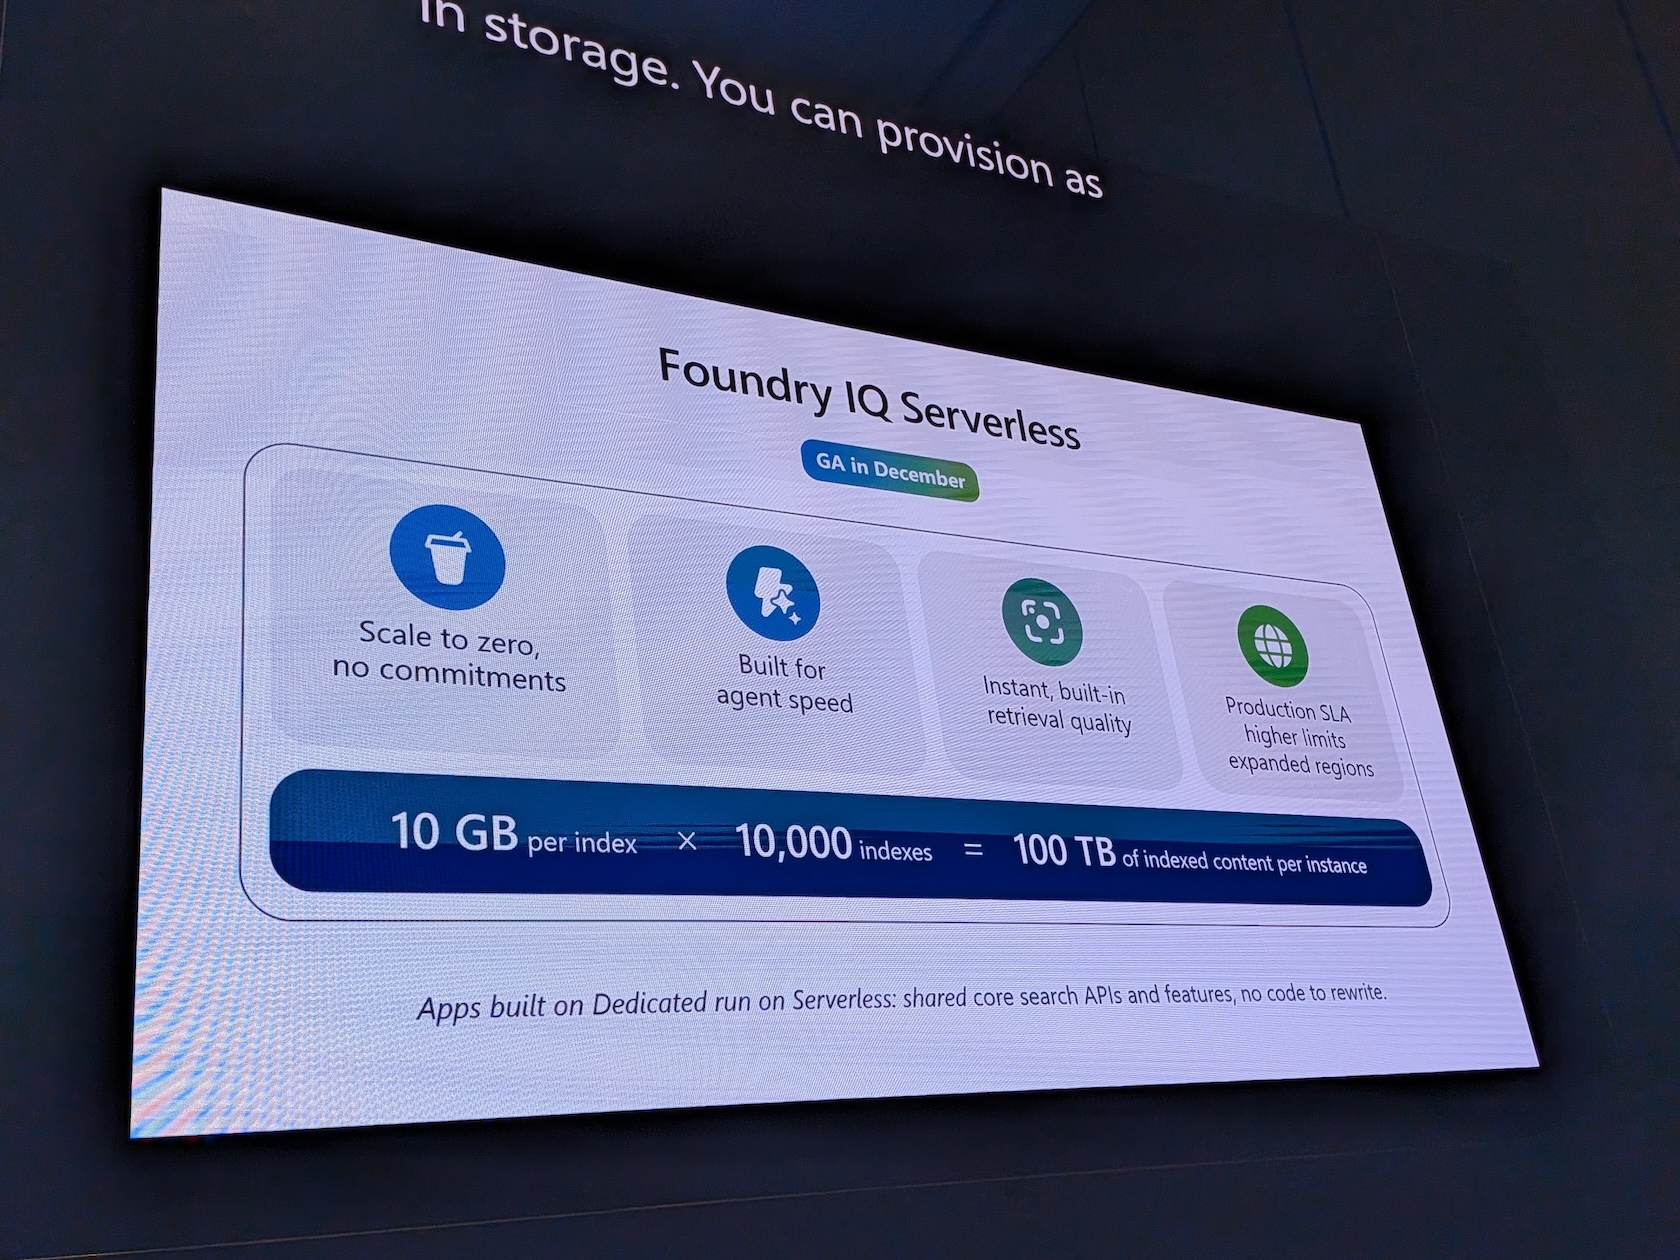
従来の検索サービスでは一定の検索処理能力を確保するためにリソースをプロビジョニングし、その容量に応じた費用が発生する構成があります。Foundry IQ Serverlessでは利用していないときにスケールゼロとなり、必要に応じて検索処理を実行できます。
セッションでは検索サービスを短時間で作成できることがデモで紹介されました。Azure PortalからServerlessを選択すると、ほぼ即座に検索サービスが作成されていました。
この仕組みは、利用頻度が一定ではないナレッジベースや、複数の環境を動的に作成する場合に適していると考えられます。一方、既存の専用コンピュート型のサービスも引き続き利用できます。常時大量の検索要求が発生する場合などには、専用型の構成を選択することもできます。
従来のRAGでは回答が難しい質問
今回のセッションでは、通常のRAGが苦手とする質問がいくつか紹介されました。登壇者は単純な検索で回答できる場合には複雑な仕組みを利用する必要はないと説明しています。そのうえで、通常の検索だけでは対応しにくい質問として、次の2つのパターンが挙げられました。
複数の文書を横断した集計
最初の例はMicrosoftの決算説明会の文字起こしに登場した医療機関の数を調べるという質問です。ここで求めているのはMicrosoftの製品を利用している顧客の総数ではありません。
決算説明会の中で実際に言及された組織が何件あるかを調べる必要があります。そのためには、複数の文字起こしから対象となる組織を抽出し、重複を考慮しながら集計する必要があります。通常のRAGでは検索結果の上位にあるチャンクを取得するため、関連するすべての情報が取得できるとは限りません。
一部の組織が検索結果から漏れてしまえば、集計結果も正しくなくなります。
複数の時点や話題を横断した分析
もう一つの例は、MicrosoftがAI需要の増大にどのように対応してきたのかという質問です。この質問に回答するには、異なる時期の決算説明会や複数の製品に関する説明を参照し、時間の経過に伴う変化を把握する必要があります。
しかし、回答が一つの文章にまとめられているとは限りません。関連性の高いチャンクをいくつか取得しても、必要な話題がすべて含まれているとは限らないため、文書集合全体を横断する検索が必要になります。
こうした課題に対応するため、Foundry IQではKnowledge Graphが追加されました。
Foundry IQにKnowledge Graphが追加
今回のMicrosoft Ignite 2026では、Foundry IQにKnowledge Graphがパブリックプレビューとして追加されました。Foundry IQでは従来のキーワード検索、ベクトル検索、ハイブリッド検索、セマンティックランキング、Agentic Retrievalに加えて、グラフによる情報の取得が可能になります。
ここで紹介されたのがEntity GraphとTopic Graphです。
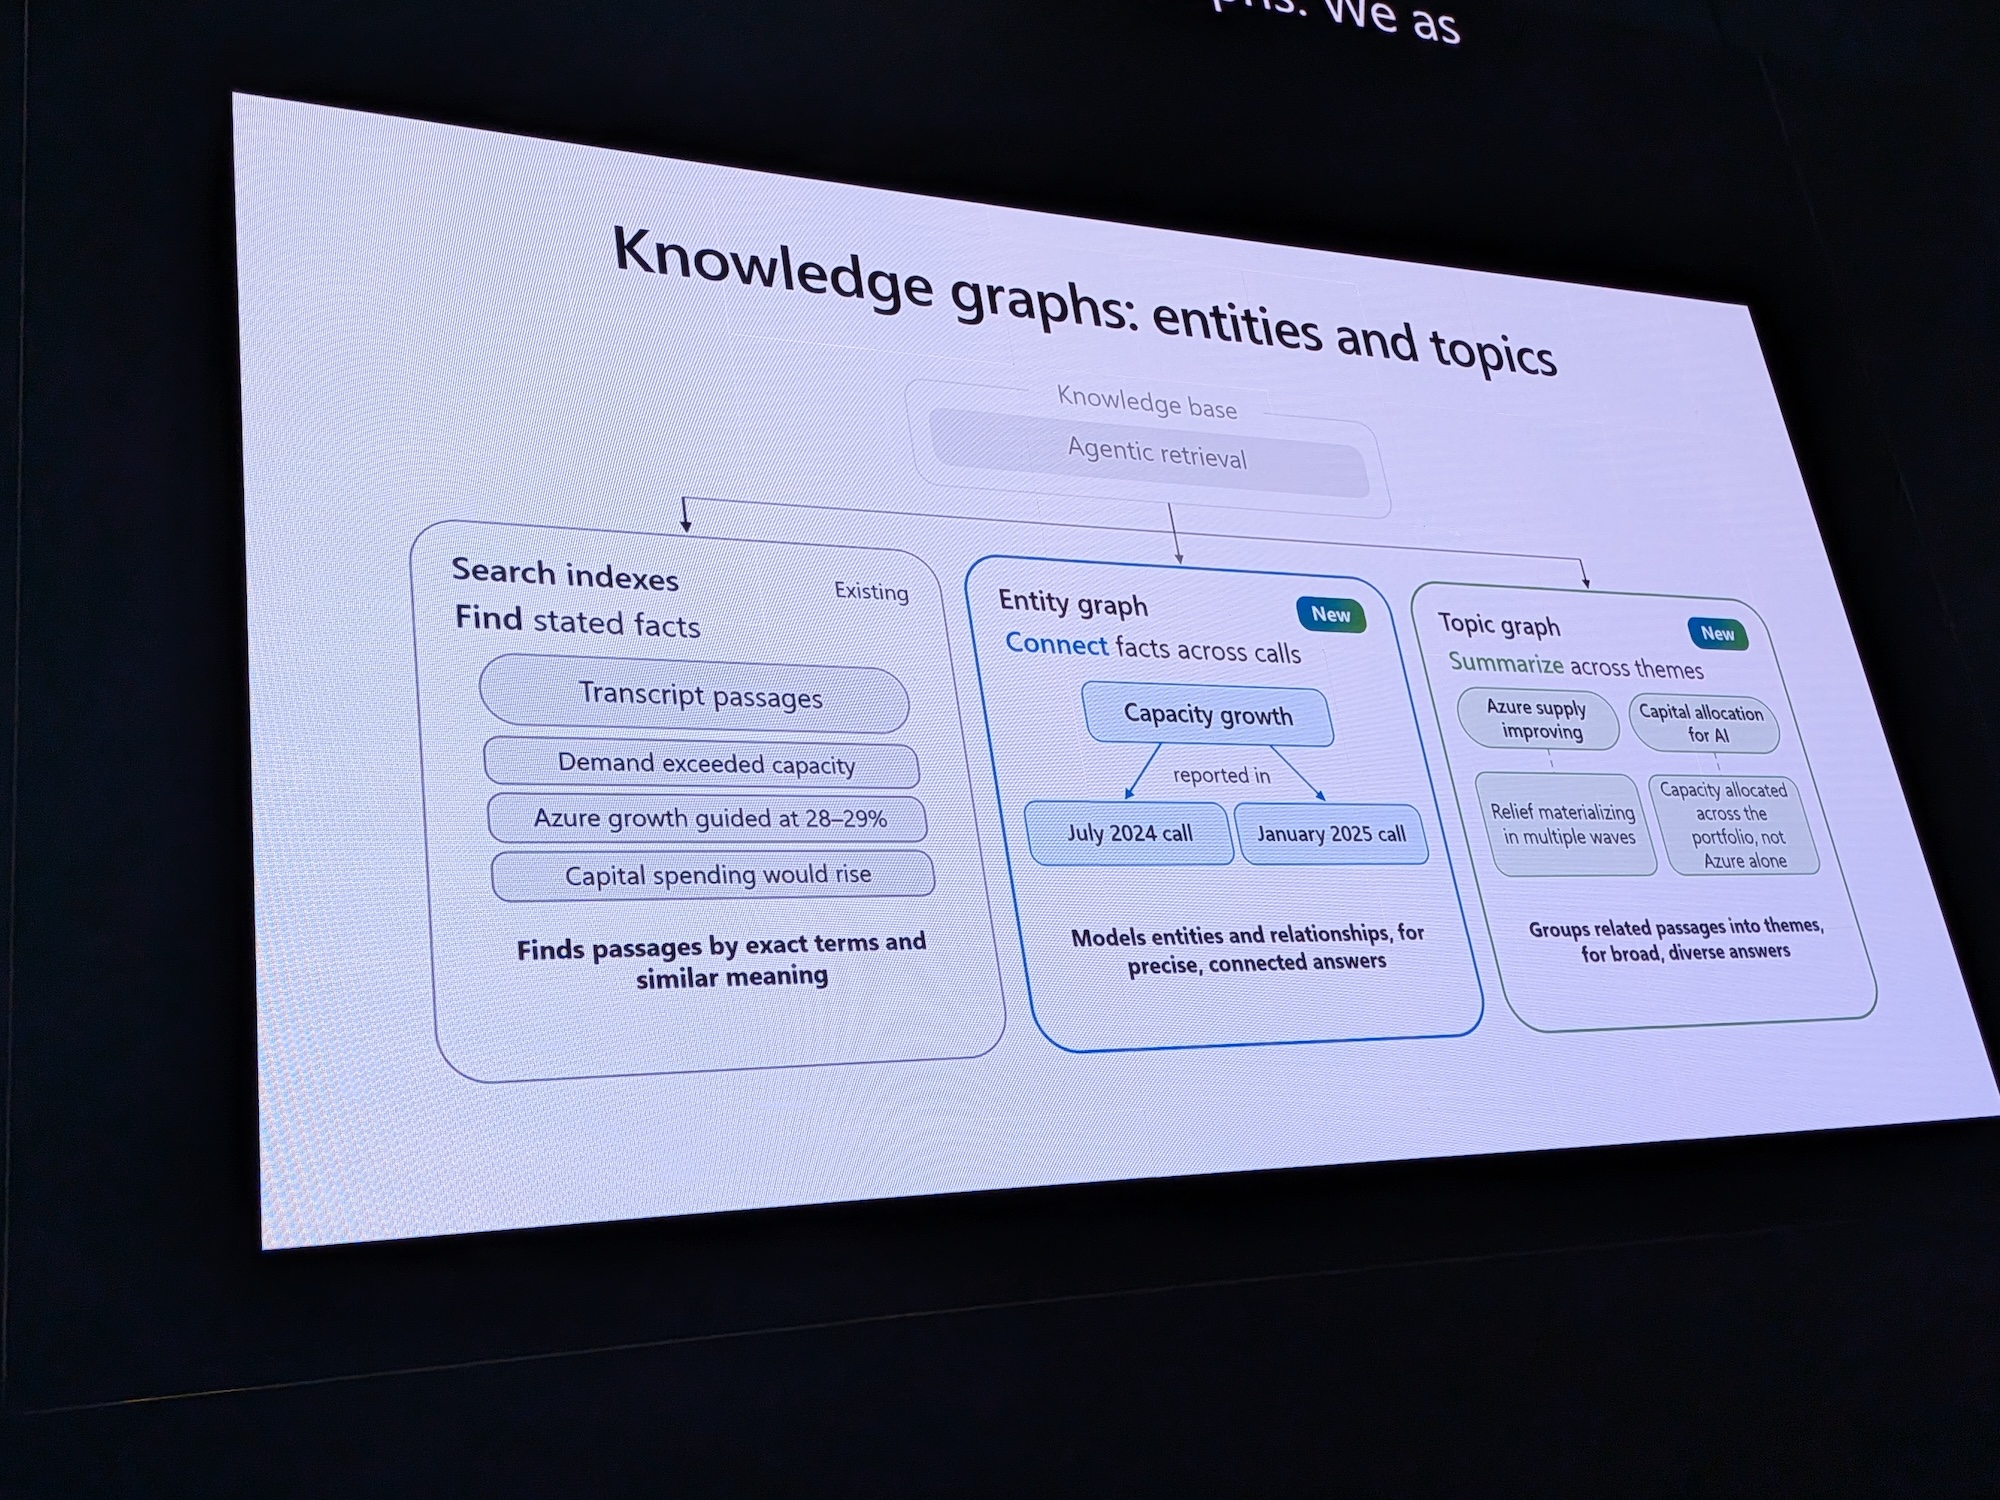
| 機能 | 主な役割 |
|---|---|
| Entity Graph | 文書中のエンティティと関係性を構造化し、正確な集計や関係の検索を支援 |
| Topic Graph | 文書集合全体をトピックの階層として整理し、複数の話題を横断した情報の取得を支援 |
これらは従来の検索機能を置き換えるものではありません。単純な質問には通常の検索を利用し、エンティティ間の関係を調べる場合にはEntity Graph、複数の話題を横断する場合にはTopic Graphを利用するという構成です。
Entity Graphによる関係性の検索
Entity Graphは、文書に存在するエンティティとその関係性を抽出する機能です。例えば、Microsoftの決算説明会の文字起こしであれば、企業、製品、人物などをエンティティとして定義できます。
さらに企業が製品を提供する関係や、人物が組織に所属する関係などを定義できます。このとき必要になるのがOntology(オントロジー)です。
Ontologyは、対象とする領域にどのようなエンティティが存在し、それぞれがどのような関係を持つのかを定義するスキーマです。Foundry IQでは、事前に用意したOntologyに基づいて文書からエンティティと関係性を抽出できます。
また、既存のグラフデータを利用する方法も用意されています。デモではMicrosoftの決算説明会の文字起こしから、企業や製品、人物などの関係性を抽出する処理が紹介されました。
Entity Graphを利用した集計
通常のRAGとEntity Graphを比較するデモでは決算説明会に登場した医療機関の数を調べる質問が使用されました。
通常のRAGでは質問に似た文章を探し、説明されている顧客数などを回答してしまう場合がありました。
一方、Entity Graphでは、文字起こしに登場する組織を関係性から取得し、それぞれの根拠となる文書を確認できます。また、自然言語からグラフ検索を実行するだけでなく、GQLを利用してグラフへ直接クエリを実行する方法も紹介されました。
この仕組みであれば、エージェント自身が必要な関係性を判断してクエリを生成する使い方も考えられます。
Entity Graphの評価結果
セッションではEntity Graphと従来のRAGを比較した評価結果も紹介されました。公式の評価資料では、集計や関係性の検索などを含む質問に対して、以下の結果が示されています。
| 評価項目 | 従来のRAG | Entity Graph |
|---|---|---|
| 正答率 | 26.1% | 93.5% |
| 平均トークン使用量 | 約13,231 | 約4,725 |
Entity Graphでは正答率が改善し、トークン使用量も約64.3%削減されたと報告されています。ただし、これは特定のデータセットと質問分類に対する評価結果です。
すべての検索処理でEntity Graphが優れているという意味ではありません。文書中に回答が直接記載されているような質問では、従来のRAGでも十分な結果を得られます。
Topic Graphによる文書全体の理解
続いて紹介されたのがTopic Graphです。Topic Graphは文書集合に含まれる情報をトピックごとに整理し、階層構造として表現する仕組みです。
例えば、企業の決算説明会であれば、事業、製品、地域、投資、業績などのトピックに分類できます。それぞれのトピックを下位の分類へ展開することで、文書全体の構造を把握できます。
デモでは決算説明会の文字起こしからトピックの階層が生成され、文書集合全体を俯瞰できるようになっていました。また、このトピック構造はEntity Graphを構築する際のOntologyを作成するためにも利用できます。
ベクトル検索で発生する検索結果の偏り
Topic Graphのもう一つの役割が、検索結果の多様性を確保することです。通常のベクトル検索では、質問と意味的に近い文書が検索結果の上位に表示されます。しかし、似た内容の文書が多く存在する場合、検索結果が同じ話題に偏ってしまうことがあります。
例えば、複数の観点から調査する必要がある質問でも、特定の観点について記述されたチャンクばかりが取得される場合があります。このような場合には、検索結果の関連性が高くても、回答に必要な情報を十分に網羅できません。
Topic Graphでは文書集合全体のトピック構造を利用し、異なる話題からも検索結果を取得する仕組みが紹介されました。デモでは通常のベクトル検索が特定のトピックに集中する一方で、Topic Graphを利用すると複数のトピックから情報を取得できることが示されています。
公式評価資料では、複数の話題を横断する質問において、Topic GraphによってEvidence Recallが改善したと報告されています。Evidence Recallは、回答に必要な根拠情報を検索結果がどの程度カバーしているかを示す指標です。
検索結果の件数や類似度だけでなく、回答に必要な情報がどれだけ揃っているかを評価している点が特徴的です。
複数の検索方法を組み合わせる
Foundry IQでは通常の検索、Entity Graph、Topic Graphを組み合わせて利用できます。
それぞれの方法には得意な質問があります。通常の検索は特定の文章に記載された情報を取得する用途に適しています。Entity Graphは文書間の関係性や集計、根拠の追跡などに適しています。
Topic Graphは、文書集合全体を横断した調査や、複数の話題を組み合わせる必要がある質問に適しています。これらを組み合わせることで、単独の検索方法では取得しにくかった情報を補完できます。
公式の評価資料では、Microsoftの決算説明会に関する質問に対して、通常のRAGにEntity GraphとTopic Graphを追加することで、必要な根拠の取得率が約64%から92%へ改善したという結果も示されました。
同時に回答に必要なトークン使用量も削減されています。このようにFoundry IQでは、質問の種類に応じて適切な検索機能を利用することで、回答品質とトークン効率を改善することを目指しています。
Foundry IQをMCPサーバーとして利用
Foundry IQのナレッジベースはMCPサーバーとして利用できます。セッションでは、エージェントからナレッジベースへ自然言語の質問を渡す方法が紹介されました。
ナレッジベース側は質問に応じて通常の検索やAgentic Retrieval、グラフ検索などを利用し、必要な情報を返します。一方、開発者がより細かく制御したい場合には基盤となる検索機能へ直接アクセスできます。
例えば、Entity GraphのTriple IndexやGQLによるグラフクエリ、通常のチャンクインデックスなどを利用でき、Triple Indexでは、エンティティ間の関係に加えて、抽出結果の信頼度や根拠となる文書への参照も保持されます。
高水準のナレッジベースを利用する方法と、個々の検索機能を直接利用する方法の両方が提供されています。また、Foundry IQの設定やKnowledge Graphの構築を支援するプラグインも紹介されました。
開発者がエージェントへ指示し、インデックスの作成やデータの取り込み、グラフの構築を進められるというものです。
Microsoft Retriever 1によるAgentic Retrievalの高速化
後半では検索の低遅延化についても説明がありました。従来の検索システムでは、数十ミリ秒単位の応答時間が重視されてきました。
一方、Agentic RetrievalではAIモデルが検索クエリを計画し、検索結果を確認しながら追加の検索を実行するため、数秒から十数秒程度の処理時間が発生する場合があります。複雑な質問に対応するために必要ですが、対話型アプリケーションでは応答時間が課題になります。
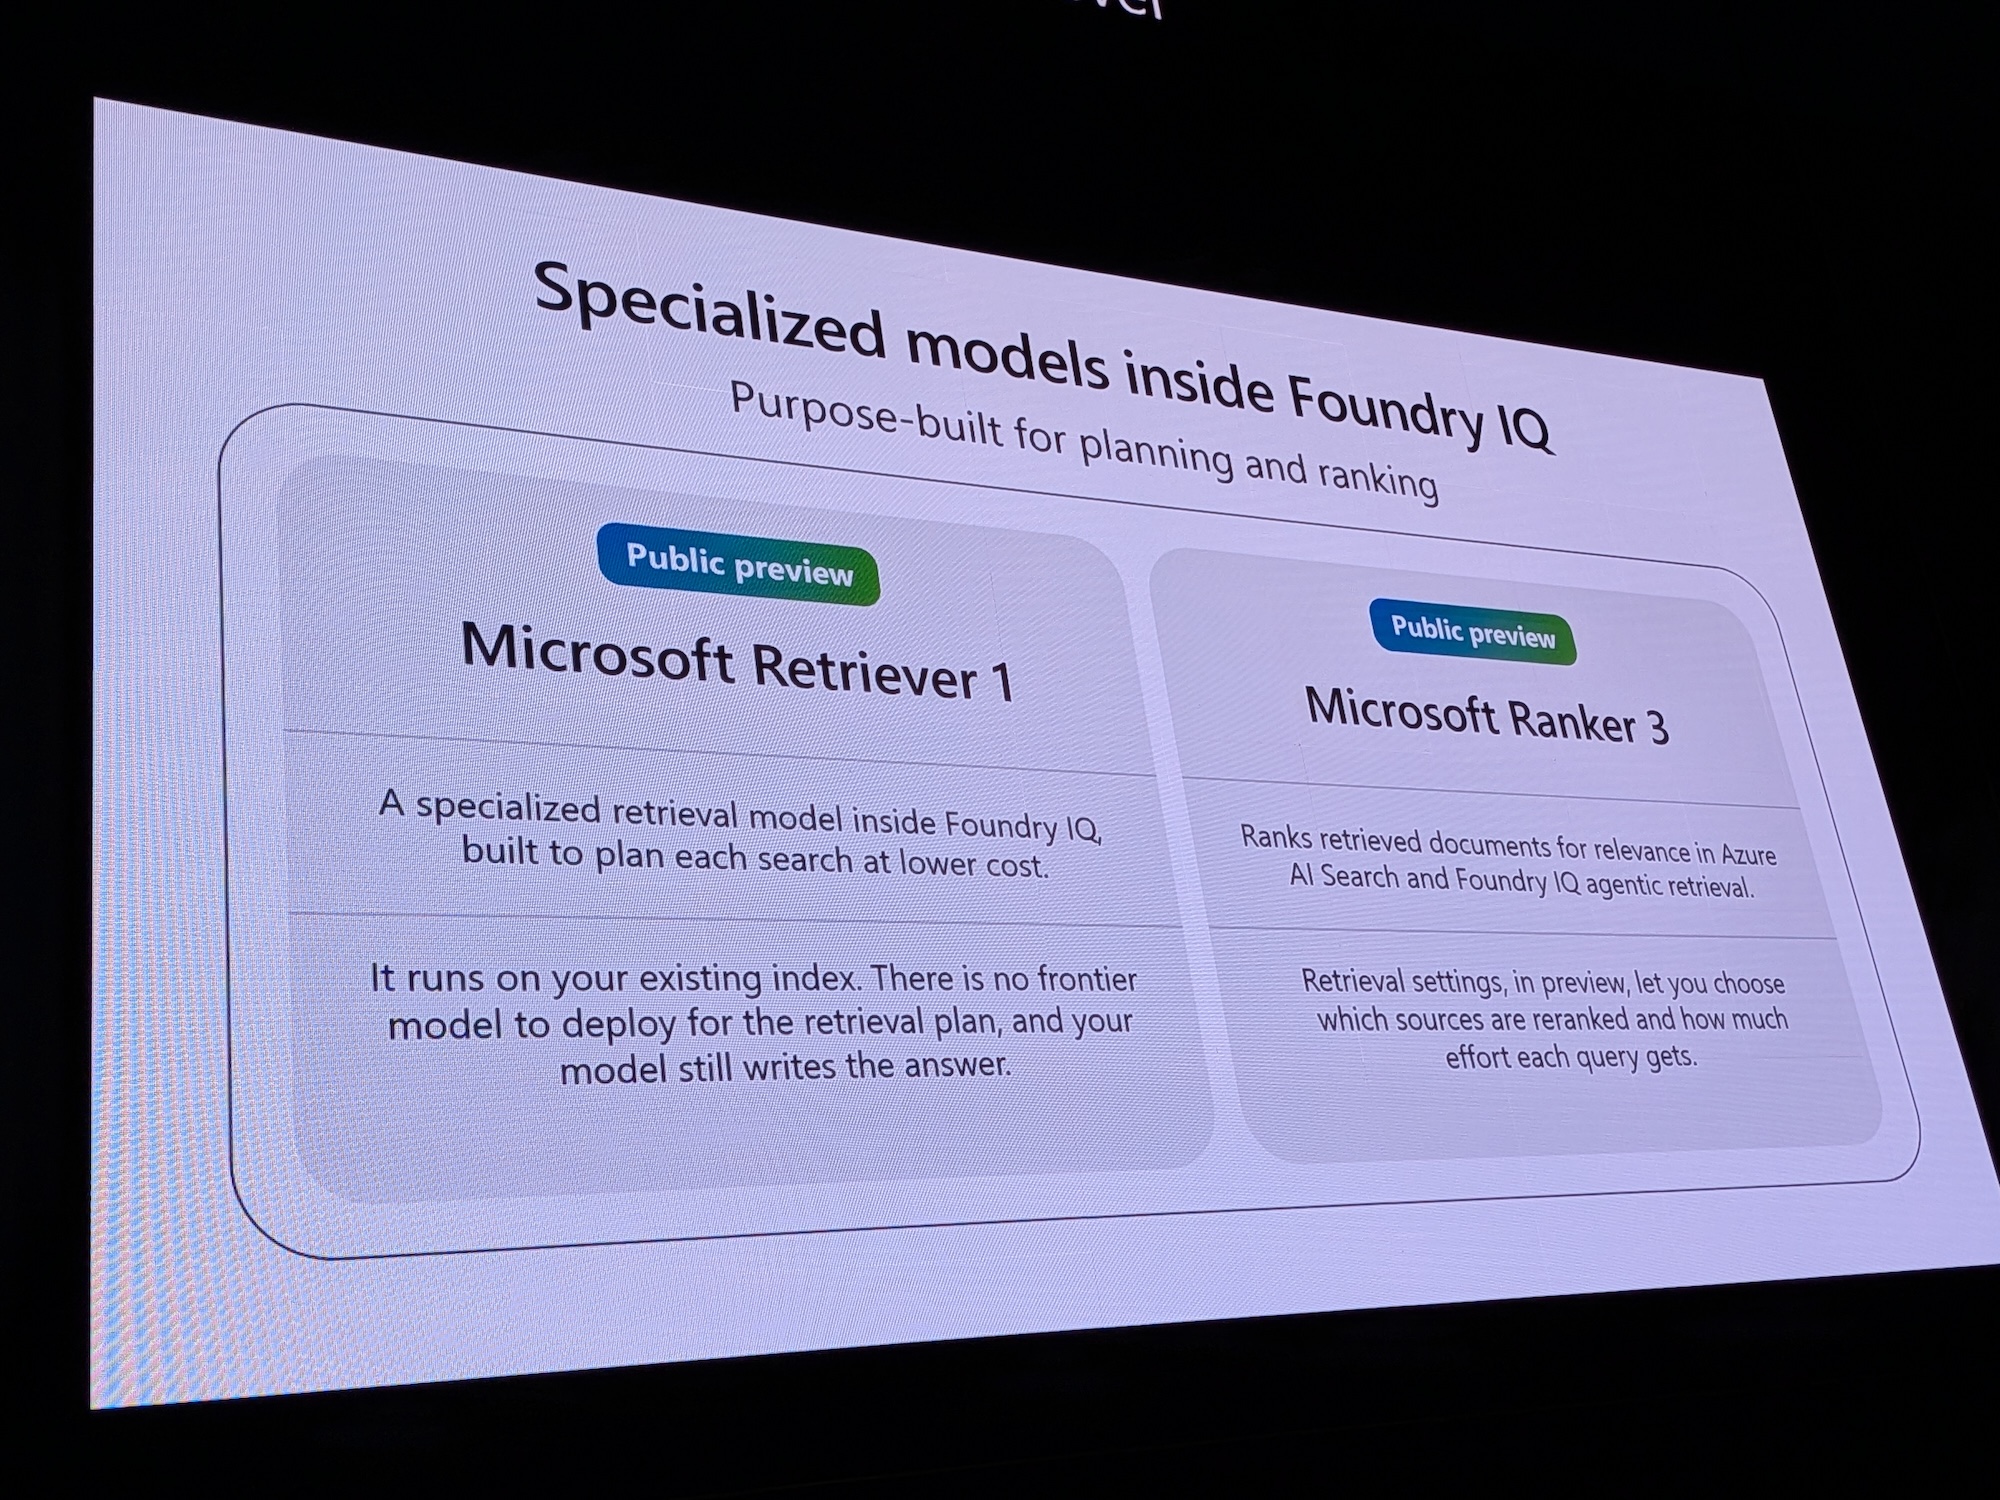
そこで今回紹介されたのがMicrosoft Retriever 1です。Microsoft Retriever 1は、検索計画や検索結果の取得に特化したモデルです。
汎用的な大規模モデルを利用して検索処理を実行するのではなく、検索に特化した小型のモデルを利用することで、応答時間とコストの削減を目指しています。
セッションではMicrosoft Ranker 3というランキング専用モデルについても言及されました。
Xboxに関する質問でのデモ
Microsoft Retriever 1のデモでは、Xboxのゲームと競合するゲーム機に関する質問が使用されました。通常のSemantic Searchでは、キーワード検索やベクトル検索、セマンティックランキングを組み合わせて関連情報を取得します。
一方、Agentic Retrievalでは最初の検索結果を確認したモデルが、質問に直接記載されていなかったXbox Play Anywhereという概念を発見しました。その後、その情報を利用して追加の検索を実行することで、より適切な情報を取得する流れが示されました。
ここで重要なのは、最初の検索結果を利用して次の検索内容を調整している点です。通常の検索ではユーザーから与えられたクエリをもとに検索を実行しますが、Agentic Retrievalでは検索結果から新しい手掛かりを得て、検索処理を継続できます。
Microsoft Retriever 1では、このような処理を低遅延で実現することが目指されています。公式発表では検索に必要な遅延を短縮しながらEvidence Recallを改善し、エージェントが回答するために必要な入力トークンを削減できるという評価結果が紹介されています。
Microsoft Retriever 1はプレビュー機能として提供されており、利用可能なAPIバージョンや設定は公式ドキュメントで確認する必要があります。
エンタープライズ環境に必要なアクセス権限の継承
最後に紹介されたのが、エンタープライズ利用に必要なセキュリティとガバナンスです。AIエージェントが企業内の文書を検索する場合、検索対象となる文書のアクセス権限を適切に扱う必要があります。
例えば、SharePointの文書を検索インデックスへ取り込む場合、元の文書にはユーザーやグループごとのアクセス権限が設定されていることがあります。このとき、文書の内容だけを検索インデックスへ登録し、アクセス権限の情報を保持しなかった場合、本来その文書を閲覧できないユーザーへ検索結果が表示される可能性があります。
このような構成が企業向けシステムでは問題になることが指摘されました。Foundry IQでは、対応するデータソースについてアクセス権限の情報を検索基盤へ引き継ぐ仕組みが紹介されています。
今回のMicrosoft Ignite 2026では、SharePointとAzure SQL Databaseのインデックス作成機能の一般提供も発表されました。デモではSharePointなどの対応するデータソースをナレッジベースへ追加し、アクセス制御情報を継承する設定が紹介されました。
ただし、アクセス権限の継承が利用できる条件はデータソースや接続方式によって異なります。実際に利用する場合には、対応する認証方法、権限の反映タイミング、検索時のアクセス制御などを確認する必要があります。
登場サービス/製品に対する見解
エージェントとコンテキストの分離
今回のセッションで特に印象に残ったのはエージェントとコンテキストを分離するという考え方です。従来のRAGでは、アプリケーションごとに検索インデックスやデータの取り込み処理を作成する構成が多くありました。
しかし、企業内で複数のAIエージェントを運用する場合には、それぞれのエージェントが独立したナレッジベースを持つことが必ずしも望ましいとは限りません。
例えば、同じ業務文書を参照するエージェントが複数存在する場合、検索インデックスを個別に作成するとデータの更新やアクセス権限の管理を重複して実施する必要が生じます。
Foundry IQではナレッジベースを共通のコンテキスト基盤として管理し、複数のエージェントから再利用できます。さらにMicrosoft IQを通じて組織全体へ公開することで、利用者やエージェントが必要な情報源を発見できるようになります。
一方ですべての情報を共通基盤へ集約すればよいというわけではありません。組織内のデータには異なる機密区分や更新頻度、利用目的が存在します。
そのため、ナレッジベースをどの単位で分割し、誰が管理し、どのエージェントから利用できるようにするのかを設計する必要があります。
RAGを置き換えるのではなく検索方法を使い分ける
今回のセッションでは通常のRAGでも十分に対応できる質問があることを明確に説明していました。この点は興味深いものでした。
Knowledge Graphを利用すれば、複数の文書を横断した集計や関係性の検索など従来のRAGでは対応が難しかった質問に答えられる場合があります。
特定の文書から一つの事実を取得するような質問では通常の検索で十分な場合もあります。
Entity GraphやTopic Graphを構築するにはエンティティや関係性の抽出、トピックの分類など追加の処理が必要です。そのため、検索対象となるデータや質問の傾向を確認せずに、すべてのナレッジベースへKnowledge Graphを導入する必要はないと考えています。
特にOntologyの設計は、検索できる情報の範囲や精度に影響します。何をエンティティとして定義し、どの関係性を抽出するのかによって、回答できる質問が変わるためです。
実際にKnowledge Graphを利用する際には、まず検索対象となるデータと質問を整理し、従来のRAGでどのような問題が発生しているのかを評価する必要があります。その結果に応じてEntity GraphやTopic Graphを追加するという進め方が考えられます。
Evidence Recallを評価するという考え方
もう一つ印象に残ったのがEvidence Recallという指標です。検索システムでは質問に関連する文書をどの程度正確に取得できるかが重要になります。しかし、AIエージェントが複数の文書から情報を収集する場合、関連性の高い文書を取得できたとしても、回答に必要な情報が揃っているとは限りません。
例えば、企業の事業戦略について質問した場合、売上や投資に関する文書だけが取得され、組織体制や競合に関する情報が取得できなければ、十分な回答にはならない場合があります。
Evidence Recallは回答に必要な根拠がどの程度取得できたのかという観点で検索品質を評価します。今回のTopic Graphのデモでは検索結果の関連性だけでなく、異なるトピックから情報を取得することでEvidence Recallを改善するという説明がありました。
この考え方はAIエージェントの検索品質を評価するうえで重要です。単純な検索精度に加えて、質問へ回答するために必要な情報が揃っているのかを確認する必要があります。
検索基盤への処理の移動とトークン効率
Microsoft Retriever 1やKnowledge Graphの評価では検索品質とともにトークン消費量の削減が繰り返し紹介されました。従来のRAGでは必要な情報を取得できなかった場合に検索回数を増やしたり、より多くのチャンクをLLMへ渡したりする方法が考えられます。
しかし、検索結果を大量に渡せば、必ず回答品質が向上するとも限りません。逆に不要な情報が増えることで、入力トークン数が増加し、処理時間や費用にも影響します。
今回のFoundry IQでは検索処理の段階でエンティティの関係性やトピック構造を利用し、回答に必要な情報を整理する仕組みが紹介されました。
LLMが大量の文書を読みながら情報を探す処理の一部を検索基盤側へ移動できます。
Microsoft Retriever 1についても検索計画という特定の処理に専用モデルを利用することで汎用モデルを利用する場合の処理時間やコストを削減するアプローチです。個人的には、AIエージェントの推論コストを削減する方法としてこのような検索基盤側の改善にも注目したいと感じました。
企業での利用ではアクセス権限の管理が欠かせない
Foundry IQの機能を企業内で利用する場合、アクセス権限の管理も確認したいポイントです。通常の検索システムでも同様ですが、アクセス権限の管理が不十分であれば、利用者が本来アクセスできない情報を取得できてしまう可能性があります。
検索品質が高くても、利用者が本来アクセスできない情報を取得できてしまうのであれば、本番環境で利用することはできません。特にMicrosoft IQのように企業全体の情報を横断する場合、情報源ごとに異なるアクセス権限をどのように扱うのかが課題になります。
今回のセッションではSharePointなどのデータソースからアクセス権限を継承する機能が紹介されました。この仕組みを利用することで、文書の内容とともに権限情報を検索基盤へ反映できます。
ただし、実際に導入する際には元のシステムで権限が変更された場合に検索基盤へいつ反映されるのか、複数のデータソースを横断した場合に権限をどのように評価するのかを確認する必要があります。
AIエージェント自身に付与された権限とエージェントを利用するユーザーの権限をどのように扱うかという観点も重要です。ナレッジベースを複数のエージェントで共有する場合にはこうした認証や認可の設計を含めて考える必要があると感じました。
まとめ
従来のRAGから企業全体のコンテキスト基盤へと発展するFoundry IQの方向性が紹介されました。特定のエージェントへ個別のデータを接続する構成から組織の知識をナレッジベースとして管理し、複数のエージェントで共有する構成への変化が示されています。
今回発表されたKnowledge GraphではEntity GraphとTopic Graphを利用し、複数の文書を横断した集計や関係性の検索、文書集合全体の理解などを支援します。
また、Microsoft Retriever 1によるAgentic Retrievalの高速化やFoundry IQ Serverless、SharePointのアクセス権限継承など、検索品質とコスト、エンタープライズ運用に関する機能も紹介されました。
個人的には、通常のRAGを含めた複数の検索方法を、質問の種類に応じて使い分けるという考え方が印象に残っています。検索対象となるデータや質問の性質によって必要な仕組みは異なるため、最初から複雑な構成を採用するのではなく、実際の検索品質を評価しながら適切な方法を選択する必要があります。
今後はFoundry IQのKnowledge Graphを利用し、通常のRAGとEntity Graph、Topic Graphで回答品質やトークン消費量がどのように変わるのかを検証してみたいと考えています。
参考情報
- BRK297:The shift from RAG to context: Grounding agents with Foundry IQ
- Foundry IQ: Introducing knowledge graphs, engineered for agents
- Knowledge graphs in Foundry IQ improve evidence recall with fewer tokens
- Microsoft Retriever 1 brings sub-second agentic retrieval to Foundry IQ
- Introducing the new Microsoft IQ: Putting your organization’s intelligence to work in every agent
- Relevance and ranking overview – Foundry IQ
 簡単30秒