


なぜ 仕様書駆動開発 なのか
バイブコーディングの限界
バイブコーディングはコードの中身を細かく把握せず、自然言語で指示して AI に任せる開発スタイル。素早い試作には非常に強力だが、既存コードベースへの機能追加や本番向け開発では、意図と生成物のズレが少しずつ蓄積していく。
問題の本質は AIの性能 ではなく、判断の根拠がチャット履歴という揮発的な場所にしか存在しないこと。
バイブコーディング:
指示 → コード生成 → 「ちょっと違う」 → 修正 → 「そこじゃない」 → 修正 → ...
↑ 判断の根拠はすべてチャット履歴の中。セッションが変われば失われる
会話が長くなるほど重要な決定はコンテキストに埋もれ、エージェントは直近の発言だけを頼りに実装する。
結果として、同じ指示を出しても同じものが出てこない ⇒再現性がない状態になってしまう。
対応策:メモをリポジトリに置く
チャットの中だけで話を進めるのをやめて、決めたことをファイルに書くようにする(仕様書駆動開発)。
ファイルに書いてあれば 毎回読み直してもらえるので、コンテキストの問題が解消する。
# 例(docsフォルダ下に置くのもあり)
myapp/
├── SPEC.md ← 何を作るか
├── CLAUDE.md ← どう作ってほしいか
└── src/
役割分担はシンプルで SPEC.md が「何を作るか」、CLAUDE.md が「どう作ってほしいか」。この2つは混ぜない。
これにより「コードは仕様から生成される派生物」になる。仕様書の段階で認識のズレに気づけば、修正コストはテキスト数行で済み、無駄な作業も減らせる。
本記事は小さめのプロダクト向けの シンプルな「仕様書駆動開発のバイブコーディング」のやり方を記載する
やり方
Step 1:実現方法の検討
実現したい・利用したいものについて、新たに作成するべきなのかどうかを調査・検討する。
わざわざ新しく1から作成しなくても、既存サービスの利用で済む場合もある。
また、作成するとしてバイブコーディングが向いているのかそうでないのかの判断も行う(社内ツール・プロトタイプは向く/決済・認証など失敗コストの大きいものは慎重に)。
以降は、バイブコーディングで作成する場合の手順となる。
Step 1.5:AIの権限・実行範囲の制限
実装を始める前に、AIは勝手にファイルやデータを消すことがあるので、AIがやってよいこと の範囲を先に縛っておく。
特に削除・本番環境・秘密情報の3つは、最初に防御する。
- 破壊的コマンドの制限
rm -rf、git push --force、DBのDROP/DELETE、マイグレーションの実行などは
自動承認させず、必ず人間の確認を挟む or 禁止する
- 本番系から隔離する
- 本番DB・本番APIキーには触れさせない。開発はローカルかステージングのみ
.env(本番用)はAIの読み取り対象から外す
- 秘密情報をコンテキストに載せない
- APIキー・トークン・パスワードはプロンプトに貼らない
.gitignoreも併せて利用する
プロトタイプ段階ではある程度自由に進めさせてよいが、
「削除系」と「本番系」だけは例外として最初に縛っておくとよい。
ここをサボると、取り返しのつかない事故(本番データの消失など)につながる。
ツール別の設定箇所の例
- Claude Code:
.claude/settings.jsonの permissions で許可・拒否コマンドを定義 - Cursor / Codex … 各ツールの permission / sandbox 設定で auto-run の範囲を限定
{
  "permissions": {
    "deny": [
      "Bash(rm -rf:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(git push:*)",
      "Bash(psql:*)",
      "Bash(mysql:*)",
      "Bash(npx prisma migrate:*)"
    ]
  }
}
ただし permissions は万能ではないので注意。
npxやdocker execのようなラッパー経由、&&でつないだコマンドはルールをすり抜ける。一次防御は「本番の資格情報をその環境に置かないこと」に置くのを前提にする。
Step 2:AIと一緒に仕様書作成
整理した要件をAIに渡し、仕様書の形に落とし込む。
以下のような指示でAIに仕様書を作成させる。
AIに一方的に書かせるのではなく、AIから質問させるのがポイント。
以下の内容のアプリケーションの仕様書 `SPEC.md` を作成してください。
不明点は先に質問してください。
曖昧な表現(適切に、必要に応じて、など)を使わないこと。

## 作りたいもの
気になった記事のURLを放り込んでおいて、あとで読むためのアプリ。
ブラウザのブックマークは増えすぎて機能してないので、「読んだら消える」前提のリストが欲しい。

## 機能
- URLを貼ると、タイトルを自動取得して保存する
- 一覧で表示する(新しい順)
- 「読んだ」ボタンで消す
- タグを1つだけ付けられる

## 制約
- 自分ひとりで使う(ログイン不要)
- ブラウザで見る(スマホアプリは作らない)
- 記載内容の例
- 技術スタック
- 機能要件
- 非機能要件(性能・セキュリティ面等)
- 画面一覧
- データ構造
- 各機能の異常系(入力不正・外部通信失敗・重複など)
- スコープ外の明記
Step 3:仕様書のレビュー・確定
まず、作った仕様書をAIに再度レビューさせる。
作成した仕様書で曖昧な箇所・考慮漏れ・矛盾点があれば指摘してください。
AIから指摘点があればそれについて記載したうえで、再度レビューの依頼を行う。
認識のズレをここで潰しておくことで、実装中の手戻りを大幅に減らせる。
AIによるレビューが完了したら、人間の目で確認しておく。
Step 4: CLAUDE.md の作成
CLAUDE.md の記述例
# Read Later

## このプロジェクトについて
気になった記事のURLを保存して、あとで読むためのアプリ。個人利用のプロトタイプ。
「読んだら消える」前提で、リストが常に短く保たれることを優先する。
スコープ外:ログイン・ユーザー管理、記事本文の保存、削除したものの履歴

## コマンド
- 起動: npm run dev
- Lint: npm run lint
- 型チェック: npm run typecheck
- ビルド: npm run build
- セキュリティ:npm audit

## 仕様・設計ドキュメント
- 仕様書: SPEC.md

### ドキュメントの扱い方(重要)
- 実装前に、該当機能の仕様書の該当箇所を必ず読む
- コードと仕様書が矛盾する場合は仕様書を正とする
- 仕様変更はコードより先に仕様書を更新する(仕様書ファースト)
- 上記ファイルの内容はこのCLAUDE.mdに転記しない

## 守るべき制約
- 破壊的コマンド(rm -rf、git push --force、データ削除)は実行前に必ず確認を取る
- 認証は自前実装しない(必要になったら実績あるライブラリ/サービスを使う)
- コードスタイルは ESLint / Prettier に従う(このファイルには書かない)
Step 5:最小規模の実装
一度で完成を目指さないことが重要。
一度に複数機能を頼むと、どこかでバグが混入して原因の特定が困難になる。
まず仕様書を渡して、最低限の機能のみ指定して土台を作る。
デザインも後回しでよい。
仕様書(`SPEC.md`)に記載の「リンク保存機能」を実装してください。

その他の機能は実装しないでください。
確認が必要な点がある場合は、憶測で決めずに事前に確認してください。
- NG 例
- 一度に多数の機能を実装させる
- 実装させる機能をプロンプトに記載していない
- AIが仕様書に記載の全機能を実装してしまう可能性大
1つ機能を実装したら、Step6 へ移る。
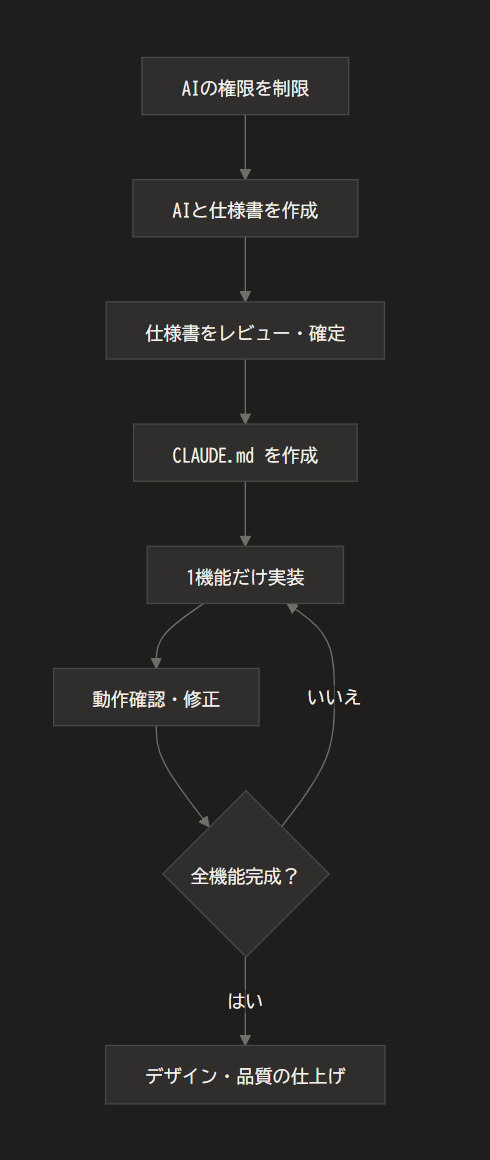
Step 6:確認・修正・実装のループを回す
実装されたものの動作確認・エラーがあれば修正を行う。
基本サイクル
機能一部実装(Step5) → 手動で動作確認 → 問題をAIに伝える → 修正 → 機能一部実装...
- エラーが出たとき
エラーメッセージをそのままコピペして調査させる。
以下のエラーが発生しました。原因と修正方法を調査してください。

【エラーメッセージ】
(エラーメッセージを貼り付ける)

【該当コード】
(エラーが起きているコードを貼り付ける)
- 動作が期待と違うとき
何が起きているか・何を期待しているかをセットで伝える。
リンクを「読んだ」にしても、一覧から消えません。

【現在の動作】
「読んだ」ボタンを押しても、そのリンクが一覧に表示され続ける

【期待する動作】
「読んだ」ボタンを押したら、即座にそのリンクが一覧から消える
- 仕様変更をしたいとき
仕様変更時は必ず仕様書を更新してからコードに反映する。
# Step1: 仕様書の変更をAIに依頼
仕様書(`SPEC.md`)を以下の内容で変更してください。

タグを1つだけでなく、複数付けられるようにします。

まだ実装には移らず、仕様書の変更のみに留めてください。

# Step2: 更新した仕様書をもとに実装
更新した仕様書(`SPEC.md`)に基づいて、タグを複数設定できるように変更してください。
- コードレビューを依頼する
機能が動いたタイミングで、定期的にコードの品質をチェックさせるとよい。
現時点のコードをレビューしてください。
以下の観点で問題があれば指摘してください。

- バグが発生しやすい箇所
- パフォーマンス上の問題
- セキュリティ上の懸念
- 読みにくいコード
- 備考
- 何度も同じ修正で失敗したら、新しいセッション(クリーンなコンテキスト)で始める。コンテキストによる失敗の履歴ではなく仕様書やエラー文を引き継ぐ。
Step 7~:デザイン・品質の仕上げ
機能が揃ったら最後に全体を整える。
UIの改善・リリース前の点検など、アプリ全体に横断的にかかわる品質を扱う。
これらの仕様も厳密に定める場合は、仕様書に追記or別途作成するようにする。
- デザイン作成 例
現在のUIをモダンなデザインに改善してください。
以下の要件で対応してください。

- カラーテーマ:ダークモード対応
- フォント:読みやすいサイズ感(本文16px)
- 余白:各要素間にゆとりを持たせる
- カード:角丸・薄いシャドウ
- ボタン:ホバー時のアニメーション
- リリース前の各種チェックの例
リリース前の最終確認として、以下を点検してください。
AI生成コードで頻出する観点を重点的にチェックしてください。

1. インジェクション
- SQL/ORM、OSコマンド、コードインジェクション(CWE-94/78)の経路はないか
- ユーザー入力は「信頼できない」前提でバリデーション・サニタイズされているか

2. 認証・認可(最も漏れやすい)
- 全エンドポイントにロールベースアクセス制御がかかっているか
- 他人のデータを取得できてしまう穴(BOLA)はないか
- UI変更で使わなくなったのに、生きたまま残っているAPIエンドポイントはないか

3. 秘密情報
- APIキー・トークン・認証情報がコード・ログ・クライアント側に漏れていないか

4. 依存関係
- AIが追加したパッケージに既知のCVEや、存在しない(ハルシネーション)ものはないか

5. その他のCWE Top 25観点
- 整数オーバーフロー(CWE-190)、無制限ファイルアップロード(CWE-434)など
フロー
全体を通しての原則
-
仕様書ファースト:
実装よりも先に仕様を確定させる。変更も仕様書から行う。 -
1回1機能:
1度のAIへの指示で依頼するのは1機能のみ。欲張るとバグが混入しやすい。 -
Gitでこまめにコミット:
動く状態になるたびにコミットしておく。 -
コンテキストを清潔に保つ:
長くなったらクリア、機能が変わったら新セッション
感想
- 手戻りが目に見えて減った
- 仕様書の段階でAIから質問が来るため、「◯◯が重複したら」「◯◯取得に失敗したら」など、見落としていた事に実装前に気づける
- 仕様書に起こしたことによって、バイブコーディングの品質をかなり維持しやすくなった
- 規模の大きいアプリケーションや、仕様面を厳密に定める必要がある場合は、仕様書を複数ファイルに分割したり、仕様書からテストを作成したテスト駆動開発といった作業が必要になり、記載のやり方では不十分だと感じた。
 簡単30秒