


Slack の「アクティビティ」には @here と @everyone が表示されず、そのせいで対応が必要な投稿を取りこぼすのを予防するために、社内向けの SlackApp を作成しました。
AWS のサーバーレス構成で、固定費 $0、集計1回あたり 1円未満。
1. 作った背景
Slack の「アクティビティ」に @here @everyoneは出ない
Slackの左側メニューにある「アクティビティ」は、自分へのメンションやリアクション、スレッドの返信が集まりとても便利。
ただし紛らわしい点があり、@here と @everyone のメッセージは表示されない仕様となっている。
代替案と課題
キーワード検索に @here や @everyone を入れて検索する方法では、少し手間である上に、そもそも @here のような特殊トークンは対象にならない。
@here 等で送信されるメッセージは「対応不要な告知」であり、仮に検索できたとしても確認しづらいものになってしまう。
=> 抽出したメッセージの中から、要対応かどうかの判定が必要であり、ここを静的ルールで判別するのは難しいのでLLMを使うことにした。
できたもの
実行すると、数分後に DM で以下のような表が届く。
| 判定 | 日時 | 内容 |
|---|---|---|
| 要対応 | 09/26 17:04 | 明日15時までに勤怠の提出が必要 |
| 要対応 | 09/26 11:20 | 環境の確認を依頼 |
| 告知 | 09/25 19:02 | 今夜メンテナンス実施の周知 |
「内容」列は各メッセージの要約で、そのままメッセージへのリンクになっている。既定では告知も含めて全件を出し、only-required を付けると「要対応」と判定されたものだけに絞れる。
| コマンド | 動作 |
|---|---|
/{コマンド} |
過去24時間分 |
/{コマンド} 3d |
過去3日分(3 / 3日 も可、上限7日) |
/{コマンド} only-required |
要対応のみに絞って表示 |
/{コマンド} help |
使い方 |
/{コマンド} delete |
連携解除・トークン削除 |
2. 決めた要件と、やらないこと
やること
- 対象メッセージは
@hereと@everyone - 本人が参加している全チャンネルから取得
- 「作業が必要か」の判定と、60字程度の要約
- 結果は実行した本人にのみDM
やらないこと
@channelを対象にする:アクティビティに表示されるため、通知すると重複する。- メッセージ本文を保存する:社内メッセージをDB等に蓄積しない。取得から送信までを1回の実行で完結させる。
- 「対応済み」ボタンなどの UI:Interactivity エンドポイントを持たない。運用対象を増やさない。
- スレッド内は見ない:これを含むと費用がかさむ上にそもそもスレッド元が検知できていれば問題ないため。
3. 全体構成
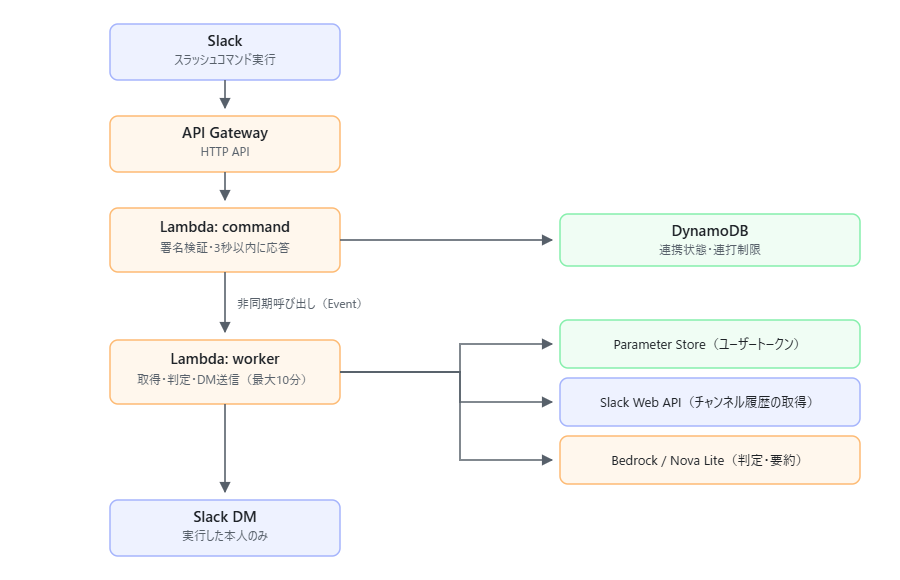
[コマンド実行]
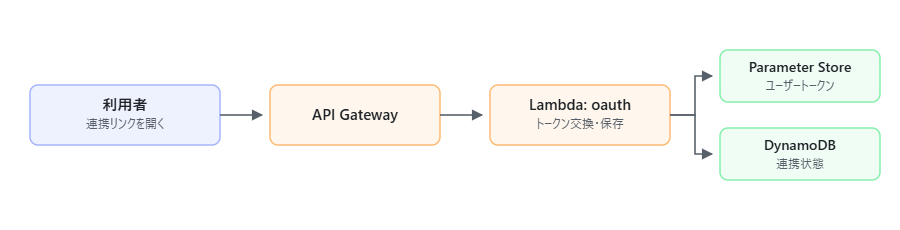
[初回の連携]
| リソース | 役割 |
|---|---|
| API Gateway | Slack からの入口。スラッシュコマンドと OAuth コールバックの2ルートを受ける(HTTP API) |
Lambda command |
コマンドの受付。署名を検証し、worker を非同期で起動して3秒以内に応答を返す |
Lambda oauth |
初回連携の処理。ユーザートークンを受け取って保存し、使い方を DM で案内する |
Lambda worker |
集計本体。履歴の取得・要対応の判定・DM 送信を1回の実行で完結させる |
DynamoDB Users |
連携済みかどうかと連打制限の記録。メッセージもトークンも置かない |
| Parameter Store | 秘密情報の保管。アプリ用3件と、利用者ごとのユーザートークン |
| Bedrock | 「対応が必要か」の判定と、60字程度の要約の生成(Nova Lite / Converse API) |
IaC は AWS SAM、言語は Python、外部ライブラリは boto3 のみ(Lambda Layer なし)。VPC,SQS,Secrets Manager なし。
コマンド実行時の Lambda を2本に分けた理由
Slack のスラッシュコマンドは 3秒以内に応答しないとタイムアウトする。一方で実処理は、60チャンネルで約1分20秒かかる見込み(Slack側のconversations.history レート制限のため、1チャンネルごとに 1.2 秒空けて直列に呼ぶようにしているため)。よって以下の構成に分けた。
command: 署名を検証して、引数を解釈して、workerを非同期で叩いて、「集計しています」と即返すworker: 取得・判定・DM 送信を最大10分かけてやる
4. 設計方針
何の権限で読むか
Slack でチャンネルの履歴を読む方法は、
- Botトークン
- ユーザートークン
の2パターン。前者はBotをそのチャンネルに招待する必要があり、今回の用途に向かない。 後者は、その人(利用者)が参加しているチャンネルを、その人の権限で読める。 よってメッセージの取得はユーザートークンを利用した。(集計結果のDM送信などにはBotトークンを利用)
利用した権限
| 種別 | スコープ |
|---|---|
| User Token | channels:read channels:history groups:read groups:history |
| Bot Token | chat:write commands |
ユーザートークンは、利用者ごとに OAuth を通す必要がある。初めて利用するユーザーには、本人にのみ表示される連携リンクから連携する必要がある。(Lambda oauth で実現)
LLM に「対応が必要か」を判定させる
依頼・期限・回答要求・提出物があれば要対応、周知・共有・完了報告は不要 としてカテゴリ分けする作業において、AWS Bedrock(LLM: Nova Lite)を利用した。
「任意である依頼」メッセージの分類に苦労した。
- 「来週の勉強会、興味のある方はぜひご参加ください」→ 不要
- 「任意ですが、希望者は本日17時までにご回答ください」→ 不要(期限はあるが任意)
- 「参加は任意ですが、出欠だけは全員必ずご回答ください」→ 要対応
素朴なプロンプトだと「期限がある」「〜してください」に反応してほとんど要対応判定になってしまう。
依頼を内容ごとに分けて洗い出し、1つでも必要なものがあればメッセージ全体を要対応にする といった手順を指示した上で、判定が割れる境界を入力・判定・理由の3点セットで並べて渡すことによって、正しく判別させるようにした。。
また、各メッセージの要約も同時に行い、併せて返すようにした。
迷ったら「要対応」にする
目的は見落とし防止なので、余分に表示されるのは許容して、取りこぼすのは問題として扱った。
以下のような場合、全て要対応扱いにし、DMが返るように決めた。
- 応答が JSON として壊れた
- 一部のメッセージの判定が返ってこなかった
- Bedrock の呼び出しが失敗した
- 要対応なのか、不要なのか判断がつかない
判定結果は配列の順序ではなく、メッセージに振ったIDで突き合わせるようにした。(配列だとLLMが1件欠落させた場合や順序がおかしくなった場合などに、判定結果が別のメッセージに紐づいてしまいエラーに気づきにくくなってしまうため)
5. コスト設計
なるべく低コストになるようにした。
| 金額 | |
|---|---|
| 固定費 | $0 |
| 集計1回 | 約 $0.001034 ≒ 0.16円 |
| 月30回 | 約 $0.031 ≒ 5円 |
※ 上記の集計1回の金額は、過去7日間を対象として集計対象として実行した金額の場合。1日(24時間)を対象とした場合はもっと金額は下がる。
実測の基準は、約60チャンネル / 約350メッセージ走査 / 約10件抽出 / 約70秒の1回。内訳は Lambda の実行時間が 60%、Bedrock が 38%、残り全部で 2%(単価は AWS Price List API 東京リージョン。無料枠は考慮していない)。
固定費をかけない
判断したのは以下の2つ。
| 判断 | 回避できた額 |
|---|---|
| Provisioned Concurrency を積まない | 約 $5.5/月 |
| Secrets Manager ではなく Parameter Store | 約 $1.60/月(+$0.40/人) |
コールドスタートは実装側で対応した。 command には3秒制約があり、定番の対策は Provisioned Concurrency だが、これは待機している間も課金される。512MB を1ユニット常駐させるだけで月 $5.5(約820円)と、アプリ本体の実行費用(月5円)の150倍以上になってしまう。よって以下を実施した。
- 重い SDK を入れない
- メモリを512MBにしてCPUを確保
- boto3 クライアントを初期化フェーズで作る
- Parameter Storeの値をキャッシュ 等を
Secrets Manager はシークレット1件あたり月$0.40 で、人数に比例する。 ユーザートークンを1人1件で持つ構成なので、50人なら 53件 × $0.40 = 月 $21(約3,200円)になる。Parameter Store の Standard は1万件まで無料なので、費用を抑えられる。
1回あたりの費用を削る
集計1回の費用は、Lambda実行時間と Bedrockのトークン数がほとんど。どちらもメッセージ件数に比例する。
| 判断 | やらなかった場合 |
|---|---|
| LLM を20件ずつバッチ処理する | +39% |
| スレッドを取得しない | +33%(件数に比例) |
chat.getPermalink を呼ばず URL を組み立てる |
+8% |
1件ずつ投げると指示文を件数ぶん重複して払うことになるため、バッチ処理を利用(プロンプトの指示文(約800トークン)を件数で割れる)。
以下2つはどちらも「メッセージ1件につき1回ずつAPIを呼ぶ」形になるのが共通している。Slackレート制限対策で呼び出しごとに 1.2 秒空けているため、件数は増えすぎないようにしたい。
- スレッド :中の返信まで見るには、親メッセージごとに API を呼ぶ必要がある。親のメッセージが取れれば問題ないため、取得しない方針に決定。
- permalink :DM の表で要約のリンク先に使っている、メッセージ個別の URL。
chat.getPermalinkで取得できるが、https://という決まった形なので、取得済みの情報から組み立てれば API を呼ばずに済む。.slack.com/archives/ /p
費用が想定外に膨らまないよう、上限も2つ設けた。
- API Gateway のスロットリング :署名検証より手前で弾かれるため、意図しない大量アクセスを受けても Lambda が起動せず課金されない。
- Bedrock の
maxTokens:性能調整ではなく、暴走時の保険として、モデルが繰り返しに陥っても1回規定のトークン数で止まるように設定。
用途に合ったモデルを選ぶ
今回LLMにやらせるのは「対応が必要かどうかの判定」と「メッセージ内容の要約」だけで、画像生成や複雑な推論といったことは行わないので高度なモデルは必要ない。
判定基準をプロンプト側で詰めれば軽量モデルで十分だったので、Amazon Nova Lite を採用した。
6. 仕様書駆動開発のバイブコーディング の活用
アプリ(lambda)の実装部分はバイブコーディングを活用した。ただし闇雲に進めるのではなく、先に仕様書を作成し、その仕様書を元にAIにバイブコーディングさせる形(仕様書駆動開発)にしたことによって、品質とスピードを両立させることができた。
- 1ステップずつ段階的に実装する :仕様書を渡して一気に最終形を作ろうとすると、どこがどう動いているのか分からない上にバグ等の温床になる。複数のステップに実装を分け、1ステップずつ動作確認してから次へ進めるように決めた。
- やらないこと や 守るべき制約 を仕様書に章として記載する。:AI エージェントは良かれと思って勝手に余計なことをするので、制約を根拠と併せて仕様書に記載した。
7. おわりに
当初の目的だった「アクティビティに出ない @here / @everyone を取りこぼさない」は達成できた。
実装はバイブコーディングで進めたが、先に仕様書を書いたぶん手戻りはほとんどなかった。
コストも月5円以下と、思っていたよりもかなり低価格で作ることができたのも満足しています。
また、アプリケーションに LLM を組み込んだのは初めてで、成功(正しい形式で返る)前提で組むと壊れることを実感した。応答が壊れたときや欠落したときにどちらへ倒すかは、目的(今回では、見落とし防止)から逆算して人間が決めていく必要があると分かり、良い経験になりました。
 簡単30秒