


はじめに
DX開発事業部の田村です。
AWS にあるデータを BigQuery の分析に混ぜたい場面があります。これまでは、Amazon S3 から BigQuery にコピーするか、BigQuery Omni で S3 のデータをその場で読む方法がありました。
Borderless Lakehouse(旧 Cross-cloud Lakehouse)は、AWS Glue にある Iceberg テーブルを、コピーせずに BigQuery から読める機能です。
発表は2026年4月22日で、6月5日に Glue に対応し、7月31日に今の名前になりました(Preview)。
今回はGoogle の公式ブログにGlue、Databricks、Snowflake をつないで JOIN し、会話型分析で聞く手順が載ったので、試してみました。
AWS にデータがあり、BigQuery で分析している方に向けた記事です。
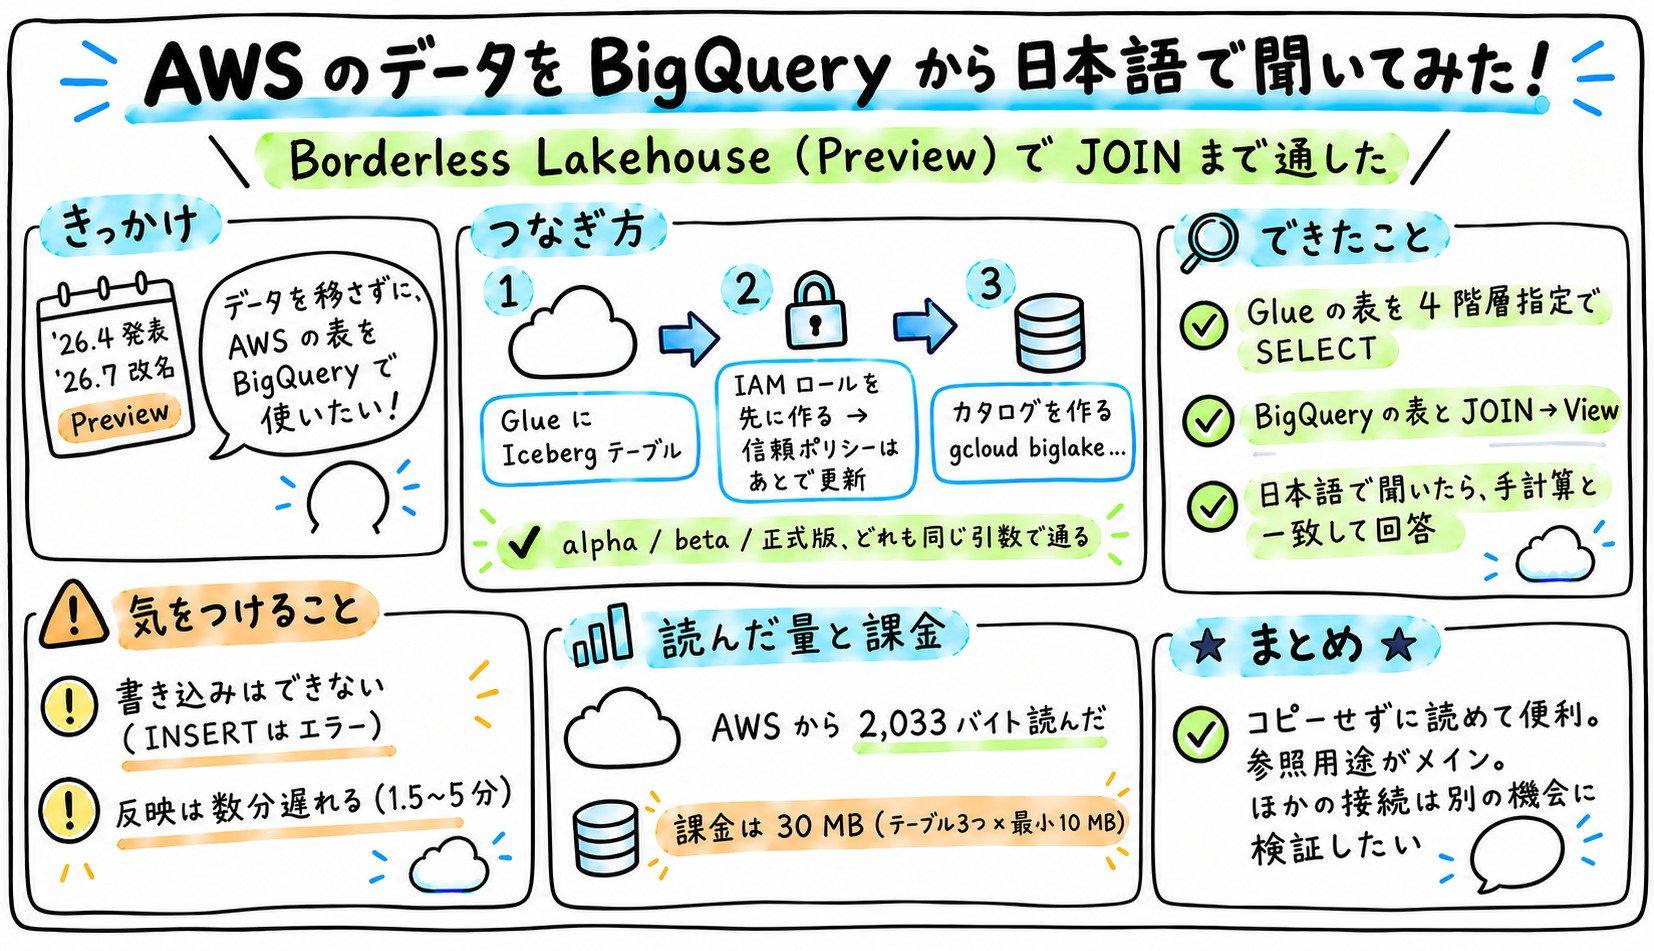
TL;DR
Borderless Lakehouse とは
AWS や Databricks のカタログを Federated Catalog として BigQuery に登録する機能です。Federated Catalog は、外部のカタログを、BigQuery の中のカタログのように見せる仕組みです。メタデータは、決めた間隔で同期されます。
クエリの時は S3 の Parquet を直接読み(読んだデータは、Google Cloud 側に一時的にキャッシュされることもあります)、計算は BigQuery の中で行いますので、Glue 側のコンピュート自体は使用されないようです。
対応しているカタログは次のとおりです(2026年10月19日時点)。
| カタログ | 置いてある場所 |
|---|---|
| AWS Glue | AWS |
| Databricks Unity Catalog | AWS、Google Cloud |
| Snowflake Horizon Catalog | AWS、Google Cloud |
| SAP Business Data Cloud | AWS、Azure、Google Cloud |
| Workday Data Lake | AWS、Google Cloud |
Azure 上の Databricks や Snowflake は、この表に載っていません。Azure Storage(ADLS)のデータを扱う場合は、Google Cloud ブログによると cross-cloud connections(Preview)という仕組みがあるようですが、今回は試しておりません。
やってみた
検証は gcloud 586.0.0 で行いました。
リージョンは、Google Cloud も AWS も東京です。公式の手順では、BigLake API の有効化と、カタログを作るユーザーへの BigLake 管理者(roles/biglake.admin)の付与が前提です。
AWS 側に Iceberg テーブルを置く
Amazon Athena で Iceberg のテーブルを作ります。
CREATE TABLE lakehouse_verify_db.dim_stores (
  store_key int, store_id string, store_name string,
  city string, state string, region string,
  manager string, opened_date date
)
LOCATION 's3://lakehouse-verify-123456789012/retail/dim_stores/'
TBLPROPERTIES ('table_type'='ICEBERG', 'format'='parquet', 'write_compression'='zstd');
INSERT INTO lakehouse_verify_db.dim_stores VALUES
  (1, 'S001', 'Shibuya', 'Tokyo', 'Tokyo', 'Kanto', 'manager_a', DATE '2020-04-01'),
  (2, 'S002', 'Umeda', 'Osaka', 'Osaka', 'Kansai', 'manager_b', DATE '2021-06-15'),
  (3, 'S003', 'Sakae', 'Nagoya', 'Aichi', 'Chubu', 'manager_c', DATE '2022-09-01');
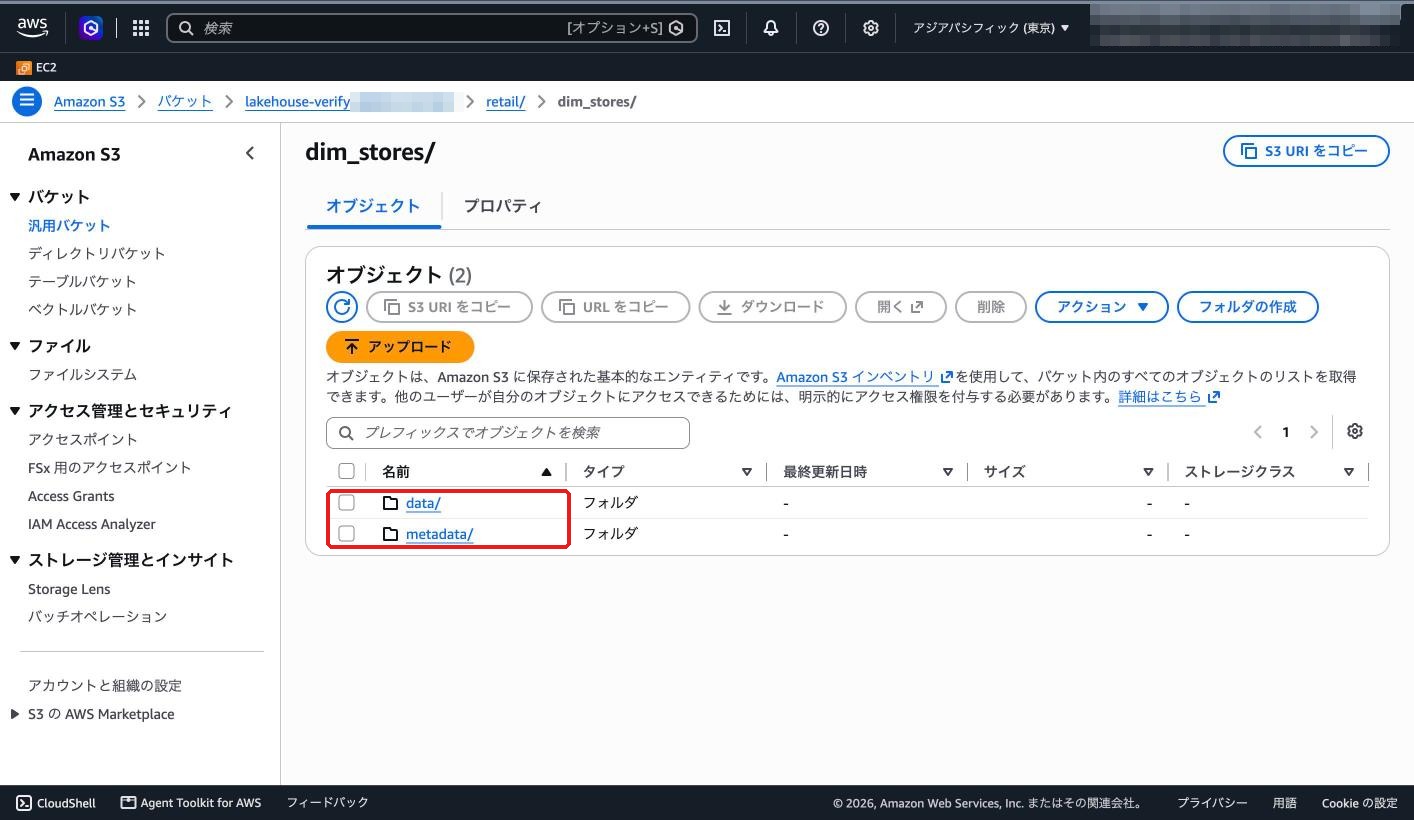
ダミーデータを3行分入れており、S3 には data/ と metadata/ がそれぞれ作成されました。Glue のコンソールでも、テーブル形式が Apache Iceberg になっています。
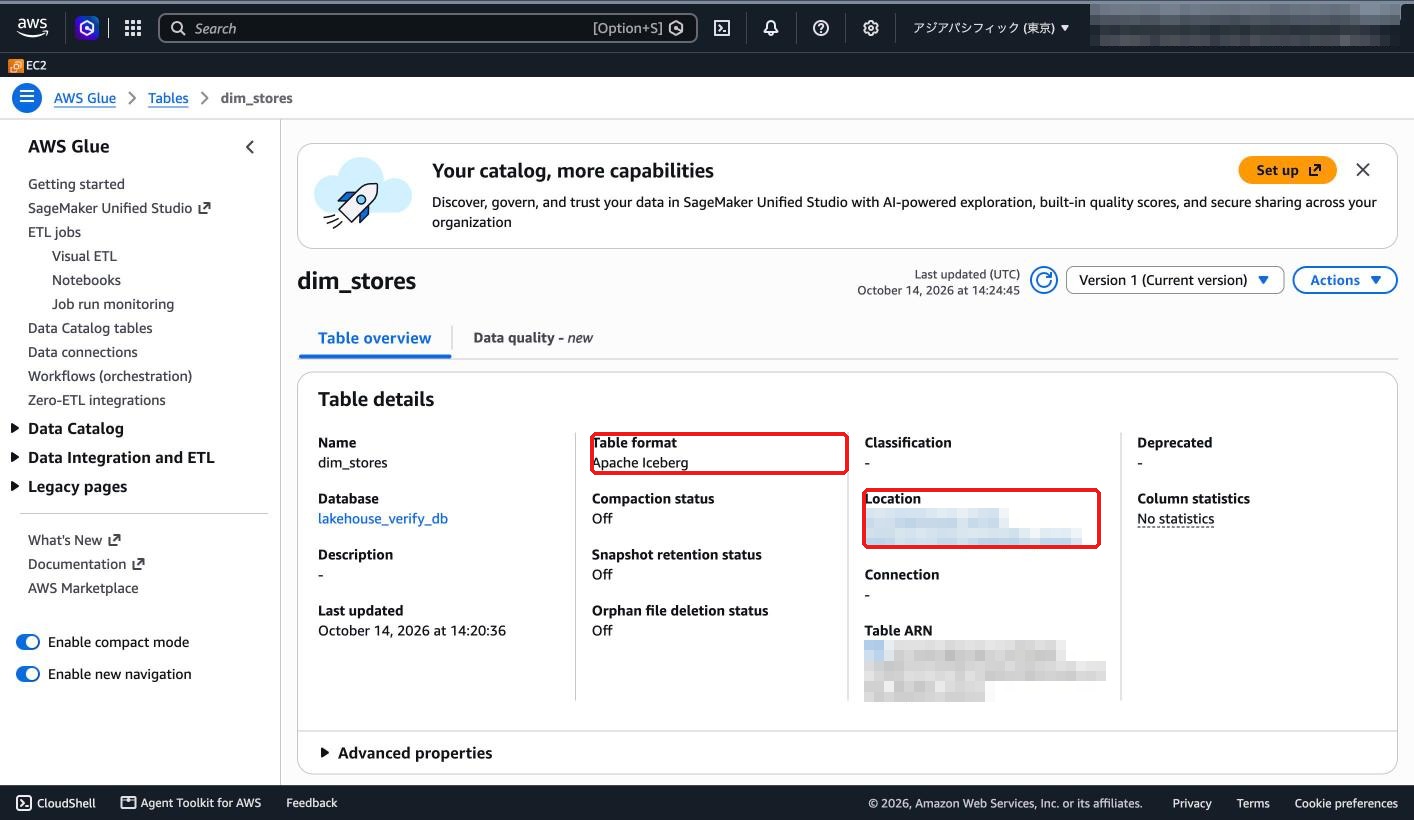
dim_products は、あとで反映の時間を計るために追加したテーブルです。作り方は dim_stores と同じで、列は product_key、product_name、category、price の4つです。
CREATE TABLE lakehouse_verify_db.dim_products (
  product_key int, product_name string, category string, price decimal(10, 2)
)
LOCATION 's3://lakehouse-verify-123456789012/retail/dim_products/'
TBLPROPERTIES ('table_type'='ICEBERG', 'format'='parquet', 'write_compression'='zstd');

INSERT INTO lakehouse_verify_db.dim_products VALUES
  (101, 'Laptop Pro', 'Electronics', 129800.00),
  (102, 'Wireless Mouse', 'Electronics', 2980.00),
  (103, 'Desk Chair', 'Furniture', 45000.00);
IAM ロールの作成
BigQuery は、Google の ID で AWS の IAM ロールを引き受けます。そのため、ロールの信頼ポリシーには、BigQuery 側のサービスアカウントの ID を書きます。
この ID はカタログを作るまで分かりませんが、カタログを作るコマンドではロールの ARN を指定する必要があり、ロールとカタログのそれぞれは先に相手の情報が必要になります。
そこで、先にロールを作ります。ID はまだ分からないので、信頼ポリシーには PLACEHOLDER_VALUE を入れておき、カタログができてから更新します。
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": { "Federated": "accounts.google.com" },
    "Action": "sts:AssumeRoleWithWebIdentity",
    "Condition": { "StringEquals": {
      "accounts.google.com:aud": ["PLACEHOLDER_VALUE"],
      "accounts.google.com:sub": ["PLACEHOLDER_VALUE"]
    }}
  }]
}
許可ポリシーは、Glue のカタログ、データベース、テーブルの読み取りと、S3 のバケットとオブジェクトの読み取りだけです。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["glue:GetCatalog", "glue:GetDatabase", "glue:GetDatabases", "glue:GetTable", "glue:GetTables"],
      "Resource": [
        "arn:aws:glue:ap-northeast-1:123456789012:catalog",
        "arn:aws:glue:ap-northeast-1:123456789012:database/lakehouse_verify_db",
        "arn:aws:glue:ap-northeast-1:123456789012:table/lakehouse_verify_db/*"
      ]
    },
    {
      "Effect": "Allow",
      "Action": ["s3:ListBucket", "s3:GetObject"],
      "Resource": ["arn:aws:s3:::lakehouse-verify-123456789012", "arn:aws:s3:::lakehouse-verify-123456789012/*"]
    }
  ]
}
カタログを作る
公式の手順は gcloud alpha ですが、リファレンスにはトラックなしのページもあります。筆者の環境(gcloud 586.0.0)では、alpha、beta、正式版のどれでも同じ引数で通ったので、ここでは正式版で書きます。
export PROJECT_ID=your-project AWS_ACCOUNT_ID=123456789012

gcloud biglake iceberg catalogs create lakehouse_verify_glue \
  --project=$PROJECT_ID \
  --primary-location=asia-northeast1 \
  --catalog-type=federated \
  --federated-catalog-type=glue \
  --glue-warehouse=$AWS_ACCOUNT_ID \
  --glue-aws-region=ap-northeast-1 \
  --glue-aws-role-arn=arn:aws:iam::$AWS_ACCOUNT_ID:role/lakehouse_verify_glue_federation_role \
  --refresh-interval=300s
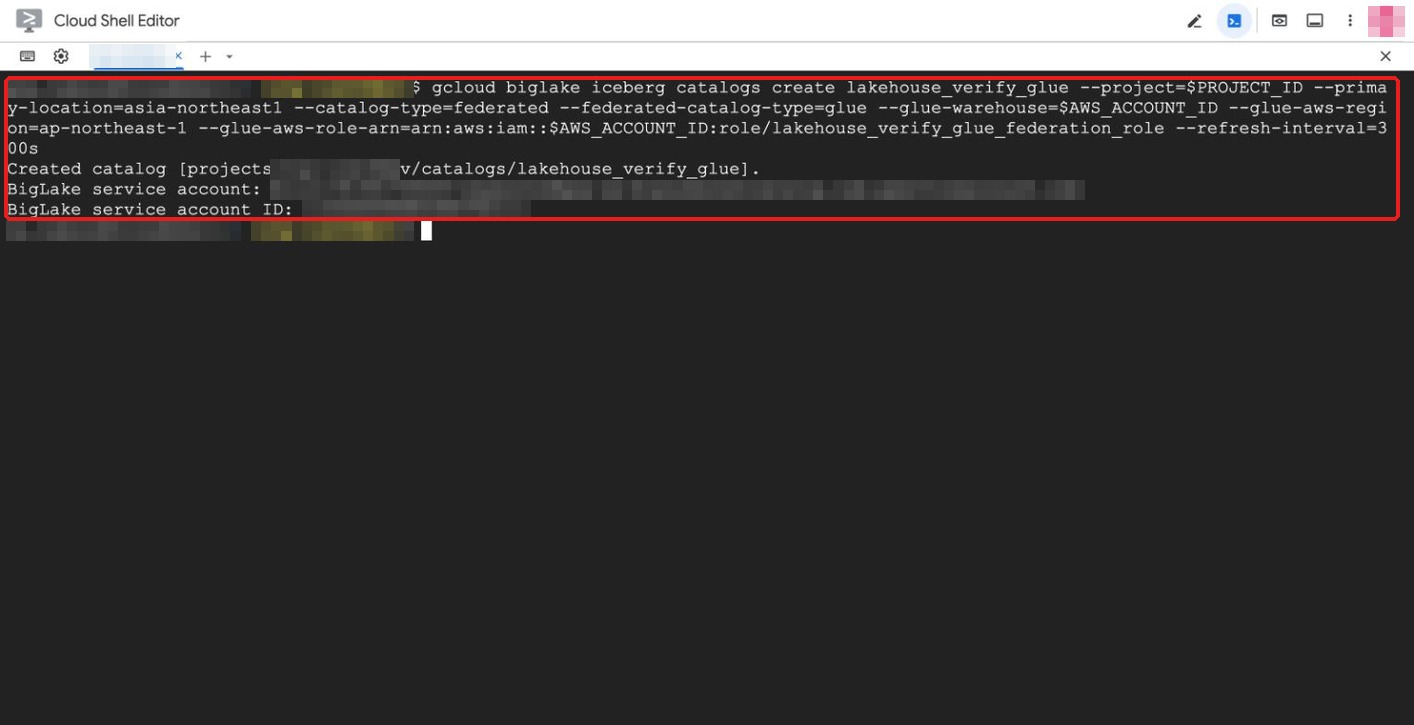
公式の手順では、信頼関係が反映されるまでの同期の失敗を避けるため、作成時は更新間隔を指定しないとされています。今回は指定したまま作成しましたが、最初の同期は、信頼ポリシーの更新後に始まり、成功しました。
出力に BigLake のサービスアカウントとその ID が出ます。この ID を、ロールの信頼ポリシーの aud と sub(どちらも同じ値)に入れて更新します。
aws iam update-assume-role-policy \
  --role-name lakehouse_verify_glue_federation_role \
  --policy-document file://trust_policy.json
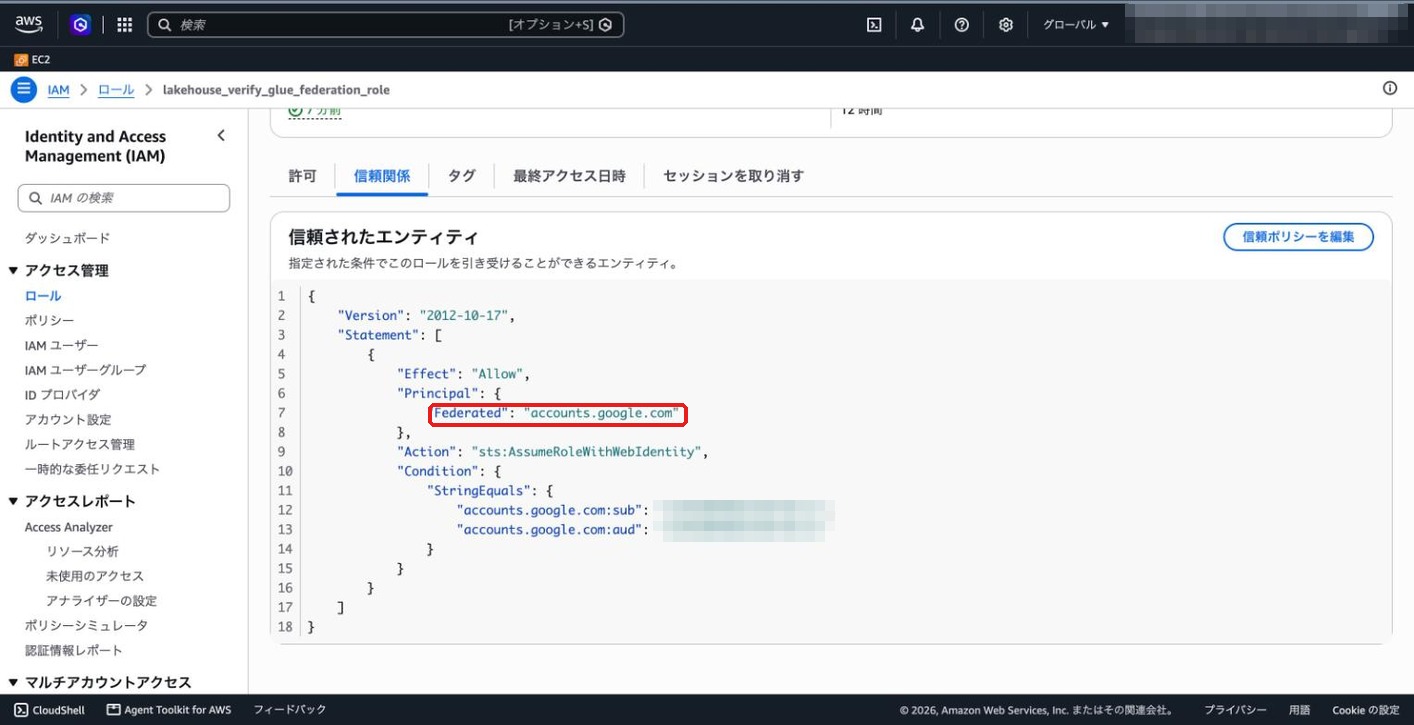
trust_policy.json は、先ほどの JSON の PLACEHOLDER_VALUE を、その ID に置き換えたものです(ID は例です)。aud と sub は、BigQuery 側のサービスアカウントの ID と一致したときだけ、ロールを引き受けられるようにする条件です。
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": { "Federated": "accounts.google.com" },
    "Action": "sts:AssumeRoleWithWebIdentity",
    "Condition": { "StringEquals": {
      "accounts.google.com:aud": ["123456789012345678901"],
      "accounts.google.com:sub": ["123456789012345678901"]
    }}
  }]
}
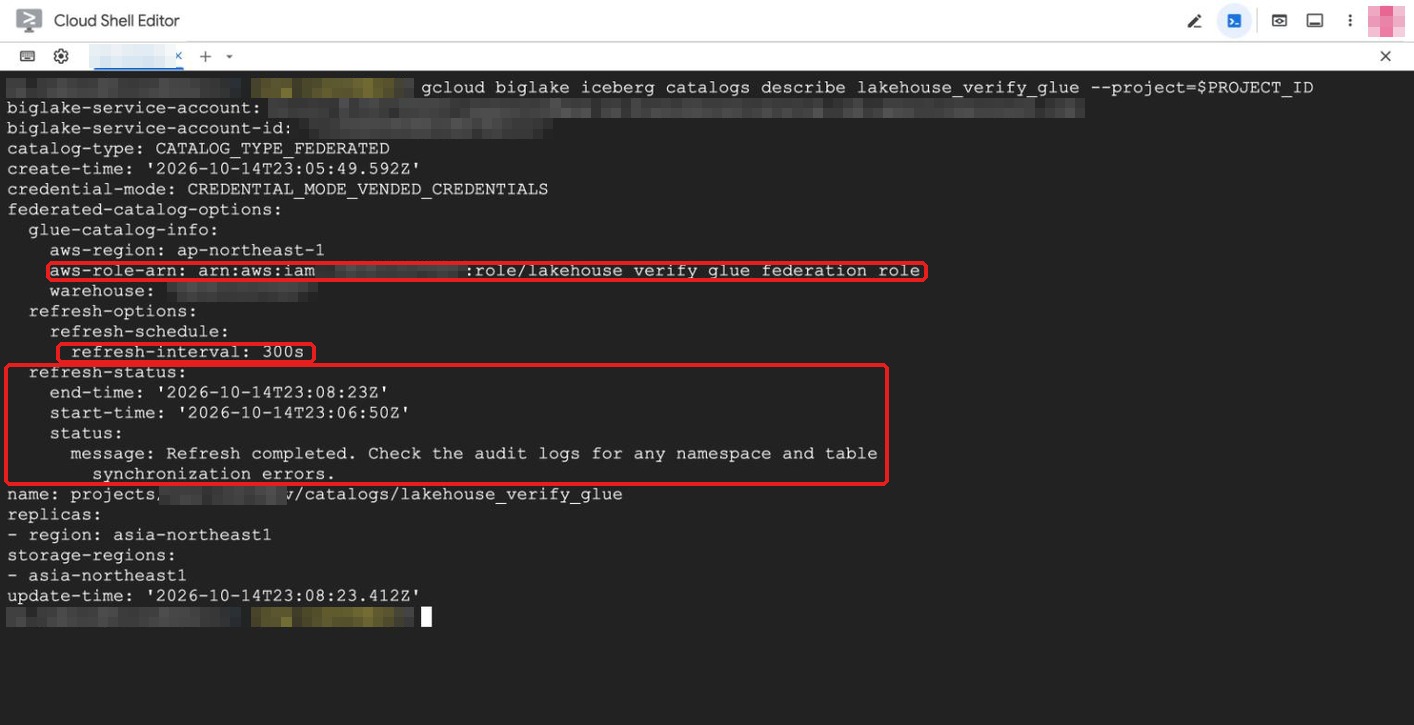
describe で ARN、更新間隔、更新の状況を確認できます。同期が始まると、更新の状況(refresh-status)に、まず start-time だけが出ます。
終わると、end-time と Refresh completed. が出ます。今回は UTC で開始 23:06:50Z、終了 23:08:23Z で、約93秒でした。更新間隔の300秒とは別に、更新そのものにも時間がかかるようです。
データを読んでみた
最初に試したときは、同期が終わる前に一覧を見て、0件でした。refresh-status に end-time が出るまで待ちます。
BigQuery では、プロジェクト、カタログ、データベース、テーブルの4階層で指定します。
SELECT *
FROM `PROJECT_ID.lakehouse_verify_glue.lakehouse_verify_db.dim_stores`
ORDER BY store_key
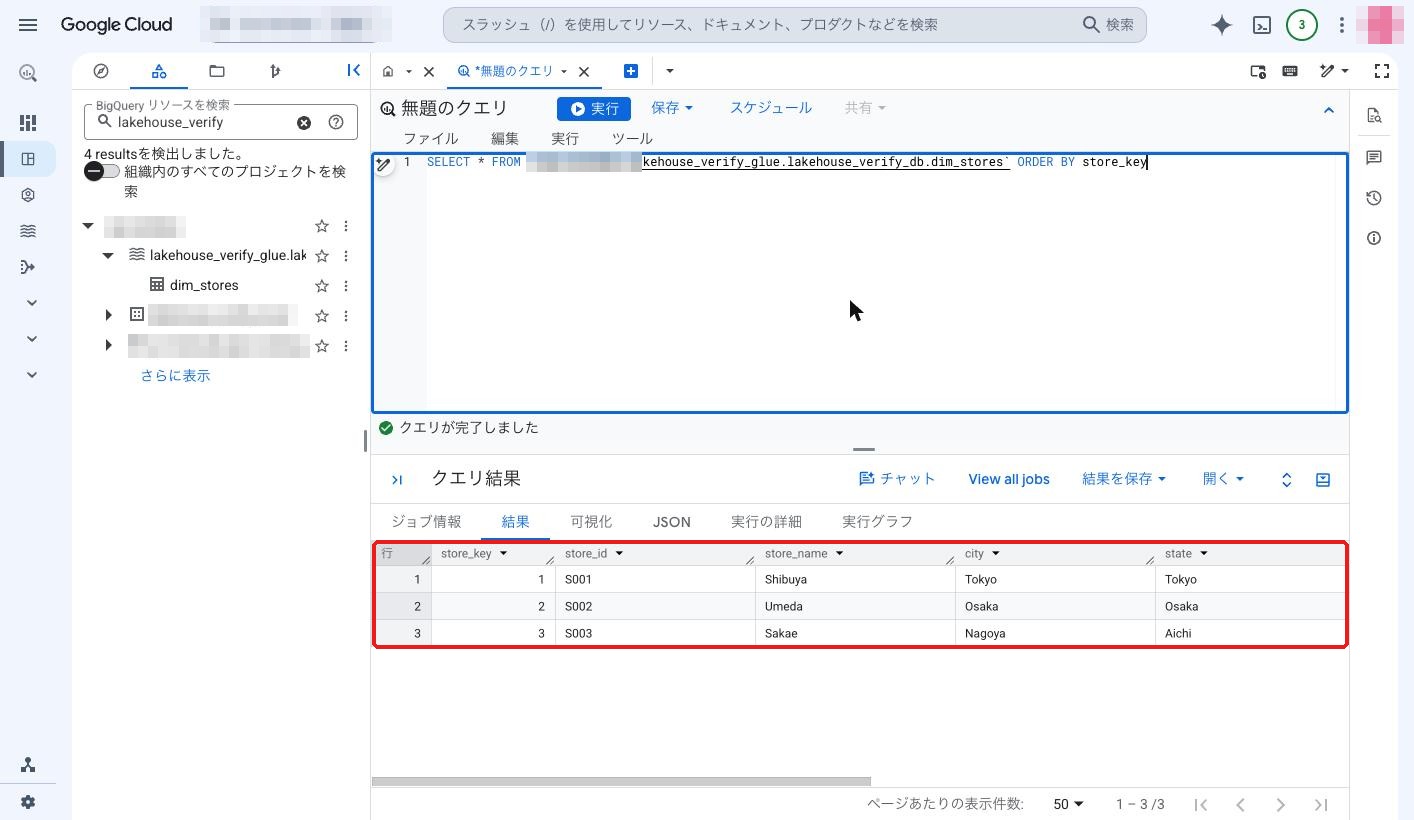
AWS で入れた3行が、BigQuery の画面にそのまま出ました。
JOIN して聞いてみた
ただ読めるだけなら目新しくはないので、普通のテーブルと同じ感覚で BigQuery の自然言語による会話型分析ができるかを試してみました。
BigQuery の表と JOIN する
fact_sales は、BigQuery に次のダミーデータで作りました。
CREATE OR REPLACE TABLE `PROJECT_ID.lakehouse_verify_local.fact_sales` (
  sale_id STRING,
  sale_date DATE,
  product_key INT64,
  store_key INT64,
  quantity INT64,
  total_revenue NUMERIC
);

INSERT INTO `PROJECT_ID.lakehouse_verify_local.fact_sales` VALUES
  ('T001', DATE '2026-10-01', 101, 1, 2, 259600),
  ('T002', DATE '2026-10-01', 102, 2, 5, 14900),
  ('T003', DATE '2026-10-02', 103, 3, 1, 45000),
  ('T004', DATE '2026-10-03', 101, 2, 1, 129800),
  ('T005', DATE '2026-10-03', 102, 1, 3, 8940),
  ('T006', DATE '2026-10-04', 103, 1, 2, 90000);
BigQuery の fact_sales(普通のテーブル)と、Glue の dim_stores、dim_products を JOIN します。
SELECT
  s.store_name,
  s.region,
  p.product_name,
  p.category,
  SUM(f.quantity) AS total_units,
  SUM(f.total_revenue) AS total_revenue
FROM `PROJECT_ID.lakehouse_verify_local.fact_sales` f
JOIN `PROJECT_ID.lakehouse_verify_glue.lakehouse_verify_db.dim_stores` s
  ON f.store_key = s.store_key
JOIN `PROJECT_ID.lakehouse_verify_glue.lakehouse_verify_db.dim_products` p
  ON f.product_key = p.product_key
GROUP BY 1, 2, 3, 4
ORDER BY total_revenue DESC
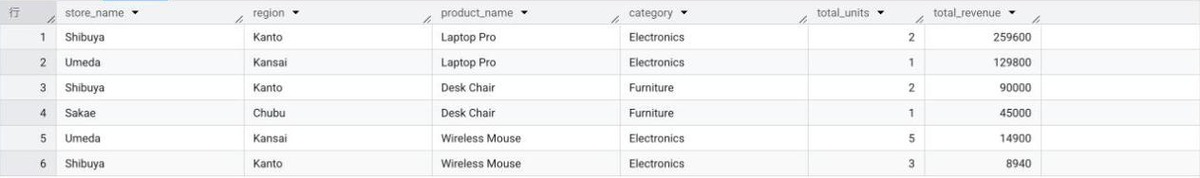
SELECT と JOIN では、Glue のテーブルも手元のテーブルも区別がありませんでした。
View にして会話型分析に渡す
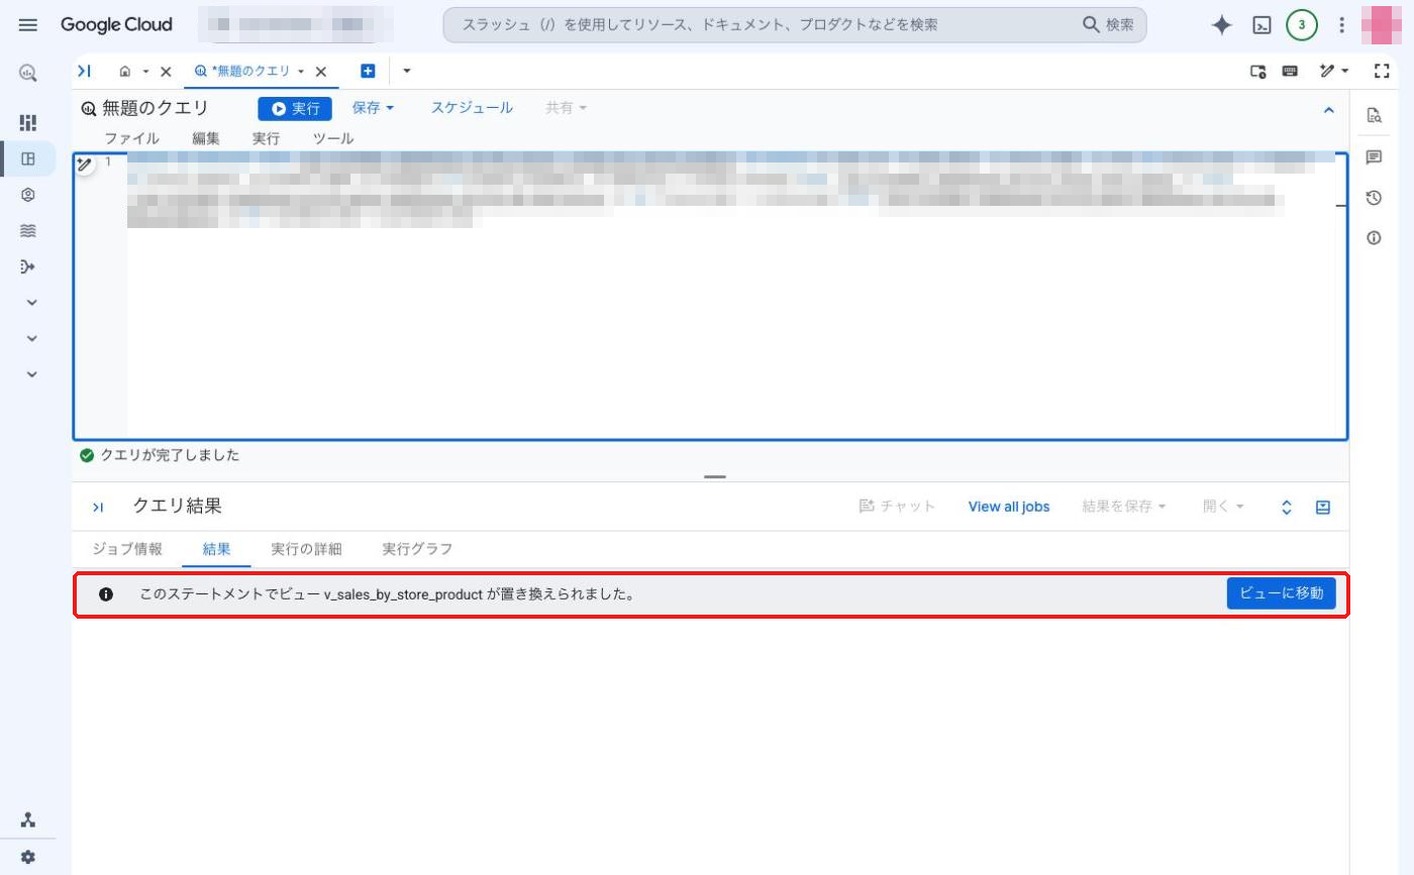
まずはこの JOIN を View にしておきます。
これにより会話の対象を View 1つにしておくと、聞く側が JOIN を気にしなくて済みます。
CREATE OR REPLACE VIEW `PROJECT_ID.lakehouse_verify_local.v_sales_by_store_product` AS
SELECT
  f.sale_id,
  f.sale_date,
  s.store_name,
  s.city AS store_city,
  s.region AS store_region,
  p.product_name,
  p.category AS product_category,
  f.quantity,
  f.total_revenue
FROM `PROJECT_ID.lakehouse_verify_local.fact_sales` f
JOIN `PROJECT_ID.lakehouse_verify_glue.lakehouse_verify_db.dim_stores` s
  ON f.store_key = s.store_key
JOIN `PROJECT_ID.lakehouse_verify_glue.lakehouse_verify_db.dim_products` p
  ON f.product_key = p.product_key
日本語で聞く
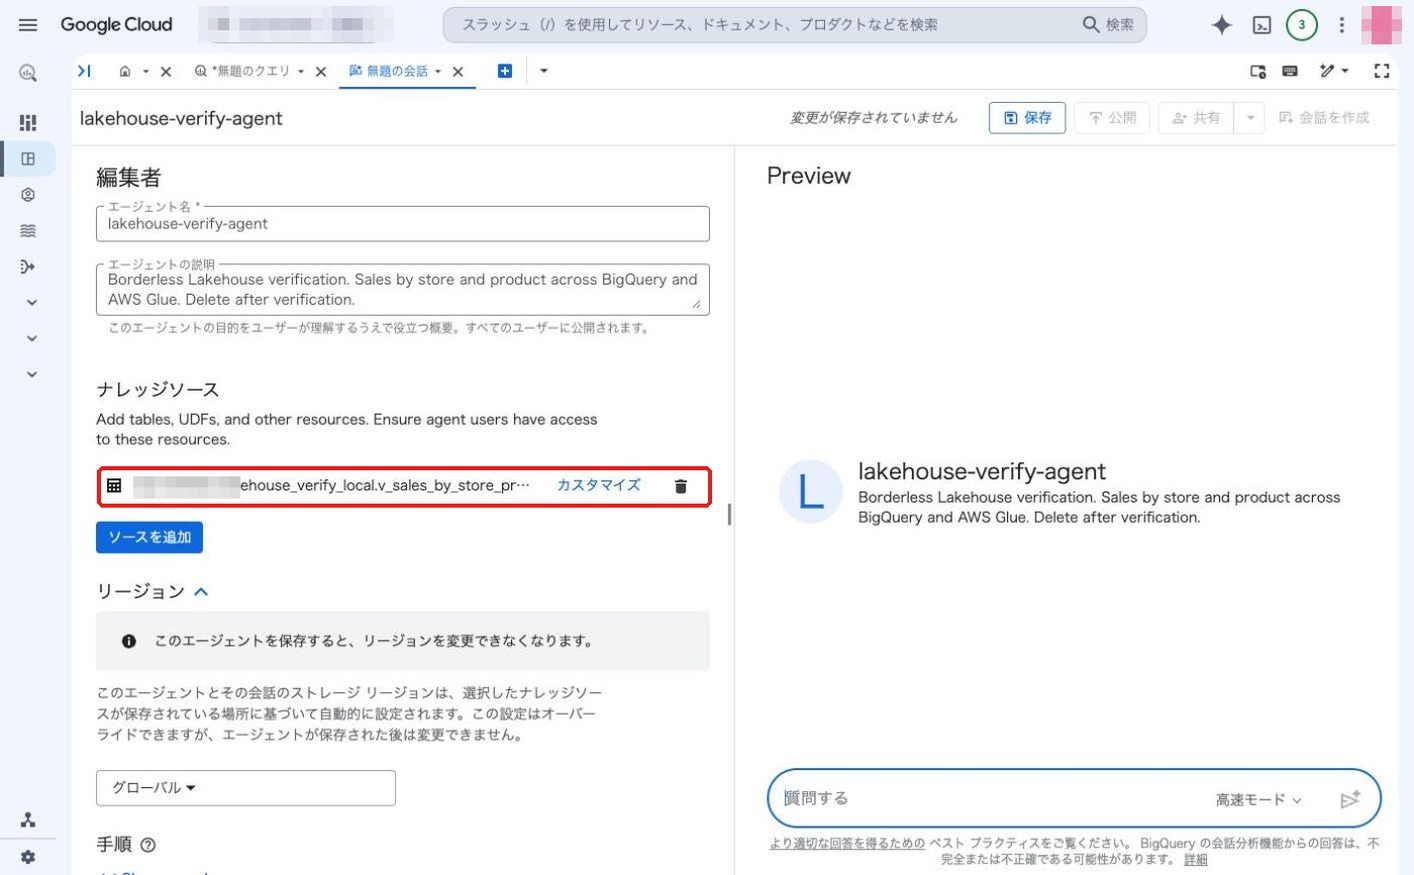
Conversational Analytics のエージェントの設定画面で、ナレッジソースにこの View を指定しました。
質問は次のとおりです。
店舗ごとの総売上を多い順に教えてください。商品カテゴリ別の内訳も見たいです。
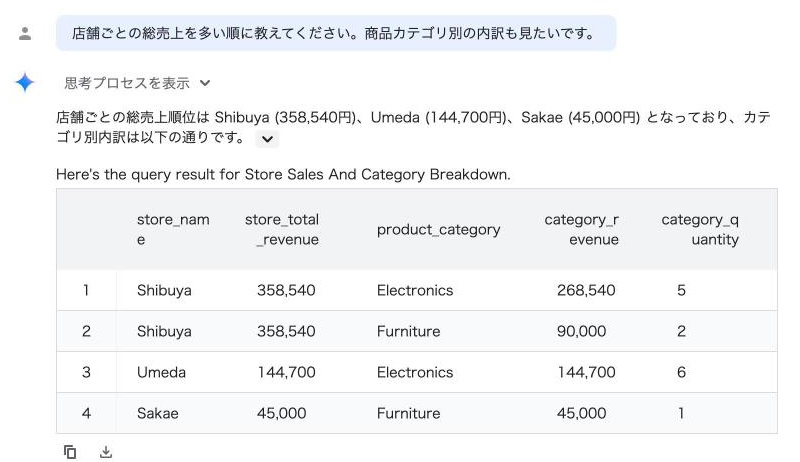
上記の画像の通り、結果が返ってきました。JOIN の結果から足し直してみましたが合っていました。
生成された SQL は、店舗ごとの合計とカテゴリ別の内訳を別々に集計して、店名で JOIN したもののようで、聞いていない構成比(%)を出す列も入っていました。
WITH store_totals AS (
  SELECT
    store_name,
    SUM(total_revenue) AS store_total_revenue
  FROM `PROJECT_ID.lakehouse_verify_local.v_sales_by_store_product`
  GROUP BY store_name
),
category_breakdown AS (
  SELECT
    store_name,
    product_category,
    SUM(total_revenue) AS category_revenue,
    SUM(quantity) AS category_quantity
  FROM `PROJECT_ID.lakehouse_verify_local.v_sales_by_store_product`
  GROUP BY store_name, product_category
)
SELECT
  st.store_name,
  st.store_total_revenue,
  cb.product_category,
  cb.category_revenue,
  cb.category_quantity,
  ROUND(SAFE_DIVIDE(cb.category_revenue, st.store_total_revenue) * 100, 1) AS category_revenue_share_pct
FROM store_totals AS st
INNER JOIN category_breakdown AS cb
  ON st.store_name = cb.store_name
ORDER BY
  st.store_total_revenue DESC,
  cb.category_revenue DESC;
Glue のテーブルだと意識させずに、日本語で答えが返ってきました。データが AWS に残っている会社なら、使いどころは多そうですね。
押さえておくこと
書き込みはできない
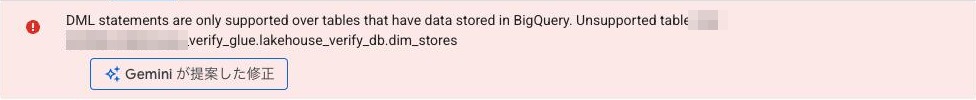
Glue のテーブルに INSERT を打つとエラーになるため、あくまで参照用途がメインになります。
DML statements are only supported over tables that have data stored in BigQuery.
Unsupported table: PROJECT_ID:lakehouse_verify_glue.lakehouse_verify_db.dim_stores
反映はすぐではない
Athena で dim_products を追加してから、BigQuery に見えるまでの時間を、2回計りました。1回目は約1.5分、2回目は5分ちょうどです(日本時間の 11:12:45 に作成して、11:17:50 に一覧に出ました。305秒です)。
更新は300秒ごとに走り、更新の直前に作ると丸ごと待つことになりますので、書いた直後に読みたいユースケースに向いていないです。
読んだ量と課金
JOIN のクエリのジョブの統計を見ると、AWS から何バイト読んだかが分かるようです。
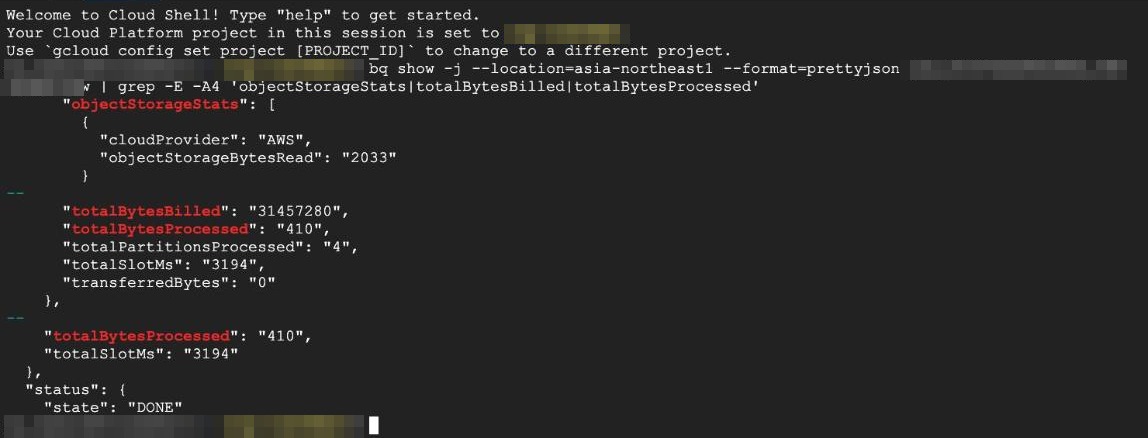
| 項目 | 値 |
|---|---|
objectStorageStats |
AWS から 2,033 バイト |
totalBytesProcessed |
410 バイト |
totalBytesBilled |
31,457,280(30 MB) |
transferredBytes |
0 |
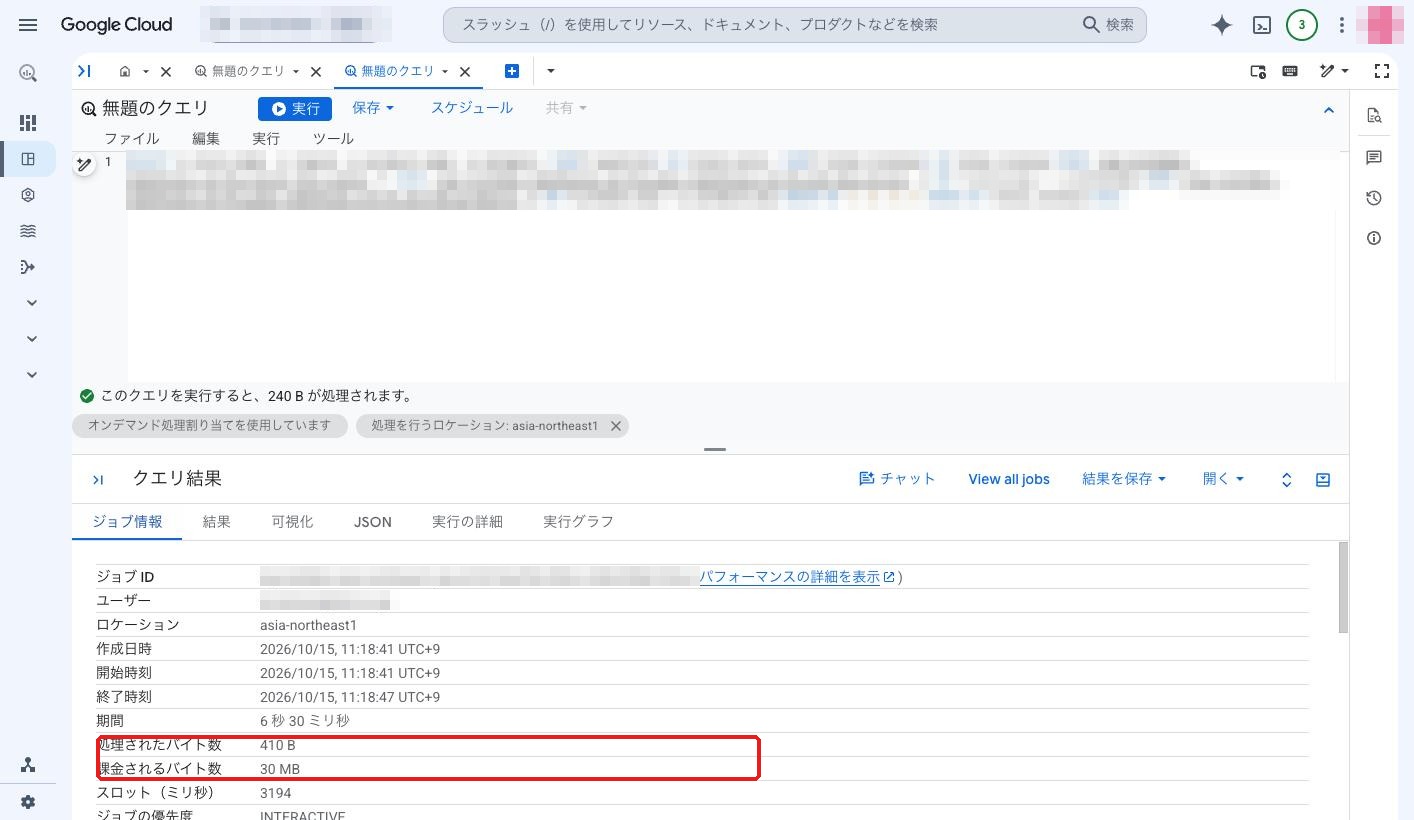
課金は30 MB となっていて、読んだのは約 2 KB でも最小単位は請求されるようです。BigQuery の料金ページには、参照するテーブルごとに最小 10 MB で計算するとあり、今回はテーブルが3つなので、10 MB × 3 で 30 MB になったようです。
公式ブログには cacheBytesRead(キャッシュから読んだ量)を見る手順がありますが、今回は出ませんでした。データが小さすぎて、キャッシュされなかったのだと思います。
まとめ
AWS Glue にある Iceberg テーブルを Google Cloud 側にコピーせずに BigQuery から読むことができ、また JOIN して BigQuery の会話型分析ができた点は便利だと感じました。
各クラウドに閉じたデータをマルチクラウドで分析に使えるようになるという事で、すでに分析基盤を保有している企業も一考の余地がある機能だと感じました。
同期は数分遅れ、書き込みもできないため、日次のレポートやアドホック分析のように、少し古くても読めればよい用途に向いていそうです。
今回は AWS Glue との接続しか試していませんが、Snowflake、Databricks、Azure、大きなデータ、Lake Formation に繋げるとさらに利用範囲が広がると思いますので、別の機会に検証をしてみたいと思います。
参考
- Lakehouse release notes
- About cross-cloud data access
- Cross-cloud conversational analytics with borderless Lakehouse(Google Cloud ブログ)
- Borderless Lakehouse cross-cloud caching and connections(Google Cloud ブログ)
- Set up a cross-cloud connection for AWS Glue
- gcloud biglake iceberg catalogs create
- BigQuery Omni の概要
- Amazon S3 の転送(BigQuery Data Transfer Service)
- BigQuery の料金
 簡単30秒