


はじめに
エンタープライズクラウド事業部の高橋です。
Oracle AI World 2026に現地参加してきました!
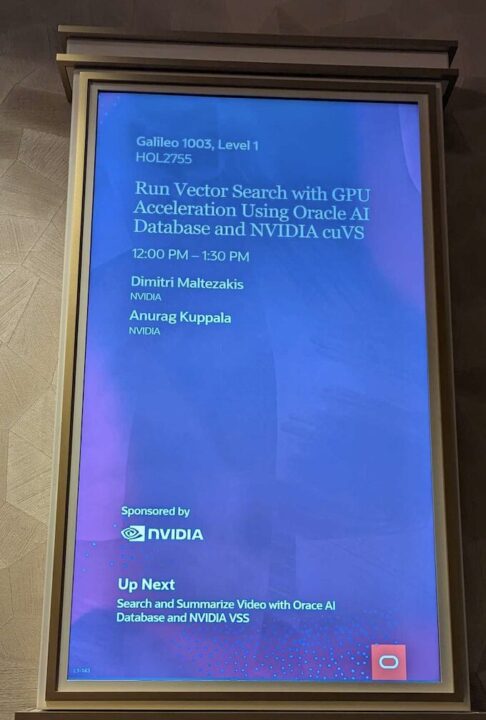
今回は、「Run Vector Search with GPU Acceleration Using Oracle AI Database and NVIDIA cuVS [HOL2755]」に参加しましたので、内容を紹介します。
セッション概要
In this hands-on lab, you will configure Oracle AI Database 26ai to offload index creation to NVIDIA GPUs using NVIDIA cuVS-powered Vector Index Service. You will load embeddings, build an HNSW vector index, compare GPU and CPU index-build performance, and execute semantic similarity searches using SQL. The lab demonstrates how organizations can accelerate the preparation of large vector datasets while keeping vectors, metadata, and business data governed within Oracle AI Database.
このハンズオンラボでは、Oracle AI Database 26aiにおいて、NVIDIA cuVSを活用した「Vector Index Service」を利用し、インデックス作成処理をNVIDIA GPUにオフロードする設定を行います。具体的には、埋め込み(エンベディング)のロード、HNSWベクトルインデックスの構築、GPUとCPUによるインデックス構築パフォーマンスの比較、そしてSQLを用いた意味的類似性検索の実行を体験します。本ラボを通じて、ベクトルデータ、メタデータ、およびビジネスデータをOracle AI Database内で適切にガバナンスしつつ、大規模なベクトルデータセットの準備プロセスを高速化する手法を学びます。
登壇者情報:
Anurag Kuppala, AI Solutions Architect, NVIDIA
Dimitri Maltezakis, Developer Relations – Cloud, NVIDIA
セッション内容
本セッションは、NVIDIAとOracleが共同で提供するハンズオンラボで、GPUを活用したベクトル検索高速化ライブラリ「NVIDIA cuVS」と「Oracle Database 26ai」を連携させる内容でした。
技術紹介の後、実際にOCI環境上でcuVSを使ったベクトルインデックスの作成・検索を体験するという構成です。
ハンズオンで実際に体験した内容を紹介します。
技術紹介として、「NVIDIA cuVS」の説明がありました。
NVIDIA cuVSは、非構造化データをAIが検索可能な形(ベクトル)に変換し、検索するためのライブラリです。
特徴として、インデックス作成、検索、HNSWパラメータ調整、量子化などベクトルのライフサイクル全体をカバーし、既存のベクトルデータベースへの置き換えではなく、組み込みで導入可能です。
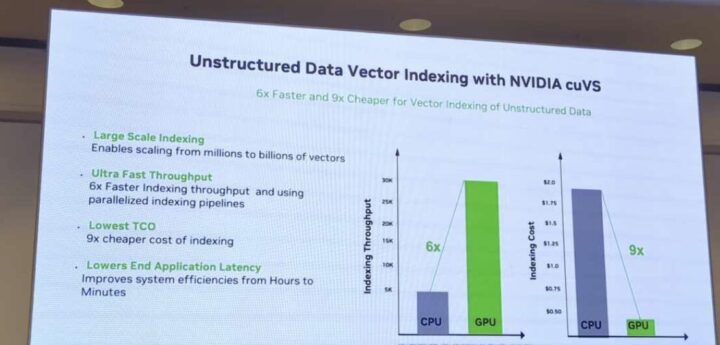
CPUベースの処理と、GPU上でNVIDIA cuVSを使用した処理のベンチマーク結果として、2つの説明がありました。
cuVS単体の性能として、インデックス作成で約6倍、検索スループットで約12倍のGPU優位性が示されました。
また、Oracle DatabaseとcuVSを統合した構成での検証例では、GPU2台構成でCPU8台構成を置き換えられるというケースが示され、CPUのみの構成と比べて少ないノード数で高いスループットを実現できるという説明もありました。
いずれの数値も、使用するデータセットやノード構成に依存するため、注意が必要です。
ハンズオン内容
ハンズオンでは、Oracle Database 26aiとNVIDIA cuVSを連携させ、GPUによるベクトルインデックスのオフロード構築とOracle Database側でのSQL検索を体験する内容でした。
デモは、OCIのKubernetes Engine (OKE)にGPUを割り当てた環境が準備されていました。
参加者にデータベーススキーマとGPUのエンドポイントが割り当てられ、ブラウザ経由のリモートデスクトップ上でコマンドを操作する形式です。
ハンズオンの流れとしては以下でした。
①Oracle Database 26aiに、cuVSを内包した「Private AI Services コンテナ」を接続
②Oracle Database上でサンプルのベクトルデータ(256件)を作成
③CREATE VECTOR INDEX文でHNSW形式のベクトルインデックスをGPU(cuVS)側にオフロードして構築
④構築されたインデックスをOracle Database側に取り込み、SQLから近似最近傍検索(Approximate Nearest Neighbor検索)を実行
各項目で実施した内容を抜粋して紹介します。
①Oracle Database 26aiに、cuVSを内包した「Private AI Services コンテナ」を接続
OKEはあらかじめ準備されていたため、コンテナを起動しました。
NVIDIA A100 GPUが割り当てられたOKEのノード上にコンテナを作成し、Oracle Databaseから呼び出せる状態にしました。
② Oracle Database上でサンプルのベクトルデータ(256件)を作成
DBにはリモートデスクトップ上のターミナルから接続した状態で、サンプルデータを作成しました。
テーブルを作成し、ダミーのデータを256件登録しています。
次の③が本デモでのポイントになるため、一部マスキングしたSQL文を紹介します。
CREATE TABLE SAMPLE_VECTORS (
  id NUMBER PRIMARY KEY,
  embedding VECTOR(8, FLOAT32)
);

INSERT INTO SAMPLE_VECTORS (id, embedding)
SELECT level,
 TO_VECTOR(
  '[' || MOD(level,17) || ',' || MOD(level,19) || ',' ||
  MOD(level,23) || ',' || MOD(level,29) || ',' ||
  MOD(level,31) || ',' || MOD(level,37) || ',' ||
  MOD(level,41) || ',' || MOD(level,43) || ']'
 )
FROM dual
CONNECT BY level <= 256;
COMMIT;
③CREATE VECTOR INDEX文でHNSW形式のベクトルインデックスをGPU(cuVS)側にオフロードして構築
②で作成したサンプルデータに対して、CREATE VECTOR INDEX文でHNSW形式のベクトルインデックスを構築しました。
★今回のデモのポイントだと思う箇所です。
インデックス定義の中に OFFLOAD_URL と OFFLOAD_CREDENTIAL_NAME という2つのパラメータを指定することで、インデックス構築処理をOracle Database自身ではなく、GPU(NVIDIA A100)上で稼働するcuVSのコンテナ側にオフロードします。
一部マスキングしたSQL文を紹介します。
CREATE VECTOR INDEX SAMPLE_VECTORS_IX
 ON SAMPLE_VECTORS (embedding)
 ORGANIZATION INMEMORY NEIGHBOR GRAPH
 DISTANCE COSINE
 WITH TARGET ACCURACY 95
 PARAMETERS (
  TYPE HNSW,
  NEIGHBORS 16,
  EFCONSTRUCTION 64,
  OFFLOAD_URL '',
  OFFLOAD_CREDENTIAL_NAME <接続用クレデンシャル名>
  );
Oracle Databaseは、上記「OFFLOAD_URL」で指定したエンドポイント(GPU上で稼働するcuVSのコンテナ)にインデックスの作成処理を実行させます。
ベクトルインデックスの作成をオフロードすることで、Oracle Databaseの既存構成を残しつつ、GPUに負荷を分散することができるため大量のデータが対象の場合等で役立つ構成だと思います!
④構築されたインデックスをOracle Database側に取り込み、SQLから近似最近傍検索(Approximate Nearest Neighbor検索)を実行
最後に構築した環境に対し、検索を試してみました。
Oracle Databaseに対してベクトル検索を実行し、データ全件ではなくインデックスを使用した類似検索が実現できました。
検索時のSQL文ではGPU(NVIDIA cuVS)を呼び出さず、Oracle Databaseのみで完結していました。
まとめ
NVIDIA cuVSを使用し、既存のOracle Databaseの仕組みを大きく変えずに、GPUアクセラレーションによってベクトルインデックスの構築や検索を高速化できることを確認できました。
検索はOracle Database側で完結し、インデックス構築のみをGPUにオフロードするという「組み込み型」の構成は、既存システムへの導入ハードルを下げる点が実システムでも参考になると思います。
ハンズオン形式のため実際の動作がわかり、非常に勉強になるセッションでした。
今後、大量の非構造化データを扱うRAGやセマンティック検索などの案件において、Oracle DatabaseとcuVSを組み合わせた構成を検討候補の一つとして持っておくと、提案時の選択肢を広げられると思います!
 簡単30秒