


はじめに
エンタープライズクラウド事業部の高橋です。
Oracle AI World 2026にて、「AI Agents, Powered by AMD: Build Autonomous Workflows on OCI [HOL2382]」に参加しましたので、その内容を紹介します。
セッション概要
Build an AI agent powered by an open LLM running on AMD GPUs in OCI. In this hands-on lab, you’ll serve a model with vLLM on AMD hardware, connect it to an open-source agent framework, and configure an agent with persistent memory and reusable skills. Then guide your agent through setting up a Python project, investigating and fixing a bug, and verifying the results. You’ll turn that process into a reusable skill and explore scheduled, autonomous workflows. Leave with a working inference stack, a personalized agent, and practical experience extending AI agents to tackle your own tasks.
OCI上のAMD GPUで動作するオープンLLMを活用し、AIエージェントを構築します。このハンズオンラボでは、AMDハードウェア上でvLLMを使用してモデルをデプロイし、オープンソースのエージェントフレームワークに接続します。さらに、永続的なメモリと再利用可能なスキルを備えたエージェントを構成します。続いて、Pythonプロジェクトのセットアップ、バグの調査と修正、そして結果の検証という一連のプロセスをエージェントに実行させます。このプロセスを再利用可能なスキルとして定義し、スケジュールに基づいた自律的なワークフローについても探求します。最終的には、実際に動作する推論スタックとパーソナライズされたエージェントが手に入り、独自のタスクを解決するためにAIエージェントを拡張する実践的な経験を習得できます。
登壇者情報
Mahdi Ghodsi, AI Solution Architect, AMD
Maharshi Trivedi, MTS Product Application Engineer, AMD
Daniel Wang, AI Applications Engineer, AMD
セッション内容
本セッションでは、AIエージェントを構成する基本要素(モデル・ランタイム・ツール)の解説や複数のLLMを用途に応じて使い分ける「モデルルーティング」の仕組みが紹介されました。
前提の説明
ライブデモも行われるため、前提知識となるAIエージェントの基本構成についてまず説明がありました。
・エージェントの3要素:「モデル(LLM/頭脳)」「ランタイム(モデルの応答やツール呼び出しを管理するソフトウェア)」「ツール(実際に処理を行う手足)」の3つで構成されると説明。
・ReActループ:Reason(推論)→Act(行動)→Observation(観察)を繰り返しながら、LLMが必要なツールを呼び出し、満足のいく結果が得られるまで処理を続ける仕組み。
例として「今日の日付を聞かれたLLMは、学習データだけでは答えられないため、日付取得用のツールを呼び出す」という具体例を紹介されていました。
特に意識せずにLLMを使用していたため、本セッションを通してLLM内部の仕組みも学べました。
・MCP(Model Context Protocol):ツールをLLMから呼び出しやすい形で公開するためのプロトコルで、Anthropicが策定し現在広く使われていると説明。
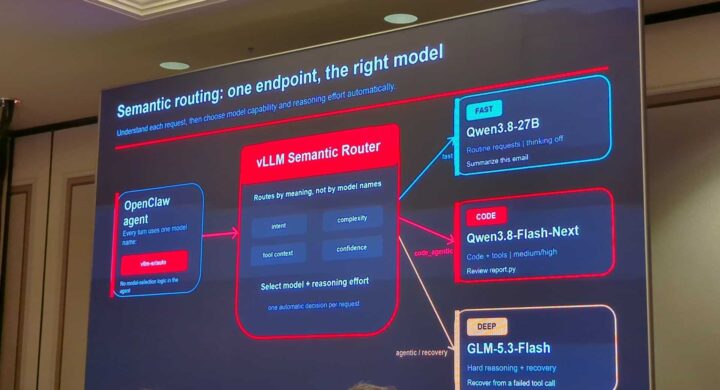
・モデルルーティング(複数モデルの使い分け):全てのリクエストを最も高性能(高コスト)なモデルに送るのは非効率であるため、プロンプトの内容に応じて適切なモデルに振り分ける「ルーティング」の仕組みが重要であると説明。
その実装例として、オープンソースの「vLLM Semantic Router」が紹介されました。
プロンプトの意味内容を解析し、あらかじめ設定した基準(モデルへの直接振り分け/安いモデルで精度等に問題があるなら高いモデルに切り替える「エスカレーション」/複数モデルの結果を統合する「コンバイン」)に基づいてモデルを振り分ける仕組みとのことです。
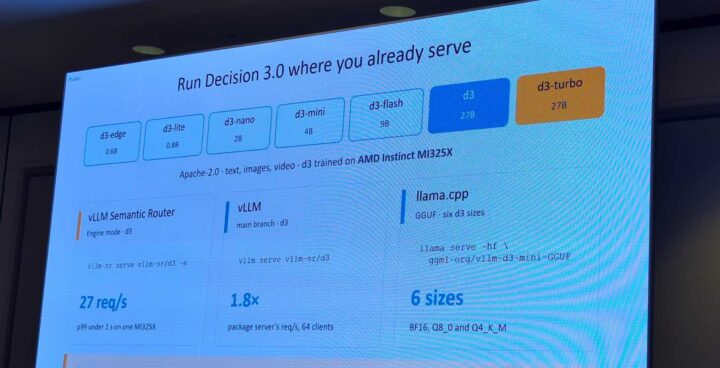
・ベンチマーク結果:AMDが実施した検証では、vLLM Semantic Routerを使うことで、最も高性能なモデルのみを使う場合と比べて精度はほぼ同等(誤差1%程度)のまま、コストを約1/3に削減できたという結果が紹介されました。
モデルへの振り分けを行うことでコスト削減が可能なため、アーキテクチャの設計時に検討するべき内容だと思います!
デモの内容
本セッションはハンズオン形式ではなく、ライブデモ形式で進行しました。
オープンソースのコーディングエージェントを操作し、GitHubリポジトリの自動セットアップからバグ修正、複数エージェントによるコードレビューまでのライブデモです。
特に注目した内容としては、デモ環境の構成です。
AMD Instinct MI300X GPU(192GBのHBM3メモリ、メモリ帯域5.3TB/秒)を8基搭載したノードが使用されていました。
このノード上でvLLMを使い、3つのオープンソースモデル(GLM系の軽量モデル、Qwen系の軽量モデル2種)とルーティング判定専用の小型モデルをそれぞれGPUに割り当てて配信し、エージェント側はモデルへの振り分けを行う「vLLM Semantic Router」のエンドポイントのみを呼び出す構成になっていました。
3つのモデルに対して振り分けを行うことでコスト効率の高い構成を実現していると思います。
また、デモを実行するJupyter Notebookは、OCI Data Science上でホスティングされており、そこからAMDのGPUノードに接続する構成となっていました。
OCI Data Scienceを使用することで、環境構築を効率化し、OCI上のAMD GPUを搭載したノードと連携することでクラウド間の設定なしに接続が可能な点もアーキテクチャ上のメリットだと思います!
まとめ
本セッションから、全てのリクエストを最高性能モデルに送るのではなく、用途に応じてモデルを自動的に振り分けるルーティングの仕組みによって、精度を落とさずにコストを大きく下げられることを登壇者の説明を通して確認できました。
今後、複数のLLMを組み合わせたコスト最適化や、役割分担型のマルチエージェント構成は、AIエージェントを使った業務支援ツールを提案する際の構成パターンの一つとして、提案の幅を広げる参考になりそうです。
OCI Data ScienceとAMD GPUを組み合わせることで、OCI上のみで完結できるアーキテクチャとすることができ、構築効率もよいと感じました。
 簡単30秒