


はじめに
Amazon OpenSearch Serviceの名寄せ機能の実装に関する検証を行いましたのでまとめてみました。
具体的には、
コンソール上でのドメイン作成から、正規化フィルターやシノニムの設定、マルチフィールド機能を使ったスコアリング、あいまい検索の挙動まで、Dev Toolsで一通り試した手順を解説しています。
ぜひ最後までお読みください🎀
セットアップ
今回は簡単な検証のため、コンソールから直接Amazon OpenSearch Serviceのドメインを作成しました。
右上のドメインを作成を押下します。
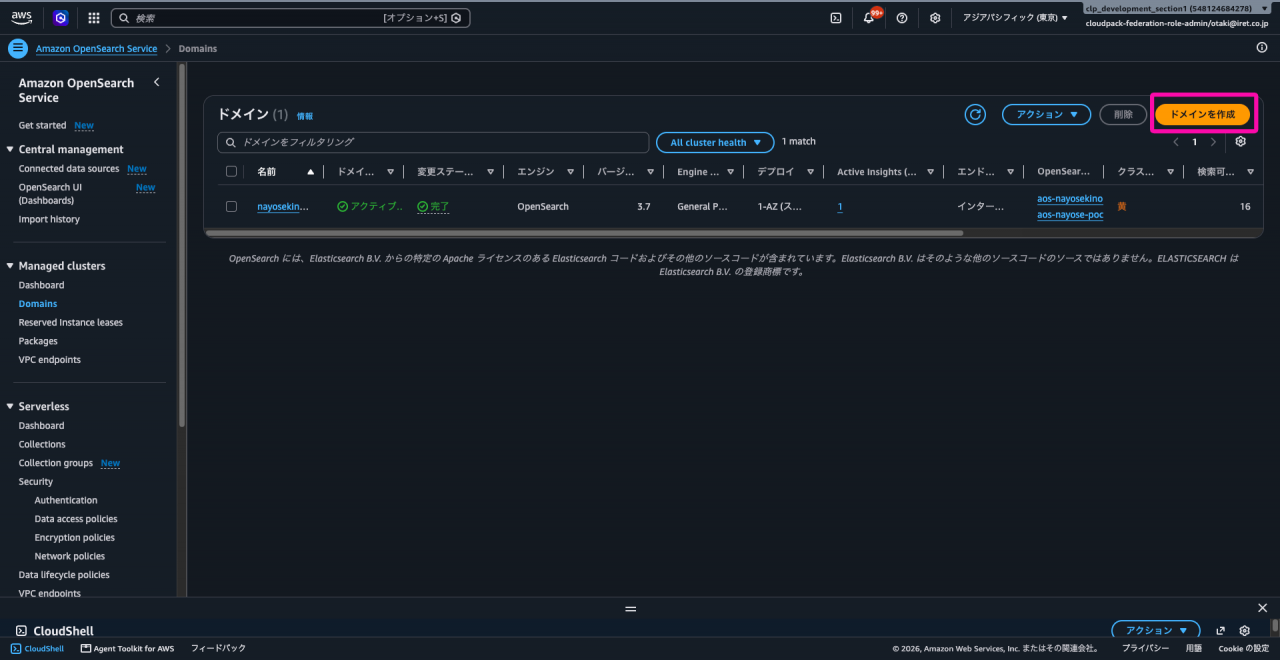
今回は簡単な検証のため標準作成モードを選択し、最も安価でシンプルなクラスター構成(t3.small.search,データノード1, 1-AZなど)をカスタムしました。
今までEC2のインスタンスタイプとか意識したことなかったから緊張しました💦
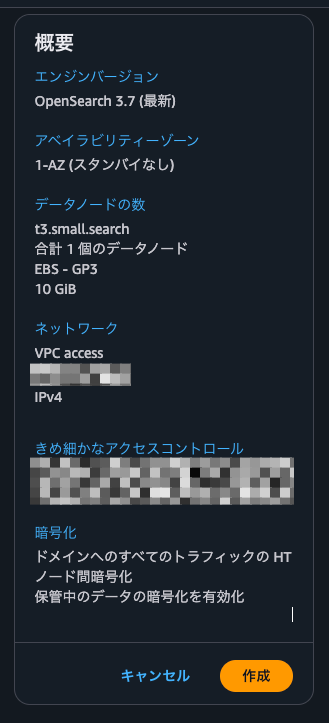
具体的には上記です。
作成すると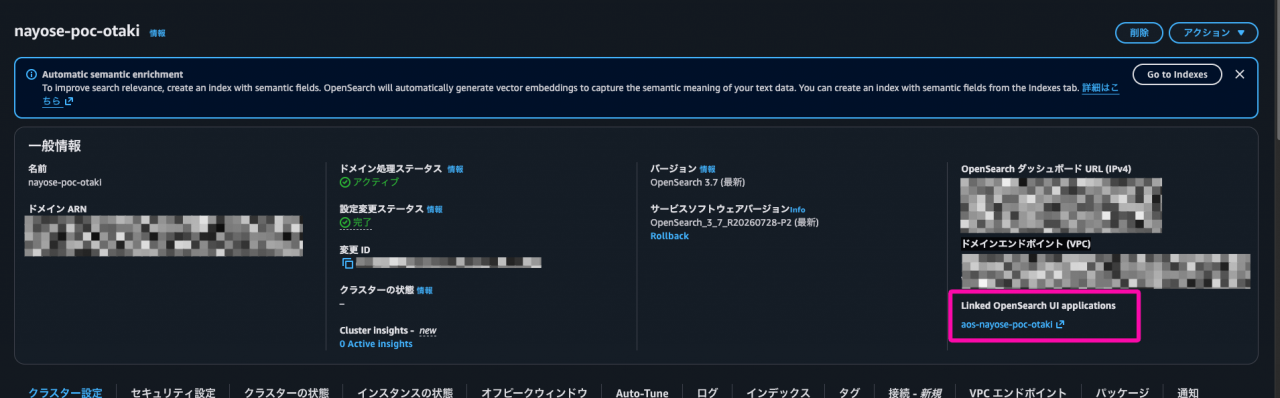
✨✨✨🥳ドメインが完成しました。🥳✨✨✨
作成を押してから実際にできるまで、15分から20分くらいかかりました。💦
ちなみにドメイン削除するにも同じくらい時間かかります。
諸事情あって一回できたドメインを削除して再作成したのでめっちゃ時間かかりました😢
OpenSearch UI Application URLに飛ぶと
nayosekinou-poc-otakiワークスペース内のDashboards画面に遷移します。
左端のターミナルのマーク的なのを押すと、Dev Toolsに遷移します。
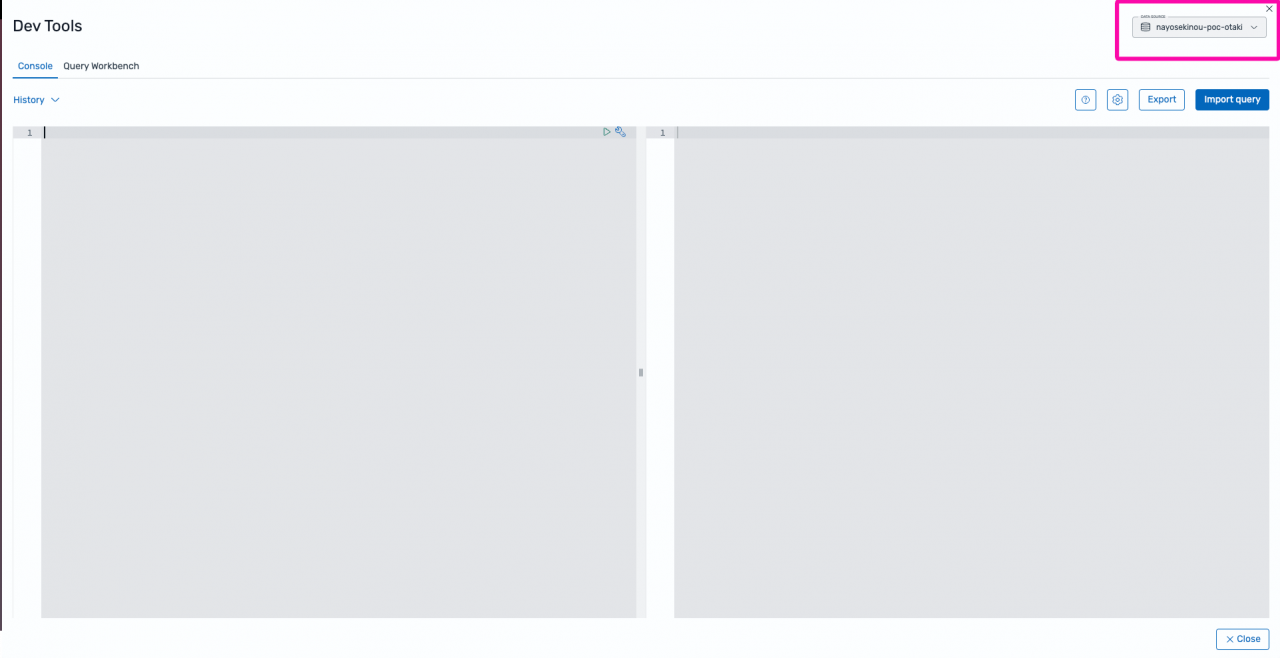
右上のData Sourceが自分の作成した正しいドメインnayosekinou-poc-otakiになっていることを確認します。
Dev Toolsの設定
Dev Toolsでは、左側のパネルがユーザーの入力になっていて
実行すると、右側のパネルに結果の出力が返ってきます。
例えば、下記のような感じです。(内容はサンプルです。理解しなくてOK)
左側パネルの緑色の再生ボタンを押すと、
右側に結果が出力されます。
/nayose-testというインデックスを作成
PUT /nayose-test
{
  "settings": {
    "analysis": {
      "char_filter": {
        "normalize_char_filter": {
          "type": "icu_normalizer",
          "name": "nfkc_cf"
        }
      },
      "tokenizer": {
        "kuromoji_search_tokenizer": {
          "type": "kuromoji_tokenizer",
          "mode": "search",
          "discard_compound_token": true
        }
      },
      "filter": {
        "company_synonym_filter": {
          "type": "synonym_graph",
          "lenient": true,
          "synonyms": [
            "KDDIアイレット, KDDI iret, ケイディーディーアイアイレット => KDDIアイレット"
          ]
        }
      },
      "analyzer": {
        "normalize_analyzer": {
          "type": "custom",
          "char_filter": ["normalize_char_filter"],
          "tokenizer": "kuromoji_search_tokenizer",
          "filter": ["lowercase"]
        },
        "synonym_analyzer": {
          "type": "custom",
          "char_filter": ["normalize_char_filter"],
          "tokenizer": "kuromoji_search_tokenizer",
          "filter": ["lowercase", "company_synonym_filter"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "会社名": {
        "type": "text",
        "analyzer": "normalize_analyzer",
        "fields": {
          "raw": { "type": "keyword" },
          "syn": { "type": "text", "analyzer": "synonym_analyzer" }
        }
      }
    }
  }
}
実際に何を設定しているのか、上から順番に見ていきましょう!
まず、icu_normalizer・kuromoji_tokenizer・synonym_graphの3つは、OpenSearch標準のプラグイン機能です。
OpenSearch標準のプラグイン機能
①icu_normalizer
テキストを標準的なUnicode形式に変換する。
例:KDDI(全角) ➔ kddi(半角小文字), ㌢(環境依存文字) ➔ センチなど
https://docs.opensearch.org/latest/analyzers/character-filters/icu-normalization/
②kuromoji_tokenizer
日本語を品詞単位で分割する。
例:東京都に行く→東京・都・へ・行く
https://www.elastic.co/docs/reference/elasticsearch/plugins/analysis-kuromoji-tokenizer
③synonym_graph
同義語セットを定義し、正しく処理する
例:KDDIアイレット, KDDI iret, ケイディーディーアイアイレット => KDDIアイレット
https://www.elastic.co/docs/reference/text-analysis/analysis-synonym-graph-tokenfilter
その後のanalyzerでは、normalize_analyzerとsynonym_analyzerを定義しています。
normalize_analyzerの流れ
- char_filter(全角半角などを統一)
- tokenizer(日本語として単語分割)
- lowercase(すべて小文字化)
synonym_analyzerの流れ
上記の normalize_analyzer の最後に company_synonym_filterが追加されただけです。
マルチフィールド機能
マルチフィールド機能とは、1つの入力データに対して、裏側で複数のサブフィールド(異なる検索方法用データのコピー)を自動作成する仕組みのこと。
   "会社名": {
    "type": "text",
    "analyzer": "normalize_analyzer",
    "fields": {
      "raw": { "type": "keyword" },
      "syn": { "type": "text", "analyzer": "synonym_analyzer" }
    }
上記部分です。
例
データとして KDDI iretを1回送信
【内部での保持のされ方】
会社名(メイン) ➔ kddi, iret(バラバラの半角小文字)
会社名.raw(サブ1) ➔ KDDI iret(そのままの文字列)
会社名.syn(サブ2) ➔ kddi, iret, KDDIアイレット(同義語も追加)
検索する側は、用途に合わせて探す対象のフィールド名を使い分けます。
自由に検索したい(あいまい検索など単語ごとに検索したい)とき
→会社名 に対して検索を実行する。
KDDI iretと完全一致するデータを集計・ソートしたいとき
→ 会社名.rawフィールドに対して集計を実行する。
ケイディーディーアイアイレットと検索してヒットさせたいとき
→会社名.syn フィールドに対して検索を実行する。
プログラム側から見るとデータ投入は1回で済み、検索時には用途に応じたサブフィールド(.raw や .syn)を指定するだけで最適な結果を得られるのがこの機能のメリットです。
インデックスの確認
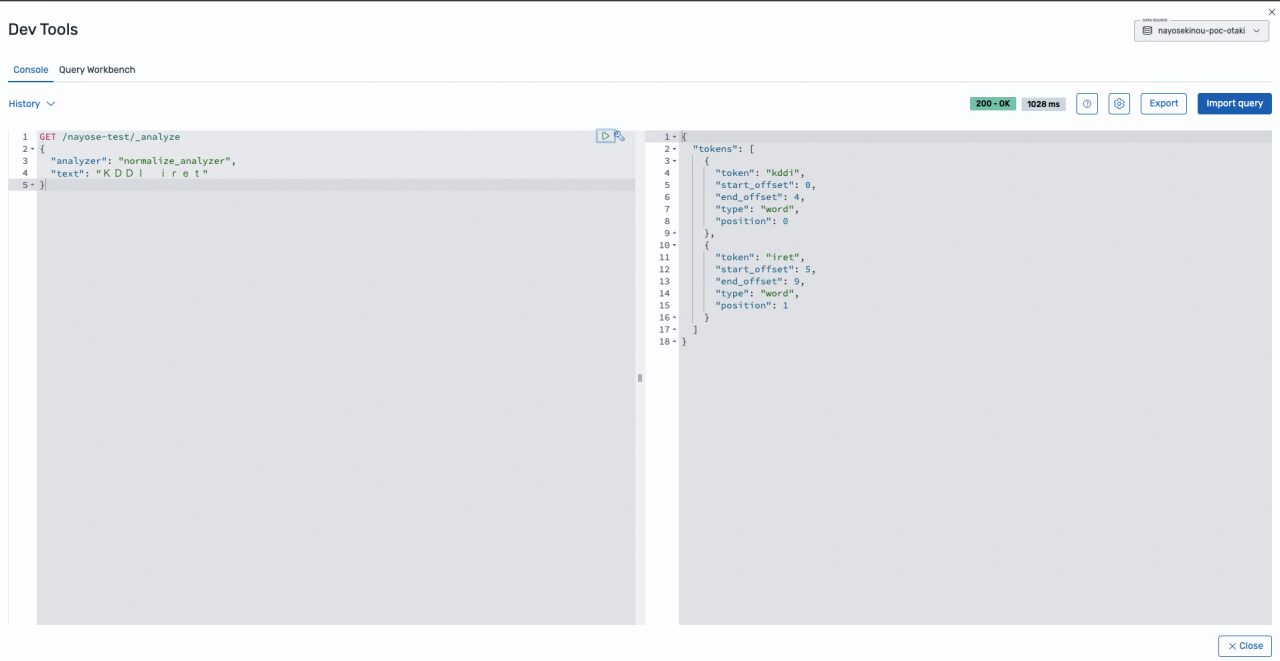
①normalize_analyzerの確認
GET /nayose-test/_analyze
{
  "analyzer": "normalize_analyzer",
  "text": "KDDI iret"
}
全角のKDDI iretという文字列を、normalize_analyzerにかけたらどう分解されるかを検証。
返却された値👇🏻
{
  "tokens": [
    {
      "token": "kddi",
      "start_offset": 0,
      "end_offset": 4,
      "type": "word",
      "position": 0
    },
    {
      "token": "iret",
      "start_offset": 5,
      "end_offset": 9,
      "type": "word",
      "position": 1
    }
  ]
}
完璧✨
入力したKDDI iret(全角)が、normalize_analyzerを通した結果、
– token: “kddi”
– token: “iret”
という半角・小文字のトークンに変換されています。
つまり、
全角→半角の統一(KDDI→kddi, iret→iret)
大文字→小文字の統一(KDDI→kddi)
が意図通りに動いていることが確認できました。✌🏻
②synonym_analyzerの確認
GET /nayose-test/_analyze
{
  "analyzer": "synonym_analyzer",
  "text": "KDDI iret"
}
KDDI iretという入力をsynonym_analyzerに通すと、事前に登録した同義語(KDDIアイレット)としても展開されるかを検証。
{
  "tokens": [
    {
      "token": "kddi",
      "start_offset": 0,
      "end_offset": 9,
      "type": "SYNONYM",
      "position": 0
    },
    {
      "token": "アイレット",
      "start_offset": 0,
      "end_offset": 9,
      "type": "SYNONYM",
      "position": 1
    }
  ]
}
入力はKDDI iretという2単語だけだったのに、結果には入力に一切含まれていないアイレットという単語が追加で出現しています。
これは、以前設定した同義語リスト
KDDIアイレット, KDDI iret, ケイディーディーアイアイレット => KDDIアイレット
が正しく機能して、「KDDI iretが来たら、KDDIアイレットの代表形も一緒に検索対象に含める」という動きをしている証拠になります👏🏻
③検索ヒット検証
サンプルマスタを投入
POST /nayose-test/_bulk
{ "index": { "_index": "nayose-test", "_id": "1" } }
{ "会社名": "KDDIアイレット株式会社" }
{ "index": { "_index": "nayose-test", "_id": "2" } }
{ "会社名": "ヤマト運輸株式会社" }
{ "index": { "_index": "nayose-test", "_id": "3" } }
{ "会社名": "日本通運株式会社" }
{ "index": { "_index": "nayose-test", "_id": "4" } }
{ "会社名": "KDDI商事株式会社" }
返却
{
  "took": 79,
  "errors": false,
  "items": [
    {
      "index": {
        "_index": "nayose-test",
        "_id": "1",
        "_version": 1,
        "result": "created",
        "_shards": {
          "total": 2,
          "successful": 1,
          "failed": 0
        },
        "_seq_no": 0,
        "_primary_term": 1,
        "status": 201
      }
    },
    {
      "index": {
        "_index": "nayose-test",
        "_id": "2",
        "_version": 1,
        "result": "created",
        "_shards": {
          "total": 2,
          "successful": 1,
          "failed": 0
        },
        "_seq_no": 0,
        "_primary_term": 1,
        "status": 201
      }
    },
    {
      "index": {
        "_index": "nayose-test",
        "_id": "3",
        "_version": 1,
        "result": "created",
        "_shards": {
          "total": 2,
          "successful": 1,
          "failed": 0
        },
        "_seq_no": 0,
        "_primary_term": 1,
        "status": 201
      }
    },
    {
      "index": {
        "_index": "nayose-test",
        "_id": "4",
        "_version": 1,
        "result": "created",
        "_shards": {
          "total": 2,
          "successful": 1,
          "failed": 0
        },
        "_seq_no": 0,
        "_primary_term": 1,
        "status": 201
      }
    }
  ]
}
4件すべて"status": 201です。
これでサンプルマスタ4件(KDDIアイレット・ヤマト運輸・日本通運・KDDI商事)が実際にインデックスに登録されました。
揺れのある入力KDDI iretを投げて、正しくKDDIアイレット株式会社が1位に来るか、そして紛らわしいKDDI商事株式会社が上位に紛れ込まないかを マルチフィールド機能を使って検証。
GET /nayose-test/_search
{
  "query": {
    "multi_match": {
      "query": "KDDI iret",
      "fields": [
        "会社名^1",
        "会社名.raw^3",
        "会社名.syn^2"
      ]
    }
  }
}
返却された値👇🏻
{
  "took": 107,
  "timed_out": false,
  "_shards": {
    "total": 5,
    "successful": 5,
    "skipped": 0,
    "failed": 0
  },
  "hits": {
    "total": {
      "value": 2,
      "relation": "eq"
    },
    "max_score": 0.5230583,
    "hits": [
      {
        "_index": "nayose-test",
        "_id": "1",
        "_score": 0.5230583,
        "_source": {
          "会社名": "KDDIアイレット株式会社"
        }
      },
      {
        "_index": "nayose-test",
        "_id": "4",
        "_score": 0.26152915,
        "_source": {
          "会社名": "KDDI商事株式会社"
        }
      }
    ]
  }
}
"max_score": 0.5230583でKDDIアイレット株式会社が候補の最上位に来ています。
その次に
_score": 0.26152915でKDDI商事株式会社が候補に出てきていますが、スコアが1位の約半分しかありません。
④あいまい検索
最後に、シノニムでも当たらない誤字パターンに対して、あいまい検索が救ってくれるかを検証。
GET /nayose-test/_search
{
  "query": {
    "multi_match": {
      "query": "KDD1アイレツト",
      "fields": [
        "会社名^1",
        "会社名.raw^3",
        "会社名.syn^2"
      ],
      "fuzziness": "AUTO"
    }
  }
}
KDD1アイレツトはKDDIアイレットのIを1に、「ッ」を「ツ」に変えた、OCR誤読を想定した誤字です。
結果は、、、
{
  "took": 840,
  "timed_out": false,
  "_shards": {
    "total": 5,
    "successful": 5,
    "skipped": 0,
    "failed": 0
  },
  "hits": {
    "total": {
      "value": 2,
      "relation": "eq"
    },
    "max_score": 0.3835761,
    "hits": [
      {
        "_index": "nayose-test",
        "_id": "1",
        "_score": 0.3835761,
        "_source": {
          "会社名": "KDDIアイレット株式会社"
        }
      },
      {
        "_index": "nayose-test",
        "_id": "4",
        "_score": 0.17435277,
        "_source": {
          "会社名": "KDDI商事株式会社"
        }
      }
    ]
  }
}
誤字入りの入力でも、正しくKDDIアイレット株式会社が1位に来ています。👏🏻
KDD1アイレツト(I→1、「ッ」→「ツ」の誤字)という、辞書にもシノニムにも登録していない文字列を投げたのに、fuzziness: AUTOを足しただけで1位に正しい候補が来ました!
正規化やシノニムでは拾えないはずの誤字が、あいまい検索の力だけで救われた、という証拠です🥳
さいごに
資格勉強で名前を聞いたことはありましたが、実際にAmazon OpenSearch Serviceを触ったのは今回が初めてでした!
正規化・シノニム・マルチフィールド・あいまい検索の4つを組み合わせることで、表記揺れだけでなく誤字にも強い「名寄せ」ができることを実感できて満足です✨
自分用メモに近い部分もありましたが、少しでも参考になれば嬉しいです。
最後までお読みいただきありがとうございました!🎀
 簡単30秒