


初めに
この記事はAWSでラジオ作れないかな?という疑問から作ってみた内容です。
どのサービスにどの役割をさせようか
ラジオといえば私のイメージではテーマに沿って人が話しているものです。
考えて話してくれるAWSサービスを正直知らない…
でもテキストを読み上げてくれるサービスは知っている!
ということでAmazon Bedrockに台本を作ってもらってAmazon Pollyに読み上げてもらおう!
作成していく
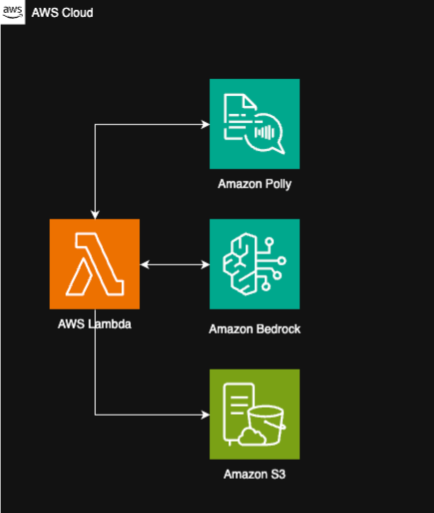
こんな構成にしようと思います。
まずはBedrockに台本作りを命令するLambdaを作ります。
コードを表示
import json
import boto3
import os
import re
import zipfile
import subprocess

# boto3クライアント
bedrock = boto3.client(service_name='bedrock-runtime', region_name='us-east-1')
polly = boto3.client('polly', region_name='ap-northeast-1')
s3 = boto3.client('s3')

BUCKET_NAME = 'your-radio-bucket-2026'

def ensure_ffmpeg():
    """S3から ffmpeg/ffmpeg-6.1-linux-64.zip を取得して /tmp に解凍する"""
    ffmpeg_path = "/tmp/ffmpeg"
    if not os.path.exists(ffmpeg_path):
        zip_path = "/tmp/ffmpeg.zip"

        print("Fetching ffmpeg.zip from S3...")
        ffmpeg_obj = s3.get_object(Bucket=BUCKET_NAME, Key='ffmpeg/ffmpeg-6.1-linux-64.zip')
        with open(zip_path, "wb") as f:
            f.write(ffmpeg_obj['Body'].read())

        print("Extracting ffmpeg.zip...")
        with zipfile.ZipFile(zip_path, 'r') as zip_ref:
            zip_ref.extractall("/tmp/ffmpeg_extracted")

        for root, dirs, files in os.walk("/tmp/ffmpeg_extracted"):
            if "ffmpeg" in files:
                target = os.path.join(root, "ffmpeg")
                os.rename(target, ffmpeg_path)
                break

        os.chmod(ffmpeg_path, 0o755)
        print("ffmpeg preparation complete!")

    return ffmpeg_path

def clean_speech_text(text):
    """Pollyが誤読するラベル名や不要なシステム単語を消す関数"""
    if not text:
        return ""

    # 引用符やカッコなどの記号を削除
    text = re.sub(r'["\'\`\{\}\[\]]', '', text)

    # 行頭の「text」「speaker」「テキスト」「json」「Maki」「Aoi」などの記号・ラベルを削除
    text = re.sub(r'^\s*(?:speaker|text|Maki|Aoi|話者|テキスト|発言|名前|json)\s*[::\s"-]*', '', text, flags=re.IGNORECASE)

    # 文中に混入した「テキスト」「text」「json」という単語自体を消去(誤読防止)
    text = re.sub(r'テキスト[::\s]*', '', text, flags=re.IGNORECASE)
    text = re.sub(r'\btext\b[::\s]*', '', text, flags=re.IGNORECASE)
    text = re.sub(r'\bjson\b[::\s]*', '', text, flags=re.IGNORECASE)

    return text.strip()

def lambda_handler(event, context):
    # topic の必須チェック
    topic = event.get('topic')
    if not topic:
        raise ValueError('エラー: テストイベントの JSON に "topic" を指定してください。(例: {"topic": "秋の味覚レシピ"})')

    # 台本生成(エンディング指示 & コンパクトなやり取りの指定)
    system_prompt = """
あなたは人気のポッドキャスト・ラジオ番組の構成作家です。
女性2人(MakiとAoi)が仲良く雑談しているラジオ対話台本を作成してください。

【番組構成の絶対ルール】
1. オープニング(挨拶、リスナーさんからのお便り紹介)
2. メイントーク(会話文8〜10往復程度でコンパクトかつテンポよくまとめる)
3. エンディング(必ず「今回はここまで!」「また次回も聞いてね〜!バイバーイ!」などの締めの挨拶で終わらせる)

【会話スタイルの厳格ルール(超重要)】
- 一人称は必ず「私」(または「あたし」)にしてください。「俺」「僕」「自分」などは【完全禁止】です。
- 敬語・丁寧語(「です」「ます」「〜でしょうか」「〜ですね」など)は【完全禁止】です。
- 100%タメ口で会話してください。(例: 「〜だよ!」「〜だよね!」「〜じゃない?」「〜かな〜」)
- 友達とおしゃべりしているような、フランクで親しみやすい言葉遣いに徹底してください。
- 「え〜!」「なるほどね〜」「う〜ん、」などの自然な相槌を入れてください。
- セリフの中に「JSON」「json」「テキスト」「text」などのシステム用語は絶対に入れないでください。

【出力フォーマット】
必ず指定の配列形式のみを出力してください。解説やマークダウン(```json)は禁止です。

[
  {"speaker": "Maki", "text": "みんなー、こんにちはー!ラジオの時間だよ!"},
  {"speaker": "Aoi", "text": "今日も楽しくいってみよー!"},
  {"speaker": "Maki", "text": "ねえねえ、今回はリスナーさんから『〜』っていうお便りをもらったよ!"},
  {"speaker": "Aoi", "text": "おっ、いいねー!私これめっちゃ気になってたんだよね!"},
  {"speaker": "Maki", "text": "あ〜、そろそろお別れの時間みたい!"},
  {"speaker": "Aoi", "text": "楽しかったね!それじゃあ今回はここまで!また次回も聞いてね〜!バイバーイ!"}
]
"""

    user_prompt = f"テーマ「{topic}」について、Maki(進行役女性)とAoi(解説役女性)が「私」という一人称で完全にタメ口で会話するラジオ対話台本を作成してください。最後は必ず「バイバーイ!」などの締めの挨拶で完璧に終わらせてください。"

    # maxTokens を 1500 に設定してコストと長さをガード
    response = bedrock.converse(
        modelId="us.anthropic.claude-haiku-4-5-20251001-v1:0",
        system=[{"text": system_prompt}],
        messages=[{"role": "user", "content": [{"text": user_prompt}]}],
        inferenceConfig={"temperature": 0.5, "maxTokens": 1500}
    )

    script_text = response["output"]["message"]["content"][0]["text"].strip()

    # JSONパース処理
    script_json = []

    # マークダウン装飾(```json ... ```)を除去
    clean_json_str = re.sub(r'```(?:json)?', '', script_text, flags=re.IGNORECASE).strip()
    json_match = re.search(r'\[.*\]', clean_json_str, re.DOTALL)

    if json_match:
        try:
            script_json = json.loads(json_match.group(0))
        except Exception as e:
            print(f"JSON Parse Error: {e}")

    # フォールバック処理(JSONパース失敗時)
    if not script_json:
        lines = script_text.split('\n')
        for i, line in enumerate(lines):
            clean_line = clean_speech_text(line)
            if clean_line:
                speaker = "Maki" if i % 2 == 0 else "Aoi"
                script_json.append({"speaker": speaker, "text": clean_line})

    # Pollyで声(/tmp/voice.mp3)の生成
    voice_bytes = bytearray()
    for item in script_json:
        if not isinstance(item, dict):
            continue

        speaker = item.get('speaker', 'Maki')
        raw_text = str(item.get('text', ''))

        speech_text = clean_speech_text(raw_text)
        if not speech_text:
            continue

        voice_id = 'Kazuha' if speaker == 'Maki' else 'Tomoko'
        polly_response = polly.synthesize_speech(
            Text=speech_text,
            OutputFormat='mp3',
            VoiceId=voice_id,
            Engine='neural'
        )
        voice_bytes.extend(polly_response['AudioStream'].read())

    voice_path = "/tmp/voice.mp3"
    with open(voice_path, "wb") as f:
        f.write(voice_bytes)

    # S3からBGM(/tmp/bgm.mp3)を取得
    bgm_path = "/tmp/bgm.mp3"
    bgm_obj = s3.get_object(Bucket=BUCKET_NAME, Key='BGM/bgm.mp3')
    with open(bgm_path, "wb") as f:
        f.write(bgm_obj['Body'].read())

    # ffmpeg で声とBGMを合成(音量8%)
    output_path = "/tmp/radio_output.mp3"
    ffmpeg_bin = ensure_ffmpeg()

    cmd = [
        ffmpeg_bin, "-y",
        "-i", voice_path,
        "-stream_loop", "-1", "-i", bgm_path,
        "-filter_complex", "[1:a]volume=0.08[bgm];[0:a][bgm]amix=inputs=2:duration=first:dropout_transition=2",
        "-c:a", "libmp3lame", "-q:a", "4",
        output_path
    ]
    subprocess.run(cmd, check=True)

    # 完成MP3を S3 にアップロード
    file_name = "radio_output.mp3"
    with open(output_path, "rb") as f:
        s3.put_object(
            Bucket=BUCKET_NAME,
            Key=file_name,
            Body=f.read(),
            ContentType='audio/mpeg'
        )

    return {
        'statusCode': 200,
        'body': json.dumps(f'Successfully generated radio episode to s3://{BUCKET_NAME}/{file_name}', ensure_ascii=False)
    }
追加でラジオにBGMをつけるためにffmpegという音声や動画の編集・合成を行うためのオープンソースツール呼び出しと、それを使うためのPython の subprocessモジュールを呼び出しました。
あとはLambdaに必要な権限もろもろつけます。
次は出来上がったラジオを入れるS3バケットを作ります。
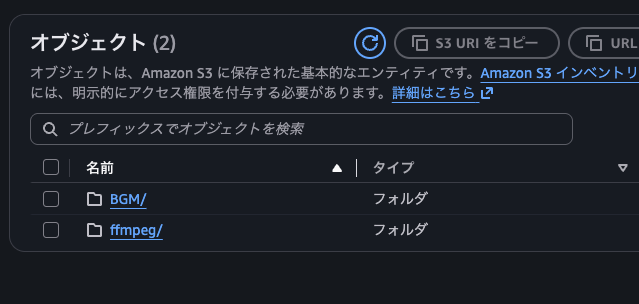
BGMフォルダの中には自身の好きな曲を入れておきます。
※使用するBGMは、ロイヤリティフリー音源や商用利用可能なフリー素材をご用意ください。
ffmpegフォルダの中にはこのGitのffmpeg-6.1-linux-64.zipを入れてます。
これだけでラジオ完成です!
聴いてみる
Lambda実行時に以下のテストJSON使います。
topicの中に話してほしいテーマを入れます。
{
  "topic": ""
}
今回私は「釣り場でマナーの悪い釣り人を見かけた」というテーマでLambdaを実行させました。
1分後くらいにS3に音声ファイルが作成されました!
↓テーマについて話してくれてます
気になる箇所もありましたが面白いので許します
話し方・設定・時間などはLambdaのBedrockへのプロンプトで指示しているので好みで変更できます。
最後に
今回は支持したテーマでAmazon Bedrockに台本を作ってもらってAmazon Pollyに読み上げてもらう擬似ラジオを作成しました。
構築自体は簡単でしたがBedrockのプロンプト修正にかなり時間を費やしました。(もう限界)
このラジオですがAmazon EventBridgeと組み合わせて定期的にお知らせやニュースを取得してBedrockで簡潔にまとめてPollyに読んでもらうとかも面白そうだなと思ってます。
気力があれば拡張していきます!
以上です。最後までお読みいただきありがとうございます。

 簡単30秒