


はじめに
2026年9月29日に、PagerDuty Tech Hub 2026 で登壇してきました。10分のショートセッションで、タイトルは「鳴らすけれど、人は動かない」です。
当日はオフライン開催で、配信もアーカイブもありませんでした。会場に来られなかった方にも届けたいので、話した内容を文章にしてみます。
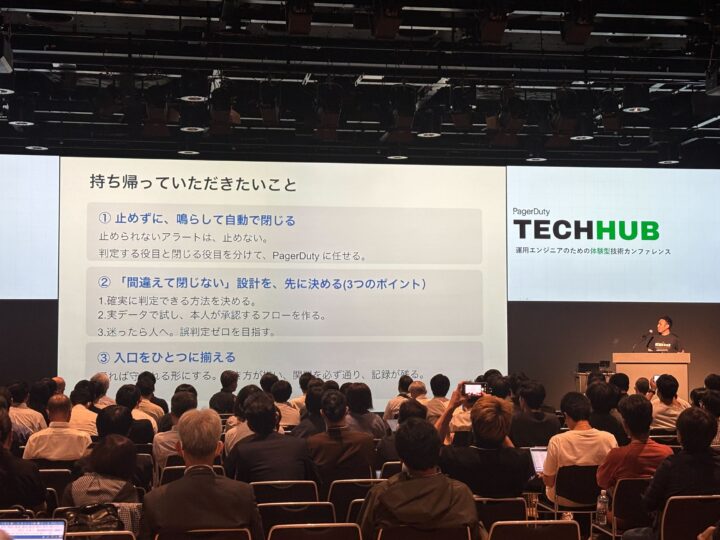
スライドは Speaker Deck に置いています。
このblogでは10分では話しきれなかった裏側の話も、少し足しています!
ざっくり言うと
- お客様への報告が必要なので、対応しなくていいアラートでも止められませんでした。なので鳴らしたうえで、判定と閉じる作業を PagerDuty に任せました
- 自動化でいちばん時間を使ったのは、「閉じてはいけないものを閉じない」設計です。決めたことは3つあります
- その3つを、Slack の入口ひとつに組み込みました。通れば守られる形です
特に2つ目は、自動化を考えるときにどの現場でも悩むところだと思います。
前提:私たちの PagerDuty の使い方
先に、私たちの環境の話をさせてください。
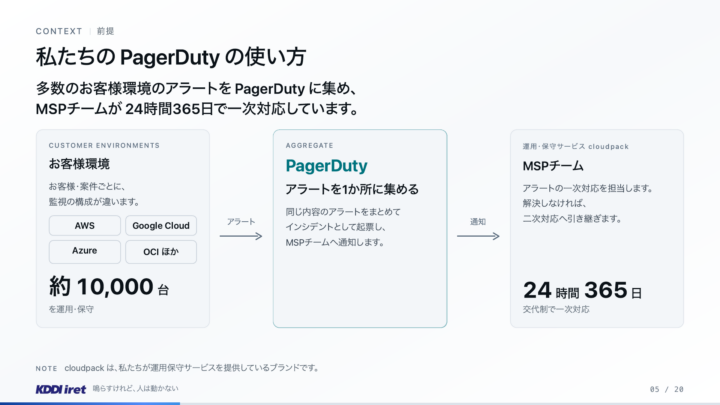
私たちは cloudpack というブランドで、運用保守サービスを提供しています。AWS、Google Cloud、OCI など、お客様ごとに監視の構成が違う環境を、約1万台お預かりしています。
アラートはすべて PagerDuty に集めていて、MSP チームは24時間365日、3交代制で一次対応をしています。
「鳴るけれど、対応しなくていいアラート」がある
皆さんの現場にもありませんか。鳴るけれど、対応しなくていいアラート。
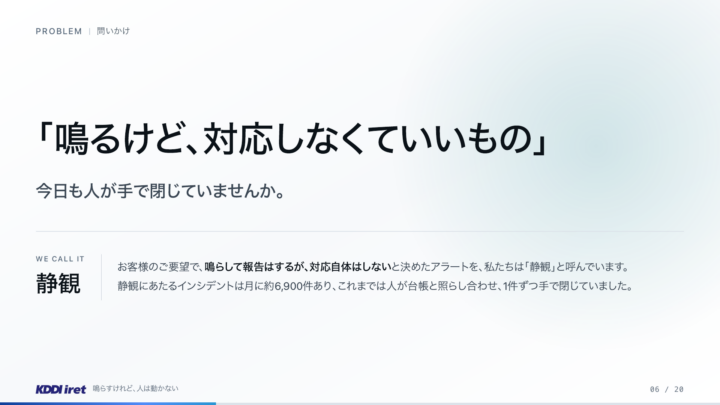
お客様のご要望で「鳴らして報告はするが、対応自体はしない」と決めたアラートを、私たちは「静観」と呼んでいます。
MSPが対応する静観のアラートは、月に約6,900件ありました。
これまでは、アラートが上がるたびに人が静観台帳と照らし合わせて、判断して手で閉じていました。1件ずつです。
1件あたりは1分ほどの作業ですが、この件数を毎月となると、正直ばかにならないですよね。
止めてしまえばいい。でも、止められなかった
対応しないなら、止めてしまえばいい。そもそも鳴らさなければいい。
そう思いますよね(PagerDutyのメンテナンスウィンドウで抑止してしまえばいいのでは)
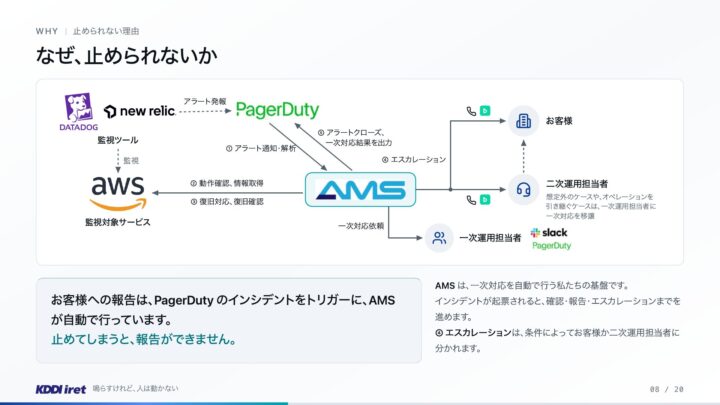
ただ、私たちは止められません。お客様への報告が必要だからです。
お客様からは「鳴ったことは報告してほしい。ただ、対応はしなくていい」というご要望をいただいています。
私たちの環境では、PagerDuty にインシデントが上がると、それをきっかけに一次対応自動化基盤の AMS(Advanced Monitoring System) がお客様へ自動で報告します。AMS は自社で内製化している基盤で、確認・報告・エスカレーションまで自動で進めます。
アラートを止めると、この報告も出せなくなります。「だから、一度は鳴らす必要があるんです。」
止めるという一番シンプルな手が使えない。ここが、この話の出発点でした。
判定と閉じる作業を、PagerDuty に任せた
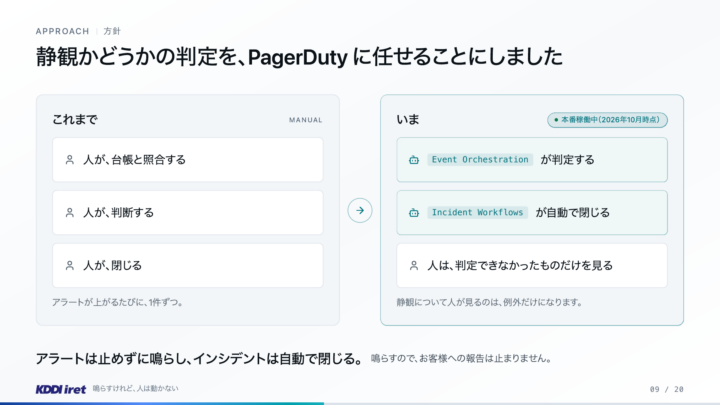
そこで、判定と閉じる作業を PagerDuty に任せることにしました。
判定するのは Event Orchestration、閉じるのは Incident Workflows です。
- アラートは止めずに鳴らします。インシデントは上がるので、お客様への報告は止まりません。
- そのうえで、静観の条件に当たったものは自動で閉じます。
- 人が見るのは、判定できなかったものだけです。この形は、いま(2026年10月時点)本番で動いています。
タイトルの「鳴らすけれど、人は動かない」は、この状態のことです。
いちばん怖いのは「閉じてはいけないものを閉じること」
ここで、いちばん重要なことをお伝えします。
静観にしてはいけないアラートを、静観として閉じてしまうこと。
これだけは、1万回に1回でも起こせません。お客様のシステムが止まっているのに、誰も気づかない状態になるからです。
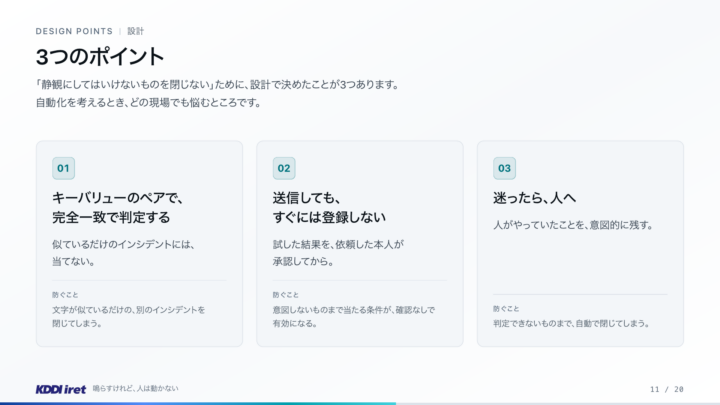
この先の設計は、すべてこの1点を防ぐために決めています。決めたポイントは3つです。
ポイント①:キーと値のペアで、完全一致で判定する
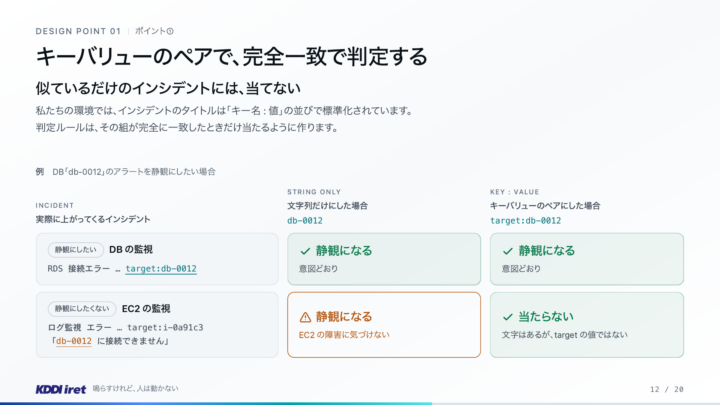
私たちのアラートのタイトルは、「キー:値」の並びで標準化されています。判定ルールは、このキーと値の組が一致したときだけ当たるように作ります。
たとえば、db-0012 という DB のアラートを静観にしたいとします。
「db-0012」という文字だけで当てると、EC2 のログ監視で「db-0012 に接続できません」と出たアラートにも当たってしまいます。これだと、EC2 の障害に気づけません。
「target:db-0012」というペアで当てれば、この EC2 のアラートには当たりません。EC2 のアラートの target は、EC2 のインスタンス ID だからです。
PagerDuty の条件式は、部分一致や正規表現も使えます。便利ですが、自由に書かれた文章に当てると、関係ないアラートまで拾ってしまいます。
私たちも、部分一致で関係ないアラートを拾ってしまった経験があります。
なので、条件式の工夫で頑張るのはやめて、入力側を「キー:値」に揃えて精度を上げる方に倒しました。
似ているだけのアラートには、当てない。
地味ですが、事故を防ぐうえでいちばん効くところだと思っています。
ポイント②:送信しても、すぐには登録しない
リリース前の現場への説明で多く上がったのが「本当にそれで当たるのか」という現場の声でした。
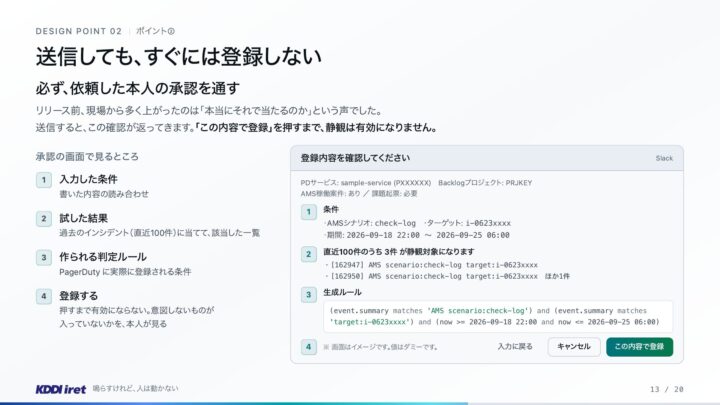
そこで、依頼を送ると、過去のインシデント直近100件に条件を当てた結果が返ってくるようにしました。いきなり本番のルールに入れずに、一度試してみる形です。
承認の画面では、次の4つを見ます。
- 入力した条件(書いた内容の読み合わせ)
- 試した結果(直近100件のうち、当たった一覧)
- 作られる判定ルール(PagerDuty に実際に登録される条件)
- 「この内容で登録」ボタン
依頼した本人がこれを見て、「この内容で登録」を押します。押すまで、静観は有効になりません。
「本当に当たるの?」という現場の不安に、実データで答えられる。ここがいちばんよかったところです。
ポイント③:迷ったら、人へ
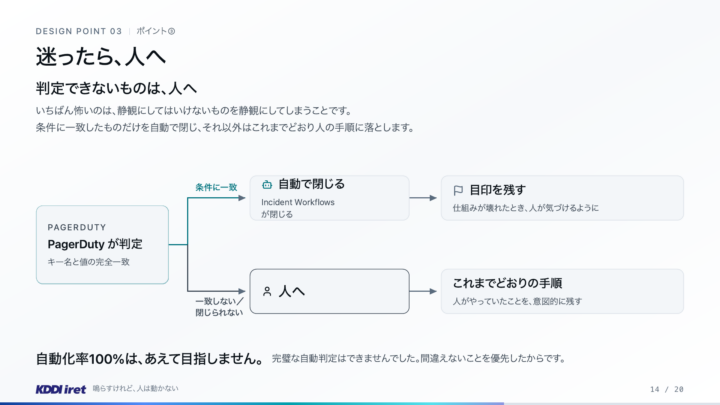
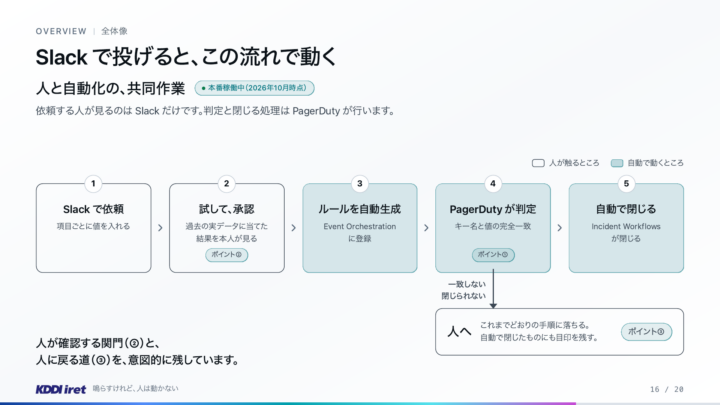
条件に一致したものだけを自動で閉じます。一致しないもの、閉じられなかったものは、これまでどおり人の手順に落ちます。
自動で閉じたものにも目印を残しています。仕組みが壊れたときに、人が気づけるようにするためです。
正直に言うと、完璧な自動判定はできませんでした。
なので、自動化率100%はあえて目指していません。間違えないことを優先したからです。
自動化の話なのに、人を残す話をしているのは少し不思議に聞こえるかもしれません。でも、ここを削ると、ポイント①と②で積み上げた安全が崩れると考えています。
入口を Slack ひとつにしたら、「守ってください」が要らなくなった
3つのポイントを決めても、現場に「守ってください」とお願いするだけでは守られません。いろいろな人がいろいろな書き方で依頼すると、正しく設定されない現場あるあるな悩みです。
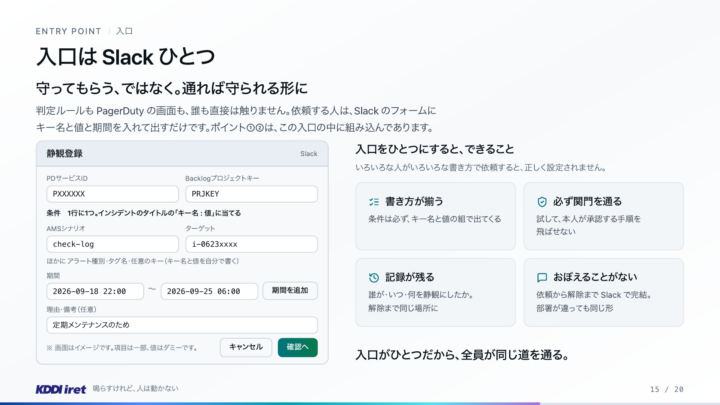
そこで、入口を Slack ひとつにしました。依頼する人は、Slack のフォームにキーと値と期間を入れて出すだけです。
判定ルールも PagerDuty の画面も、誰も直接は触りません。
入口をひとつにすると、こうなります。
- 書き方が揃う:条件は必ず、キーと値の組で出てくる
- 必ず関門を通る:試して、本人が承認する手順を飛ばせない
- 記録が残る:誰が・いつ・何を静観にしたか。解除まで同じ場所に残る
- おぼえることがない:依頼から解除まで Slack で完結する。部署が違っても同じ形
ルールを文書で配って守ってもらうより、守らないと通れない道を1本だけ用意する。その方が、結局はみんな楽なんだと感じました。
裏側は「依頼1件ごとに、作って、消す」
ここからは、仕組みの裏側を少し補足します。
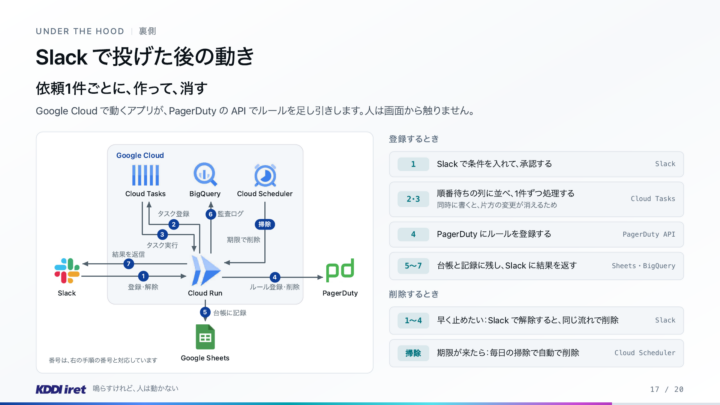
依頼の処理は、Google Cloud で動くアプリが担当しています。PagerDuty の API で、Event Orchestration のルールを足したり消したりします。
登録するときの流れはこうです。
- Slack で条件を入れて、本人が承認する
- 依頼を Cloud Tasks の列に並べ、1件ずつ処理する
- Cloud Run のアプリが、PagerDuty にルールを登録する
- 台帳(Google Sheets)と監査ログ(BigQuery)に記録し、Slack に結果を返す
2つ目の「1件ずつ」には理由があります。PagerDuty の API は、サービスのルール一覧をまとめて書き換える形です。
2人が同時に登録すると、後から書いた方が先の変更を上書きしてしまいます。なので、順番待ちの列を挟みました。
削除は2通りあります。
早く止めたいときは、Slack で解除すると同じ流れで消えます。期限が来たものは、Cloud Scheduler で毎日動く掃除の処理が自動で消します。
人が触るのは Slack だけです。運用する側としても、この割り切りはかなり気が楽だと感じています。
これで、どれだけ変わるか(見込み)
ここで定量的な数字の話をします。
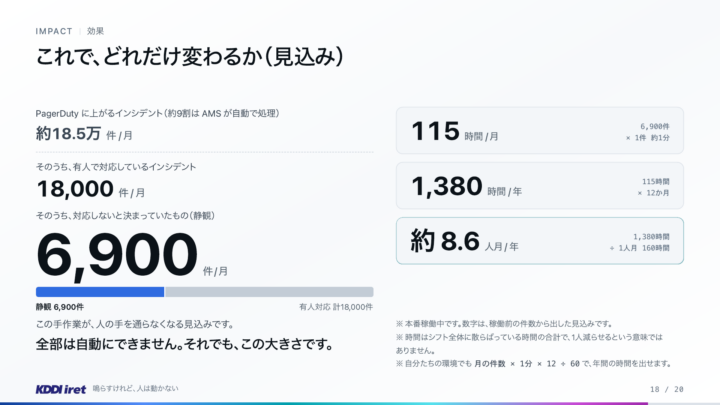
私たちの PagerDuty には、月に約18.5万件のインシデントが上がります。約9割は一次対応自動化基盤の AMS が処理していて、実際に有人で見ているのは月約1万8,000件です。
そのうち、対応しないと決まっていた静観が、月約6,900件ありました。
| 項目 | 数字 |
|---|---|
| 静観の件数 | 月 約6,900件 |
| 1件あたりの作業 | 約1分 |
| 月の時間 | 約114時間(6,900件 × 約1分) |
| 年の時間 | 約1,368時間(114時間 × 12か月) |
| 人月に換算 | 約8.6人月(1,368時間 ÷ 1人月160時間) |
1件はたった1分です。それでも、積み上げるとこの大きさになります。
数字にしてみると、改めてですがバカになりません。
注意点が2つあります。
1つ目。この時間は、24時間365日のシフト全体に散らばっている時間の合計です。
1人減らせるという意味ではありません。浮いた時間を、本当に対応すべきアラートに回せるという意味です。
2つ目。いまは本番で動いていますが、上の数字は稼働前の件数から出した見込みです。
気になりそうなところに、先回りで答えます
当日の Ask the Speaker に向けて準備していた答えのうち、ブログで読む方も気になりそうなものをまとめておきます。
Q. 止めるのがダメなら、PagerDuty の Suppress は使えなかったんですか?
使えませんでした。Suppress はアラートを受けても、インシデントを立てません。
インシデントが立たないと、AMS の報告が出ません。なので、一度インシデントを立ててから Incident Workflows で閉じる形にしました。
Q. 「完全一致」と言っていますが、どういう意味ですか?
キーと値の組で当てる、という意味です。値の文字列だけでは当てないので、ポイント①の EC2 の例のような取り違えは起きません。
Q. 静観のルールは増え続けませんか?
依頼ごとに期限を持たせて、期限が来たら毎日の掃除で消しています。
思ったこと
自動化というと、どれだけ人の手を減らせるかに目が行きがちです。
でも今回いちばん時間を使ったのは、間違えて閉じないための設計でした。
完全一致で当てる、試してから承認する、迷ったら人へ。どれも「自動にしないところ」を決める作業です。
そして、その決めごとを入口に組み込みました。人にお願いする形だと、どこかで抜けるからです。
ここまでやって、やっと現場に渡せる形になったと思っています。
まとめ
- 止められないアラートは、止めない。鳴らして、判定と閉じる役目を PagerDuty(Event Orchestration と Incident Workflows)に任せる
- 「間違えて閉じない」設計を先に決める。キーと値のペアで当てる、実データで試して本人が承認する、迷ったら人へ
- 入口をひとつに揃えて、通れば守られる形にする。書き方が揃い、関門を必ず通り、記録が残る
鳴るけれど対応しなくていいアラートを、毎日だれかが手で閉じている。そんな現場は、たぶん私たちだけじゃないと思っています。
同じように PagerDuty で多くのお客様環境を見ている方がいたら、どこまで自動にして、どこを人に残しているか、ぜひ聞かせてください。私たちもまだ稼働したばかりなので、一緒に学んでいきたい感じです。
おまけ
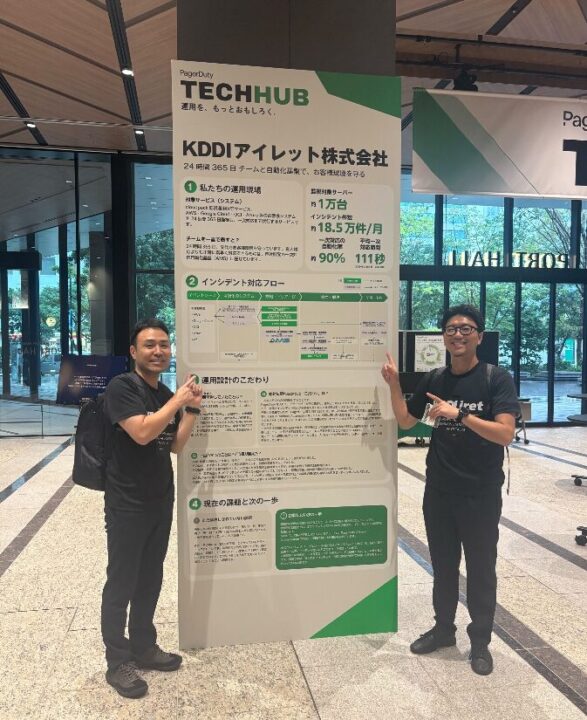
イベント用にPagerDuty様がKDDI アイレットの活用フローボードを作成してくれました!! 3mを超える大作!!
貴重なイベントの登壇機会をいただき、ありがとうございました!


 簡単30秒