


はじめに
- こんにちは、エンタープライズクラウド事業部の新川です。今週は Oracle AI World 2026 に参加するため、ラスベガスに来ています。
- 前回に続き、クイズからスタートしたいと思います。
- AI を動かす部品(モデル)を、利用料の単価が半額のものに乗り換えました。AI を使う費用は下がるでしょうか?
A. 半額になる
B. あまり変わらない
C. 3 倍になることもある答えは C です。トークンの単価が半額でも、費用が 3 倍になることがあります。このセッションでは、そう説明されました。
- 今回は「AI Without GPUs: Scale AI Inference with OCI Cloud Native and CPU Shapes [LRN2230]」の内容をお伝えします。
このブログの対象
-
AI を動かす費用の考え方と、システムを作るときの設計のコツを扱います。
- 非エンジニアの方:AI を使う費用は何で決まるのか、どう考えると無駄が減るのかが分かります。
- エンジニアの方:AI を組み込むシステムを設計するときの、考え方の軸が分かります。
先に、用語をおさらい
-
この記事によく出てくる言葉を、先に説明します。
- 推論(すいろん):できあがった AI に、質問や依頼を出して、答えを出してもらうこと。ChatGPT のような AI に話しかけて、返事が返ってくる一連の動きです。AI を「作る」(学習)のではなく、「使う」ことを指します。
- モデル:AI の頭脳にあたる部分です。文章を作ったり、質問に答えたりする本体です。
- トークン:AI が文章を読み書きするときの、文字のかたまりです。だいたい単語や文字の一部くらいの大きさです。AI の利用料は、このトークンの量で決まることが多く、「トークン単価」はその 1 つあたりの値段です。
- GPU と CPU:AI を動かすための計算部品です。GPU は、AI の計算が得意で高性能ですが、高価です。CPU は、パソコンやサーバーに普通に入っている汎用の部品で、AI 専用ではありません。
- 成果(アウトカム):AI が、こちらの要求を満たす結果を出し終えた 1 件のことです。
- SLO:サービスが守るべき目標値のことです。「何秒以内に返す」「このくらいの品質を保つ」といった約束です。
- フォールバック:いつもの方法が使えないときに、代わりの方法に切り替えることです。
- そのほかの言葉は、出てきたところで説明します。
3 行まとめ
- トークンの単価ではなく、「成功した成果 1 件あたりのコスト」で考える。
- 推論は、モデルに質問するだけではなく、いくつもの段階がつながった流れ。段階ごとに、コストを減らす打ち手がある。
- モデルを一度選んで終わりにせず、何度でも選び直せる仕組みを作る。CPU はその有力な選択肢の一つ。
「安いトークン」が「安い成果」とは限らない
売上より費用が大きいと、増えるほど赤字になる
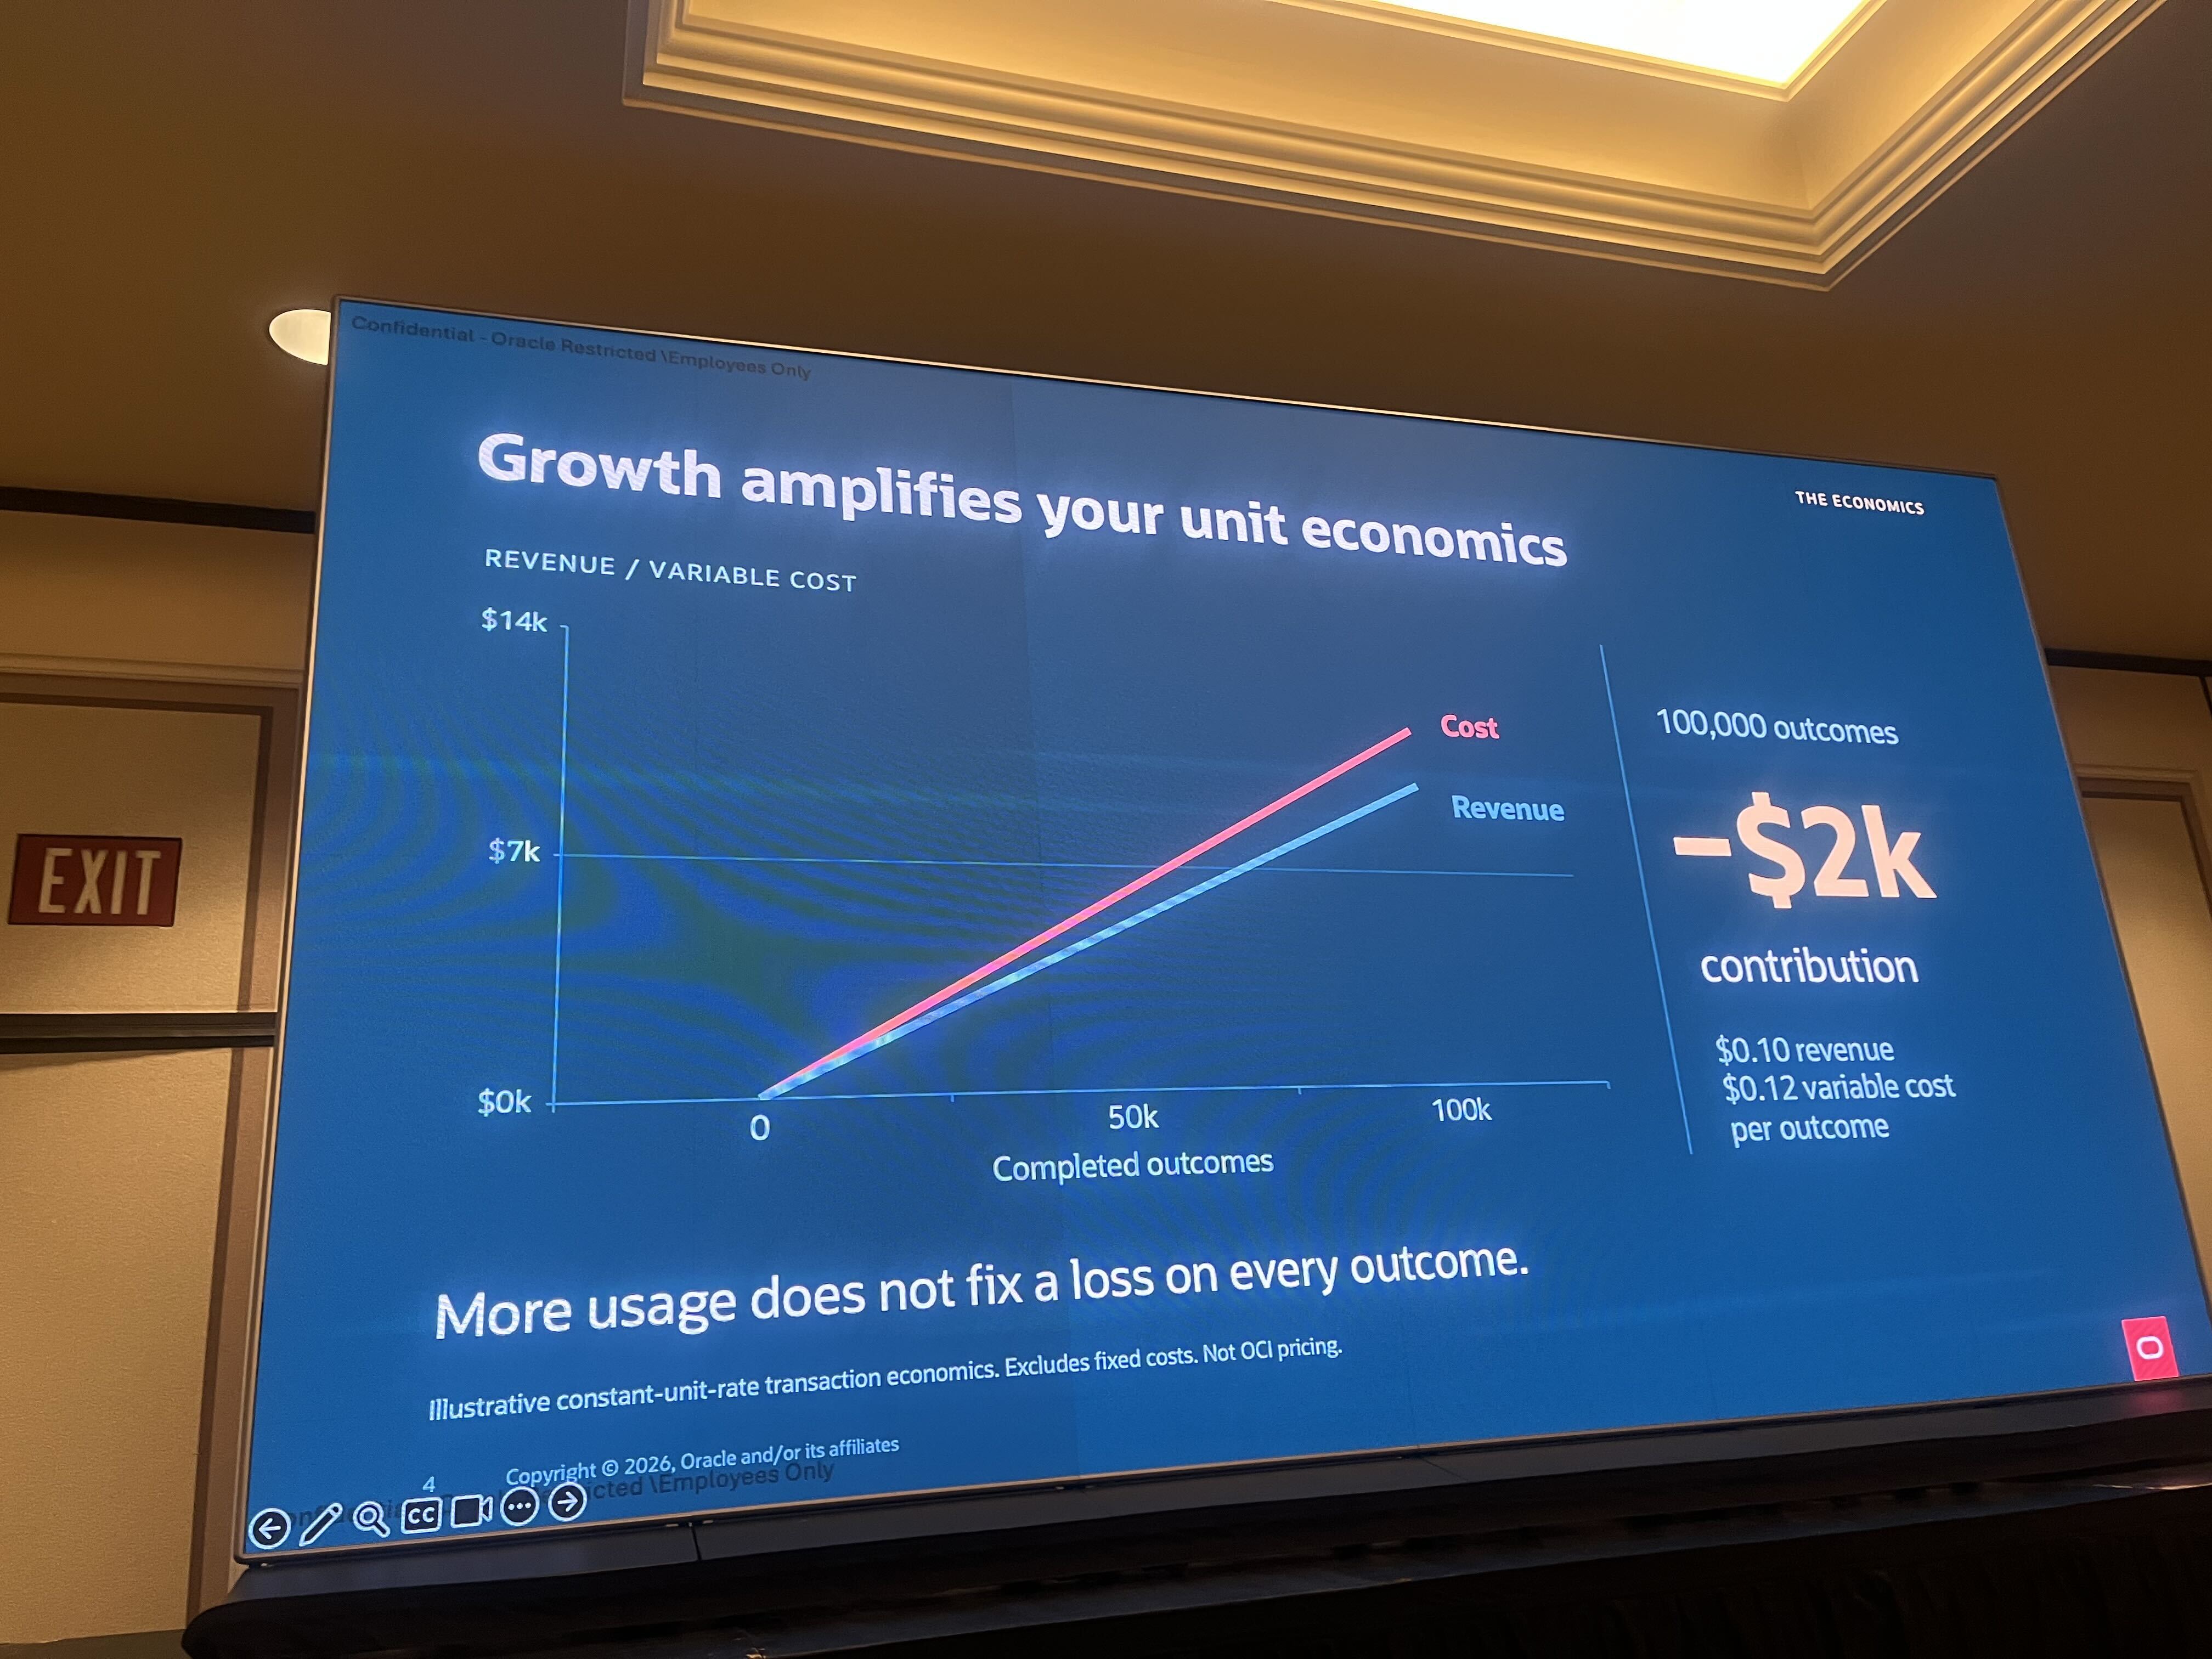
- 最初は、グラフで見せる損益の話です。
-
1 件の成果で、売上が $0.10、変動費(件数に応じてかかる費用)が $0.12 だったとします。10 万件こなすと、$2k(2,000 ドル)の赤字です。スライドには「More usage does not fix a loss on every outcome.(たくさん使われても、1 件ごとの赤字は直らない)」とありました。
-
なお、このスライドの数字は、注記で「説明用の例で、OCI の料金ではない」とされています。
トークンが半額でも、成果あたりの費用は 3 倍になる
- 冒頭のクイズの答えです。
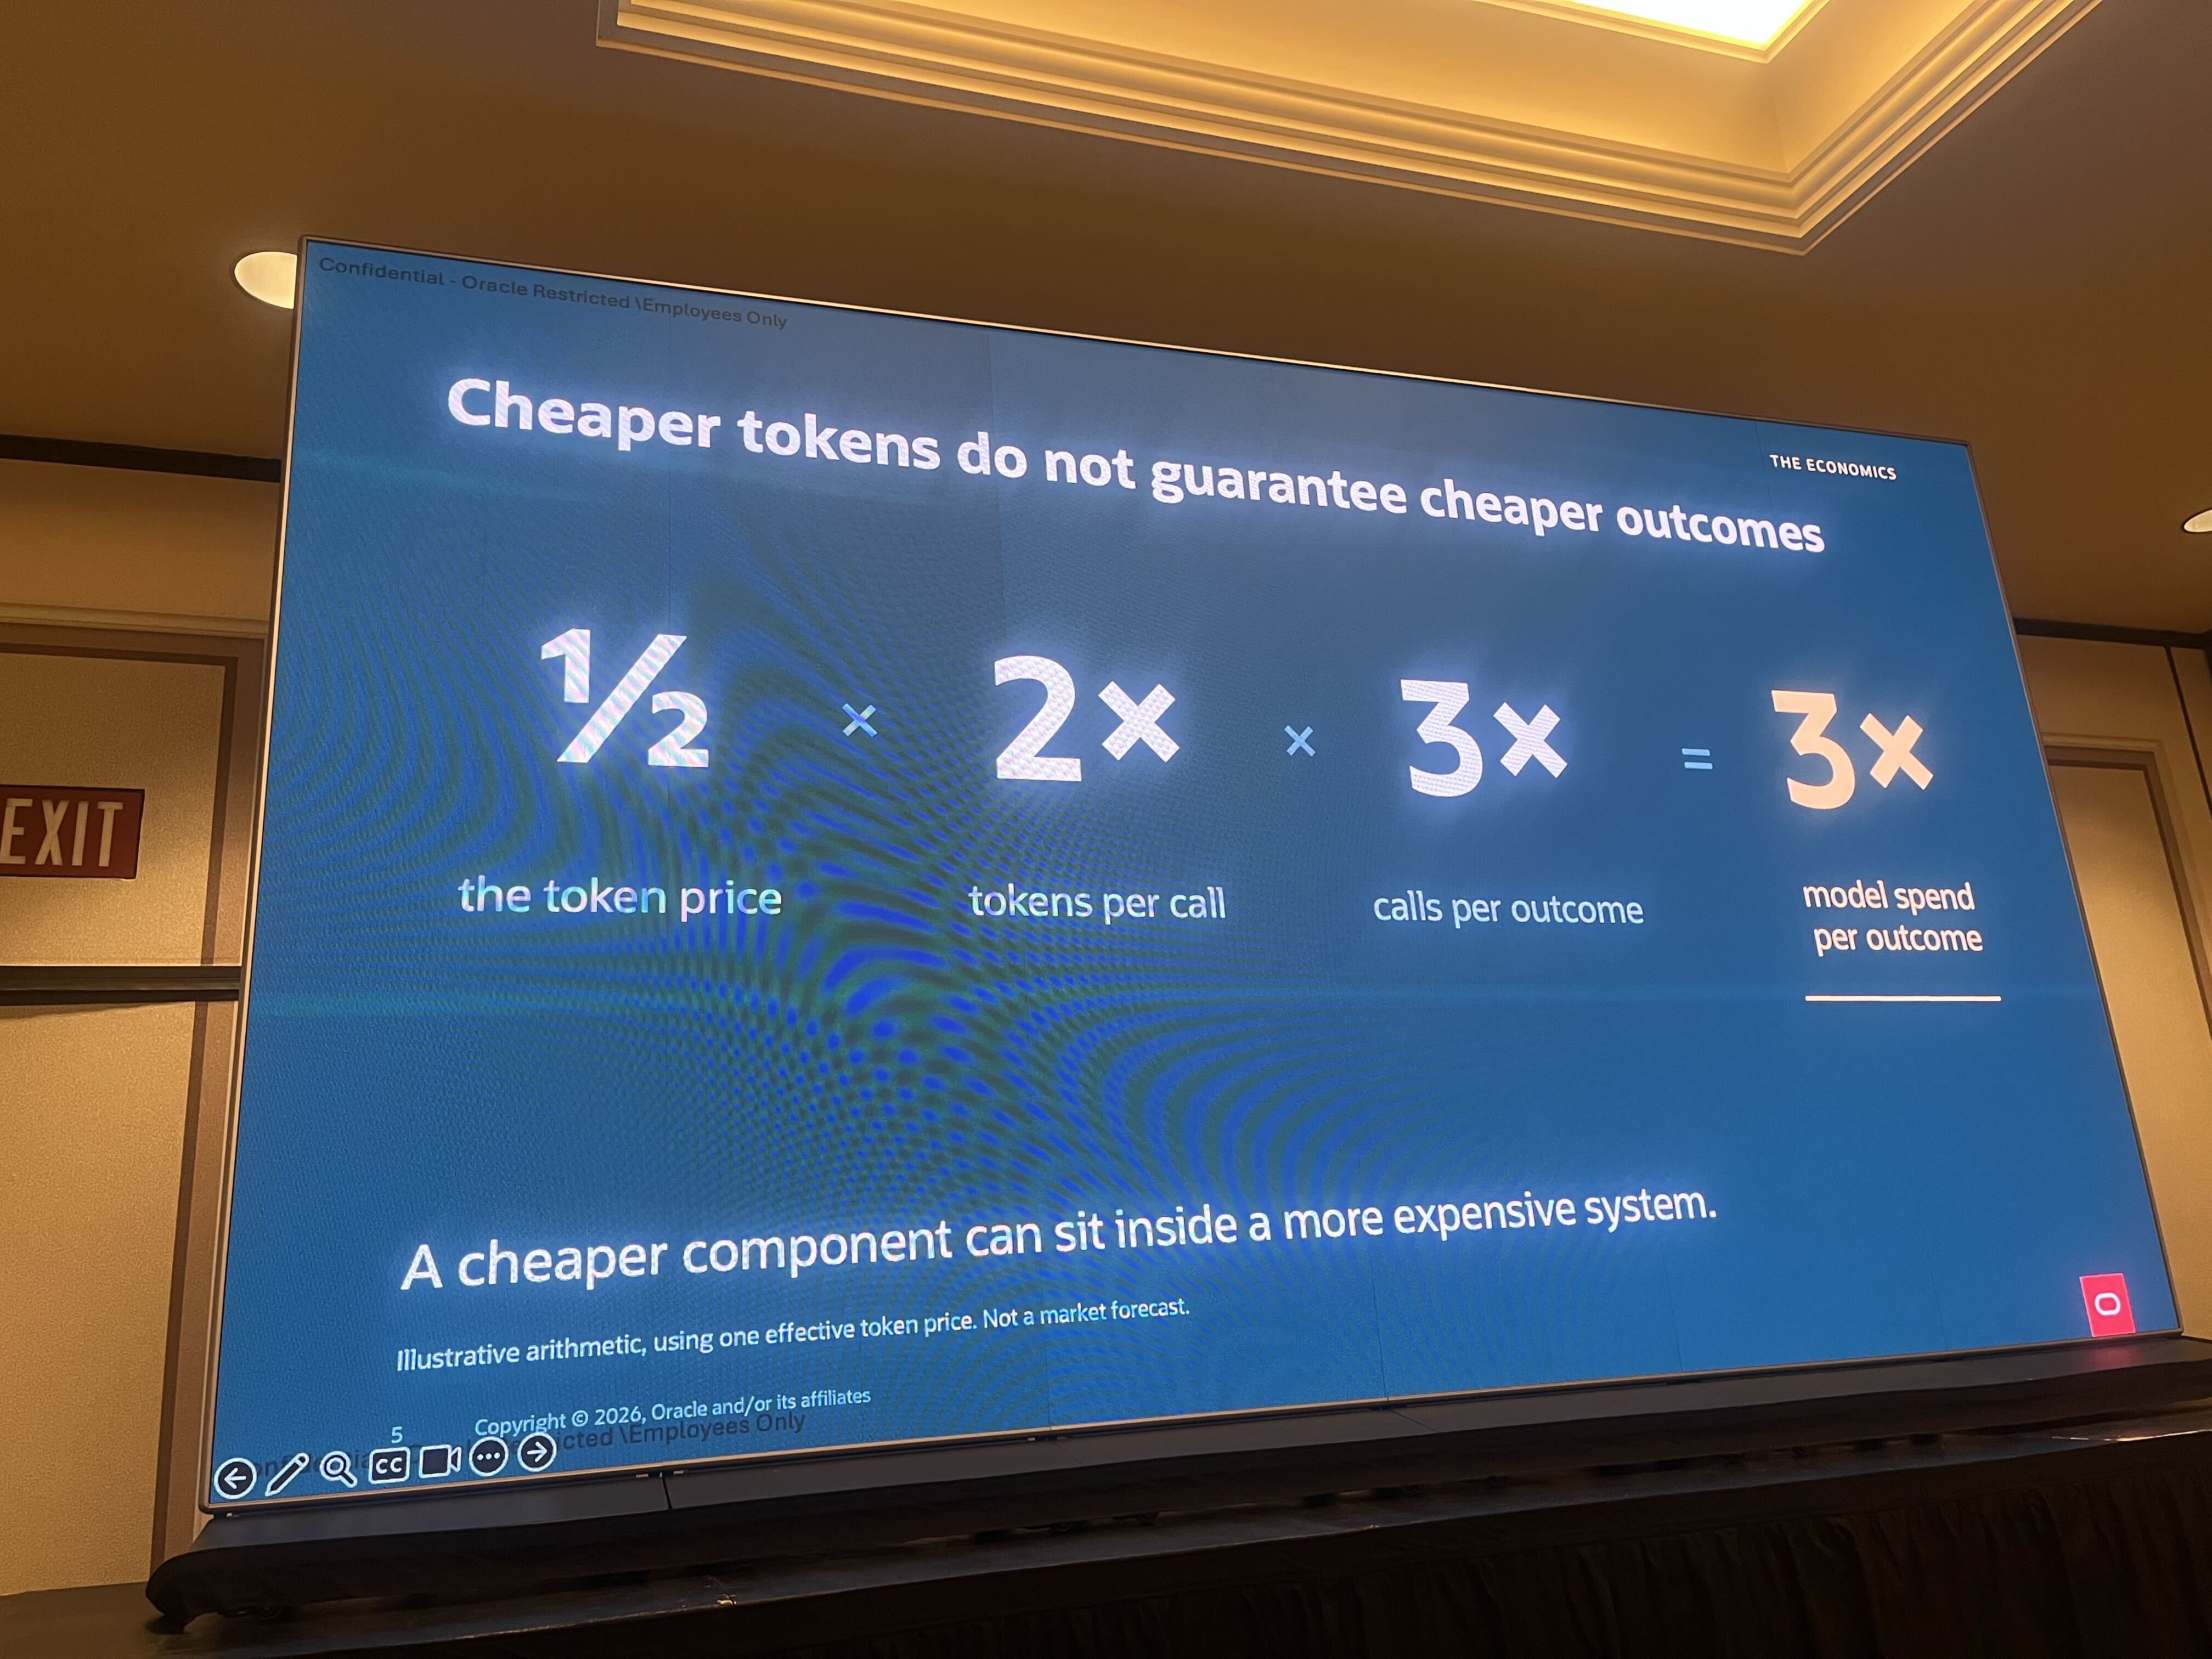
- トークン単価:半分(1/2)
- 1 回の質問で使うトークンの量:2 倍
- 1 件の成果を出すのに必要な質問の回数:3 倍
- 成果 1 件あたりのモデル費用:3 倍
-
単価は半分でも、使う量が 2 倍、回数が 3 倍なら、1/2 × 2 × 3 で、費用は 3 倍です。スライドの言葉では「A cheaper component can sit inside a more expensive system.(安い部品が、高いシステムの中に入っていることがある)」でした。これも、説明用の計算です。
数えるのは「全部の費用」と「成功した成果だけ」
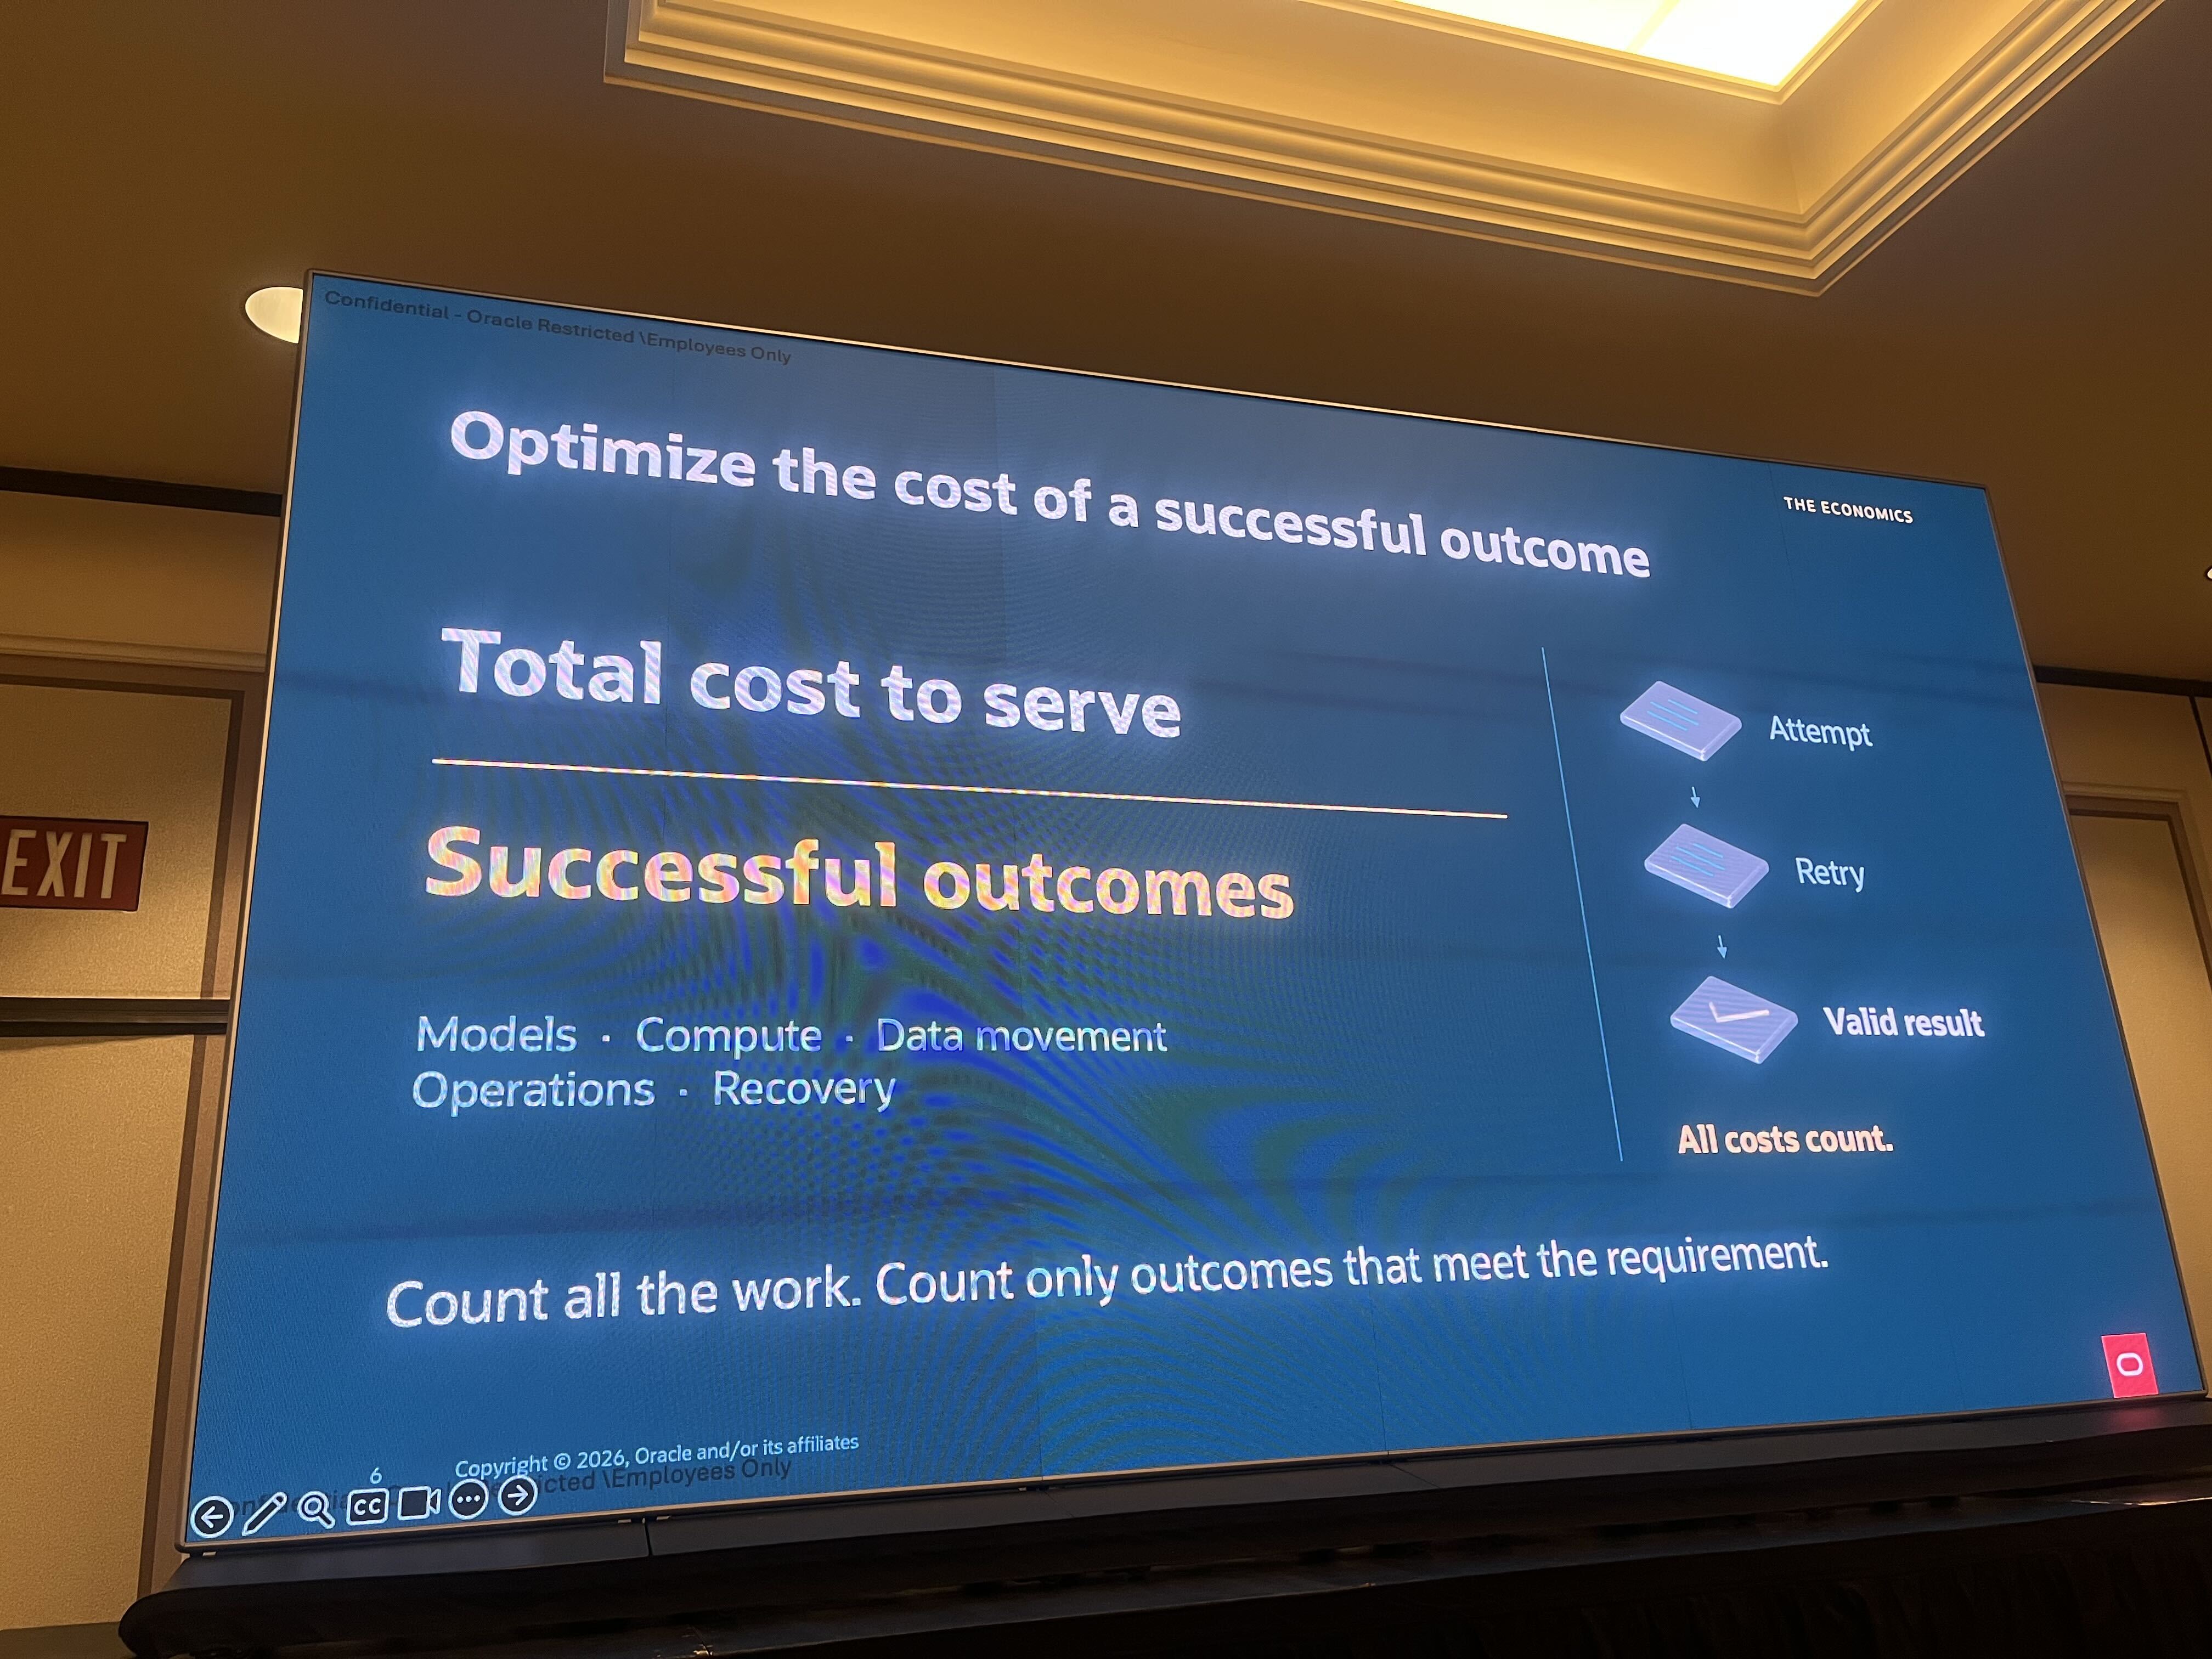
-
考え方はシンプルです。
成功した成果 1 件あたりのコスト = 提供にかかった費用の合計 ÷ 成功した成果の数
- 費用の合計には、モデルの利用料、計算資源、データの移動、運用、復旧、さらに失敗してやり直した分(リトライ)まで、全部入れます。
- 成果の数には、要件を満たした成功分だけを数えます。
- スライドの言葉では「Count all the work. Count only outcomes that meet the requirement.(作業は全部数える。数える成果は、要件を満たしたものだけ)」です。失敗ややり直しが多いほど、1 件あたりのコストは上がります。
推論は、いくつもの段階がつながった流れ
推論は 6 つの段階に分けられる
-
スライドでは、推論を、次の 6 つの段階の流れで示していました。サプライチェーン(部品の調達から商品が届くまでの流れ)のようなもの、という説明です。
リクエスト(依頼)→ コンテキスト(参考情報)→ ルート(行き先の選択)→ 実行 → 検証 → 成果
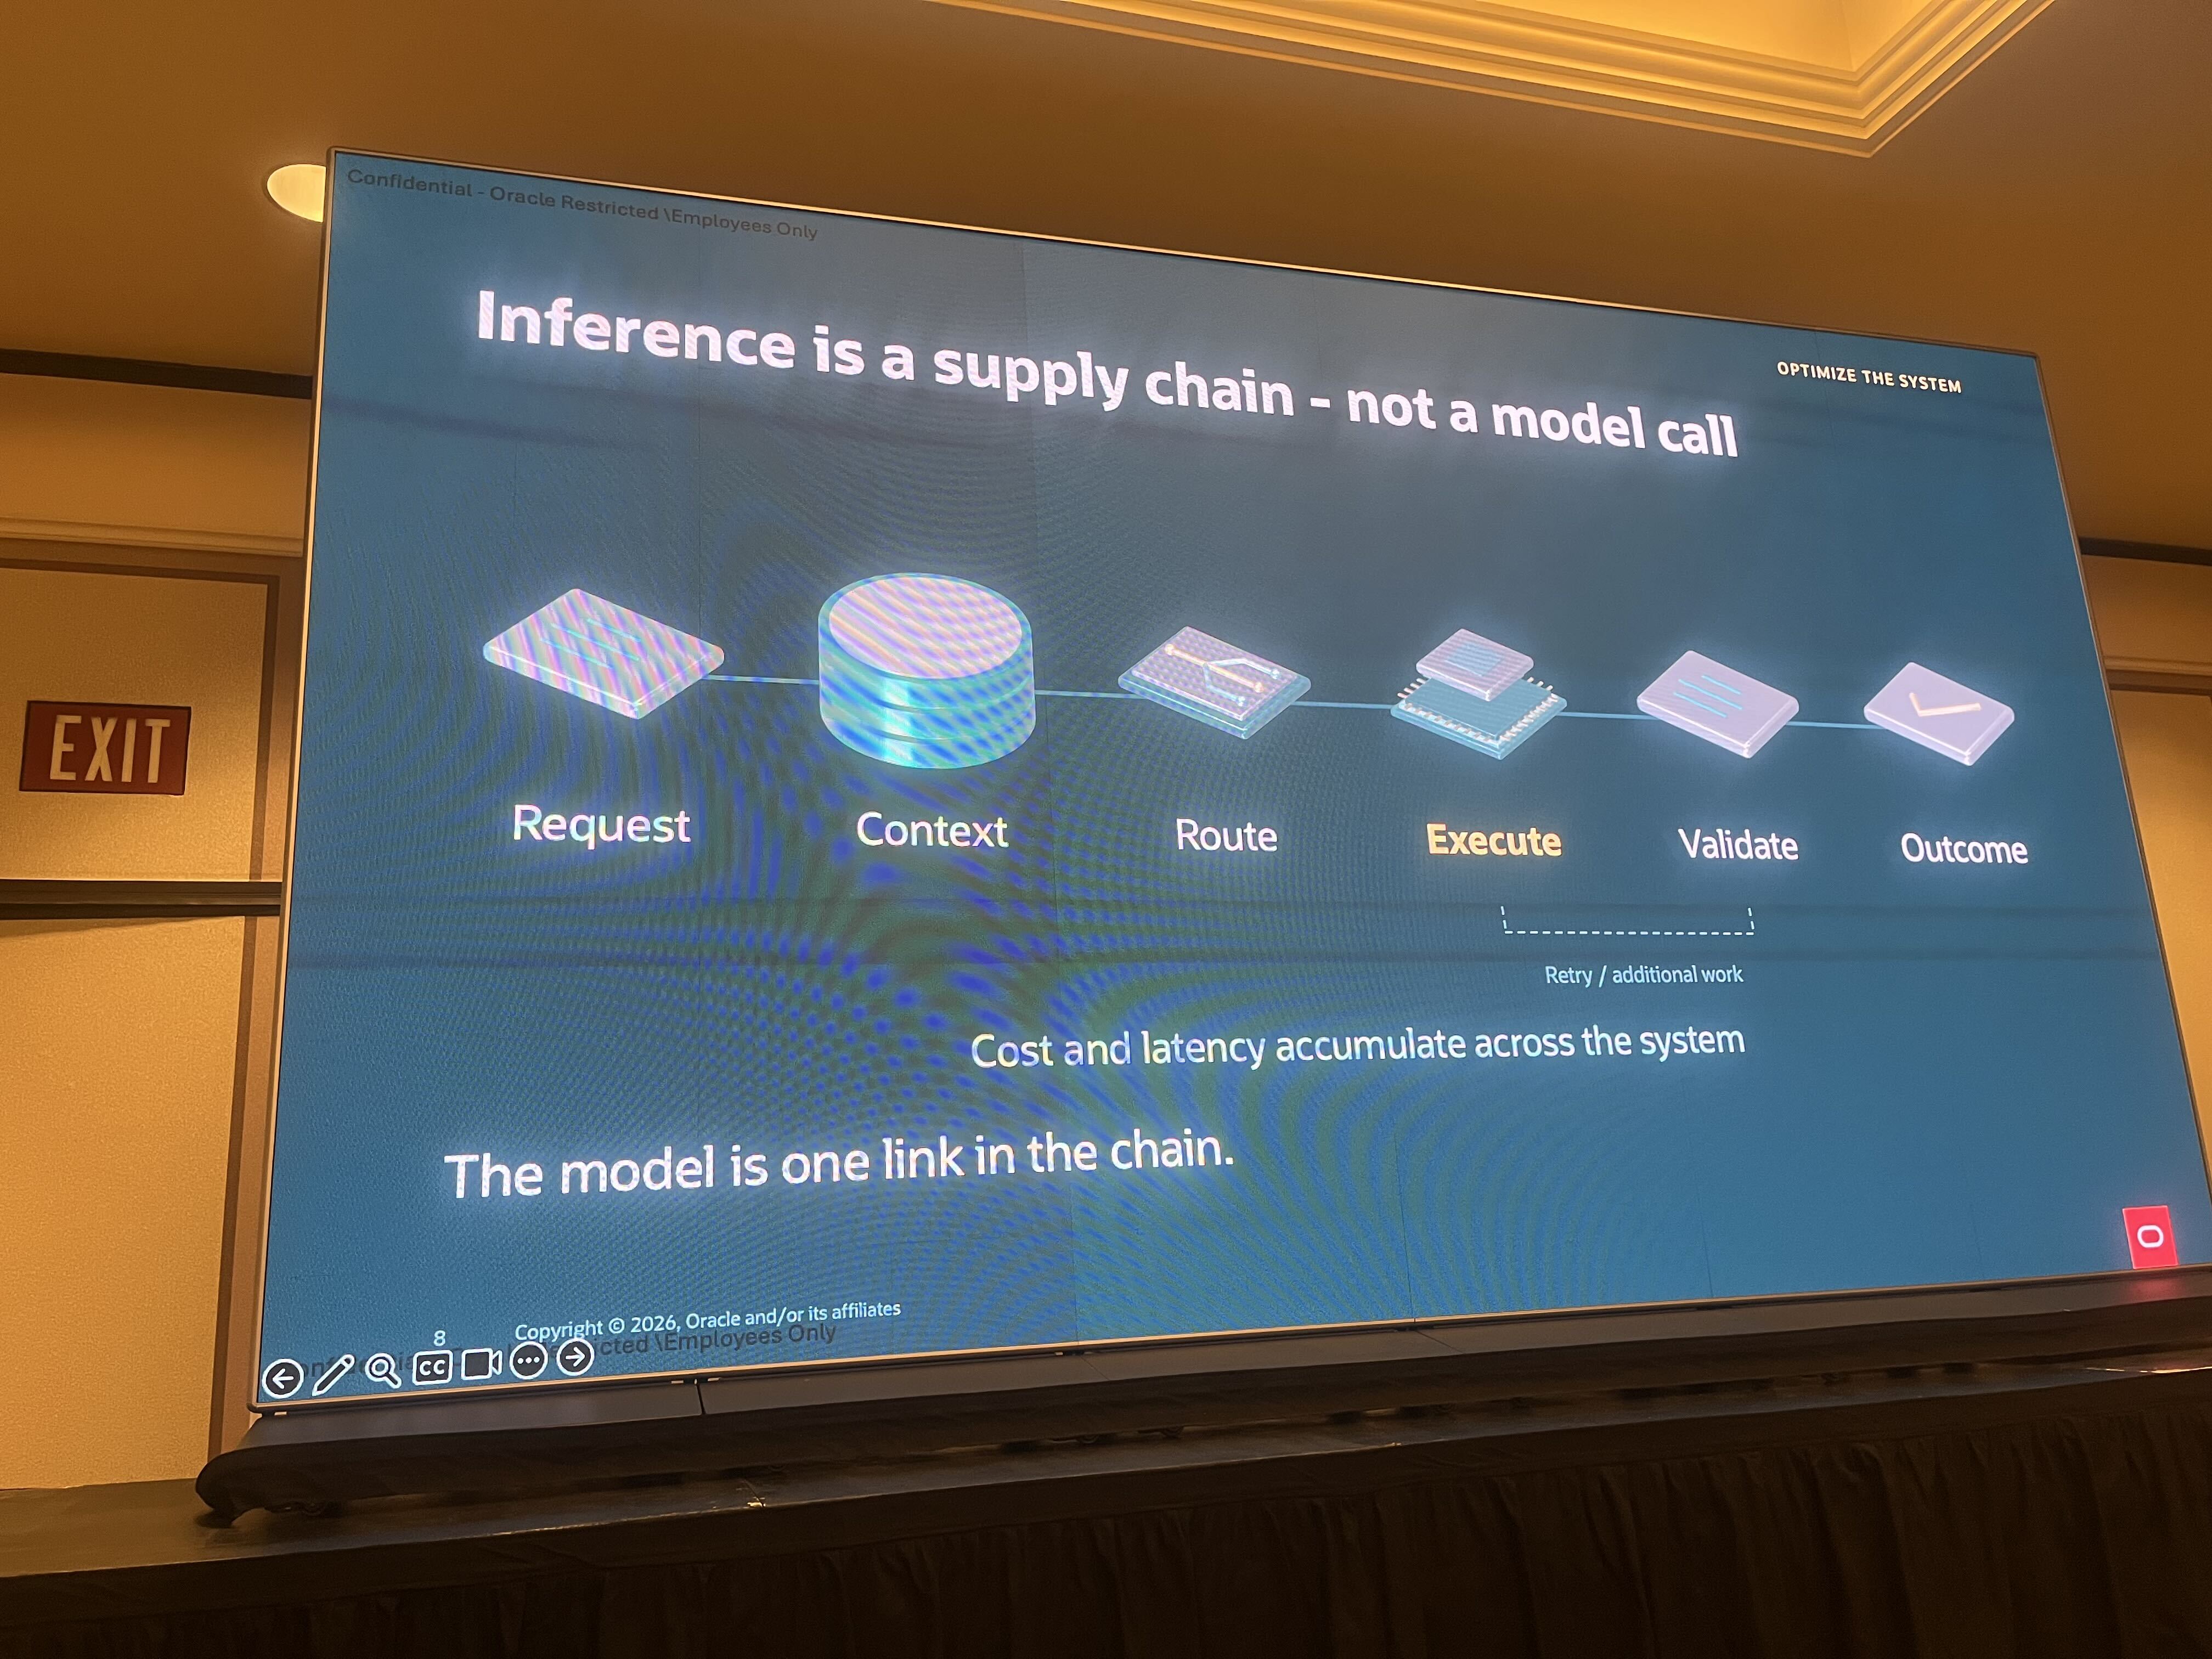
-
モデルが答えを作るのは、「実行」の段階だけです。スライドには「The model is one link in the chain.(モデルは、流れの中の一つにすぎない)」とあり、費用と待ち時間は、流れ全体で積み上がります。
段階ごとに、コストを減らす打ち手がある
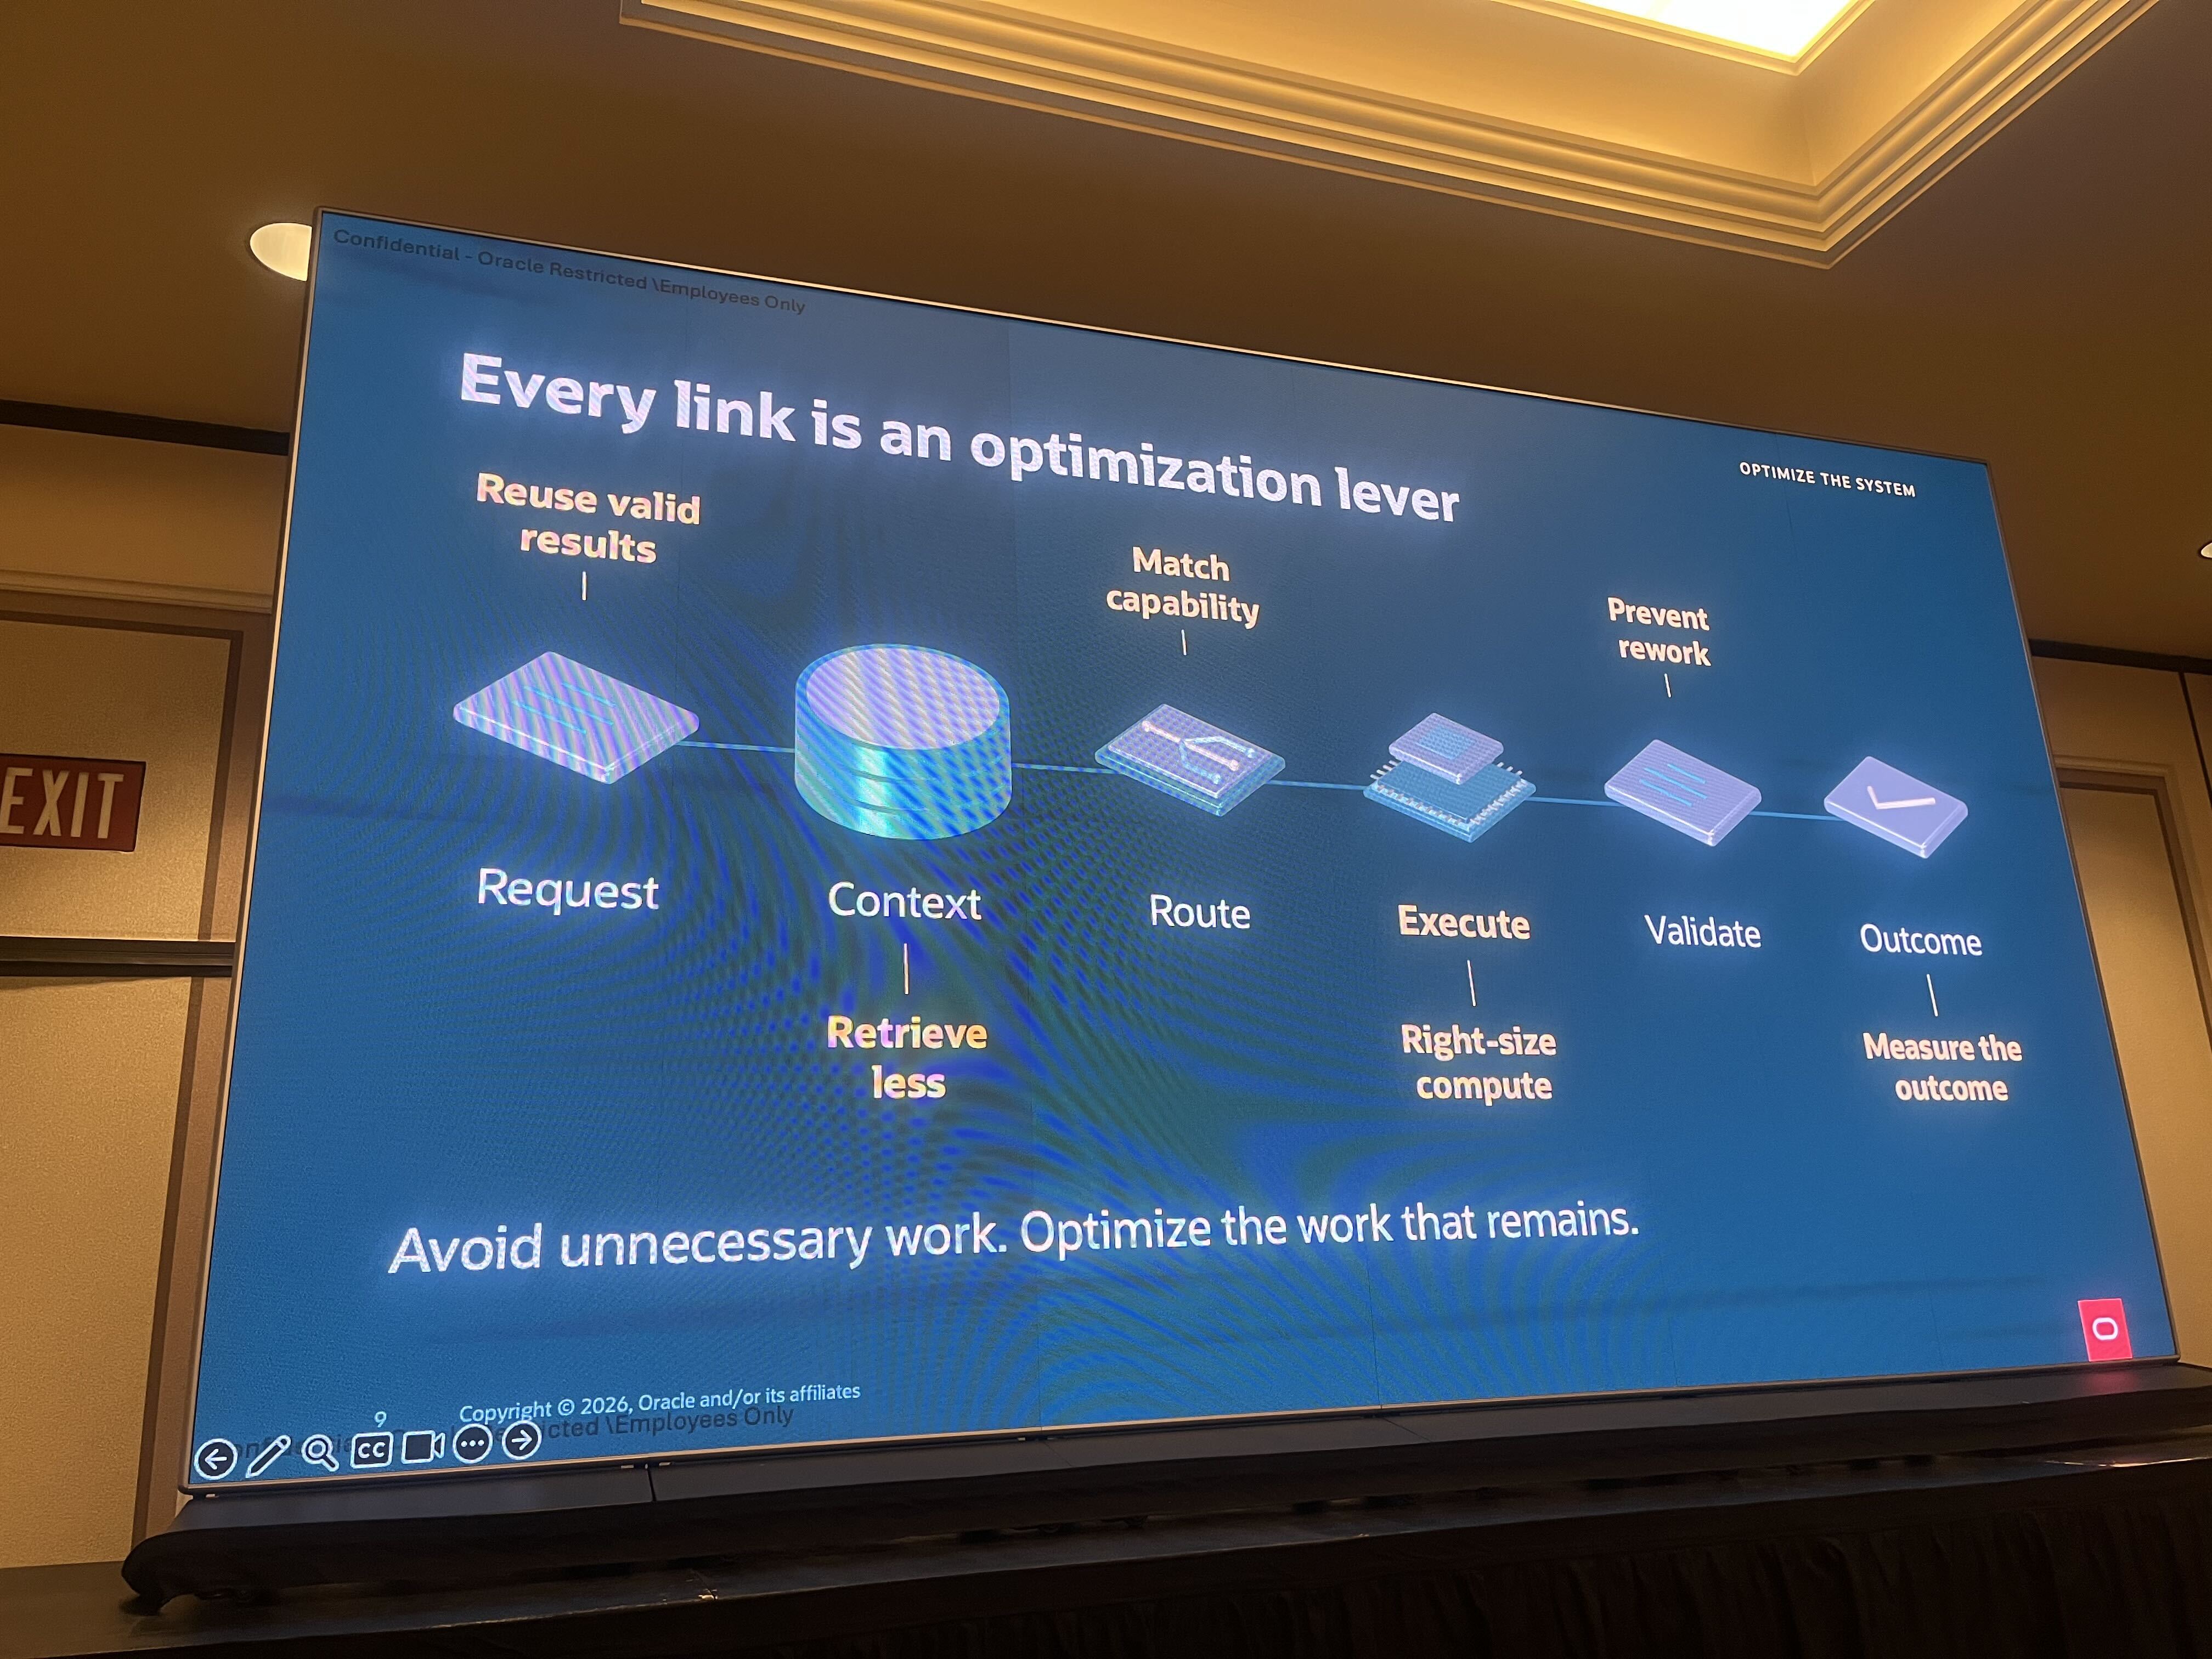
- 6 つの段階それぞれに、コストを減らすための打ち手が示されていました。
| 段階 | スライドの言葉 | ポイント |
|---|---|---|
| リクエスト | Reuse valid results | 同じ依頼には、前の答えを使い回す |
| コンテキスト | Retrieve less | 参考情報は、必要な分だけ取ってくる |
| ルート | Match capability | 仕事に合う実行先を選ぶ |
| 実行 | Right-size compute | 計算資源を、ちょうどよい大きさにする |
| 検証 | Prevent rework | やり直しが出ないようにする |
| 成果 | Measure the outcome | 成果を測る |
- このスライドの結びの一文は「Avoid unnecessary work. Optimize the work that remains.(無駄な仕事は避ける。残った仕事は最適化する)」です。まず「やらなくて済む仕事」を減らして、そのうえで残りを速く、安くする。この順番が大事だと受け取りました。
仕事ごとに、実行先を変える
全部を同じモデルで処理しない
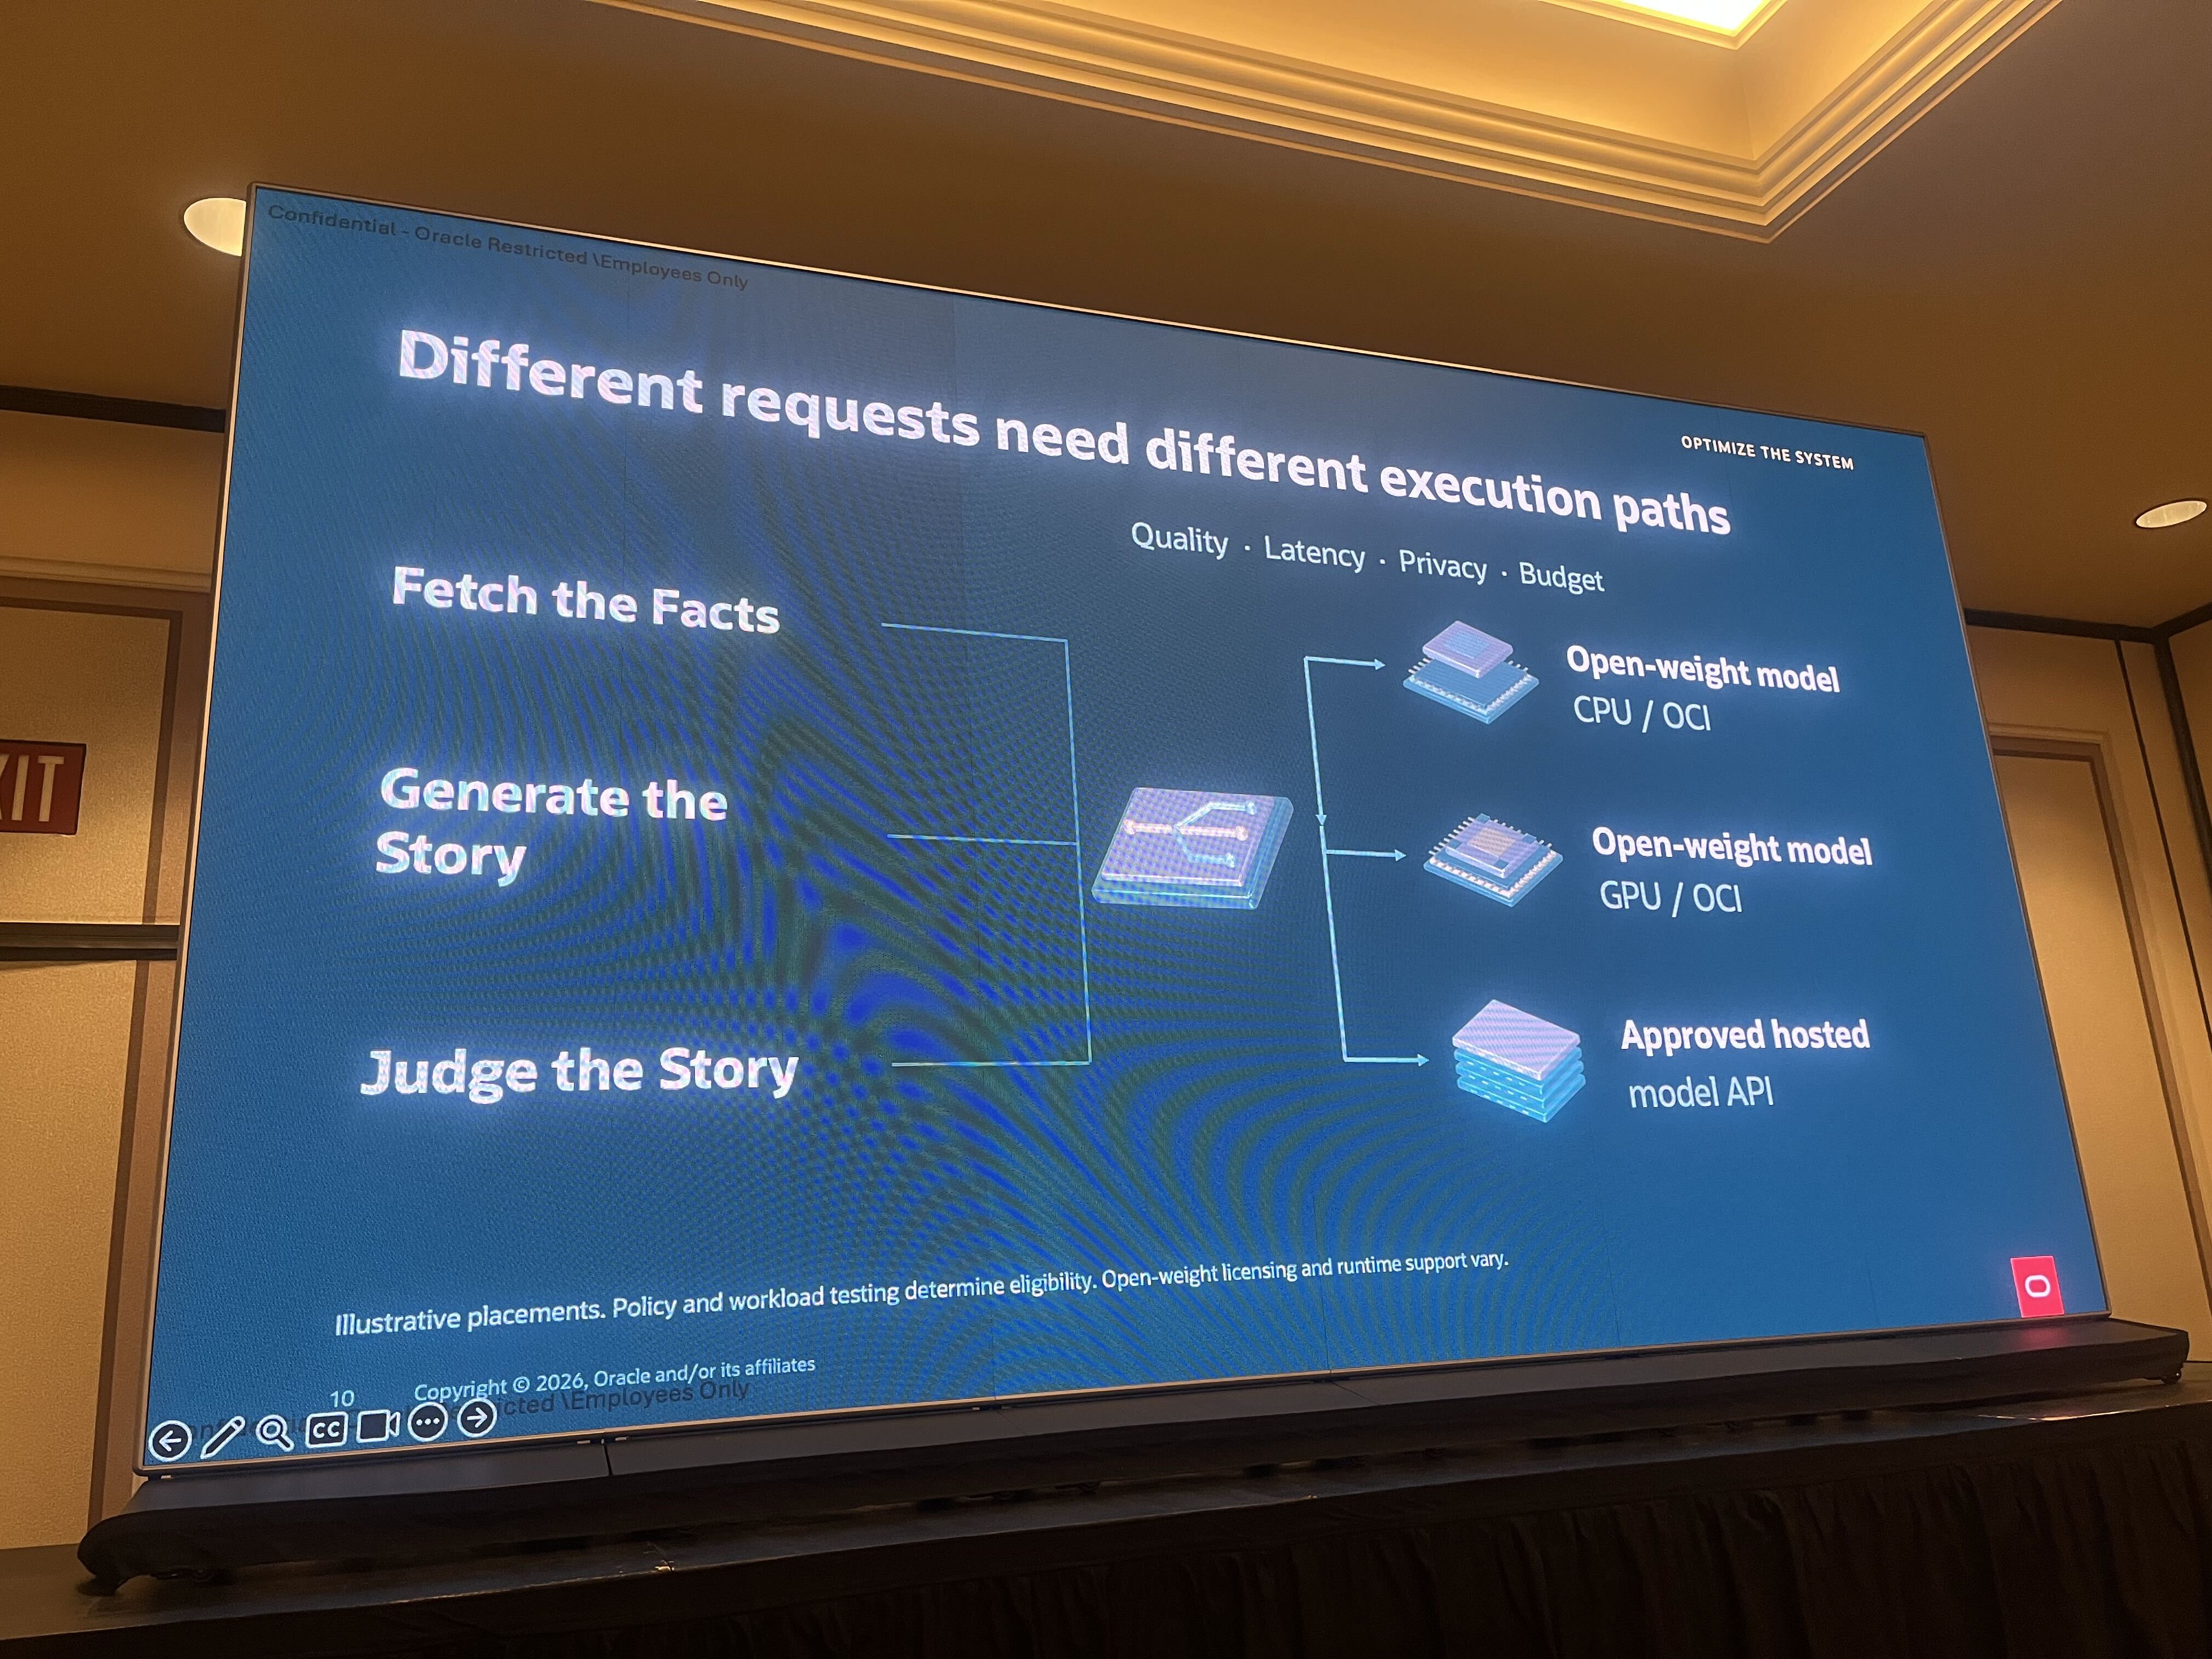
-
スライドでは、「Fetch the Facts(事実を取ってくる)」「Generate the Story(物語を作る)」「Judge the Story(物語を判定する)」という 3 種類の仕事が例に出ていました。右側に並ぶ実行先は、次の 3 つです。
- オープンウェイトモデル(CPU / OCI)
- オープンウェイトモデル(GPU / OCI)
- 承認済みのホスト型モデル API
-
オープンウェイトモデルは、中身(重み)が公開されていて、自分たちで動かせるモデルのことです。ホスト型 API は、外部の事業者が動かしているモデルを、サービスとして呼び出して使う方法です。
どこに振り分けるかは、Quality(品質)・Latency(待ち時間)・Privacy(情報の扱い)・Budget(予算)の 4 つで決めます。スライド下には「Illustrative placements. Policy and workload testing determine eligibility.(配置は例。実際はルールとテストで決める)」とありました。
主役は「CPU か GPU か」ではなく「SLO」
-
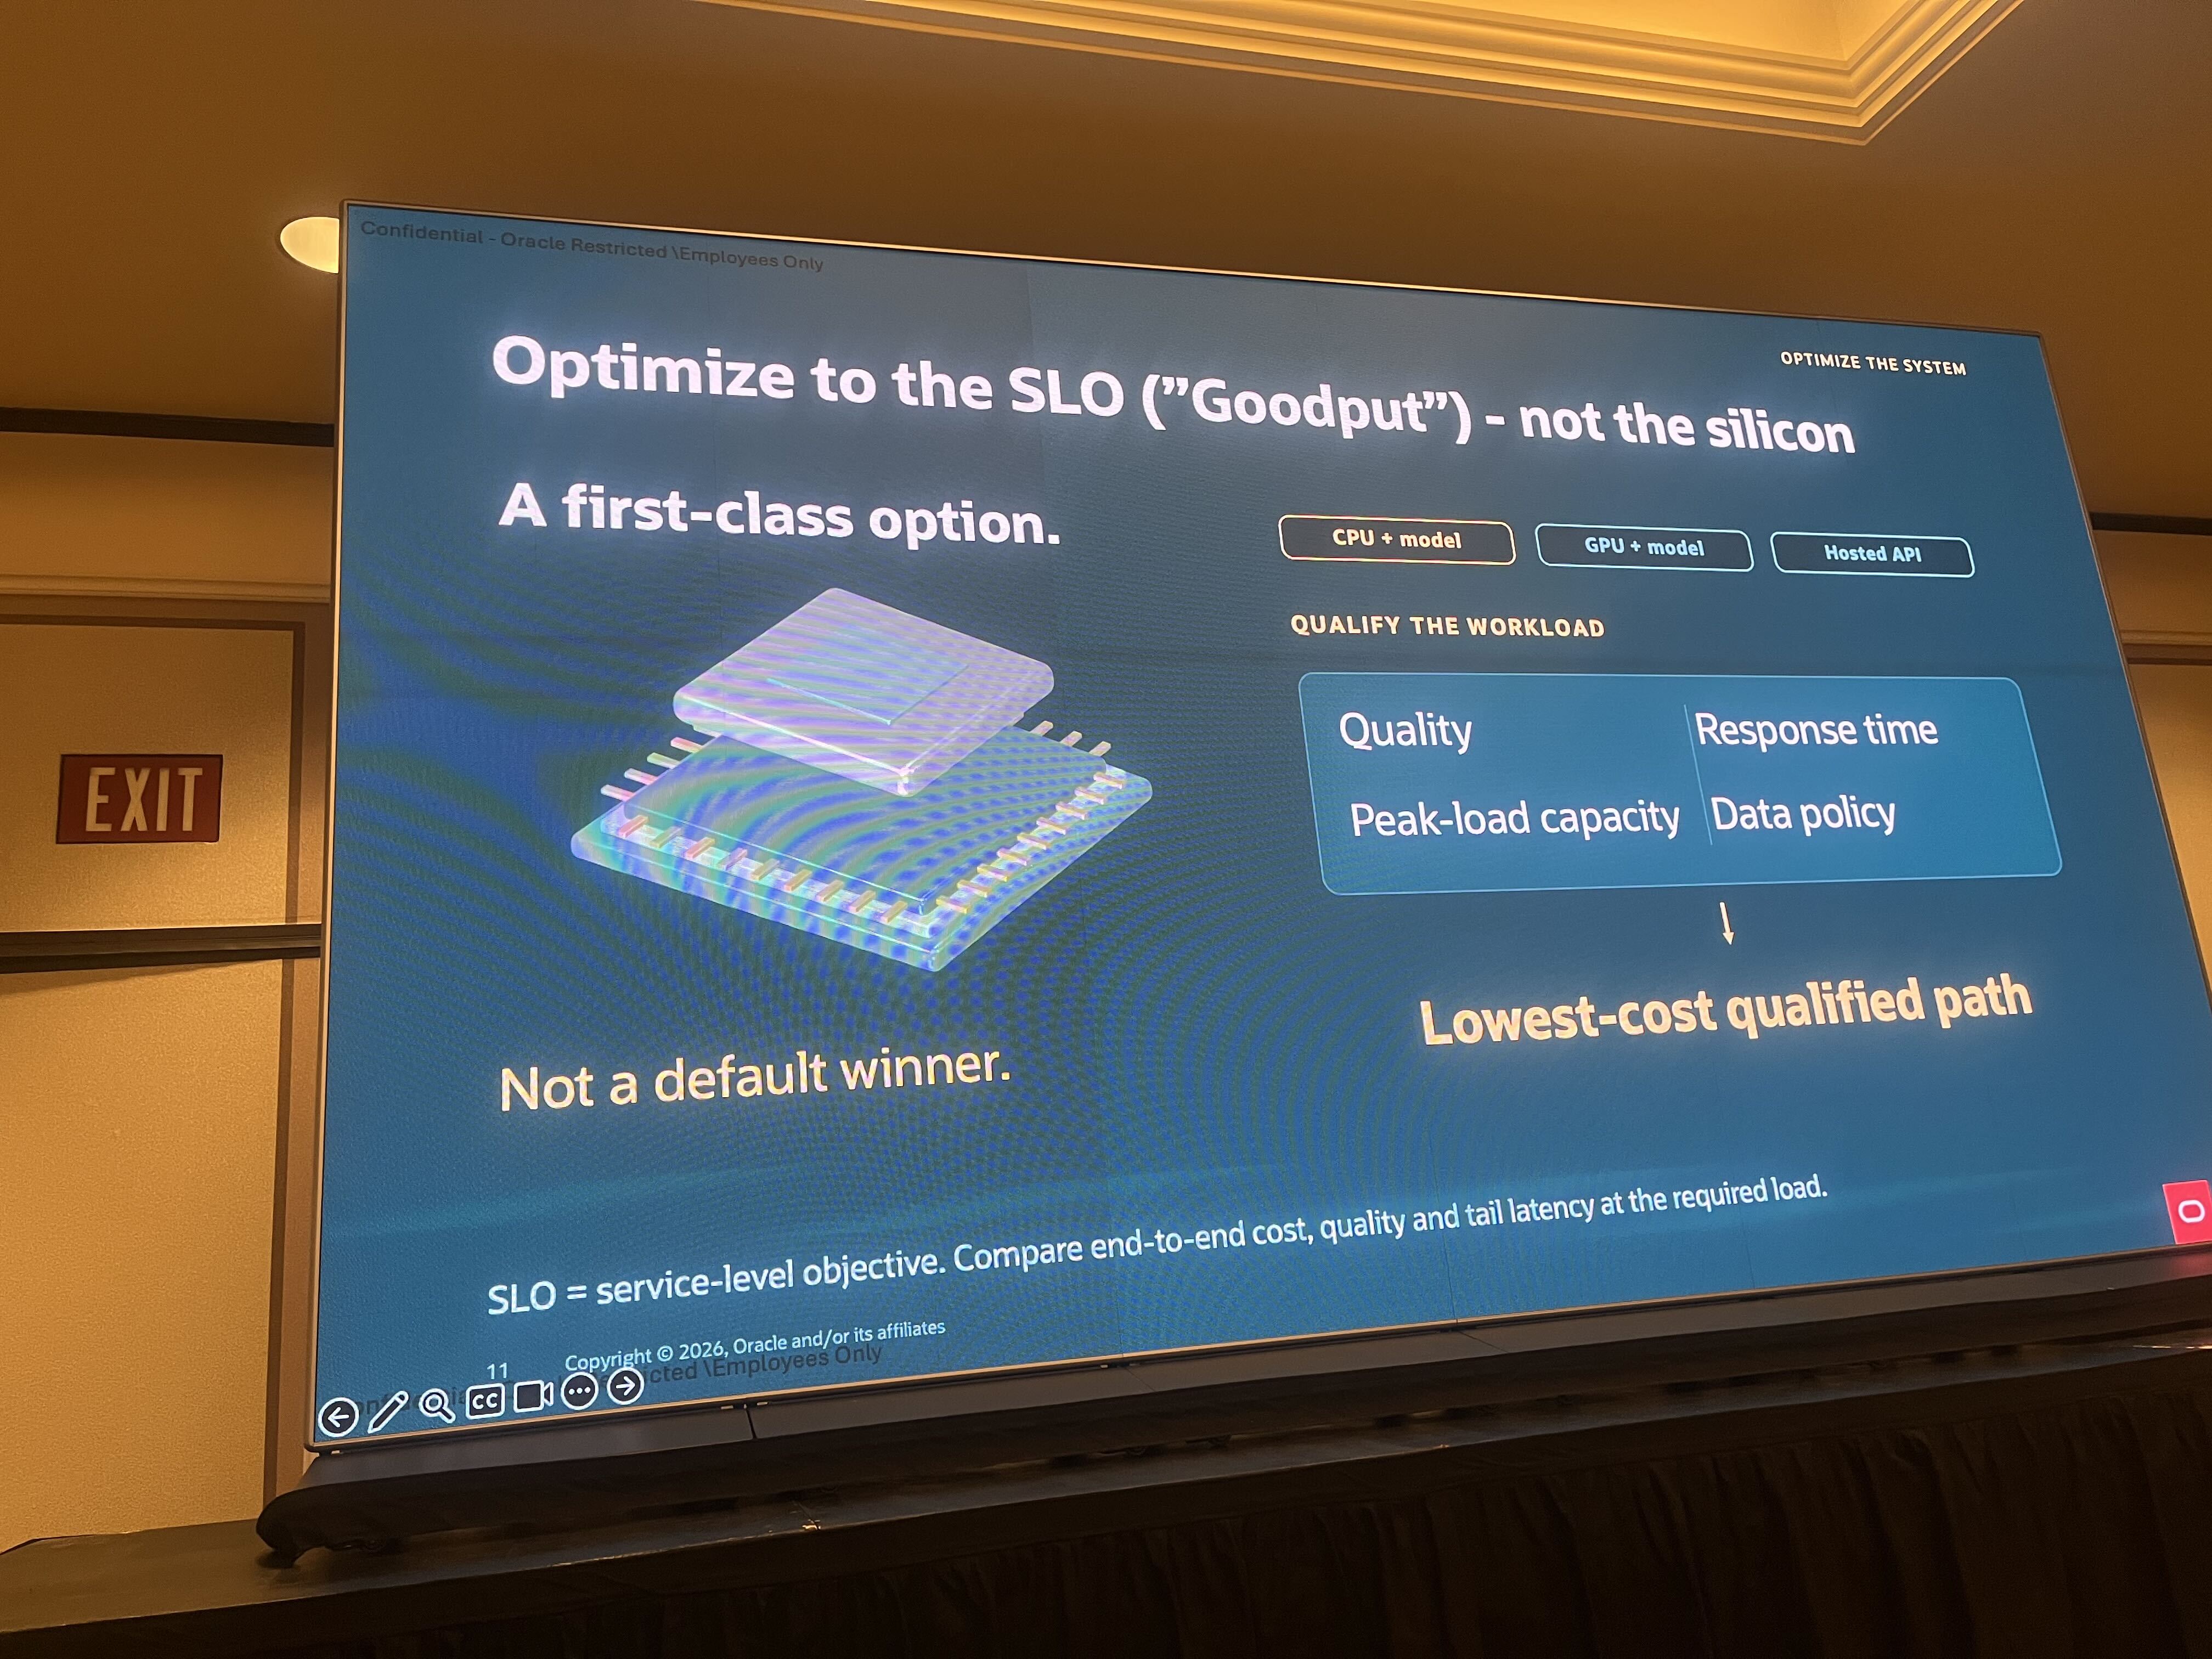
タイトルは「Optimize to the SLO (“Goodput”) – not the silicon」。「半導体(CPU か GPU か)ではなく、SLO(守るべき目標)に合わせて最適化する」という意味です。Goodput は、「ただ処理した量」ではなく「目標を満たして役に立った量」のことです。
-
スライドでは、仕事が次の 4 つの条件を満たせるかを確かめる、としていました。
- Quality(品質)
- Response time(応答時間)
- Peak-load capacity(いちばん混む時間帯に耐えられるか)
- Data policy(データの扱いのルール)
-
この条件を満たす実行先のうち、もっとも安いものを選びます(Lowest-cost qualified path)。
-
CPU については「A first-class option. Not a default winner.」と書かれていました。「有力な選択肢の一つだが、いつも勝つわけではない」という意味です。セッション名の「AI Without GPUs」は、「GPU は不要」という意味ではありません。条件が合えば、CPU でも十分な仕事がある、という話でした。
コストと障害への備えは、同じ設計から生まれる
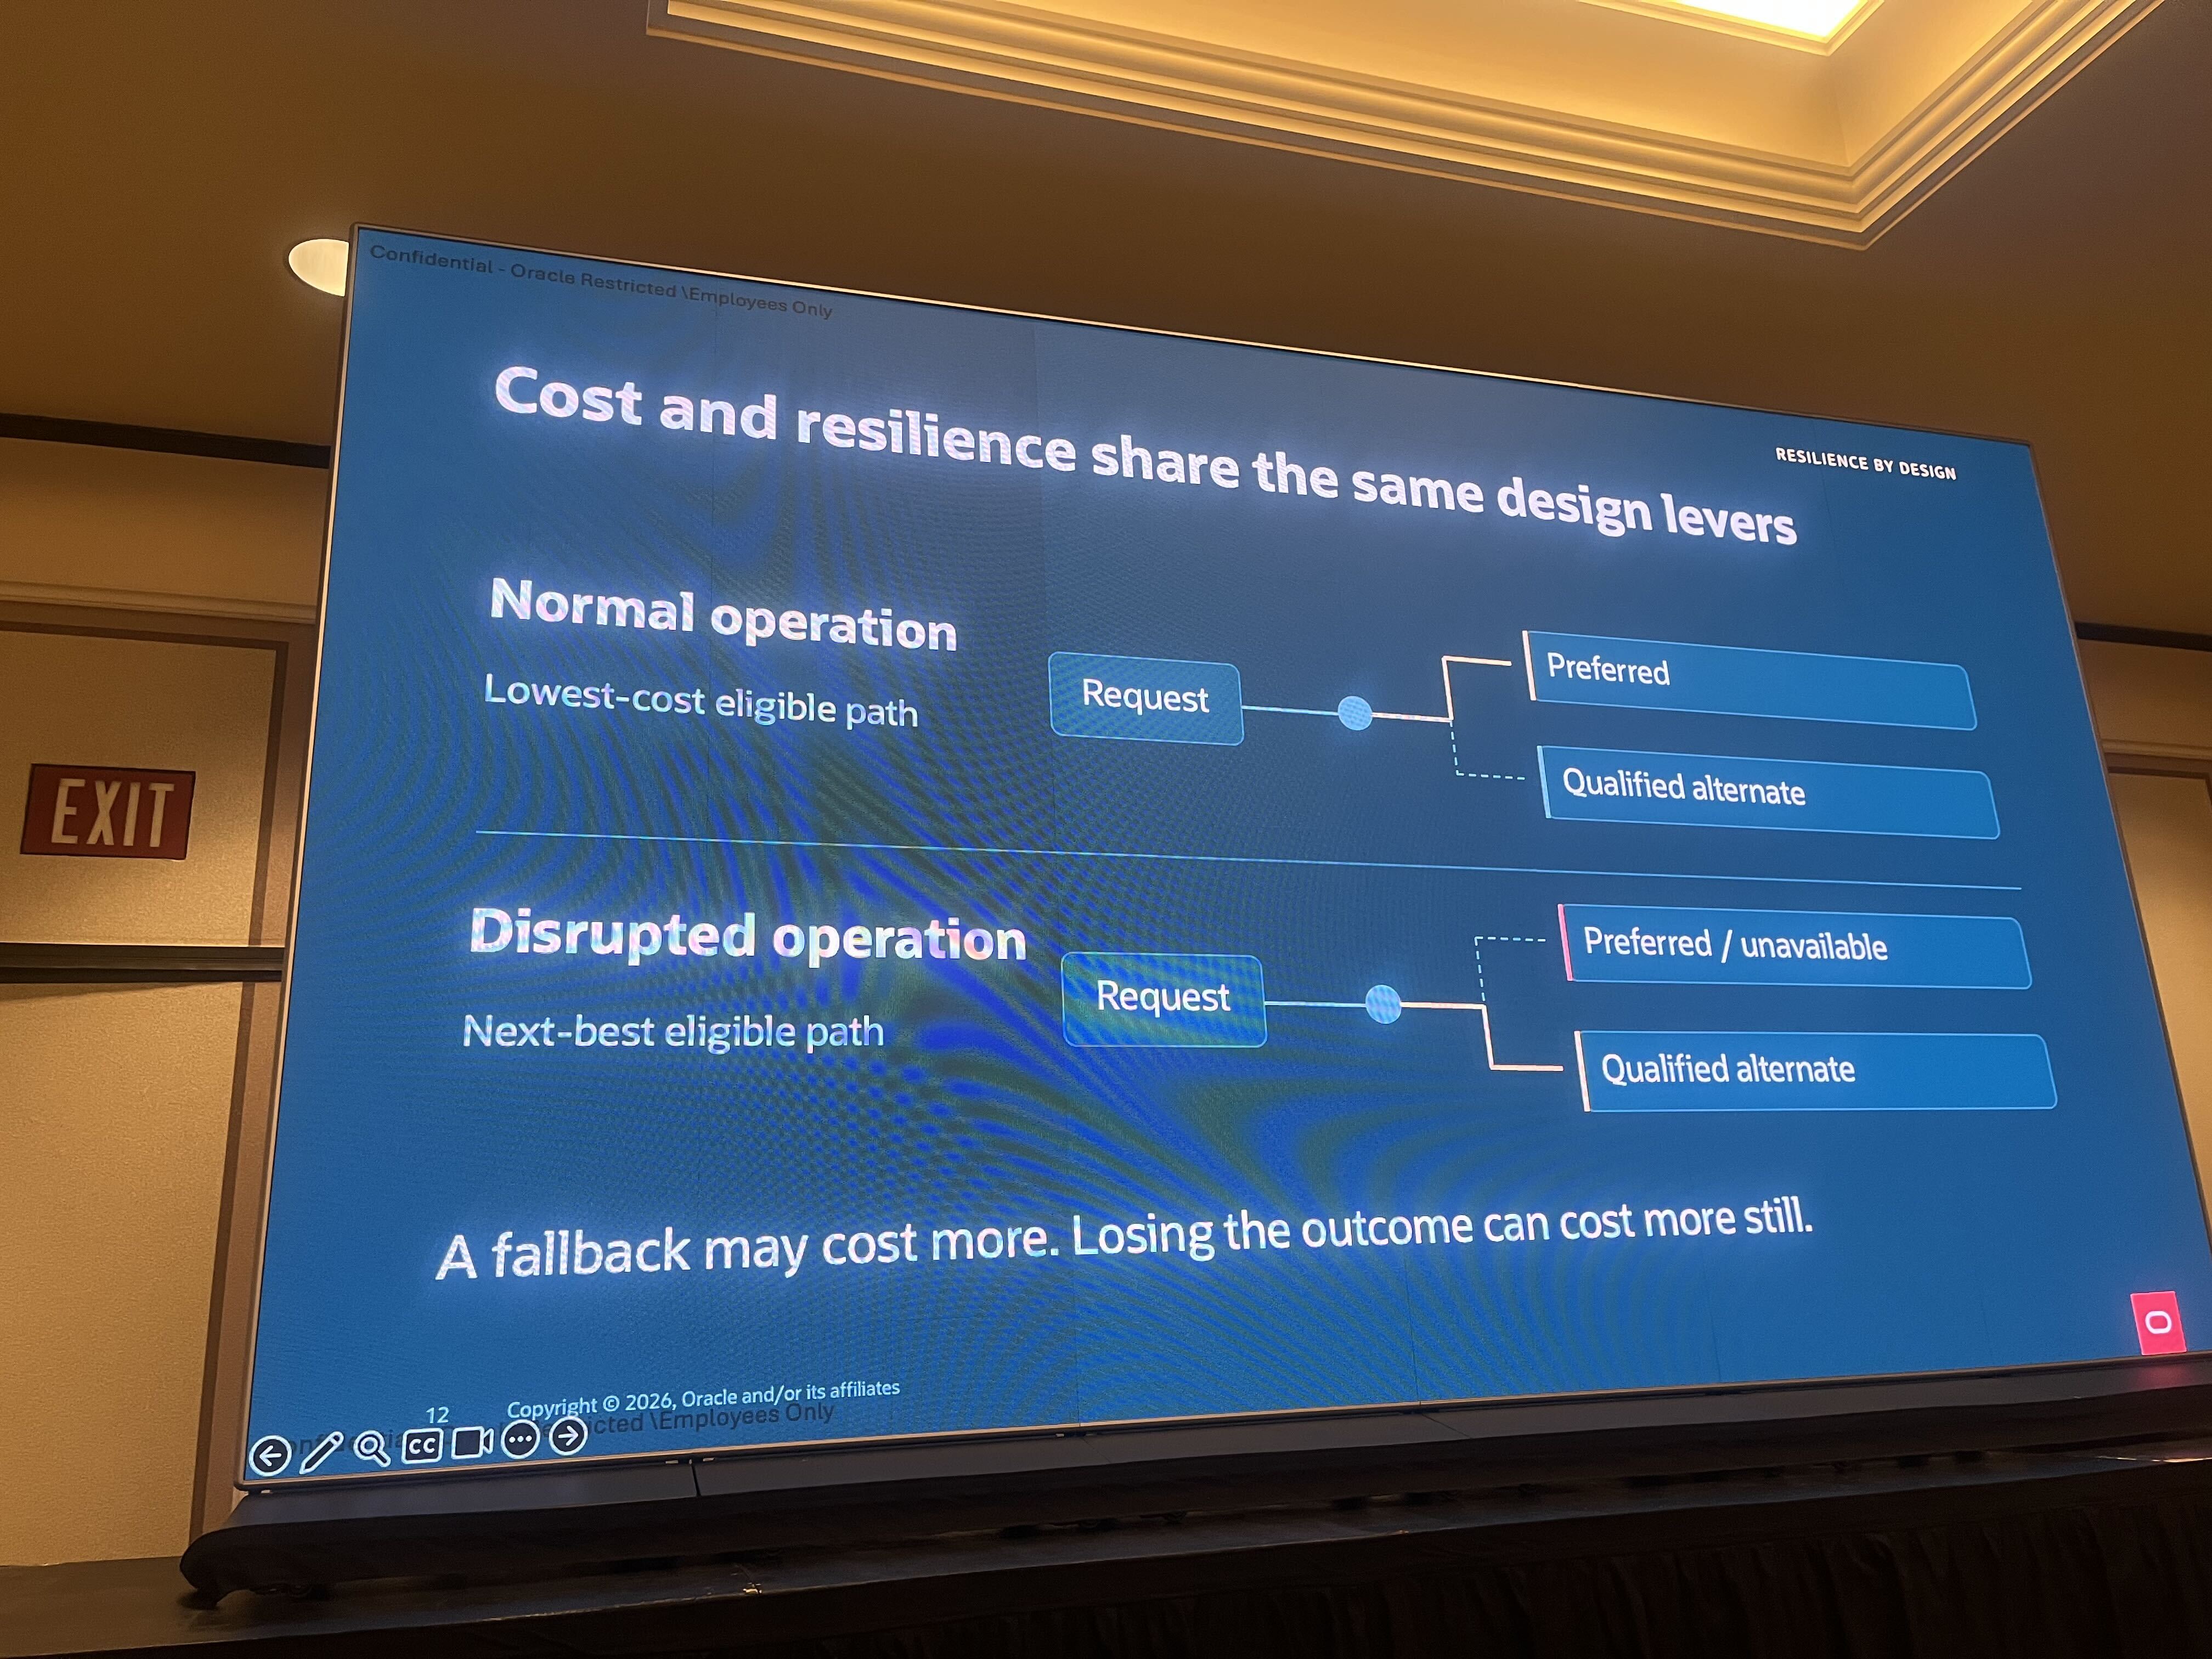
通常時は「いちばん安い道」、障害時は「代わりの道」
- ここでは、AI に仕事をさせる経路(実行先)を「道」と呼んでいます。
- 通常時:条件を満たす道の中で、もっとも安い道を選ぶ。
- 障害時:優先の道が使えなければ、代わりの道(Qualified alternate)に切り替える。
-
スライドの一文は「A fallback may cost more. Losing the outcome can cost more still.(代わりの道は、高くつくかもしれない。でも、成果を失うほうが、もっと高くつく)」でした。
-
代わりの道を用意しておくのは、お金だけ見ると無駄に見えます。でも、サービスが止まって成果そのものを失うほうが、損失が大きくなることがあります。
1 つのアプリでも、状況で行き先が変わる
- 次のスライドをご覧ください。図に出てくる部品(Routing gateway や Control plane など)は、このあとの「構成例」で説明します。
-
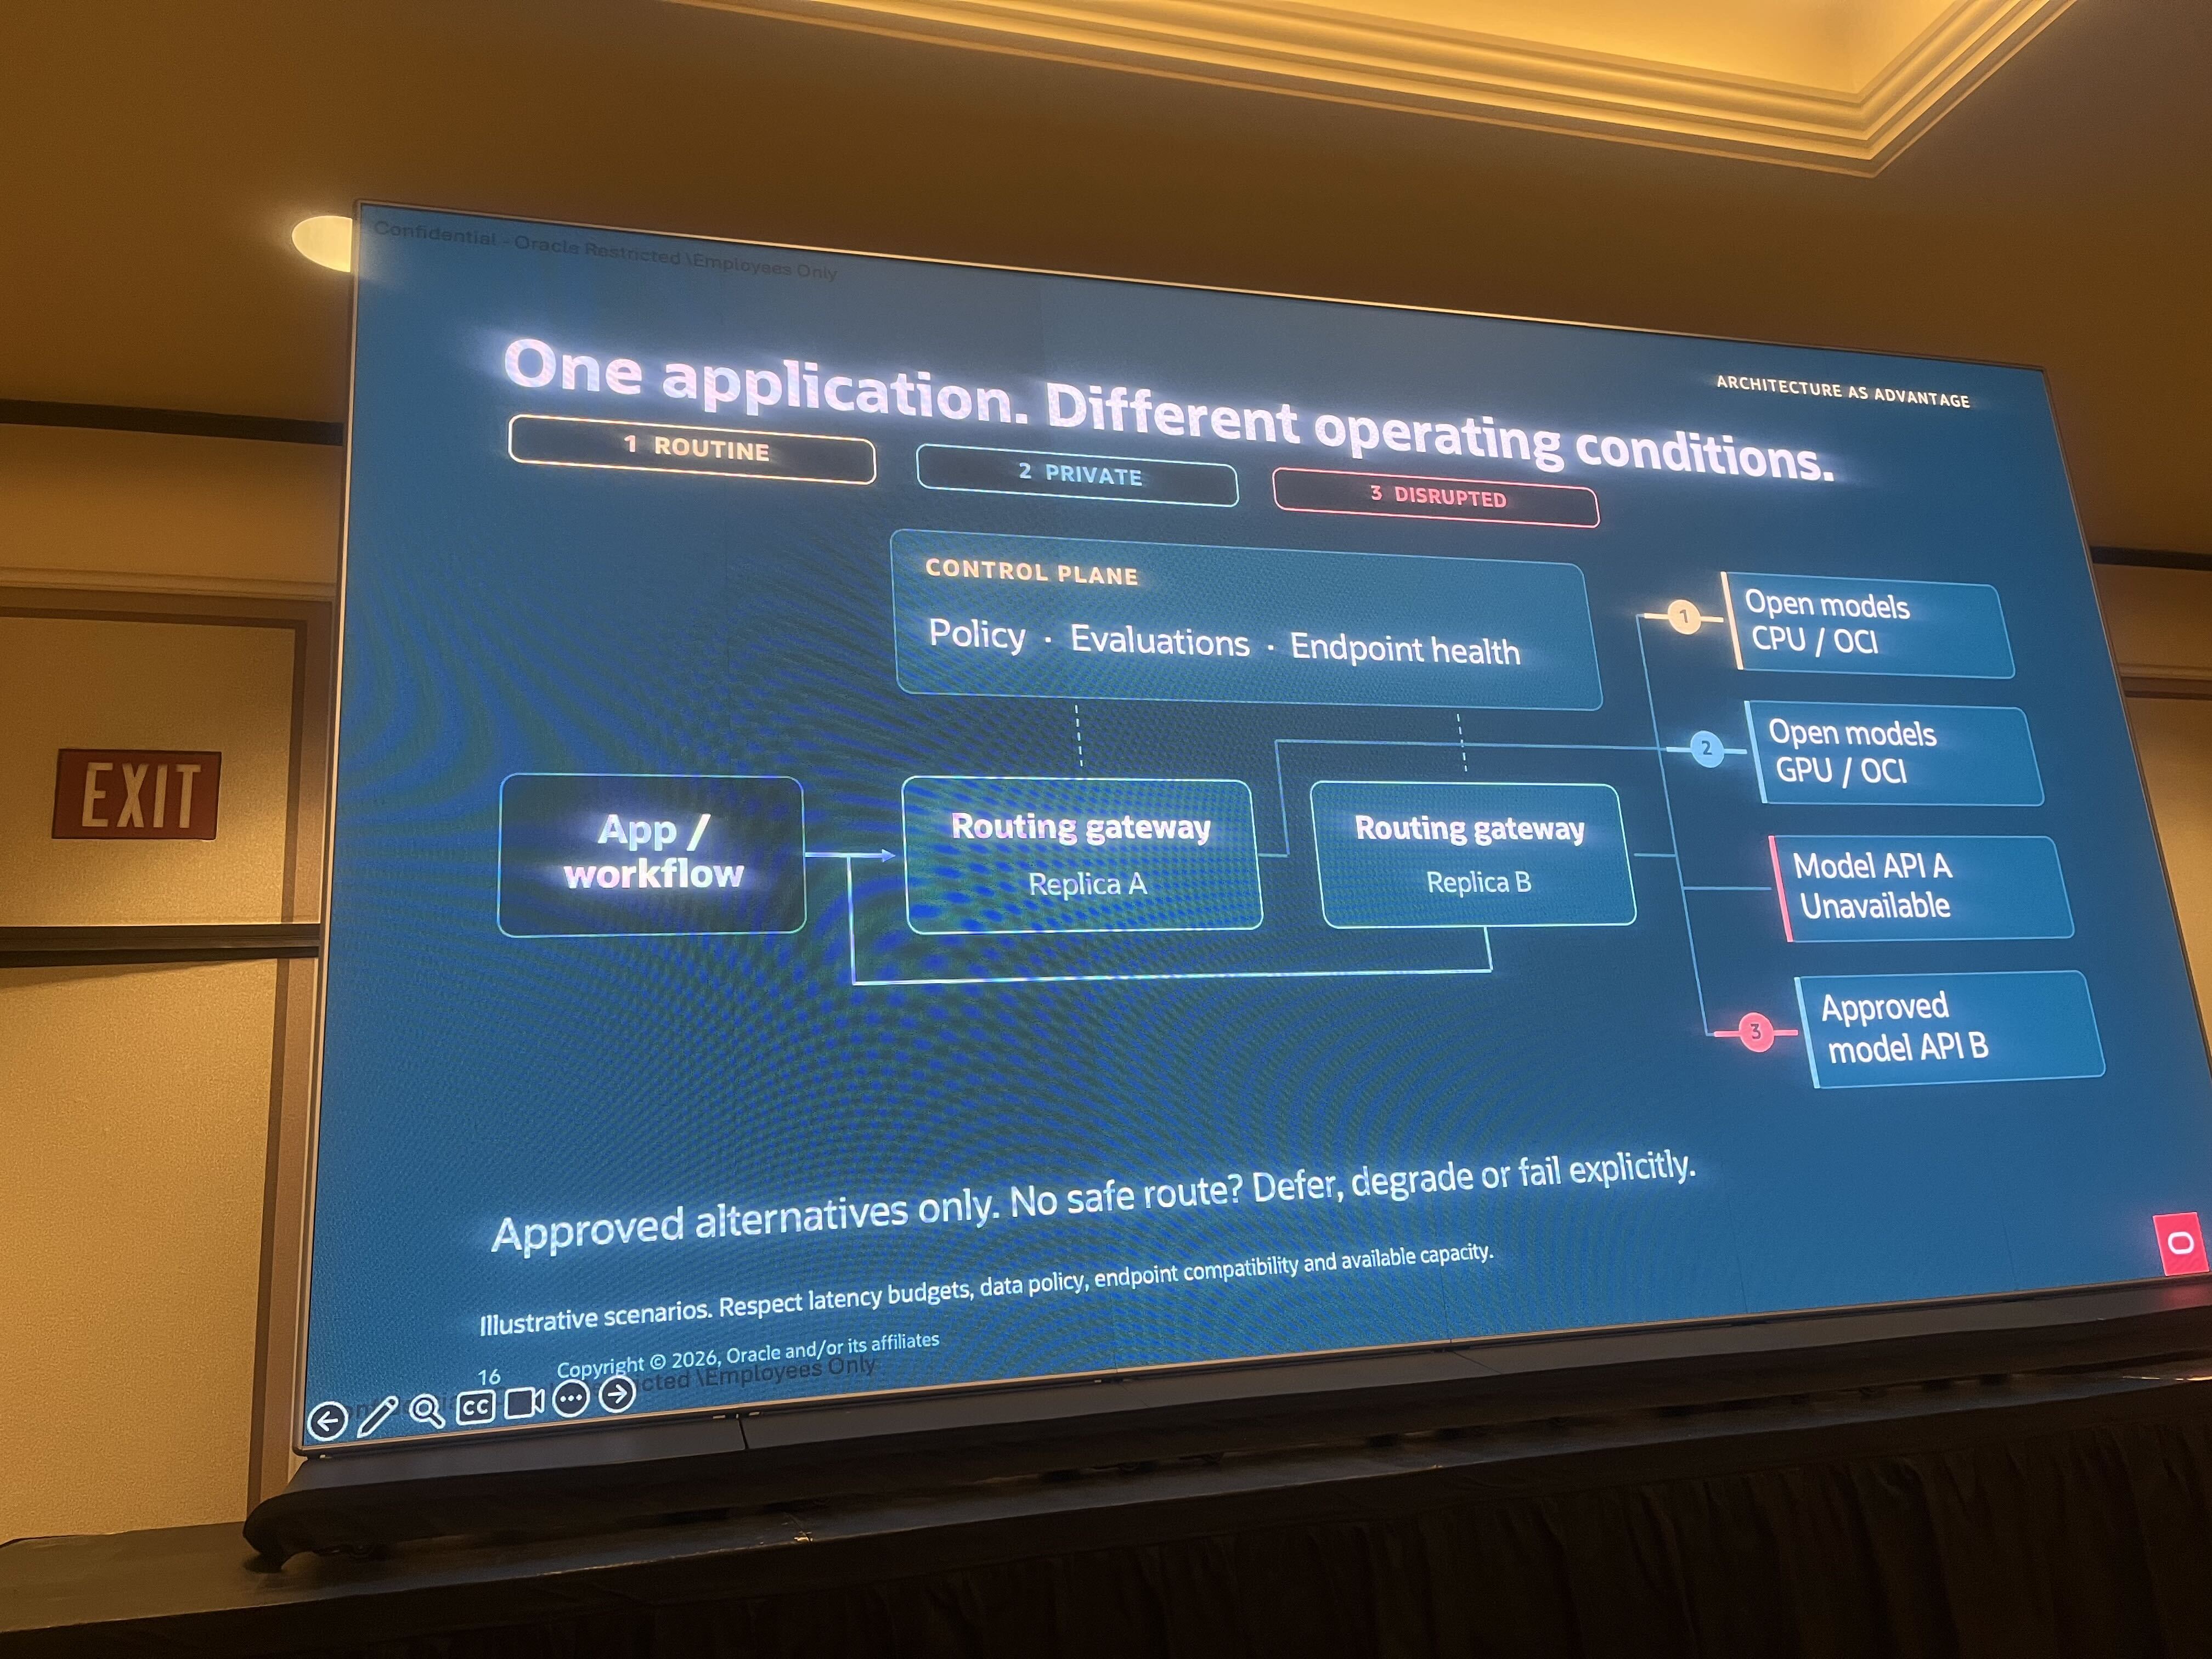
スライドでは、同じアプリが、3 つの状況で違う道を通ります。
-
ROUTINE(いつも通り):CPU 上のオープンモデル(OCI)
-
PRIVATE(情報の扱いに制約がある場合):GPU 上のオープンモデル(OCI)
-
DISRUPTED(障害時):Model API A が使えない → 承認済みの Model API B へ
-
-
最後に「Approved alternatives only. No safe route? Defer, degrade or fail explicitly.」とあります。「承認済みの代わりの道だけを使う。安全な道がなければ、先送りする、機能を落とす、はっきり失敗させる、のどれかにする」という意味です。承認していない道に、勝手に流してはいけません。
作り方のイメージ
アプリは「モデル」ではなく「要件」を伝える
-
もう 1 枚、スライドを紹介します。タイトルは「Ask for a capability – not a model」でした。アプリは、どのモデルを使うかではなく、「どんな品質で、何秒以内に、どこにデータを置いてよいか、予算はいくらか」という要件を伝えます。どのモデルで、どの計算資源で、どこで動かすかは、基盤の側が選びます。
-
「The application defines the requirement. The platform selects execution.(アプリは要件を決め、基盤が実行先を選ぶ)」という分担です。
構成例
-
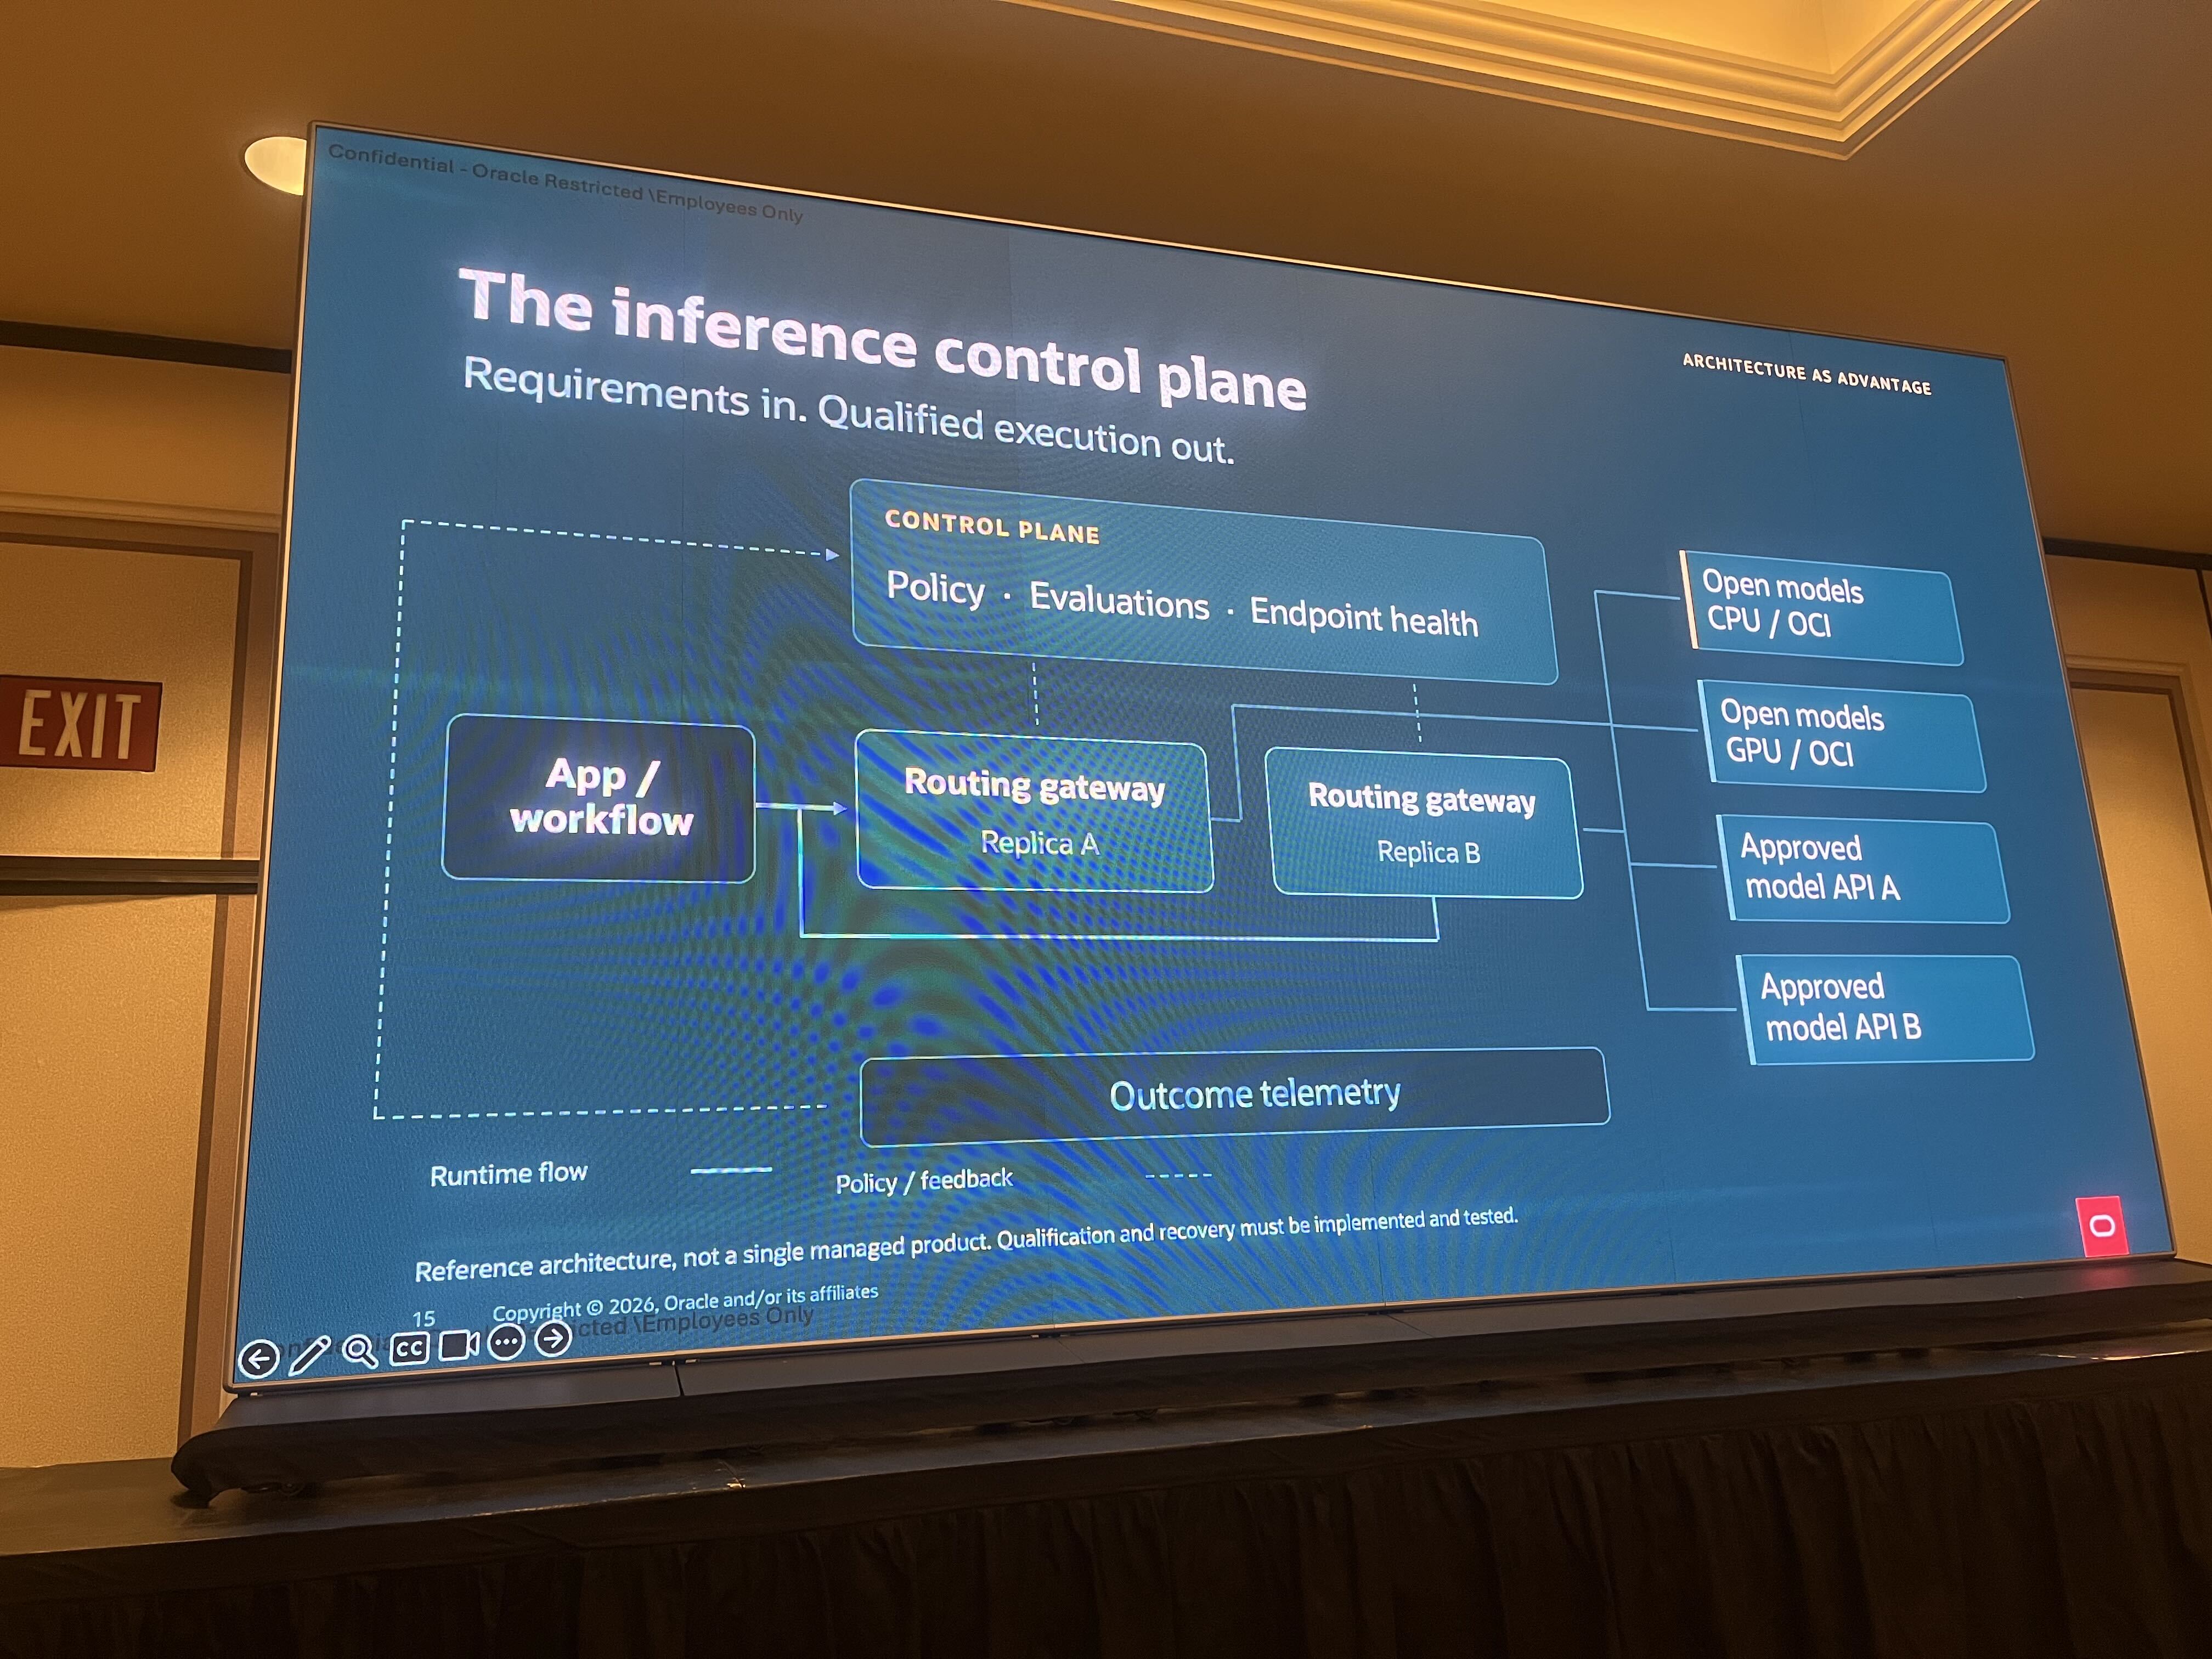
構成例の中身は、次の通りです。
- アプリの前に、依頼を受けて振り分ける窓口(Routing gateway)を置く。2 台(Replica A / B)構成にしておく。
- 振り分けのルールや、評価の結果、各行き先の稼働状況を管理する司令塔(Control plane)が、窓口に指示を出す。
- 窓口の先に、CPU・GPU 上のオープンモデルや、承認済みの API が並ぶ。
- 結果を測った記録(Outcome telemetry)が、ルールの見直しに戻される。
-
スライド下の注記が大事です。「Reference architecture, not a single managed product. Qualification and recovery must be implemented and tested.」。これは参考構成であって、そのまま使える 1 つのサービスではありません。条件を満たすかの確認や、障害時の復旧の仕組みは、自分たちで作って、テストする必要があります。
なぜ OCI なのか
-
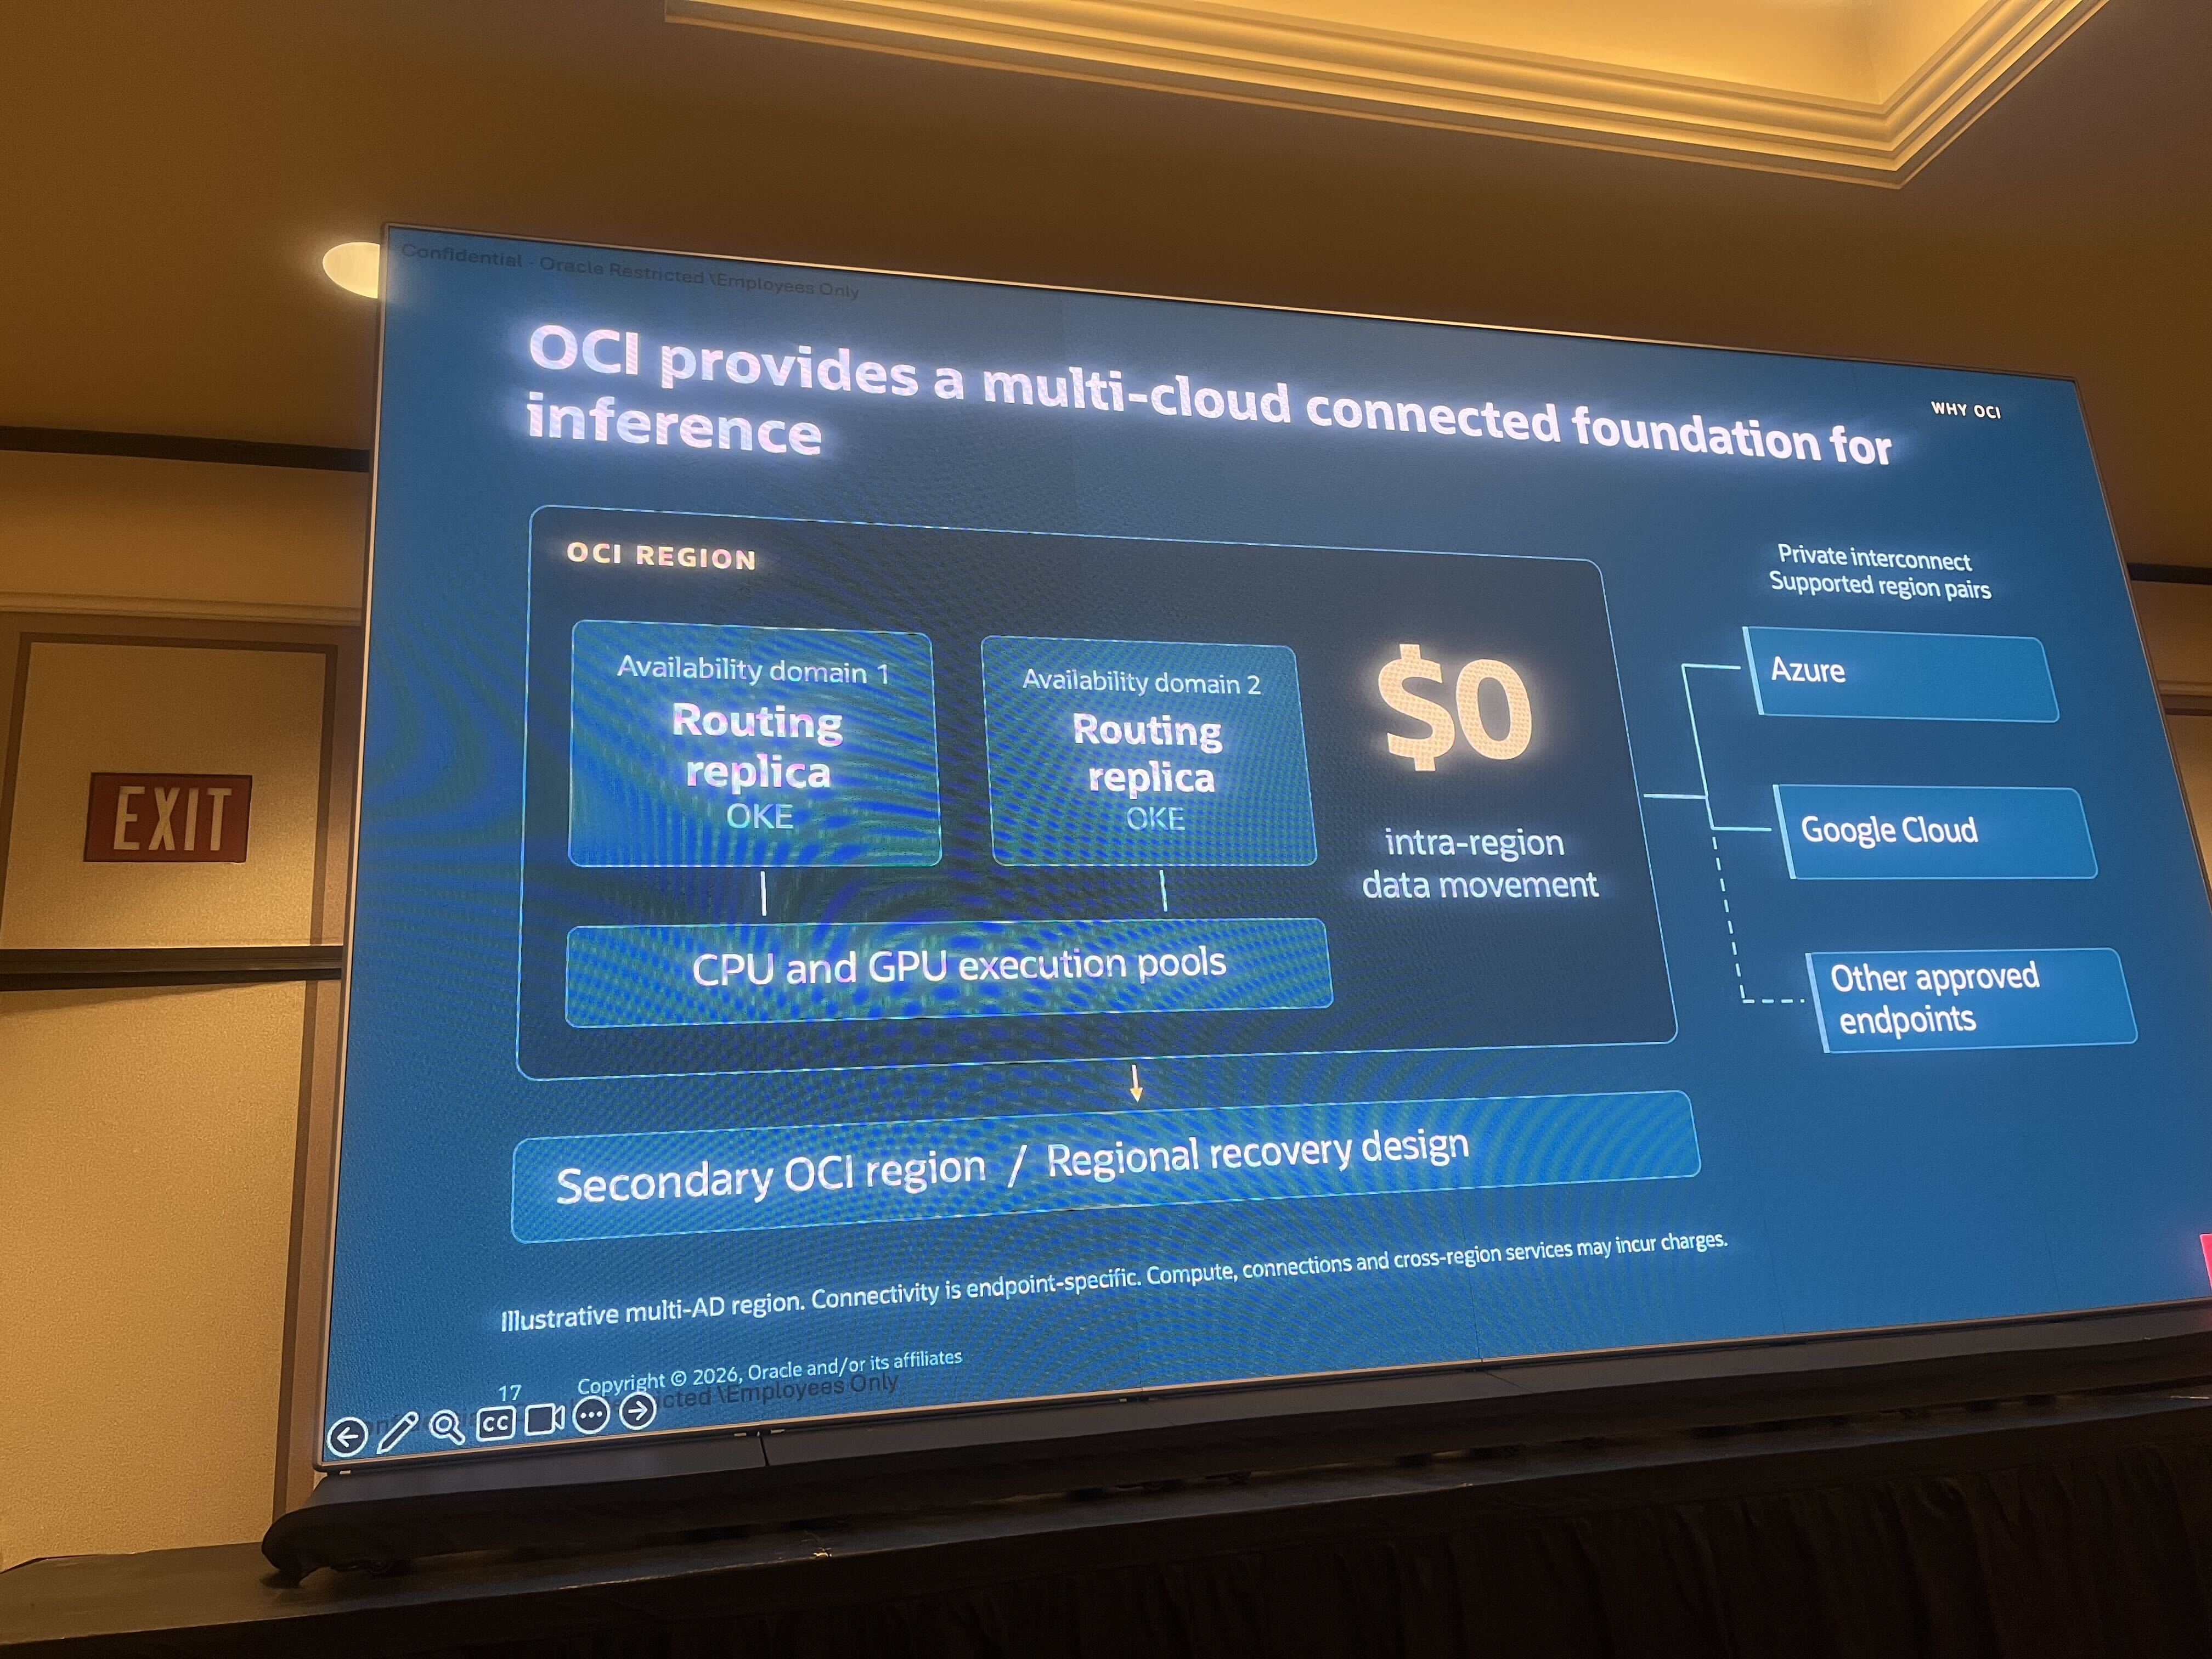
OCI の強みとして、スライドでは次の 3 点が示されました。
- 同じリージョン内のデータ移動は $0
- Azure や Google Cloud などとのプライベート接続(対応するリージョンの組み合わせに限ります)
- 別のリージョンを使った復旧の設計
-
ただし注記に「Connectivity is endpoint-specific. Compute, connections and cross-region services may incur charges.」とあります。無料なのは同じリージョン内のデータ移動で、計算資源や接続、リージョンをまたぐサービスは、課金されることがあります。
このセッションを、どう理解すればよいか
- ここまでの話を、立場ごとにかみくだいてみます。
一言でいうと
- AI を使うときは、「どのモデルが最高か」を一度決めて終わり、という選び方をやめて、「目標を満たす中で、いちばん安い道を、状況に応じて選び直せる仕組み」を作りましょう、という話でした。
AI を使う側(利用者・企業の担当者)の見方
- 見るべき数字は、トークンの単価ではなく、成功した成果 1 件あたりの費用です。
- 失敗ややり直しも費用に入ります。安いモデルでも、やり直しが増えれば高くつきます。
- 「GPU か CPU か」は、手段の話です。まず、守りたい目標(品質・応答時間・データの扱い・予算)を決めることが先です。
作る側(エンジニア)の見方
- モデルは、アプリの中に直接埋め込まず、要件を渡して、基盤が実行先を選ぶ形にしておきます。
- 同じ依頼には答えを使い回す、参考情報を減らす、やり直しを防ぐなど、モデルを呼ぶ前後の工夫のほうが効くことがあります。
- CPU の道も、品質と応答時間を測って、使えるか確かめておきます。使えるなら、選べる道が増えます。
- 代わりの道(フォールバック)は、作るだけでなく、障害を想定してテストしておきます。
まとめ
-
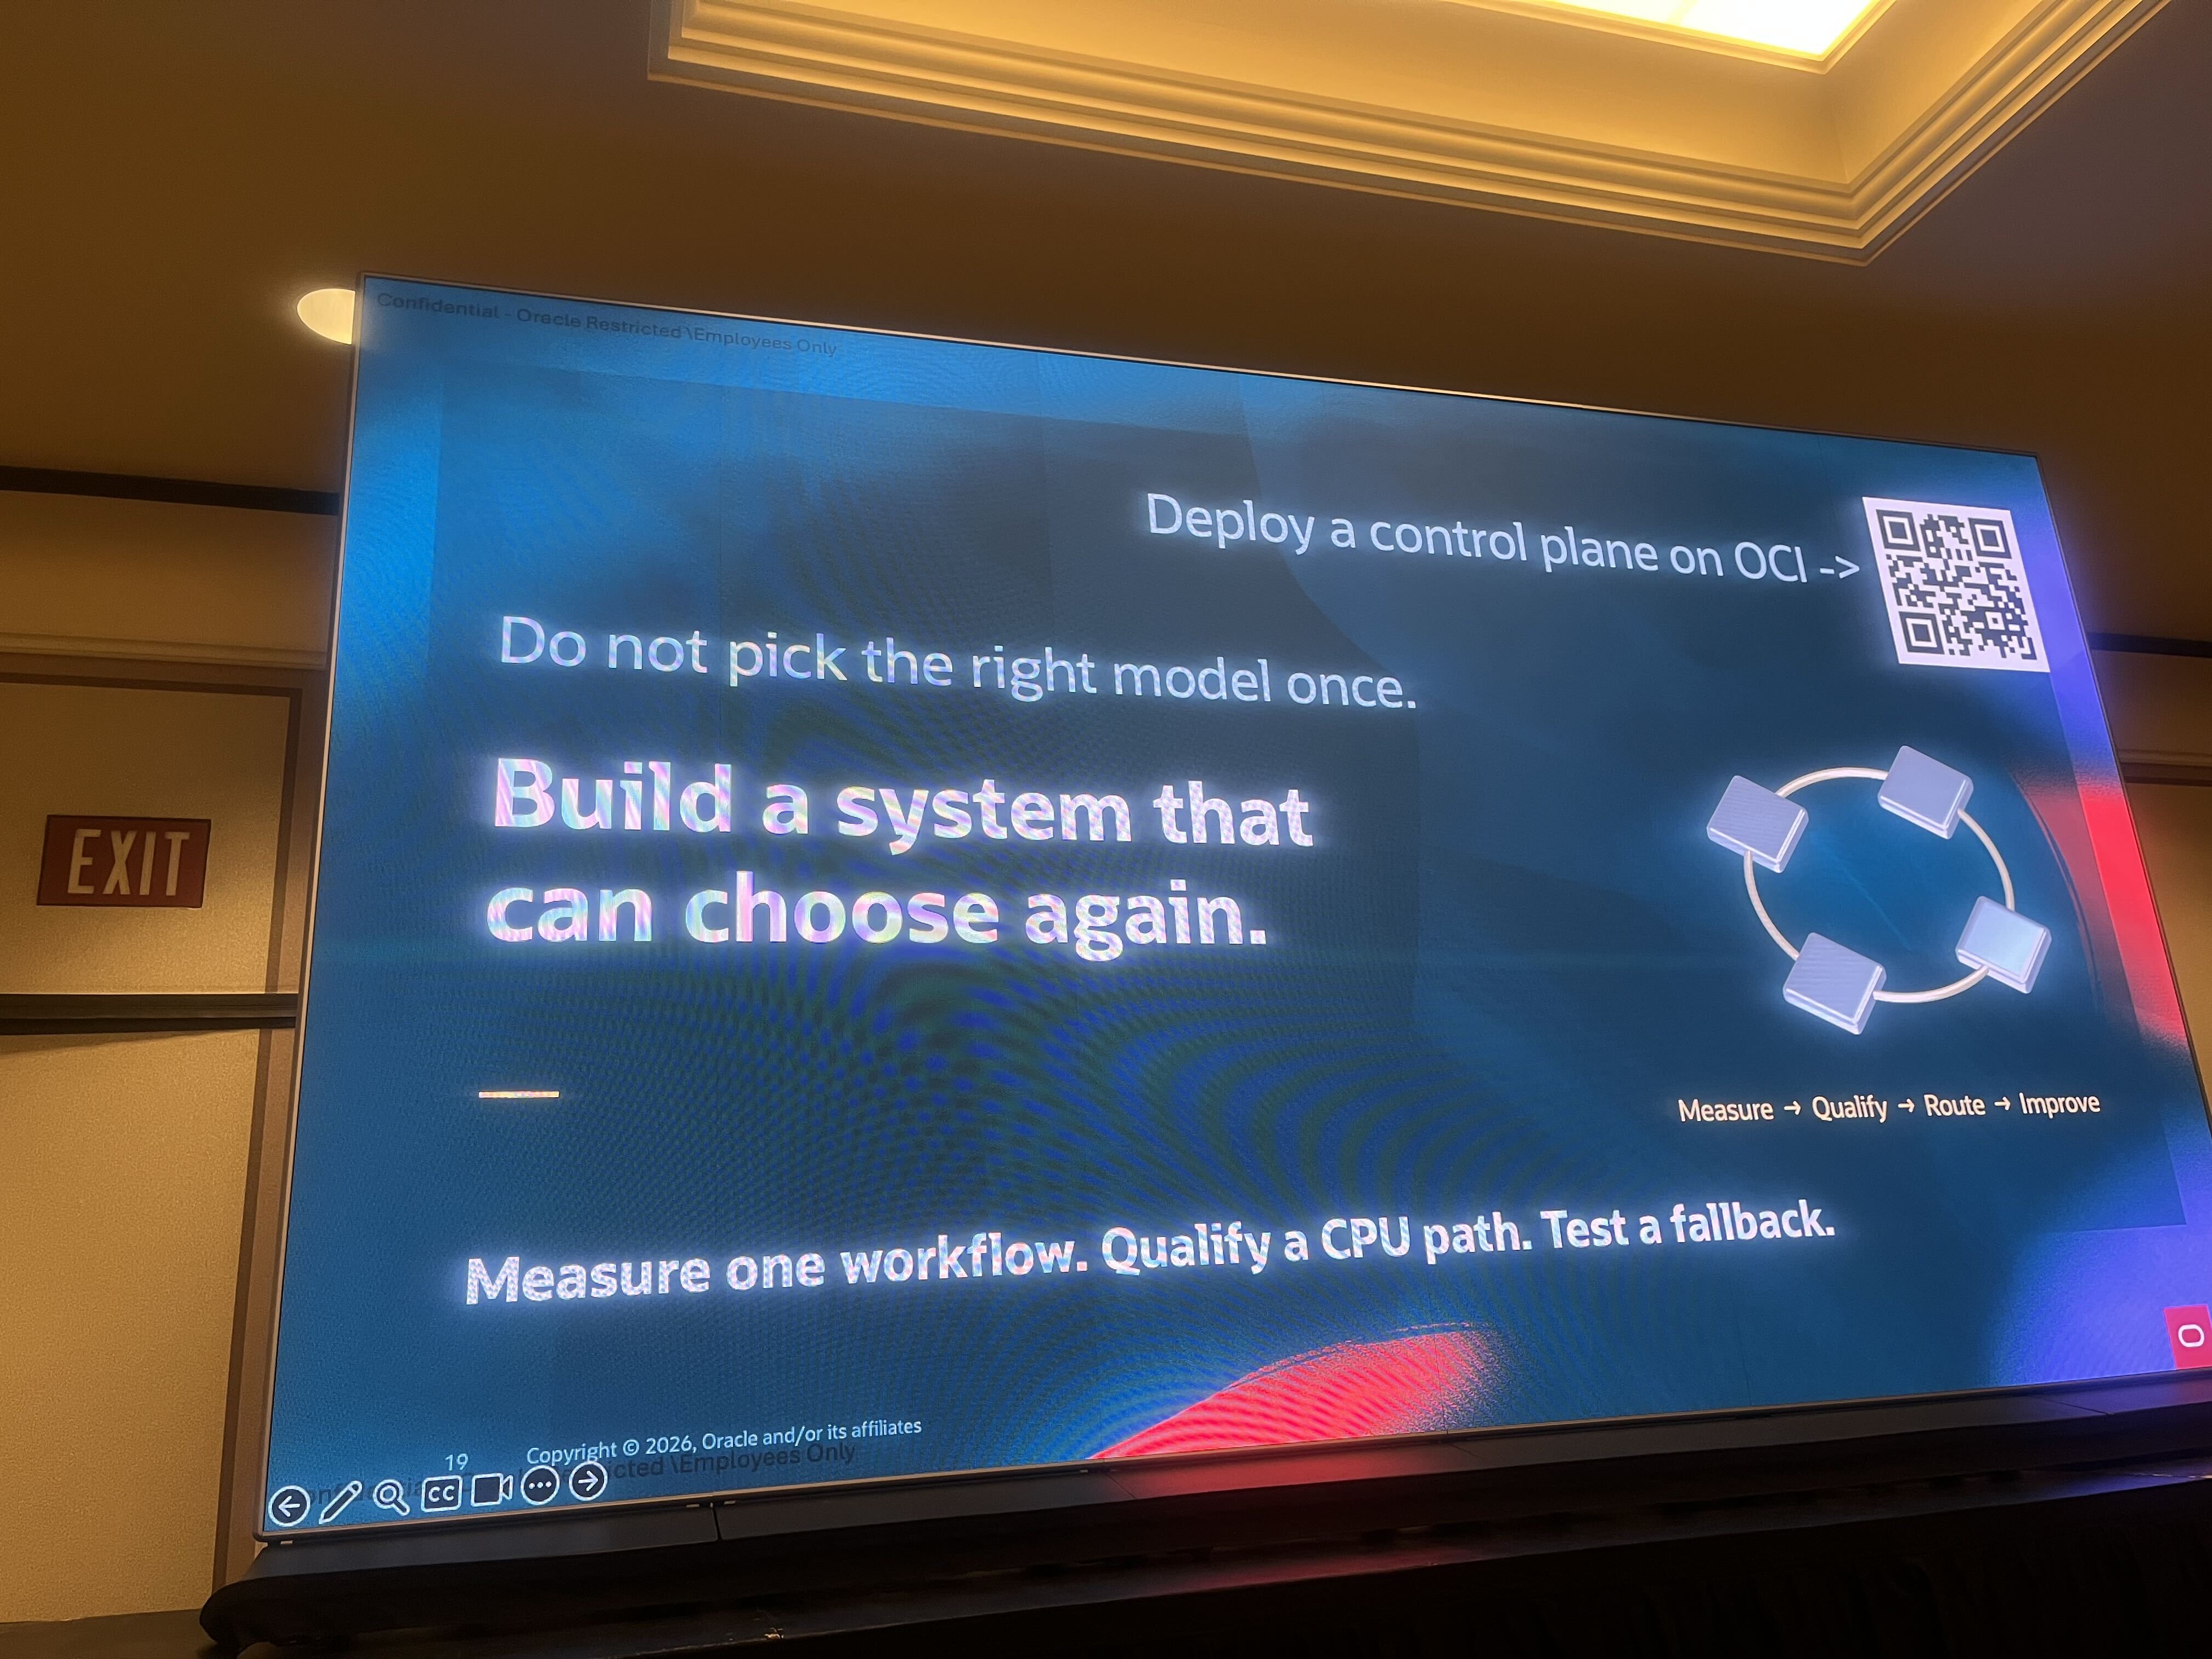
最後のスライドは「Do not pick the right model once. Build a system that can choose again.(正しいモデルを、一度だけ選ばない。選び直せるシステムを作る)」。「測る → 条件を満たすか確かめる → 振り分ける → 改善する」を回し続ける、というイメージです。
-
今回のセッションで学んだことを、3 点にまとめます。
- 成果あたりで考える:トークンの単価ではなく、失敗ややり直しも含めた、成功した成果 1 件あたりのコストで見る。
- 仕事ごとに実行先を選ぶ:品質・待ち時間・データの扱い・予算を満たす、もっとも安い道を選ぶ。CPU は有力な選択肢の一つ。
- 選び直せる設計にする:コストの最適化と障害への備えは、同じ設計から生まれる。
-
このスライドの下には、小さな第一歩として、「Measure one workflow. Qualify a CPU path. Test a fallback.(まず 1 つの仕事を測る。CPU の道が使えるか確かめる。代わりの道を試す)」が示されていました。
おわりに
-
「GPU なしで AI」というセッション名から、CPU で AI を動かす技術の話だと思って参加しました。でも実際に聞いてみると、中心は「AI を事業として成り立たせるには、何を測り、どう設計するか」でした。
-
AI を使い始める段階では、モデルの性能や単価に目が行きがちです。でも運用が始まると、やり直しやデータ移動、障害時の備えまで含めた「1 件あたりのコスト」が効いてきます。
-
AI を使うからといって、ベストプラクティスに沿ってサービスを選び、構成を組めば、自動で最適な結果が得られるわけではありません。開発したシステムに応じて、測定して結果を見て、設計し、改善していく必要があると学びました。仕事の仕方は大きく変わらず、すべてを任せきりにせず、鵜呑みにせず、きちんと自分の目で見て確かめる必要があるわけです。
-
CPU を「GPU の代わり」ではなく「条件が合えば使える選択肢」と位置付けていた点も、現実的で参考になりました。まずは 1 つの仕事を測るところから、試してみたいと思います。
 簡単30秒