


TL;DR
- Oracle Globally Distributed AI Database は、データを複数のデータベース(シャード)に分散しつつ、アプリケーションからは1つの論理データベースに見せる仕組みだ。Raft ベースのレプリケーションでは、3秒未満の自動フェイルオーバーとゼロデータロスをうたっている。
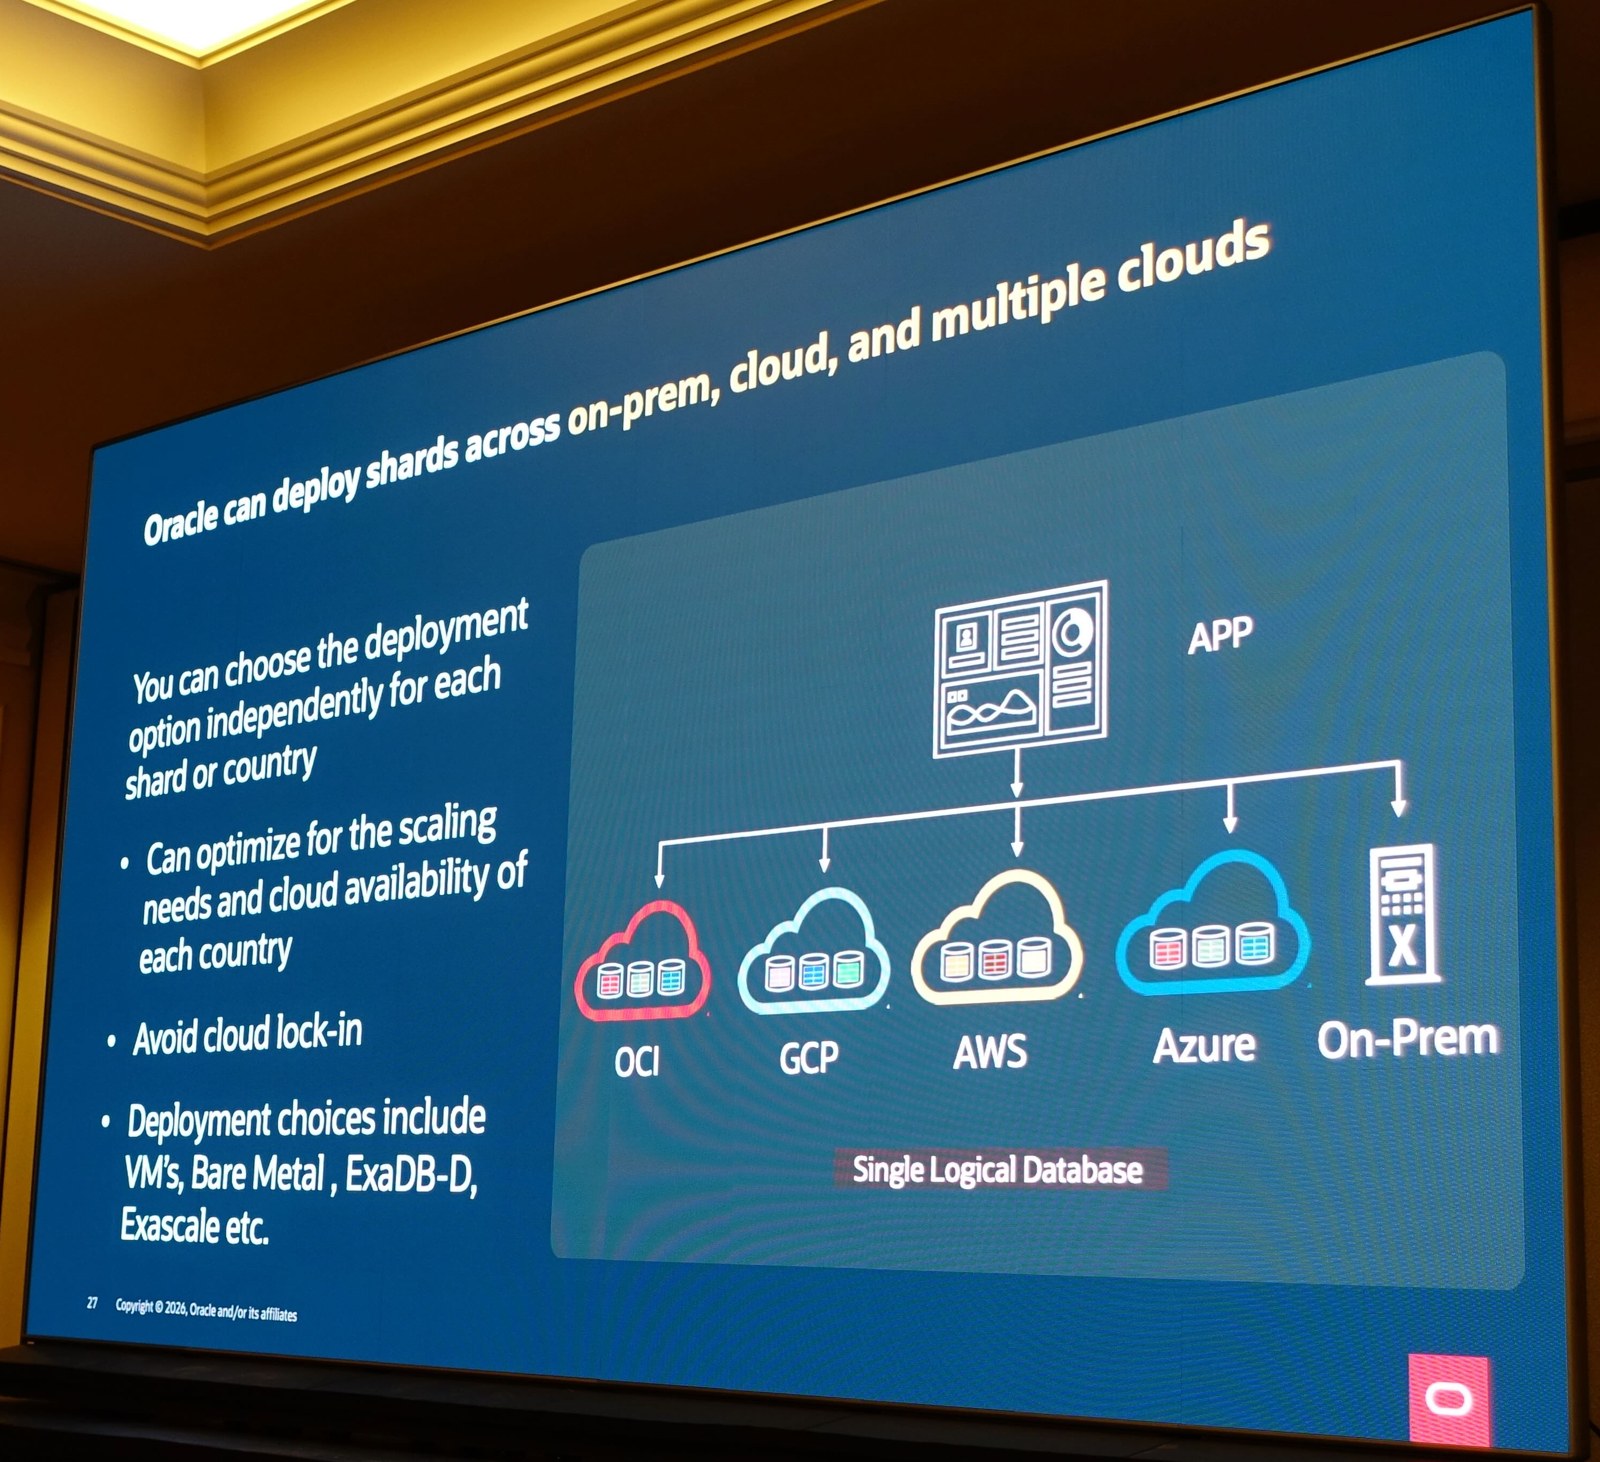
- シャードは Oracle Database が動く場所ならどこにでも置け、それに加えて OCI、Google Cloud、AWS、Azure といった複数のクラウドにまたがっても置ける。
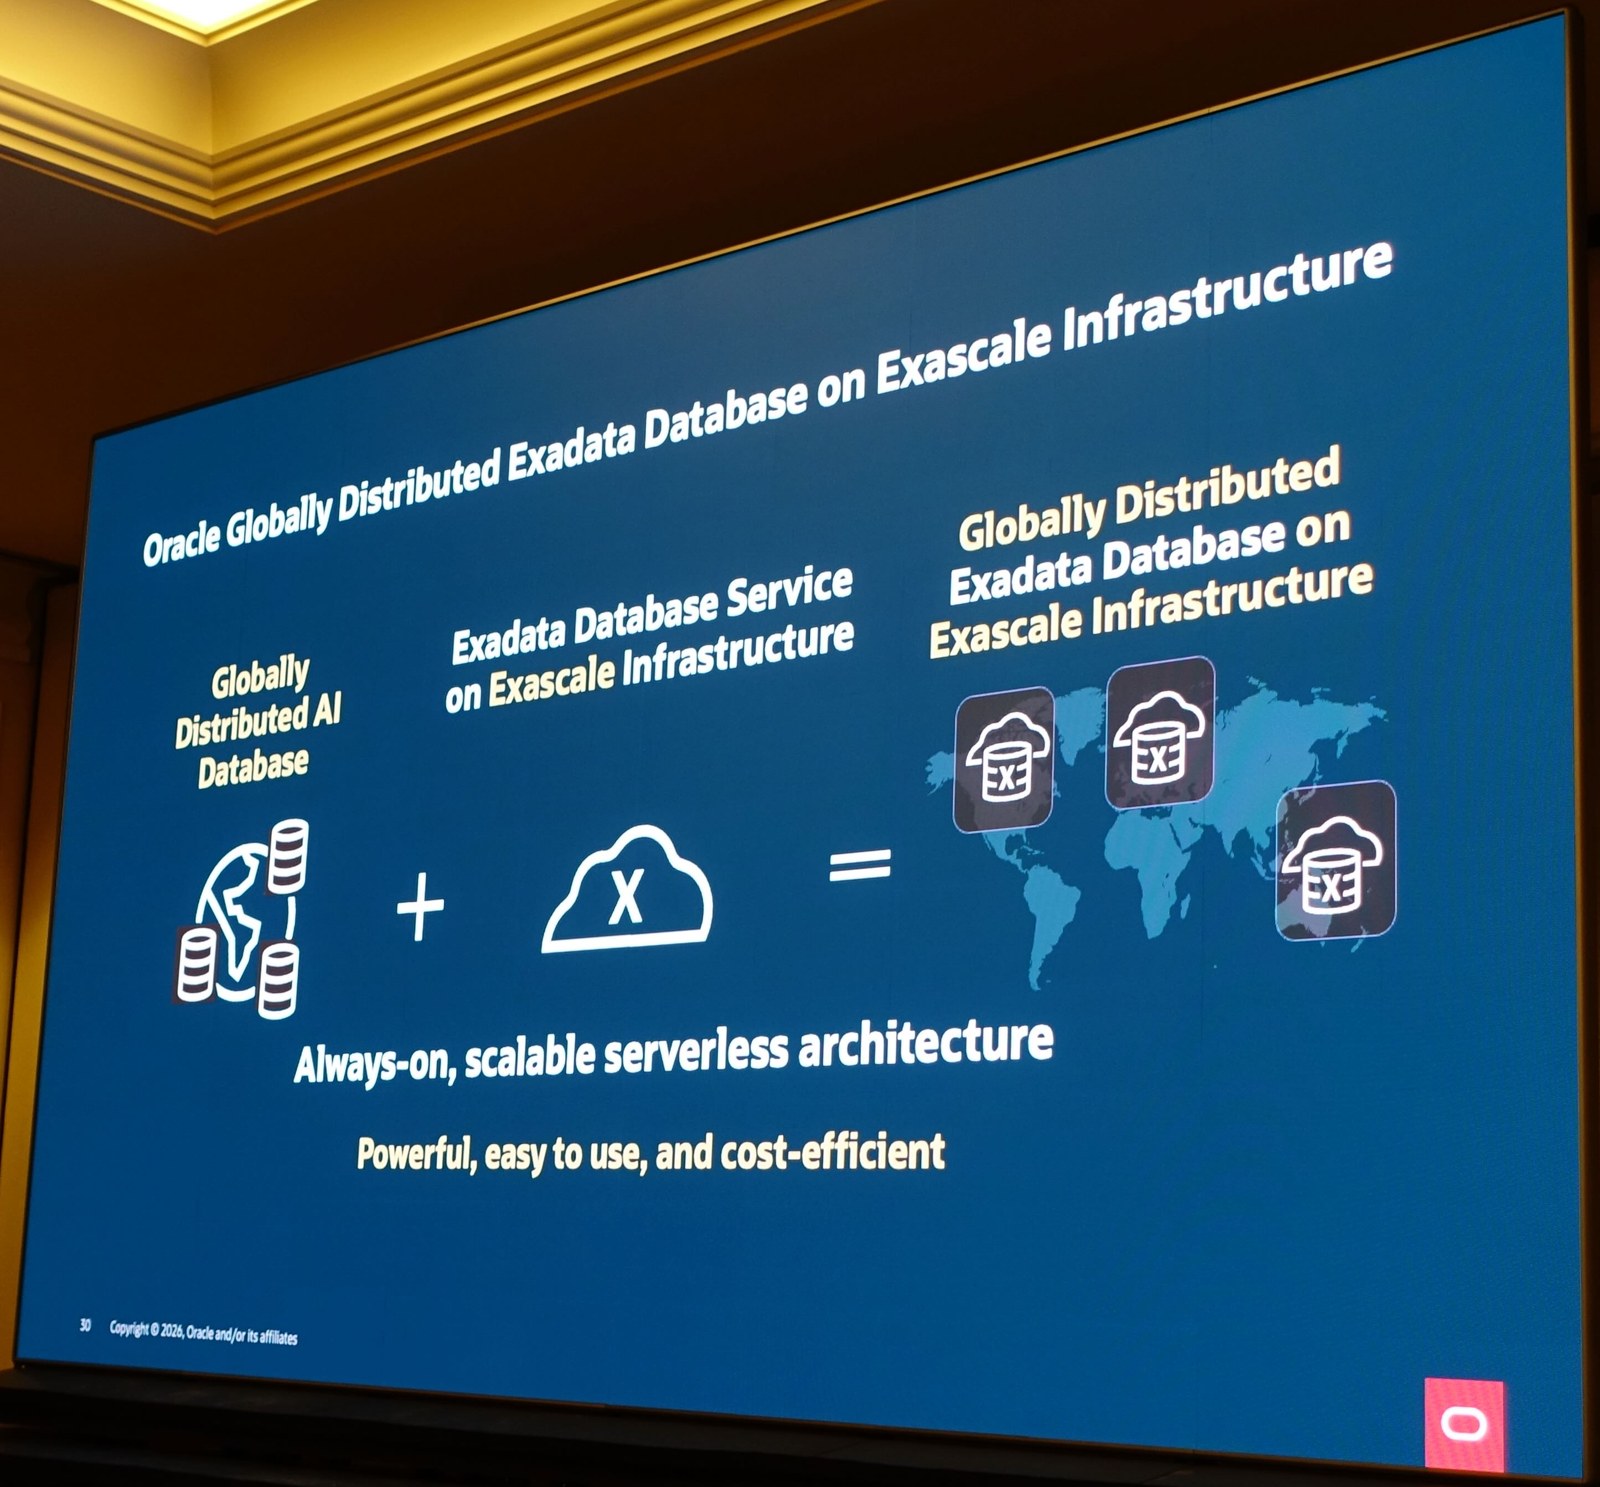
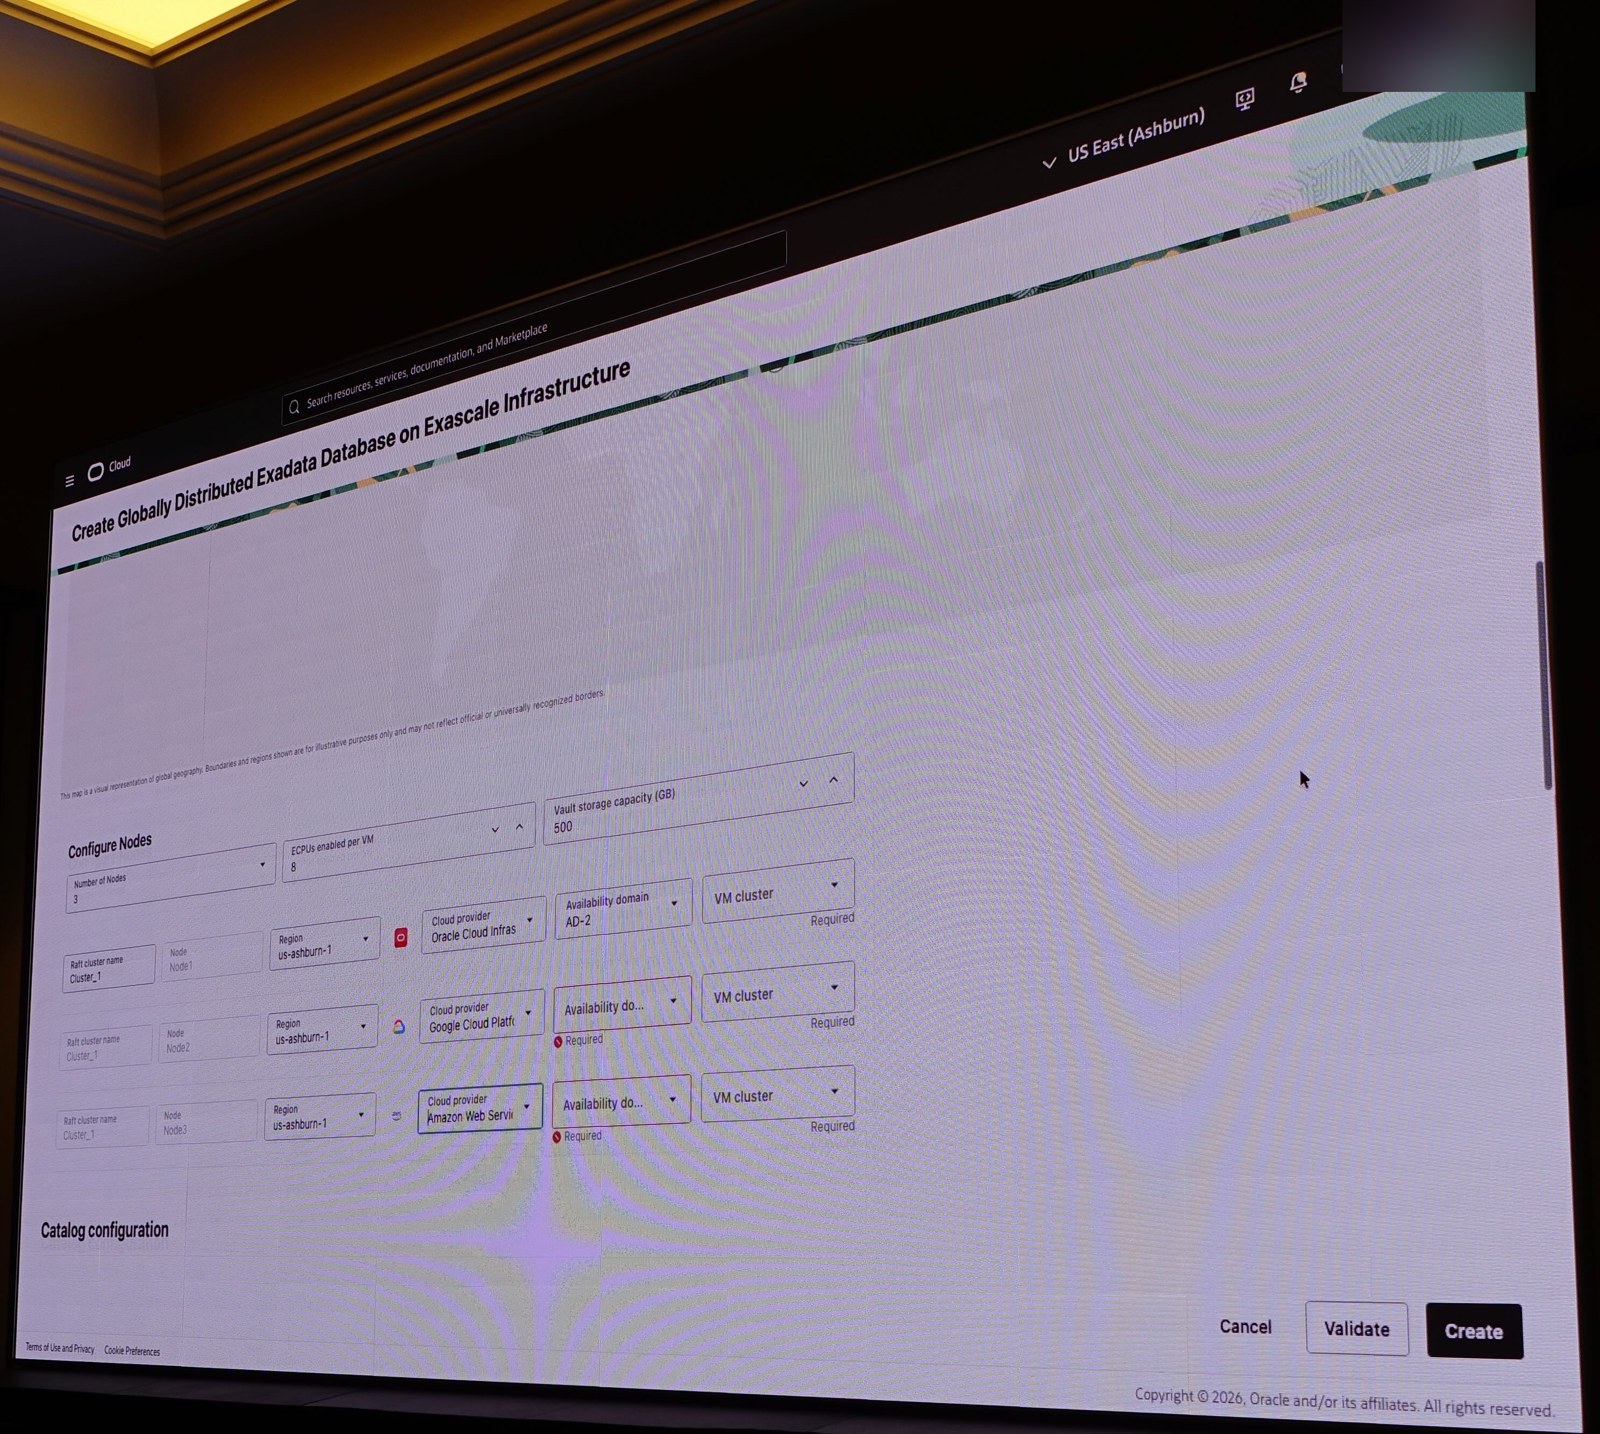
- OCI では、Exascale 上のクラウドサービス「Globally Distributed Exadata Database on Exascale Infrastructure」として紹介され、OCI コンソールでの作成画面がデモされた。作成画面には、ノードごとに Region と Cloud provider を選ぶ項目があった。
はじめに
OCI Top Partner Engineers 2026 の今井です。
今週は Oracle AI World 2026 に参加するため、ラスベガスに来ている。今回聴いたのが、セッション「LRN6009 – Build Multicloud AI Apps That Never Go Down with Globally Distributed Database」だ。Oracle の Shailesh Dwivedi 氏(GVP, Data Systems Engineering)と、PayPal の2名が登壇した。日時は 2026-10-26 11:30〜12:15(PDT)、会場は Galileo 1001 だった。
スライドにも「Oracle AI Database は 2017 年にネイティブのシャーディングをリリースして分散データベースになった」とある通り、Globally Distributed AI Database(以下 GDD)自体は新しい機能ではない。ただ私は、OCI と他クラウドのハイパースケーラーが加速したことで、GDD に新しい価値が出てくるのではないかと感じた。本記事では、GDD でできることと、Raft レプリケーション、複数クラウドにまたがる配置を中心にまとめる。
Globally Distributed AI Database とは?
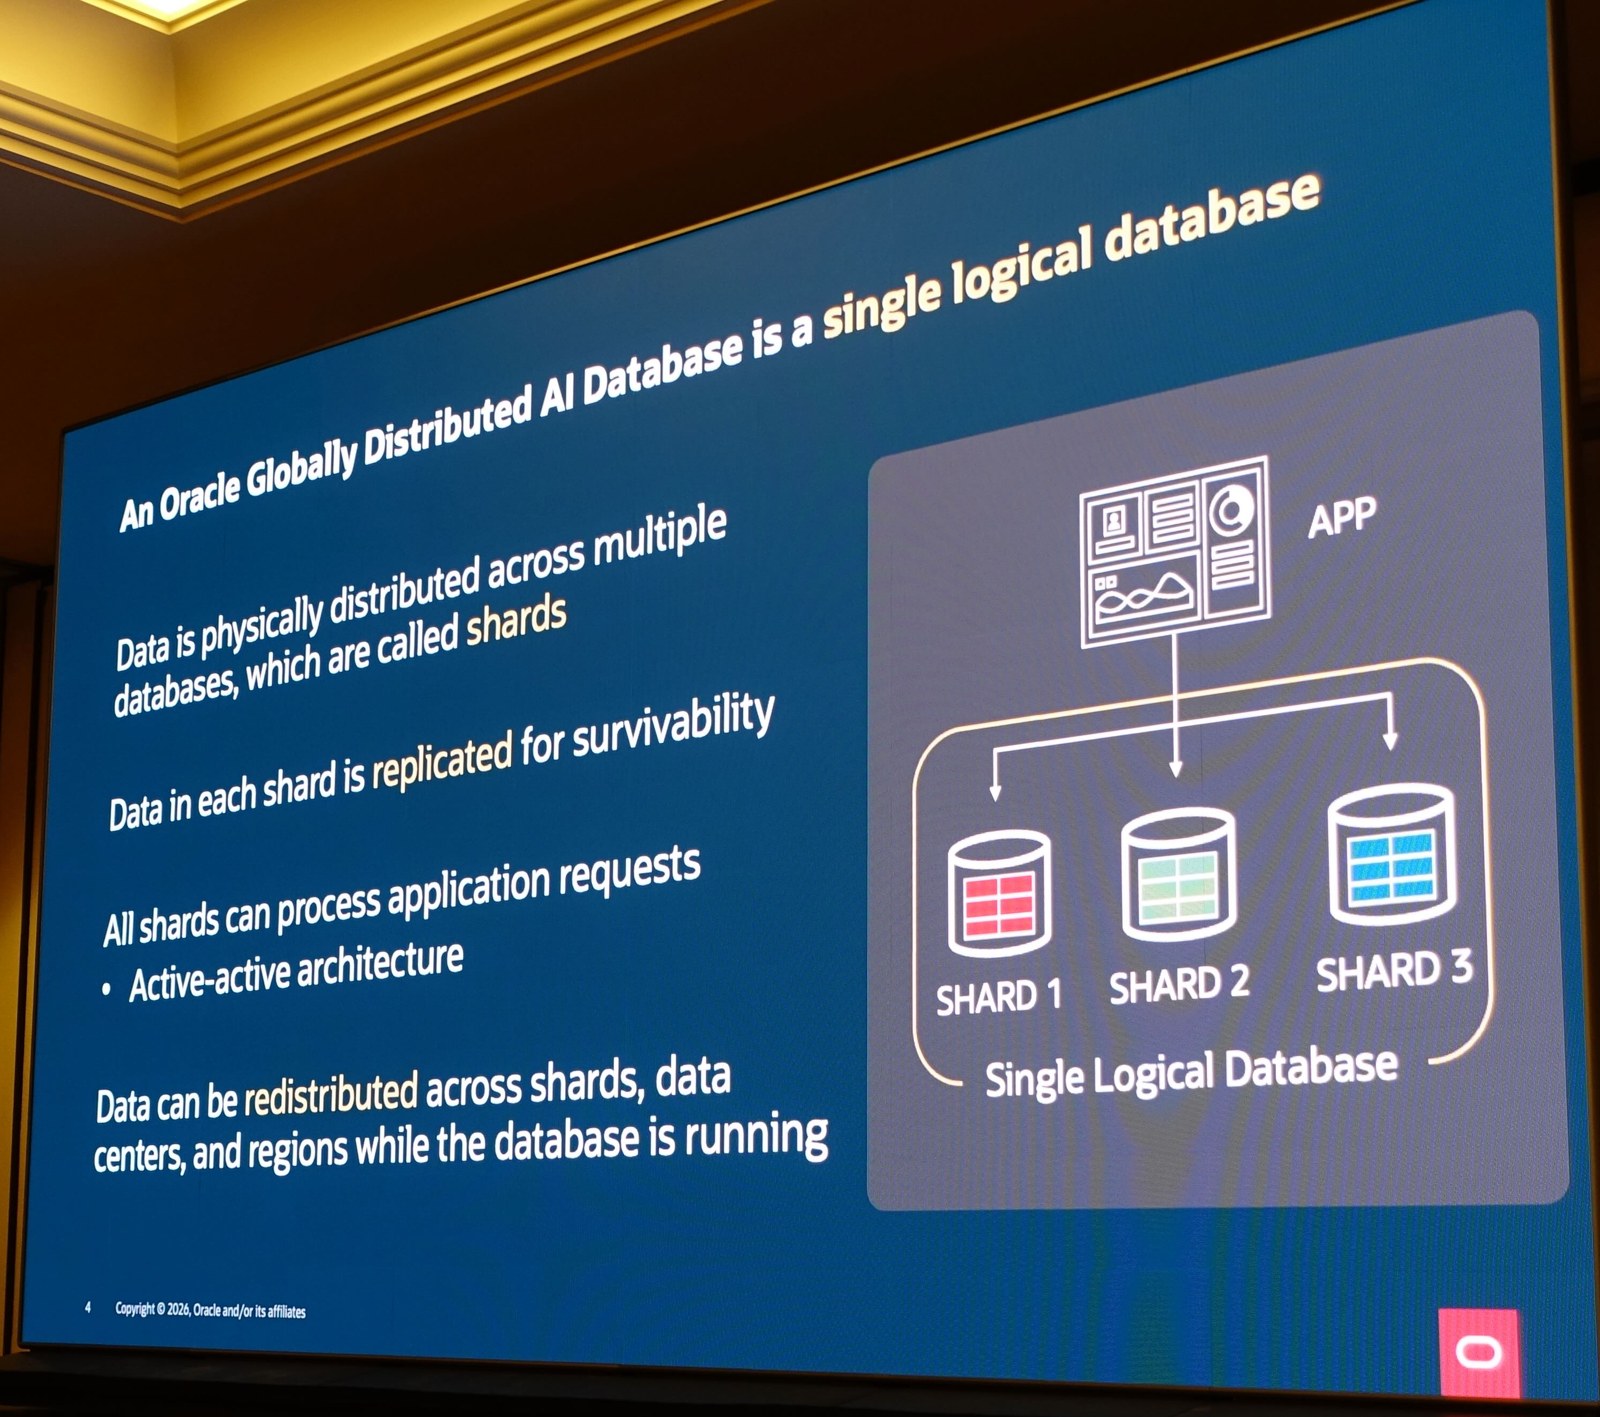
GDD では、データを物理的に複数のデータベースに分散して置く。この1つ1つをシャードと呼ぶ。各シャードのデータは複製され、どのシャードもアプリケーションのリクエストを処理する active-active の構成だ。
登壇者は、GDD は同じ Oracle Database を別のアーキテクチャで配置したものだと説明していた。アプリケーションからも運用からも単一の論理データベースに見え、リクエストはデータがあるノードへ自動で振り分けられる。
Globally Distributed AI Database でできること
| できること | 内容 |
|---|---|
| データを置く国を決める | US とインドにまたがる1つの分散データベースで、インドのデータはインドに、それ以外は US に置いた銀行の事例が紹介された |
| 止めずにシャードを増減する | シャードの追加・削除とデータの再配置はオンラインで、停止時間は発生しないとしている |
| 障害時に3秒未満で切り替える | Raft ベースのレプリケーションで、レプリカへの自動フェイルオーバーが3秒未満、ゼロデータロス |
| データのコピーを減らす | データを持たず Raft のログだけを持つ witness node を置ける |
| シャードごとにクラウドを選ぶ | Oracle Database が動く場所に加えて、OCI、Google Cloud、AWS、Azure といった複数のクラウドにまたがって、シャードごと・国ごとに配置先を選べる |
ここで重要なのは、銀行の事例でアプリケーション層をインドに作り直していない点だ。スライドには、複雑なアプリケーション層をインドに重複して配置する必要がなく、変更も最小限だったと書かれていた。登壇者は、規制の対象になるデータを持つテーブルだけをインドに置き、アプリケーションは US で動かし続けていると説明していた。
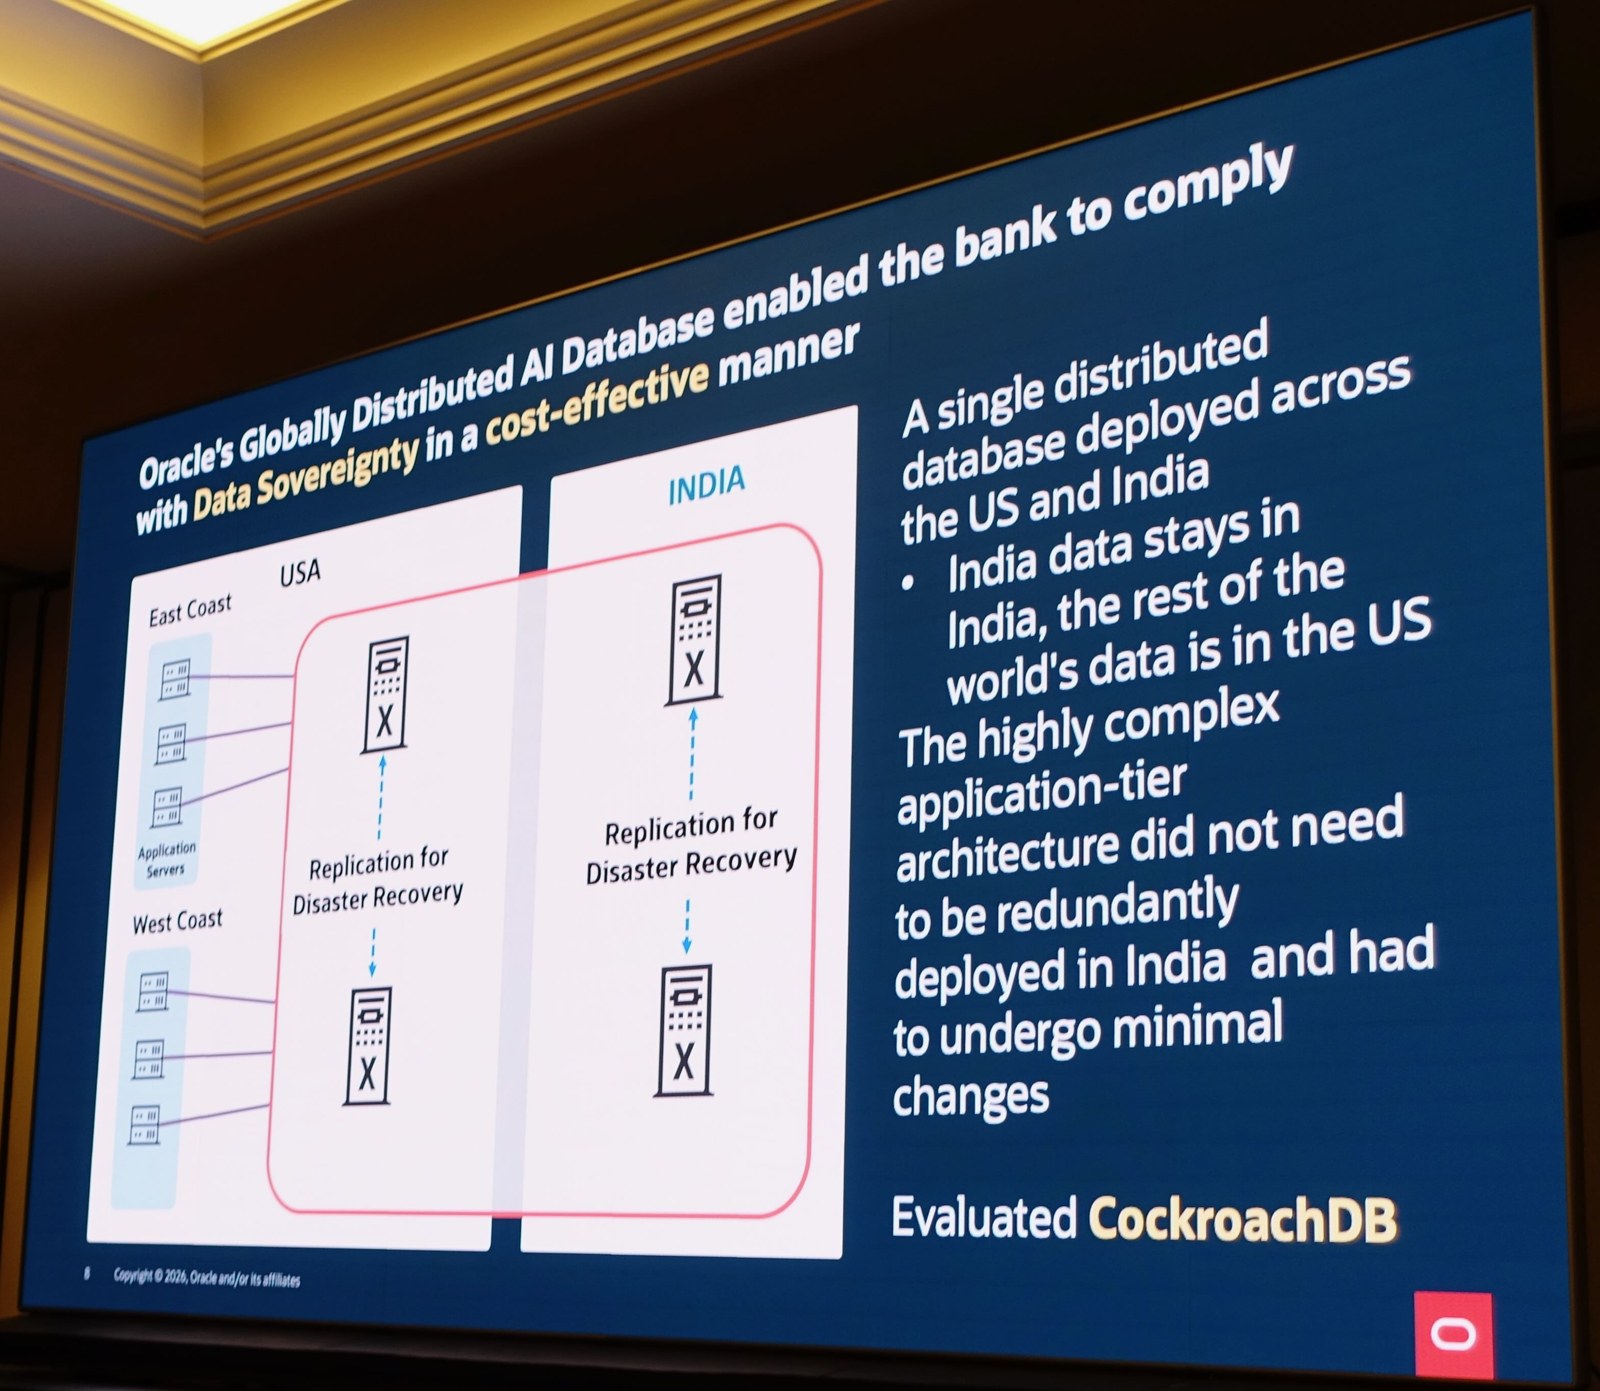
発表のポイント
1. Raft レプリケーションと witness node
Raft レプリケーションは、Raft のクォーラムに基づくレプリケーション方式だ。各シャードがデータの一部について書き込みと読み込みを受け付ける active-active の対称構成で、シャード間の同期レプリケーションによりゼロデータロスを実現するとしている。登壇者は、障害時はアプリケーションの振り分け直しまでを含めて3秒未満で終わると説明した。
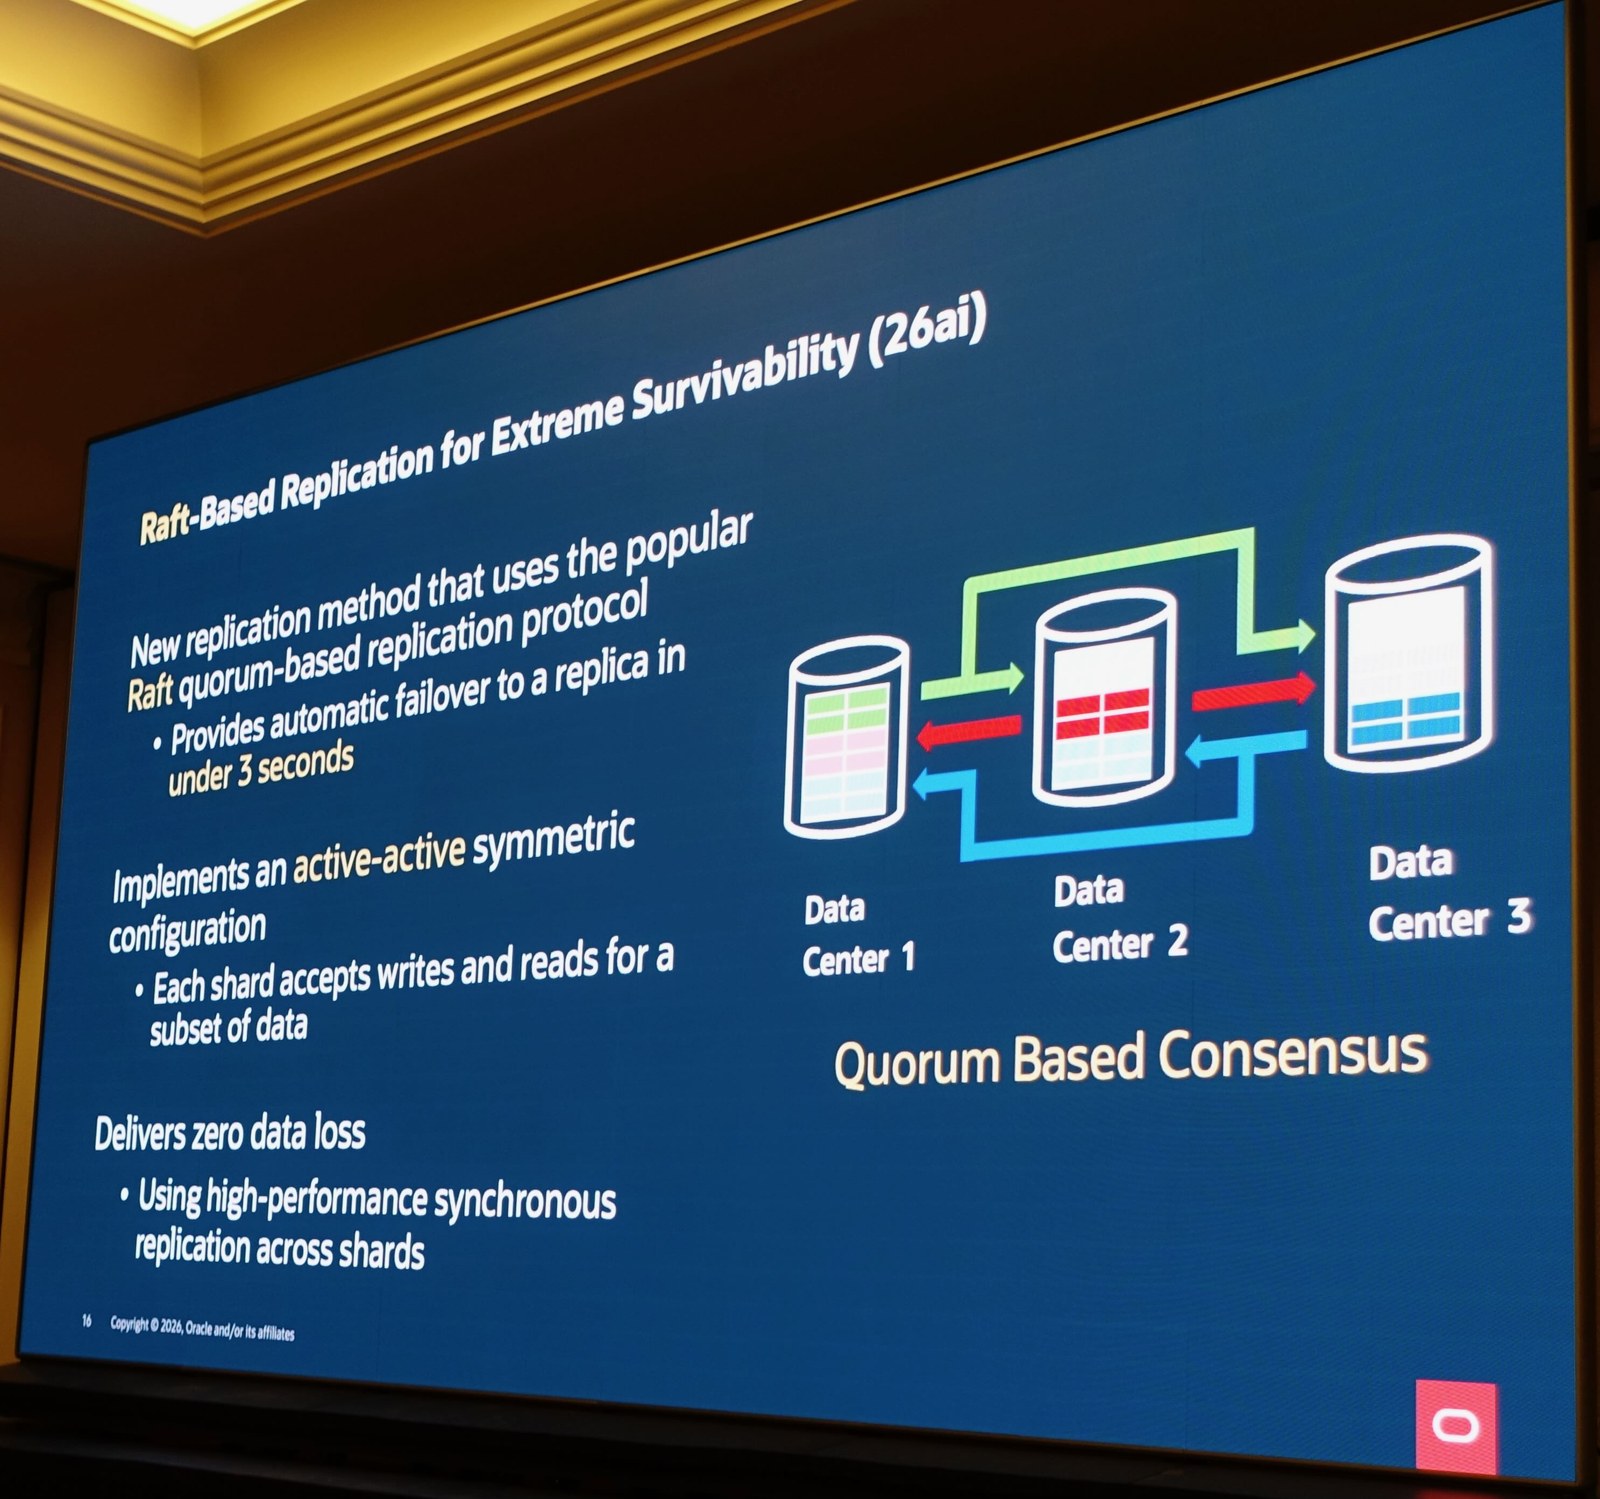
データを持たず Raft のログだけを持つ witness node も置ける。witness node を使うと、シャード間に保存するデータのコピーを減らせる。witness node は通常のフォロワーと同じくコミットのクォーラムに参加するため、フェイルオーバー時のゼロデータロスは保たれる。
2. 複数のクラウドにまたがる配置とクラウドサービス
登壇者によれば、この機能は Oracle Database のバイナリに組み込まれているため、Oracle Database を動かせる場所ならどこでも動く。それに加えて、シャードはオンプレミス、クラウド、複数のクラウドにまたがって置ける。スライドには、クラウドのロックインを避けられること、配置先として VM、Bare Metal、ExaDB-D、Exascale などがあることも書かれていた。
OCI のクラウドサービスとしては、GDD と Exadata Database Service on Exascale Infrastructure を組み合わせた「Globally Distributed Exadata Database on Exascale Infrastructure」が紹介された。スライドの表記は “Always-on, scalable serverless architecture” と “Powerful, easy to use, and cost-efficient” だ。
デモでは、OCI コンソールの「Create Globally Distributed Exadata Database on Exascale Infrastructure」の画面で、地図からロケーションを選んでいた。ノードの設定欄には、ノードごとに Region と Cloud provider を選ぶ項目があった。登壇者は、複数のクラウドにまたがって複製することで、クラウド単位の障害にも備えられると話していた。
セッションの後半は PayPal の登壇者に交代した。内容は本記事では扱わない。
最後の Key Takeaways では、Vector Search や Agentic Workloads にも対応すること、Exascale のサーバーレスなアーキテクチャでコストを抑えて伸縮できることが挙げられていた。
提供状況や、機能がどのバージョンから使えるかは、公式の情報を確認いただきたい。
ユースケースの考察
ワークロードは各クラウドの得意な場所に置き、データは1つにまとめる
複数のクラウドを使い分ける案件では、アプリケーションを作ったクラウドにデータベースも合わせることが多い。その結果、データがワークロードに引きずられ、別のクラウドの強みを使いたくなったときに、データの移行や同期が負担になる。GDD はシャードごとに配置先を選べるので、OCI ともう1つのハイパースケーラーにシャードを置き、それぞれのクラウドで動くアプリケーションの近くに、そのアプリケーションが主に使うデータを置く構成が考えられる。アプリケーションから見れば単一の論理データベースのままなので、ワークロードはクラウドごとの強みに合わせて選べる。前提として、どのデータをどのクラウドのシャードに置くかを決めるシャーディングキーの設計と、クラウド間のネットワーク遅延の見積もりが要る。クラウドサービスをどのクラウドで使えるかも、構成を決める前に確かめる必要がある。
 簡単30秒