


はじめに
- Oracle AI World 2026(ラスベガス)で、「Ask Your Data Anything: Connect with Google Cloud, Azure, AWS, and OpenAI [LRN2453]」を聴講しました。Gemini Enterprise、Amazon Quick、Microsoft Foundry、ChatGPT といった AI アシスタントから、Oracle AI Database のデータへ自然言語で問い合わせる仕組みをOracle、Google、AWS、Microsoft、OpenAI の 5 社がデモとともに紹介するセッションでした。
- 本記事では、セッションの流れに沿って次の内容を整理します。
- なぜ「AI アシスタントから Oracle データへ」が必要なのか
- Google Cloud(Gemini Enterprise)での実装とデモ
- AWS(Amazon Quick / Kiro)、Microsoft(Foundry / Copilot)、OpenAI(ChatGPT)との連携
- 共通する設計の考え方(ID・権限・データを複製しない)
- スライドの内容を基本とし、登壇者が口頭で補足した内容は「セッションでは」と明記しています。
用語をおさらい
- Oracle AI Database Agent:AI アシスタントから Oracle AI Database に自然言語で問い合わせるためのOracle 提供のエージェント。
- A2A(Agent2Agent):異なるプラットフォームのエージェント同士が内部のメモリやツールを共有せずに連携するためのプロトコル。
- A2UI:エージェントがフォームやカードなどのインタラクティブな画面を返すための仕組み。
- MCP(Model Context Protocol):AI アシスタントが外部のツールやデータにアクセスするための共通プロトコル。
- NL2SQL:自然言語の質問を SQL に変換すること。Oracle では Select AI がこの機能にあたります。
- Deep Data Security:Oracle AI Database の機能で、ユーザーの ID に応じて、行や列の単位でアクセスを制御します。
- Apache Iceberg:オブジェクトストレージ上の大規模なテーブルを扱うためのオープンなテーブル形式。
3 行まとめ
- 利用者が選ぶ AI アシスタント(Gemini、Quick、Foundry、ChatGPT)から同じ Oracle のデータへ聞けるようになっている。
- どのクラウドでもデータベースの ID と権限をそのまま使い、データはコピーしない設計になっている。
- 開発者は A2A や MCP でエージェントを拡張でき、更新系の操作は人の承認を挟む作りになっている。
なぜ「AI アシスタントから Oracle データへ」なのか
利用者がアシスタントを選び、開発者がデータにつなぐ
- セッションは、「ユーザーはアシスタントを選び、開発者は信頼できるデータにつながなければならない」という課題設定から始まりました。立場ごとの要望は次のように整理されていました。
- データオーナー:明示的な ID、範囲を絞ったアクセス、何が実行されたかの可視性
- 開発者:アプリケーションやワークフローをまたいで使える、再利用可能なデータアクセス部品
- ビジネスユーザー:普段使っているツールの中で、レポート作成の手間を減らして答えを得ること
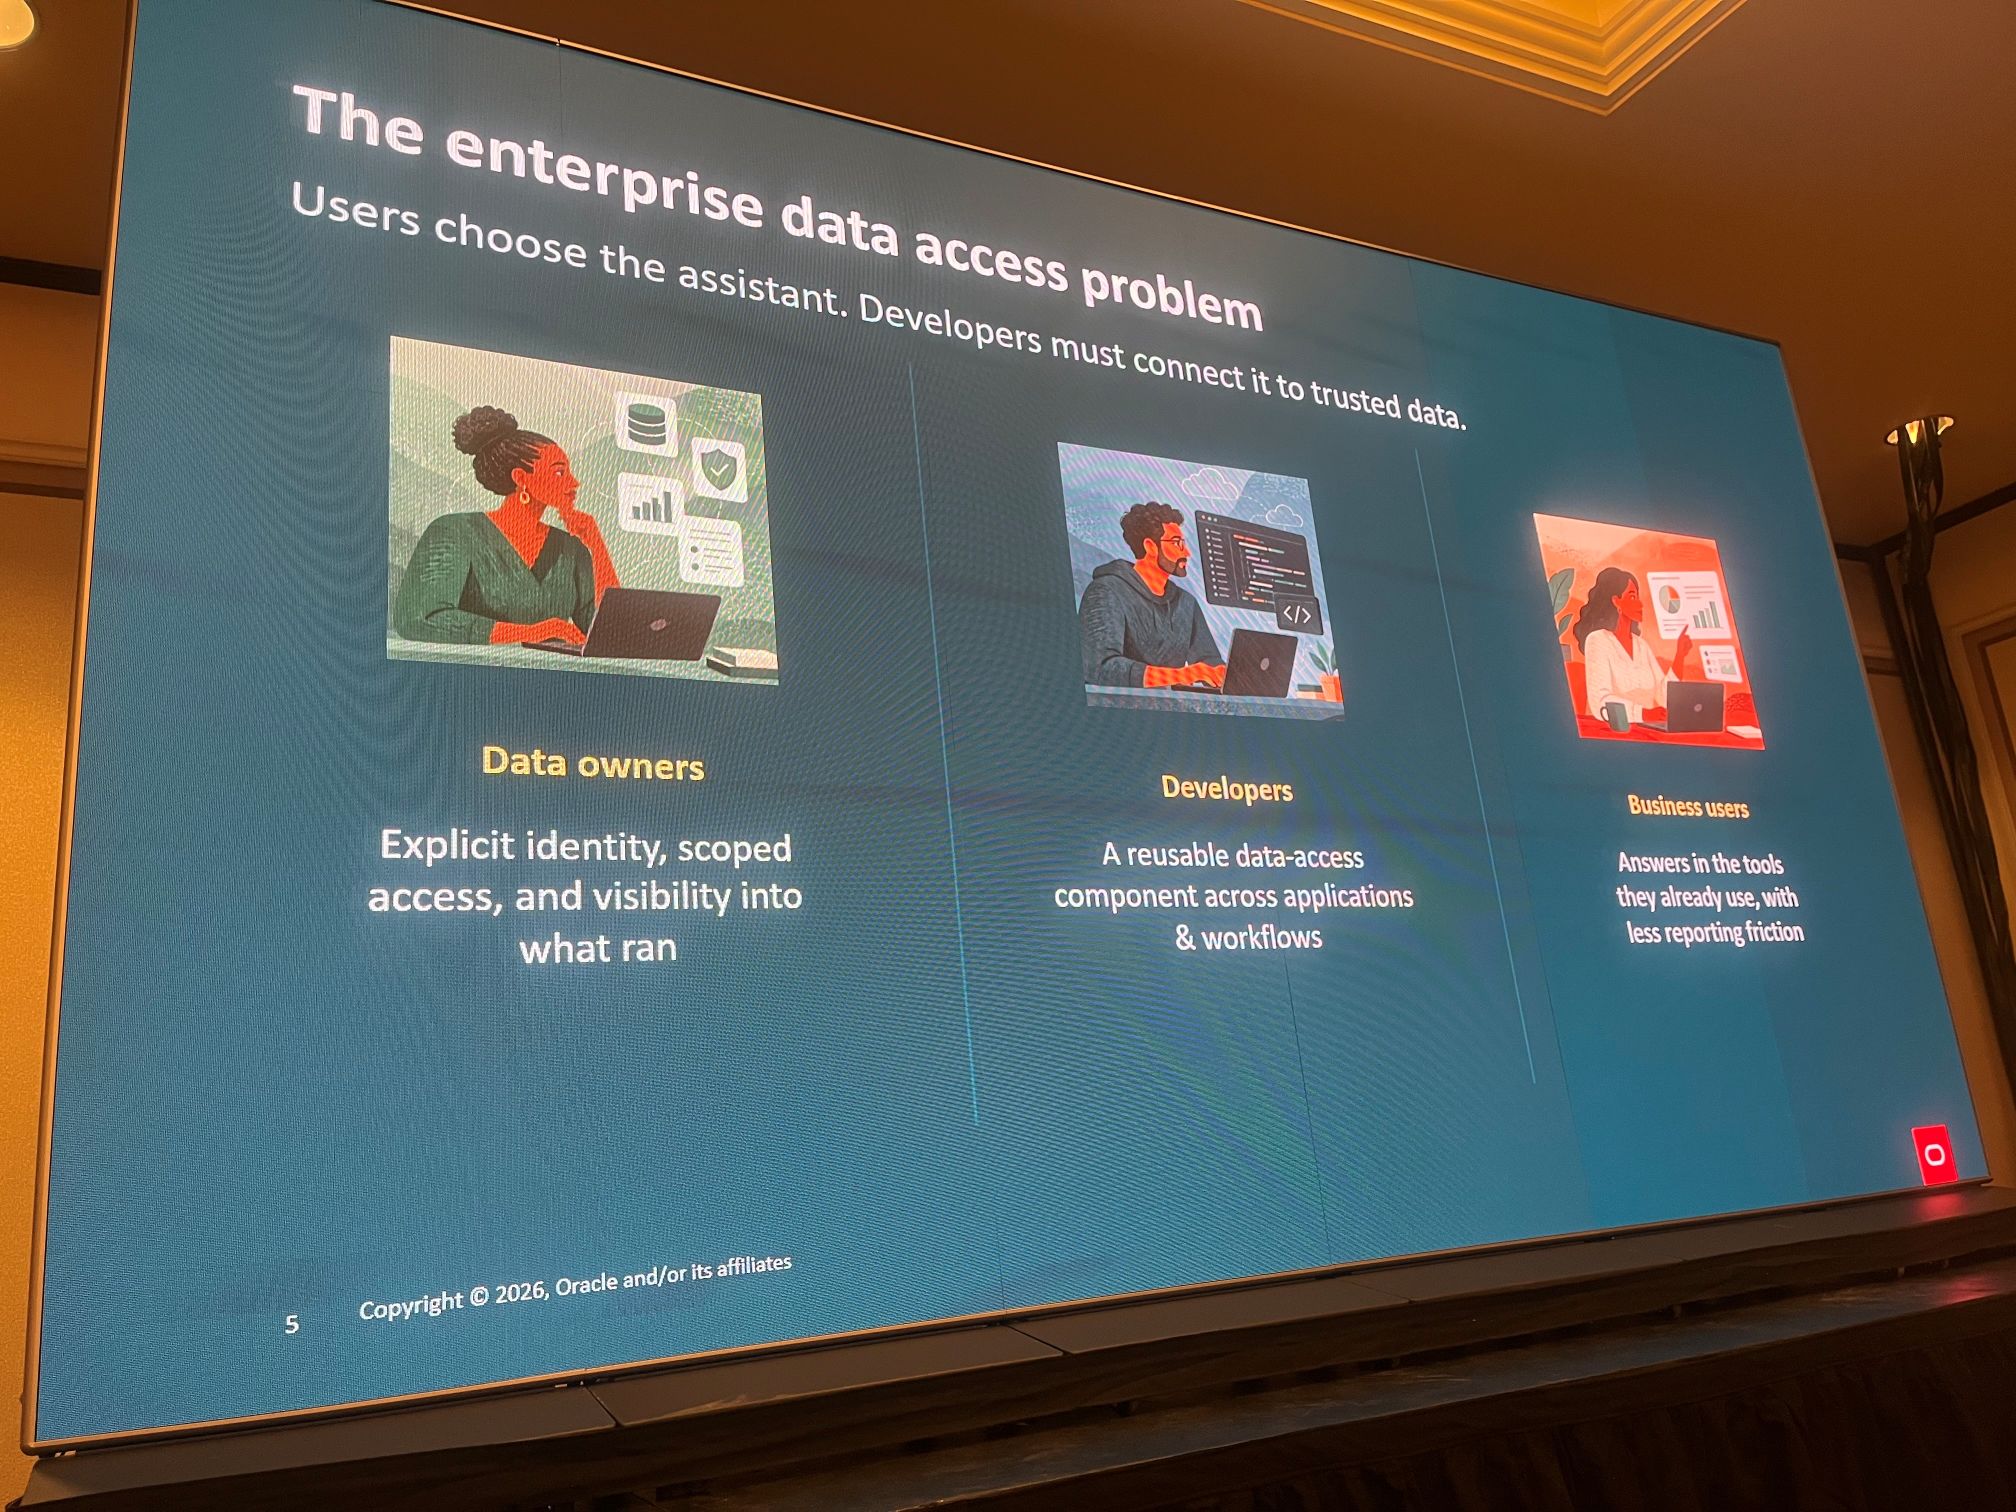
- セッションでは、冒頭に会場へ「データオーナー、開発者、ビジネスユーザーはどれくらいいるか」と挙手を求め、3 者がほぼ均等に分かれていると語られました。どの立場にも使いやすい体験にする、という狙いが背景にあります。
Oracle AI Database はあらゆる場所で動く
- Oracle AI Database は、OCI、オンプレミス、Dedicated Region、Exadata Cloud@Customer、AWS、Microsoft Azure、Google Cloud で動作します。スライドでは「now runs natively everywhere」と表現されていました。
Google Cloud:Gemini Enterprise × Oracle AI Database Agent
統合・マネージド・拡張可能
- Oracle AI Database Agent for Gemini Enterprise は、4 月に Google Cloud とのパートナーシップとして発表されたものです(Oracle の公式発表は 2026 年 4 月 22 日)。「ビジネスユーザーがデータから洞察を得るまでの距離を縮める」ことが狙いと説明されました。
- セッションでは、従来の流れを次のように振り返っていました。
- チケットを切ってデータアナリストに依頼する
- SQL が書かれ、結果が返り、レポートが作られる
- 条件が変わればこれを繰り返す
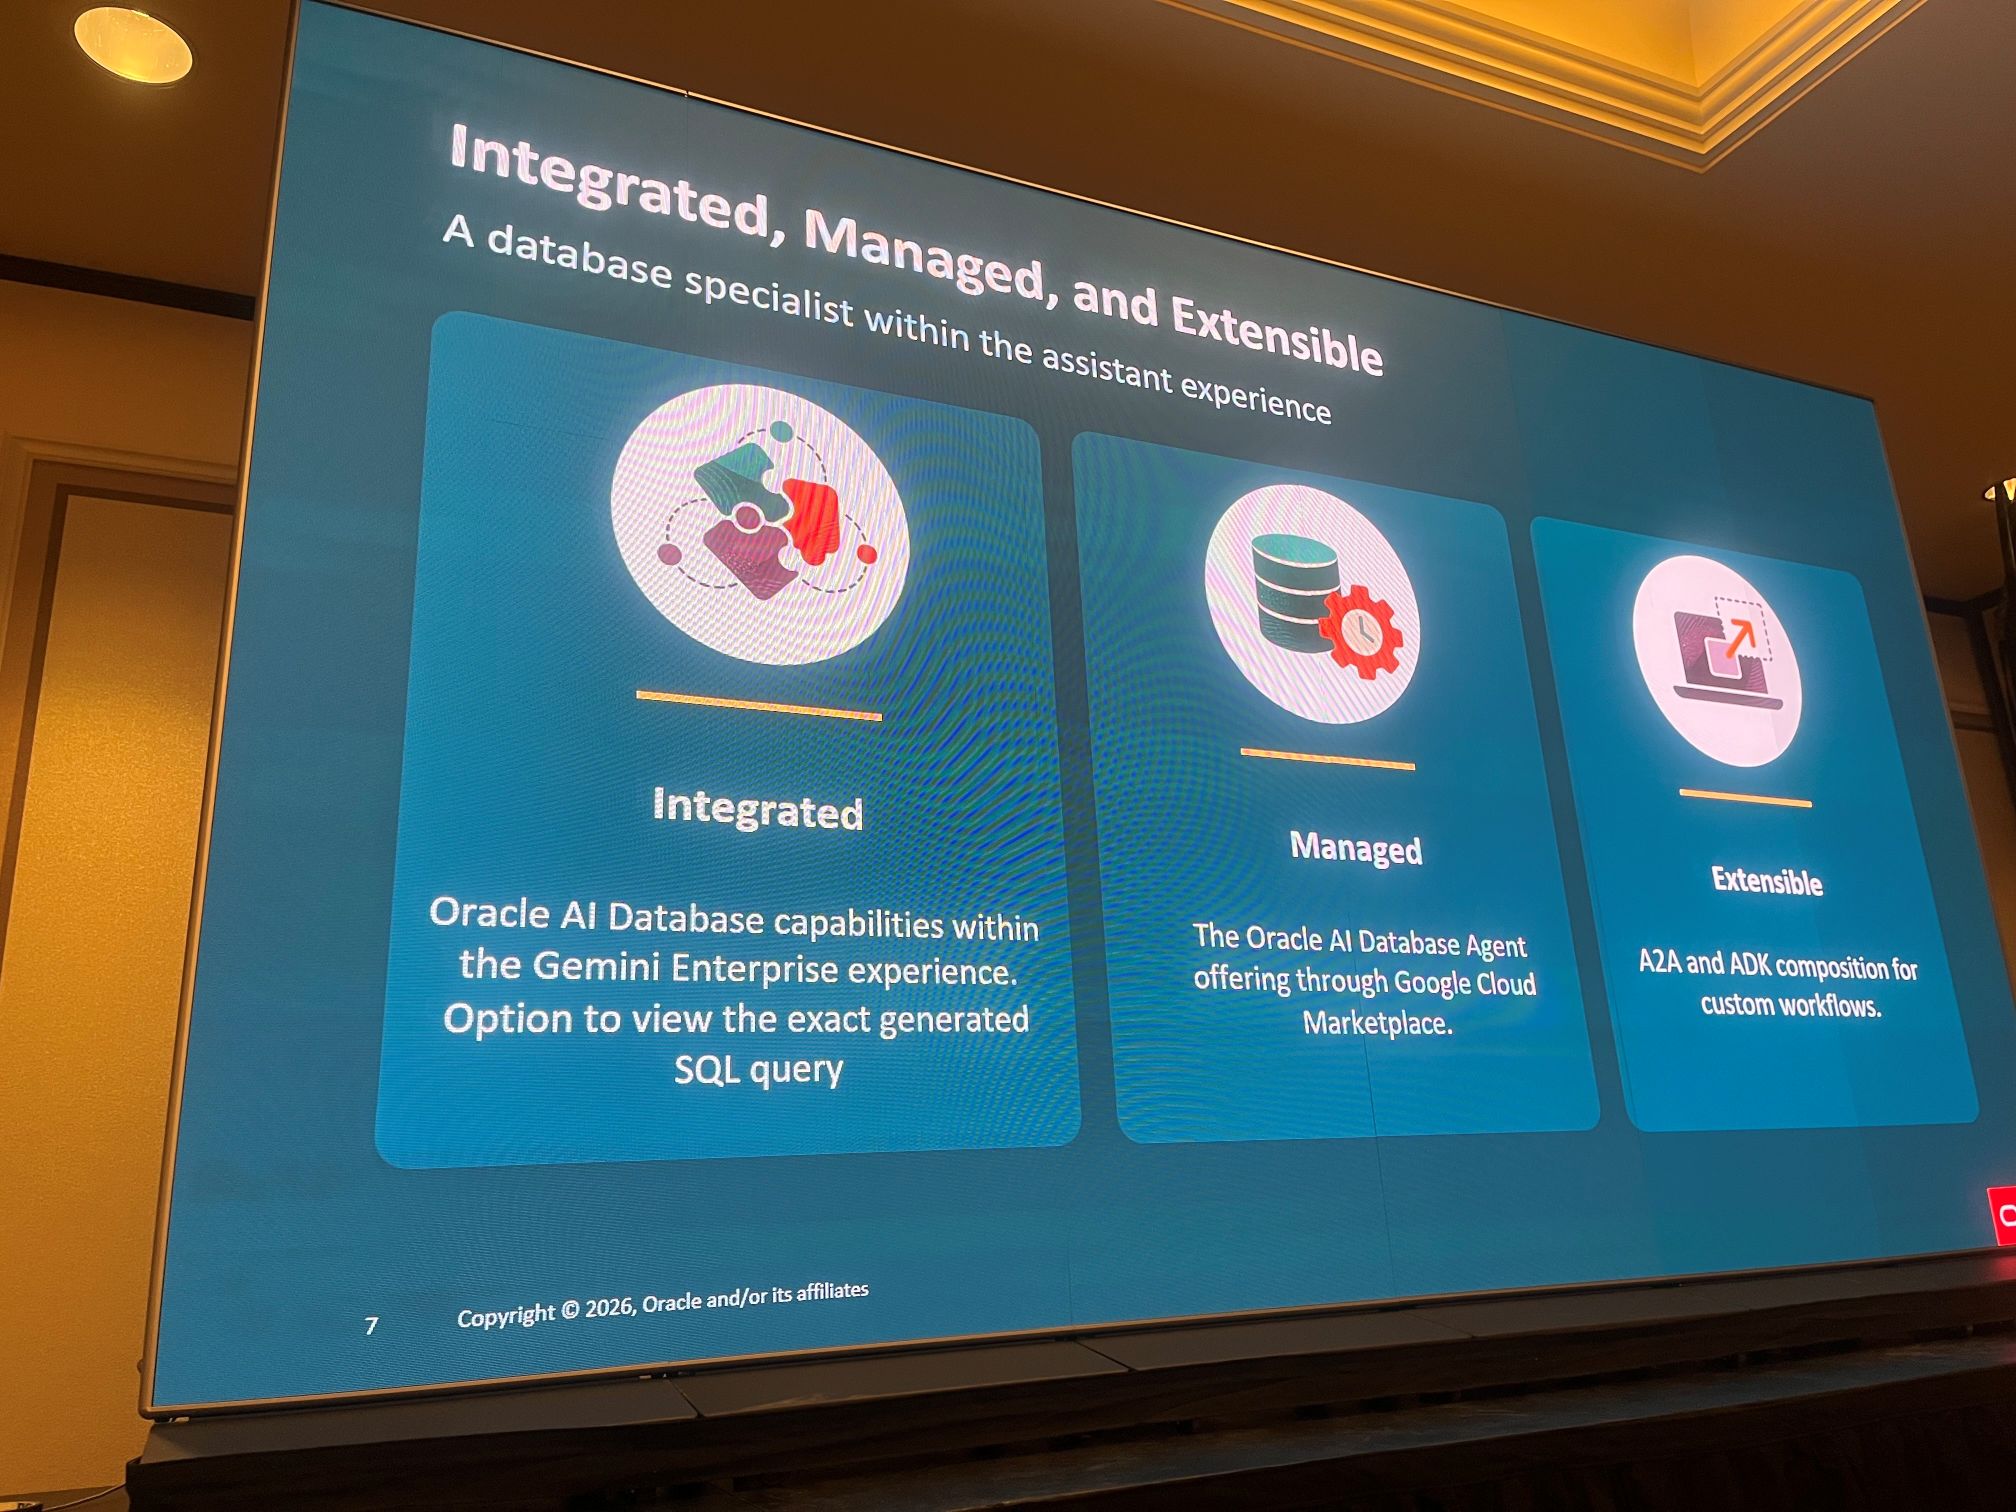
- このエージェントを使うと、自然言語で質問でき、データベースの ID がそのまま適用されます。特長は次の 3 つです。
- Integrated:Gemini Enterprise の体験の中で Oracle AI Database の機能を使える。生成された SQL をそのまま確認するオプションがある。
- Managed:Google Cloud Marketplace から提供される。セッションでは、エージェントは Marketplace から追加料金なしで入手できると説明されていました(公開情報でも、Google Cloud 上の既存の Autonomous AI Database 利用者向けに追加費用なしとされています)。
- Extensible:A2A と ADK(Agent Development Kit)を組み合わせて、独自のワークフローを作れる。
複数のエージェントを A2A でつなぐ
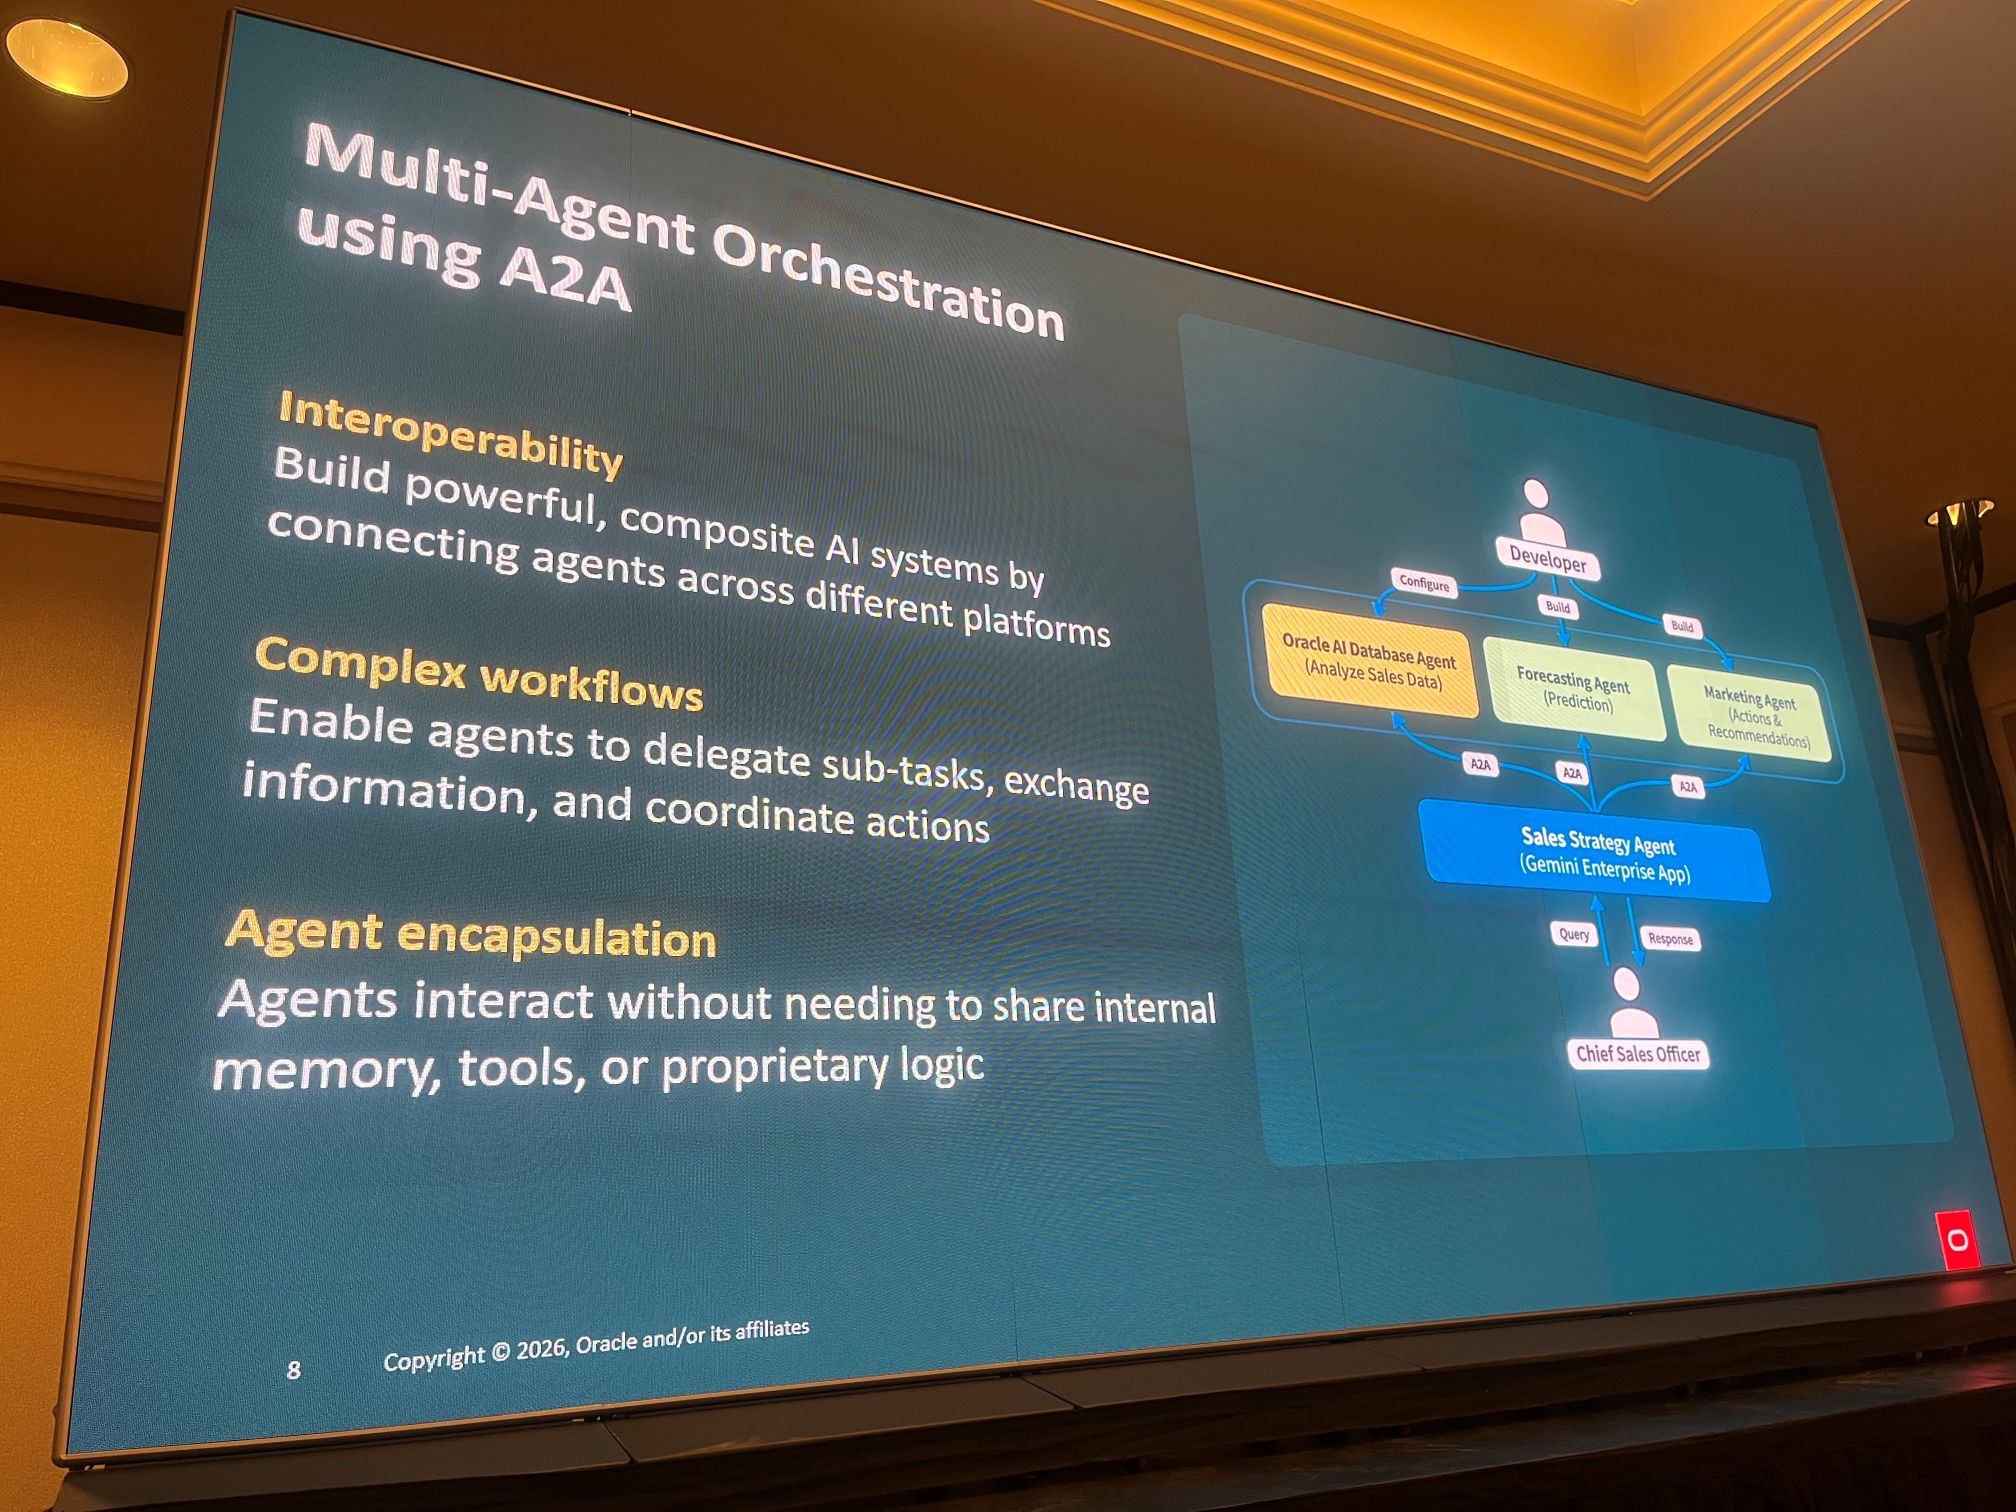
- データベースと話すエージェントが 1 つとは限りません。スライドでは、次のような構成例が示されていました。
- Oracle AI Database Agent:売上データの分析
- Forecasting Agent:予測
- Marketing Agent:アクションと推奨の提示
- Sales Strategy Agent(Gemini Enterprise アプリ):各エージェントに A2A でタスクを振り、結果を営業責任者に返す
- セッションでは、Marketing Agent が Web から情報を集め、メールなどと組み合わせて提案を作る、という例が語られました。A2A は、エージェントが内部のメモリやツール、独自ロジックを共有せずにやりとりできる点が特徴です。
6 月以降のアップデート
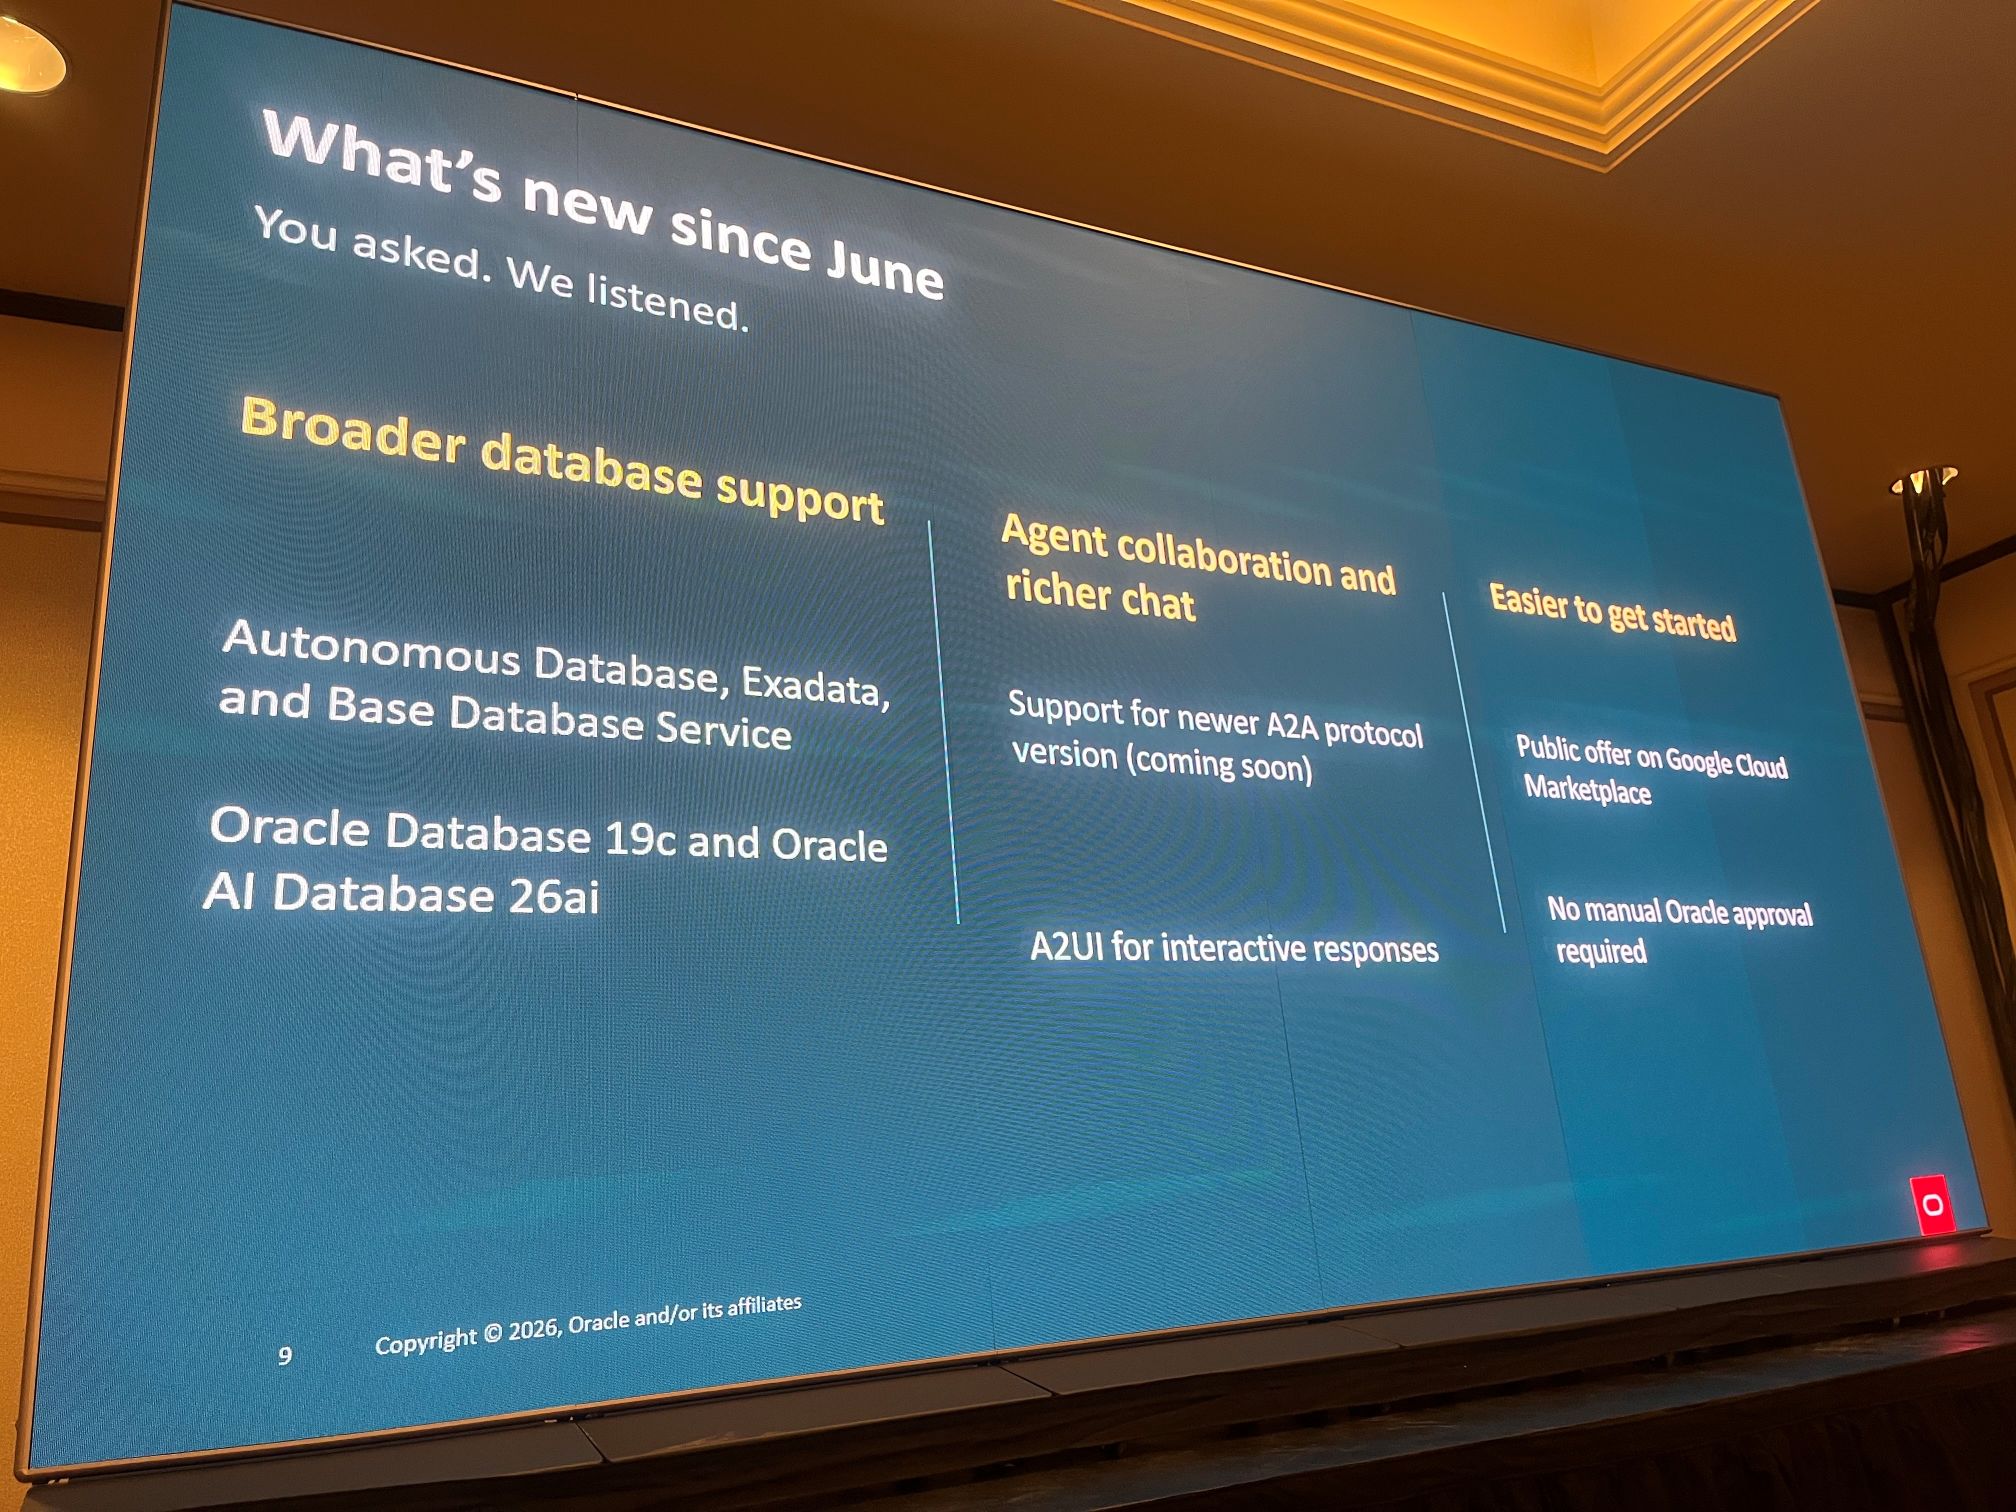
- スライド「What’s new since June」では、次の更新が示されていました。
- 対応データベースの拡大:Autonomous Database、Exadata、Base Database Service。Oracle Database 19c と Oracle AI Database 26ai
- エージェント連携とチャットの強化:新しい A2A プロトコルのバージョンへの対応(近日対応予定)。インタラクティブな応答のための A2UI
- 始めやすさ:Google Cloud Marketplace でのパブリックオファー。Oracle の手動承認が不要
ID とデータの範囲
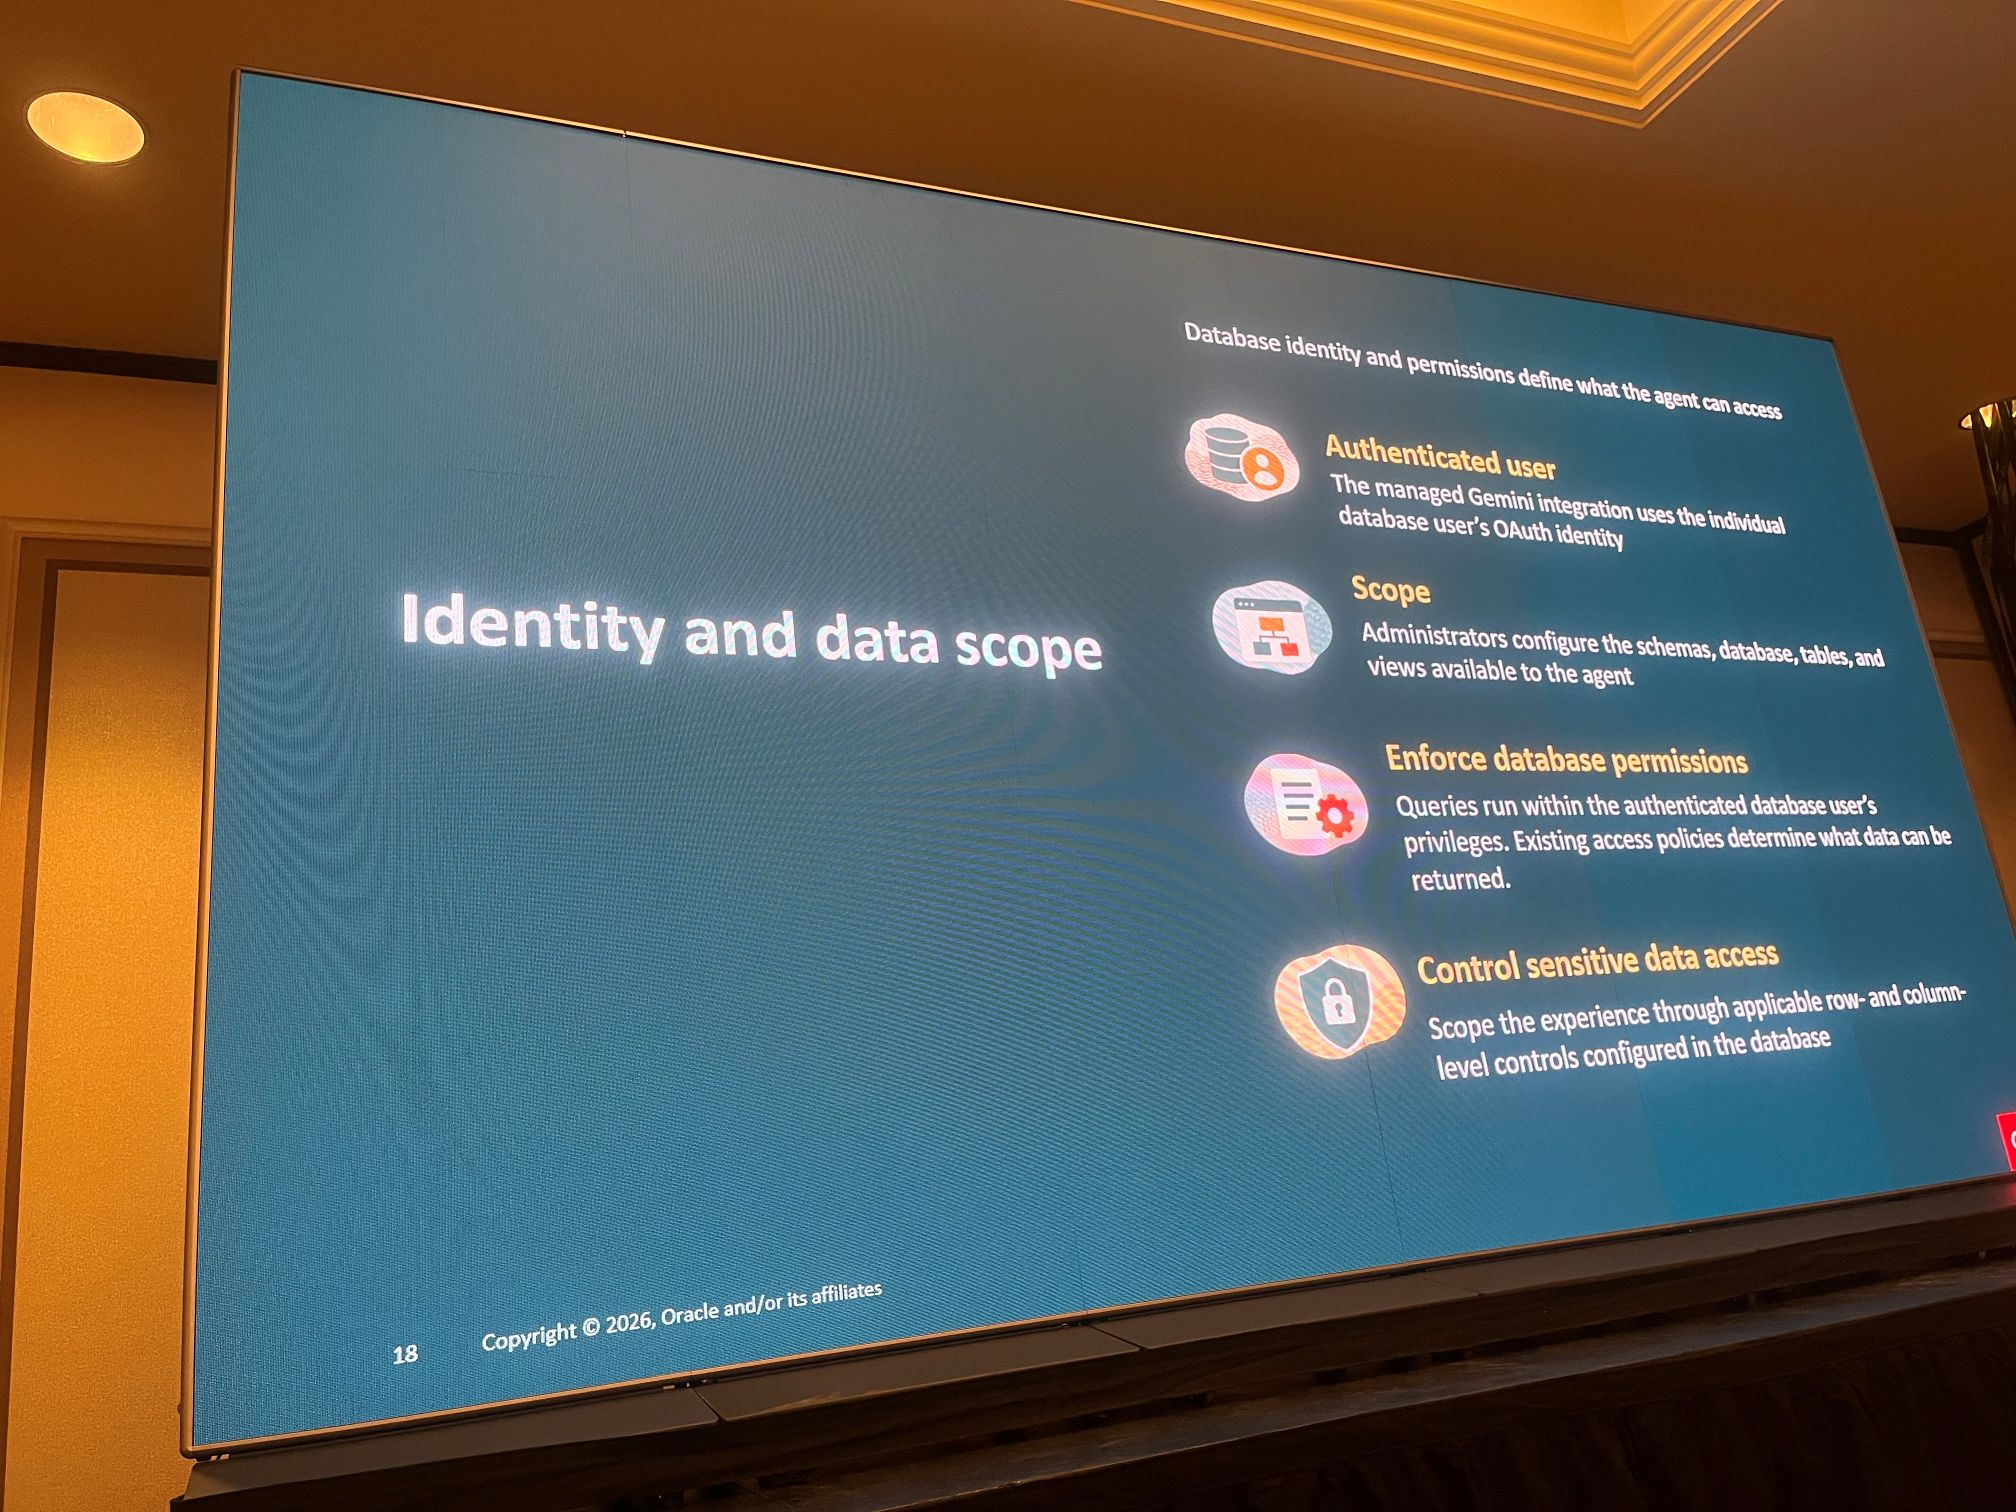
- セキュリティの考え方は、スライド「Identity and data scope」に整理されていました。
- 認証されたユーザー:マネージドな Gemini 連携は、データベースユーザー個人の OAuth ID を使う
- スコープ:管理者がエージェントに見せるスキーマ、テーブル、ビューを設定する
- データベース権限の適用:クエリは認証されたユーザーの権限の範囲で実行される。既存のアクセスポリシーが返せるデータを決める
- 機微データの制御:データベースに設定された行・列レベルの制御で範囲を絞る
デモ:サプライチェーンのシナリオ
- セッションでは、Oracle の登壇者がサプライチェーンのシナリオでデモを行いました。デモで使ったコードやドキュメント、スキルは GitHub で入手でき、自分のクラウドで試せると説明されていました。
- セットアップは次の流れで、「5 分程度」と語られました。
- 1. コンソールで Oracle データベースを選び、エージェントに公開するデータを設定する
- 2. Gemini Enterprise でアプリを作る
- 3. データソースの画面で MCP サーバー(サプライチェーン用)を確認する
- 4. エージェントの画面で、Marketplace から Oracle AI Database Agent を追加する
- 5. 独自の A2A エージェントは、A2A カードを登録して追加する
- 実際の操作は次のとおりでした。
- 「すべての SKU を一覧して」と質問すると、初回に認可を求められる。同じアプリを異なるデータベースユーザーで使い分けられる
- 在庫切れリスクのある SKU を絞り込む。Google 検索をオフにして、回答がデータベースだけに基づくことを示した
- 依存関係のグラフを、インタラクティブな MCP アプリとして表示する(Oracle Database のグラフ機能が使われている)
- 在庫切れリスクのホットスポットを地図で表示する
- 最後に、A2UI を使ったサプライチェーン用エージェントが、在庫移送の対応案を画面で提示する。確認なしに実行するのではなく、承認を挟む画面になっている
- 読み取りと分析は MCP アプリ、洞察を行動に移す部分は A2UI、という使い分けで見せていたと補足されました。
アーキテクチャと ID の流れ
- 続いて Google の登壇者がアーキテクチャを解説しました。次の 4 層で整理されていました。
- Interface 層:Gemini Enterprise、A2UI と MCP アプリ(動的な UI フォームとアクションカード)
- Orchestration 層:Cloud Run とオーケストレーター、人による確認、カスタム可視化エージェント、A2A のサブエージェント
- Data 層:Oracle AI Database Agent、Oracle の Autonomous Database(Deep Data Security)
- Lakehouse Intelligence 層:Cloud Storage(非構造化データ)、Apache Iceberg Lakehouse(Zero-copy の Iceberg REST Catalog)、BigQuery Analytics
- セッションでは、次の点が強調されていました。
- A2A は、Google、Microsoft、AWS、Oracle などどこで作られたエージェントでも呼べる相互運用のためのもの
- A2UI は、エージェントごとに最適化された画面を返すためのもの
- クラウドからのアクセスでは OAuth トークンが使われ、リクエスト可否の検証の後、データベース側でユーザーの権限が適用される
- Deep Data Security により行・列レベルで権限を強制できる
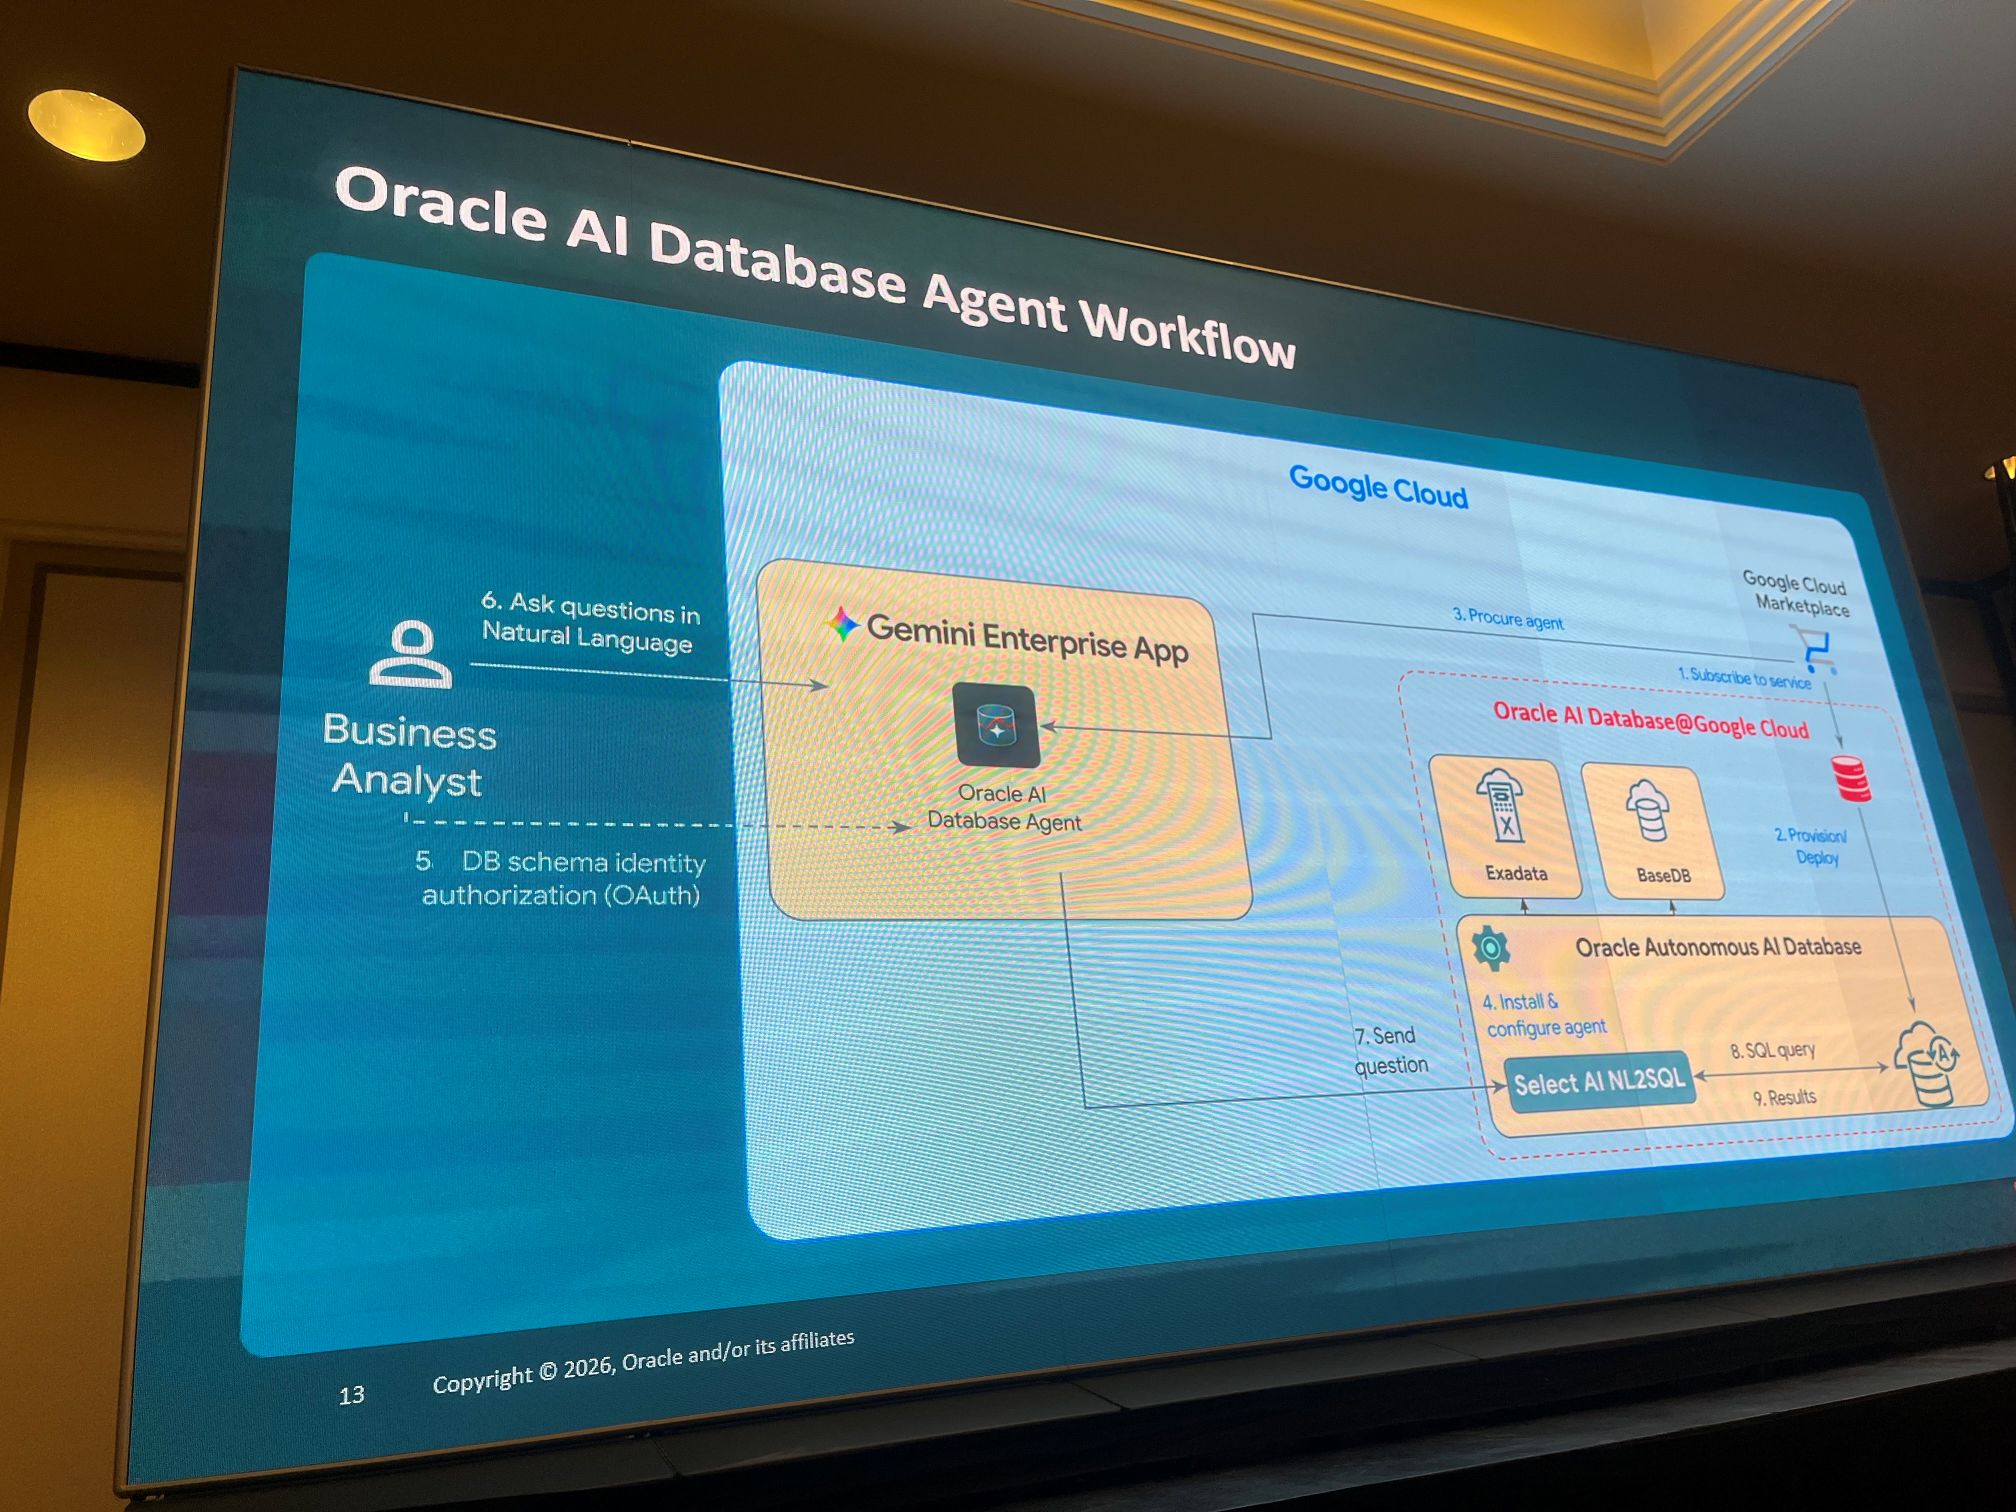
- スライド「Oracle AI Database Agent Workflow」の手順は次のとおりです。
- 1. Marketplace でサービスを購読
- 2. プロビジョニング/デプロイ
- 3. エージェントを調達
- 4. エージェントをインストール、設定(Select AI NL2SQL)
- 5. データベーススキーマの ID 認可(OAuth)
- 6. 自然言語で質問
- 7. 質問を送信
- 8. SQL クエリを実行
- 9. 結果を返す
Google 側の全体像とお客様の声
- Google のスライドでは、Gemini Enterprise が「エージェント時代のエンドツーエンドのシステム」として紹介されていました。Gemini Enterprise Agent Platform は、Build(ADK、新しい Agent Studio、200 以上のモデル)、Scale(Agent Runtime、Memory Bank)、Govern(Agent Identity、Registry、Gateway)、Optimize(シミュレーション、評価、オブザーバビリティ)の 4 つで構成されています。
- また、Google Cloud と Oracle のパートナーシップ全体は、「Oracle in Gemini」と「Gemini in Oracle」で整理されていました。
- Oracle in Gemini:Gemini Agentic Data Cloud Connector、Oracle AI Database Agent、Agents for Industries
- Gemini in Oracle:Oracle Enterprise AI Ecosystem(Fusion AI Agent Studio、Fusion Claw、Oracle NetSuite Connector)、OCI 上の Google Cloud TPU
- お客様の声として、ADT と AI Shift のコメントが紹介されました。AI Shift(日本企業)のコメントでは、Gemini Enterprise から Oracle AI Database Agent を使うことで、SQL を書く作業から自然言語で信頼できる企業データに基づく回答を得る作業へ移れるという趣旨が語られていました(スライドの要旨)。
AWS:Amazon Quick と Kiro から Oracle AI Database へ
Oracle AI Database と連携する AWS の AI サービス
- AWS は「ビジネスユーザー」の立場でデモを行いました。スライドでは、Oracle AI Database と連携する AWS の AI サービスとして、Amazon Bedrock、Amazon Bedrock AgentCore、Kiro、Amazon Quick が示されていました。
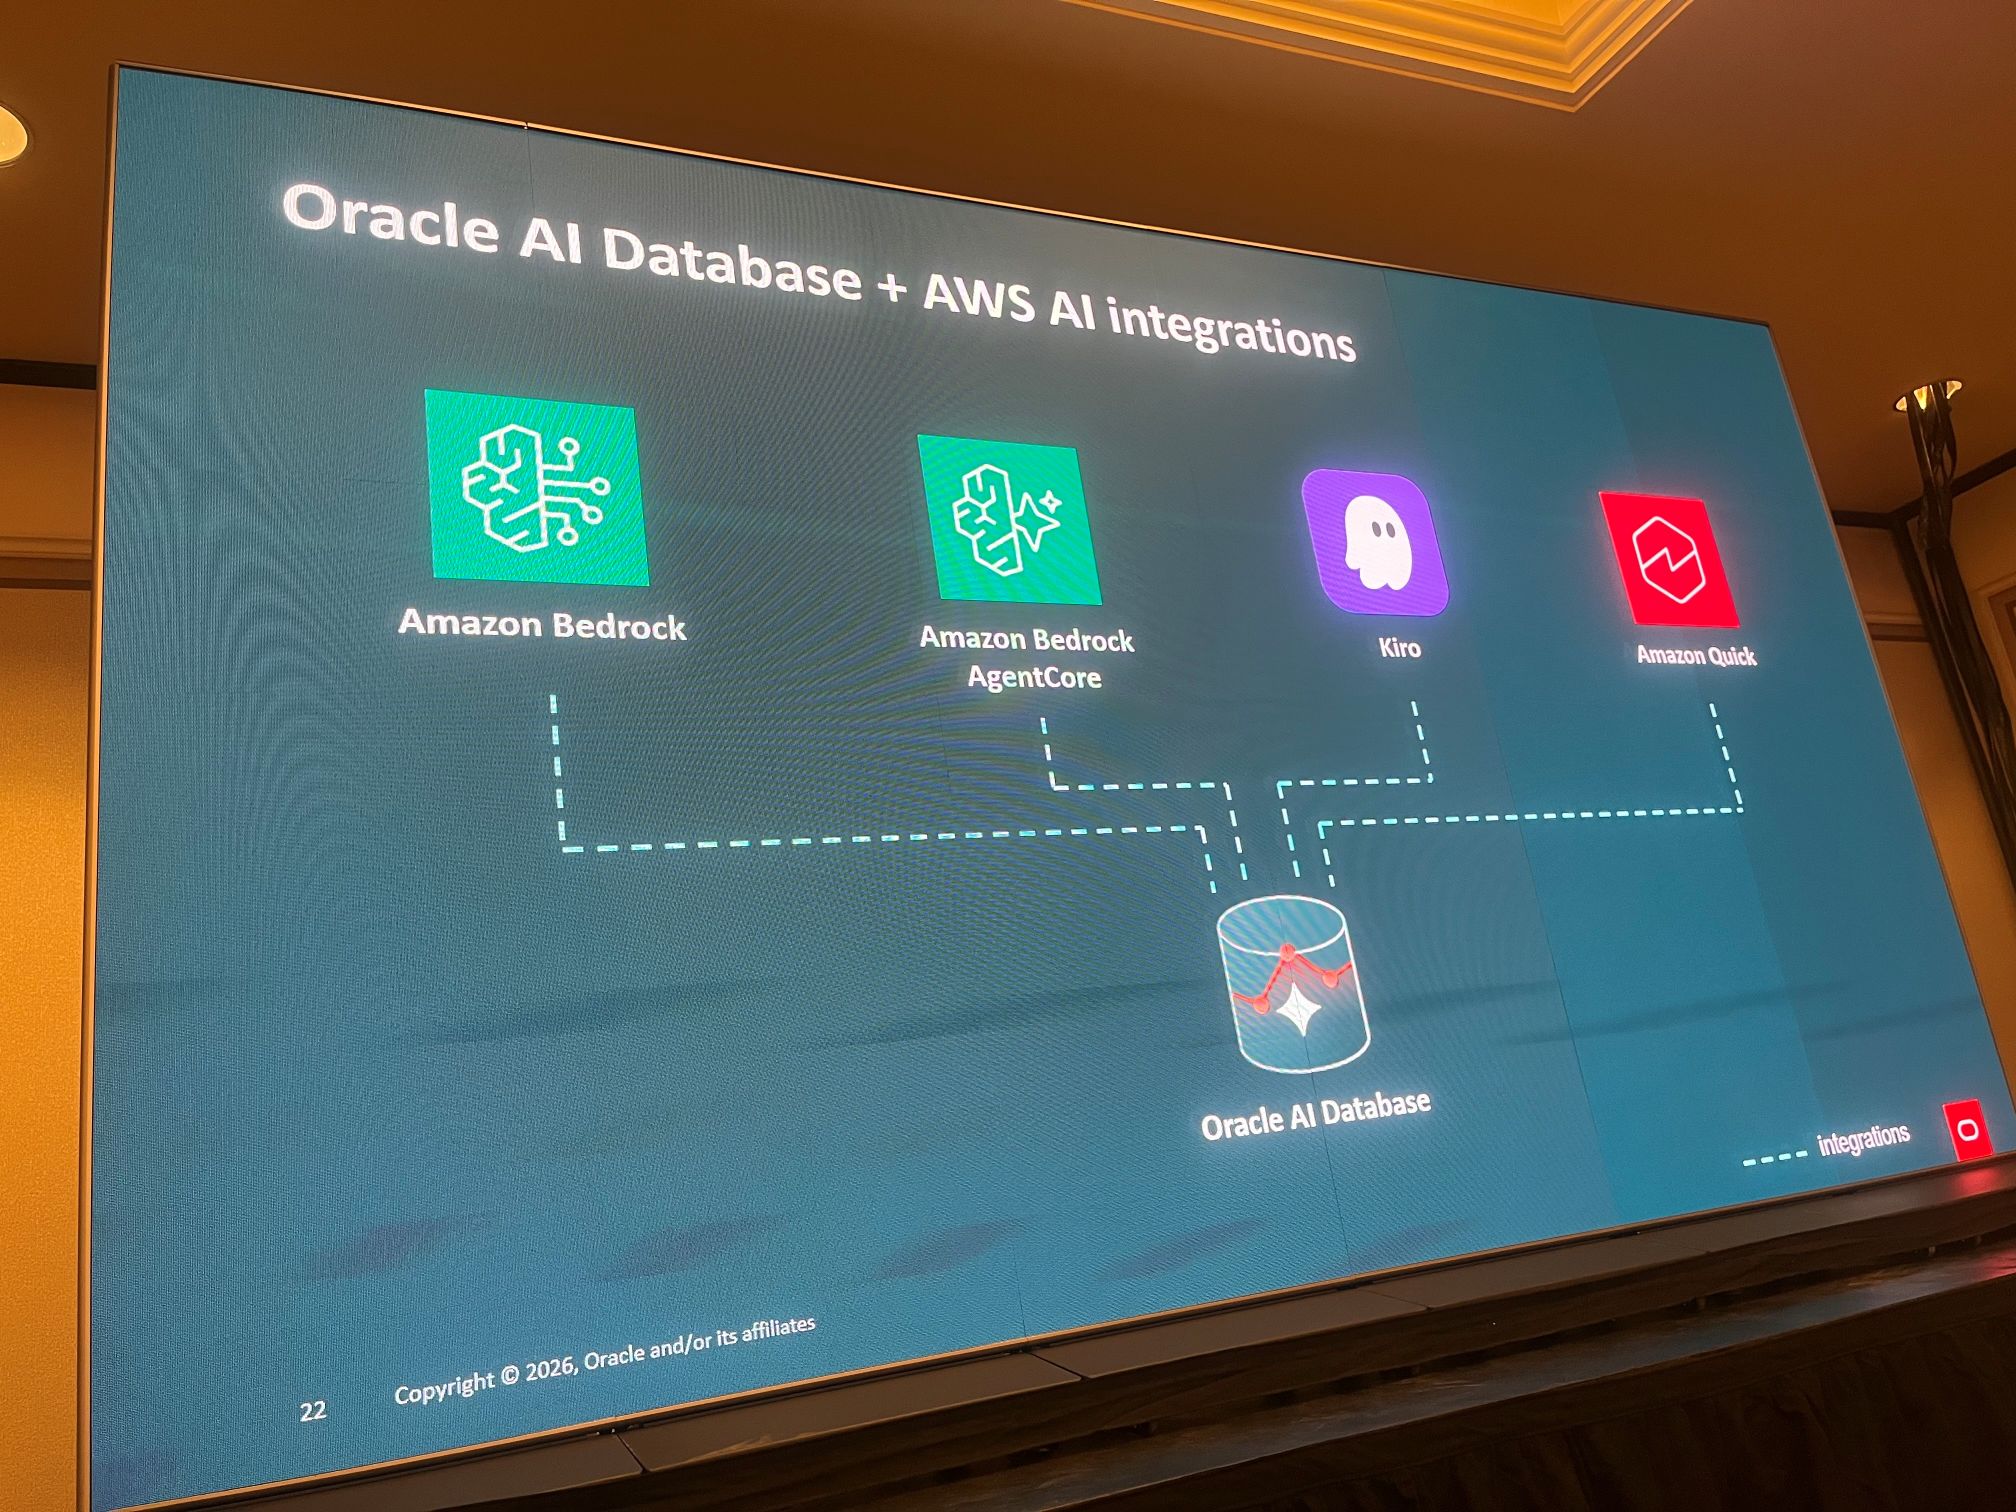
- セッションでは、それぞれの役割を次のように説明していました。
- Amazon Bedrock:アプリやエージェントを作るためのモデル基盤
- Bedrock AgentCore:各サービスをつなぐ「接着剤」
- Kiro:統合開発環境(IDE)
- Amazon Quick:ビジネスユーザー向けの入口
Kiro で作りQuick で聞く
- デモは、Oracle Autonomous AI Database on AWS に売上データがあるという前提で進みました。
- 構築:Kiro に「ビジネスユーザーが売上データへ英語で質問できるように、Amazon Quick をデータベースにつないでチャットアシスタントを作って」と数文で依頼すると、MCP サーバー経由で Quick とデータベースが接続された。SQL もコンソール操作も不要。スライドには「every write waits for your yes(更新は必ず承認を待つ)」と表示されていた
- ガードレール:「総売上とトップの営業担当は?」といった読み取りはその場で答える。変更を依頼すると明示的に承認されるまで書き込みを拒否する
Iceberg のデータをコピーせずに統合する
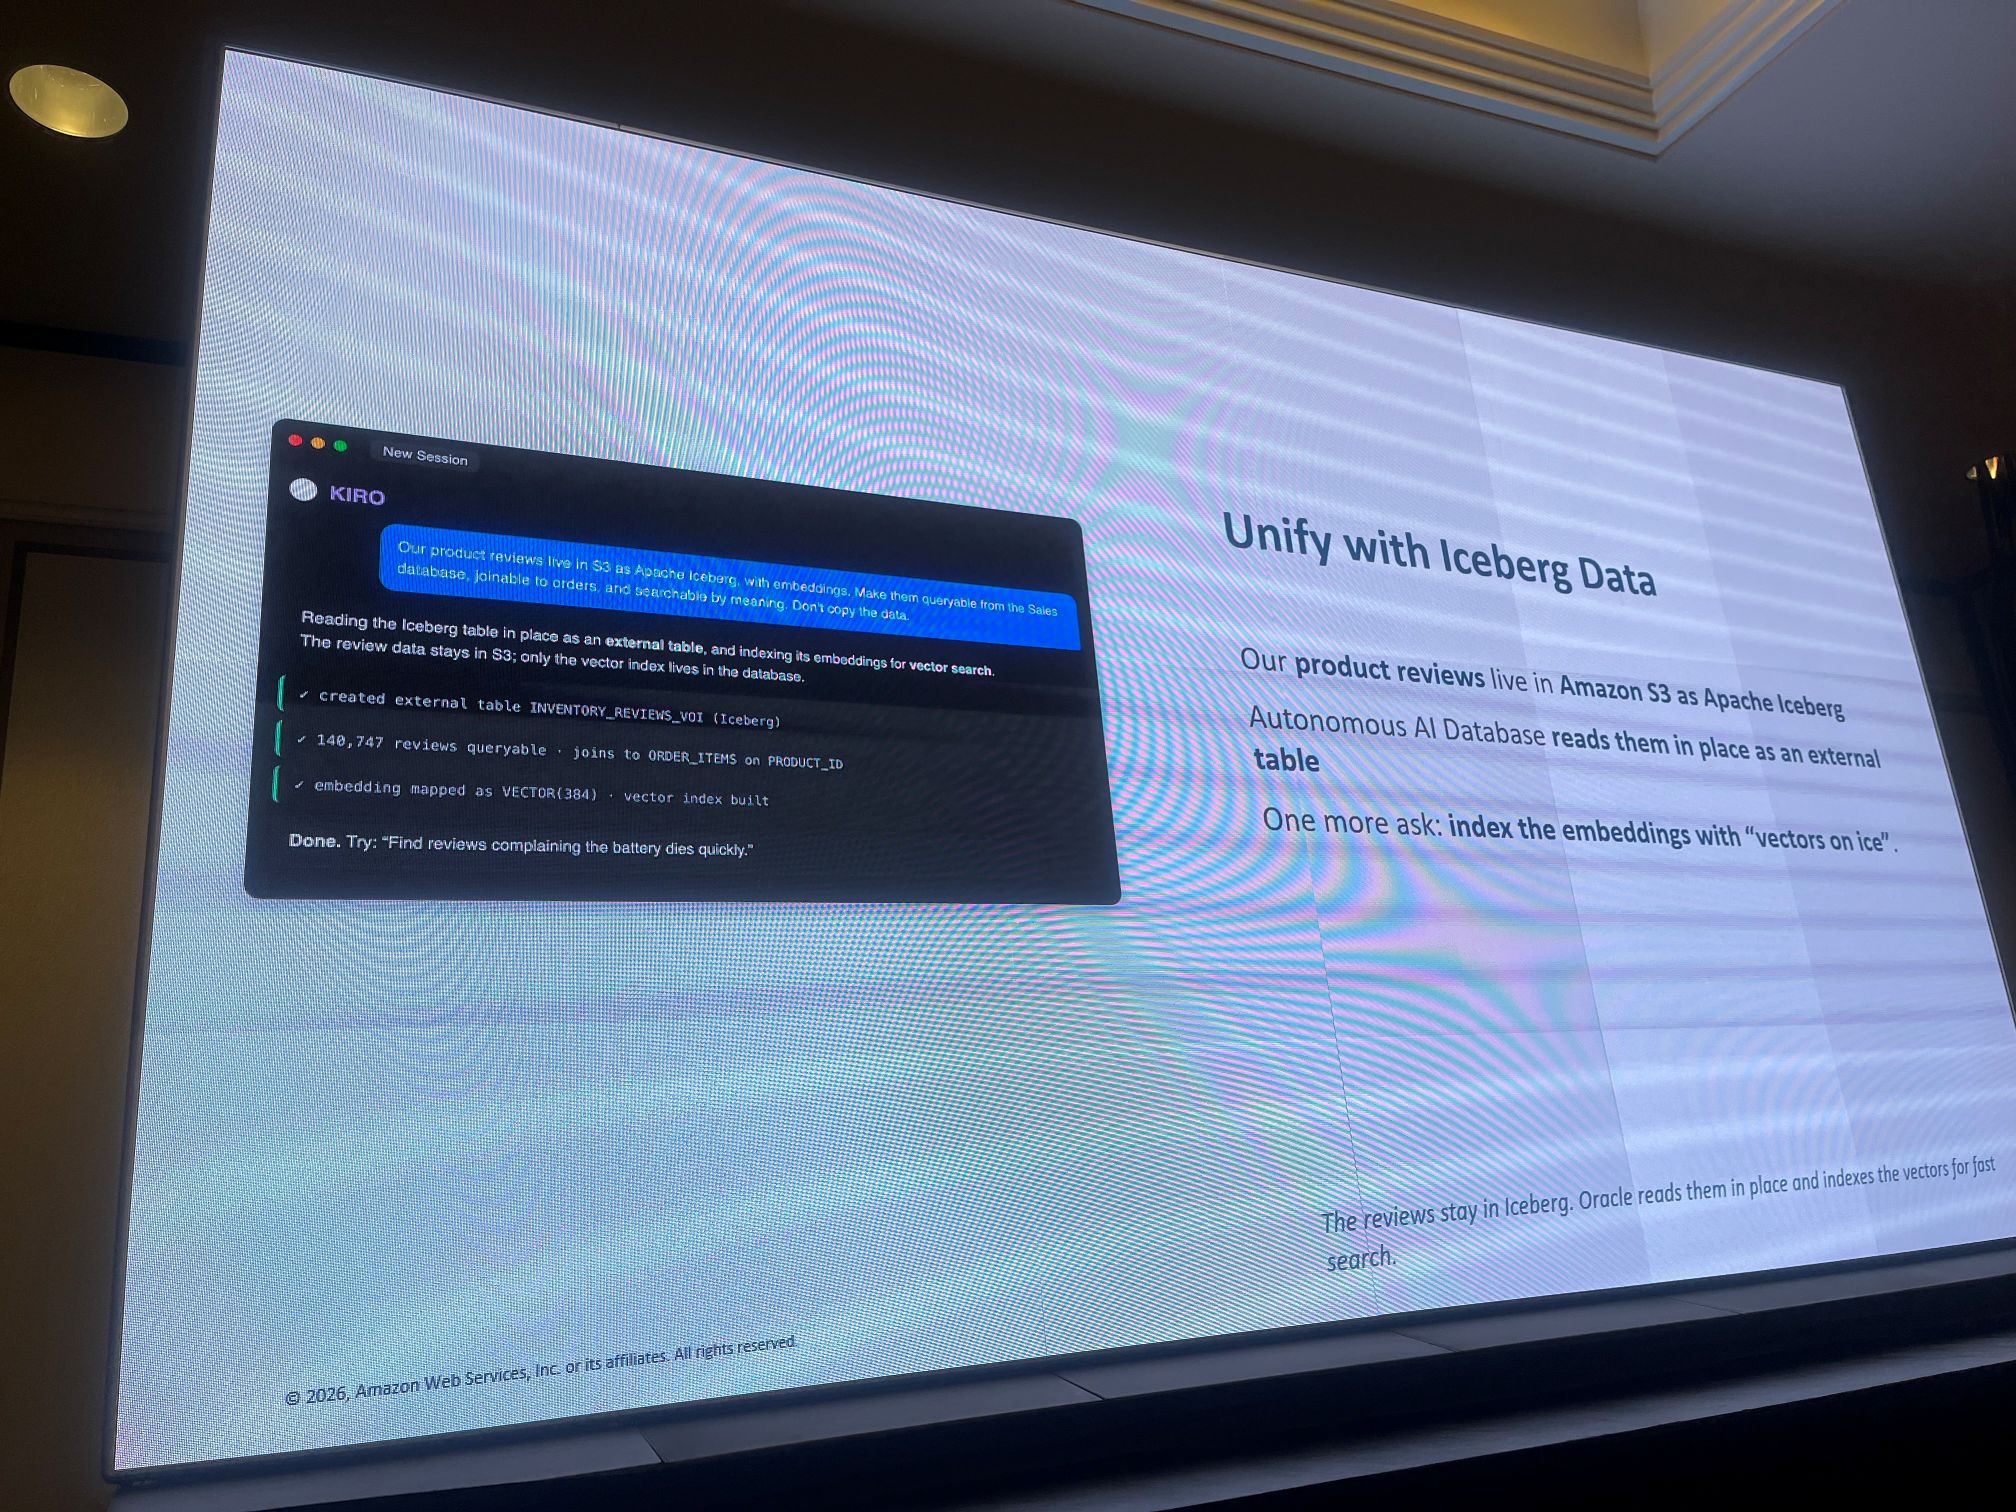
- 次のデモでは、S3 上の Apache Iceberg 形式の商品レビューをAutonomous AI Database から外部表として読み込みました。
- レビューのデータは S3 に残し、データベースにはベクトルインデックスだけを作る
- スライドには「140,747 reviews queryable」「VECTOR(384)」「vector index built」と表示されていた
- 続けて、「vectors on ice」でエンベディングをインデックス化するよう依頼していた
リスクを見つけメールに対応する
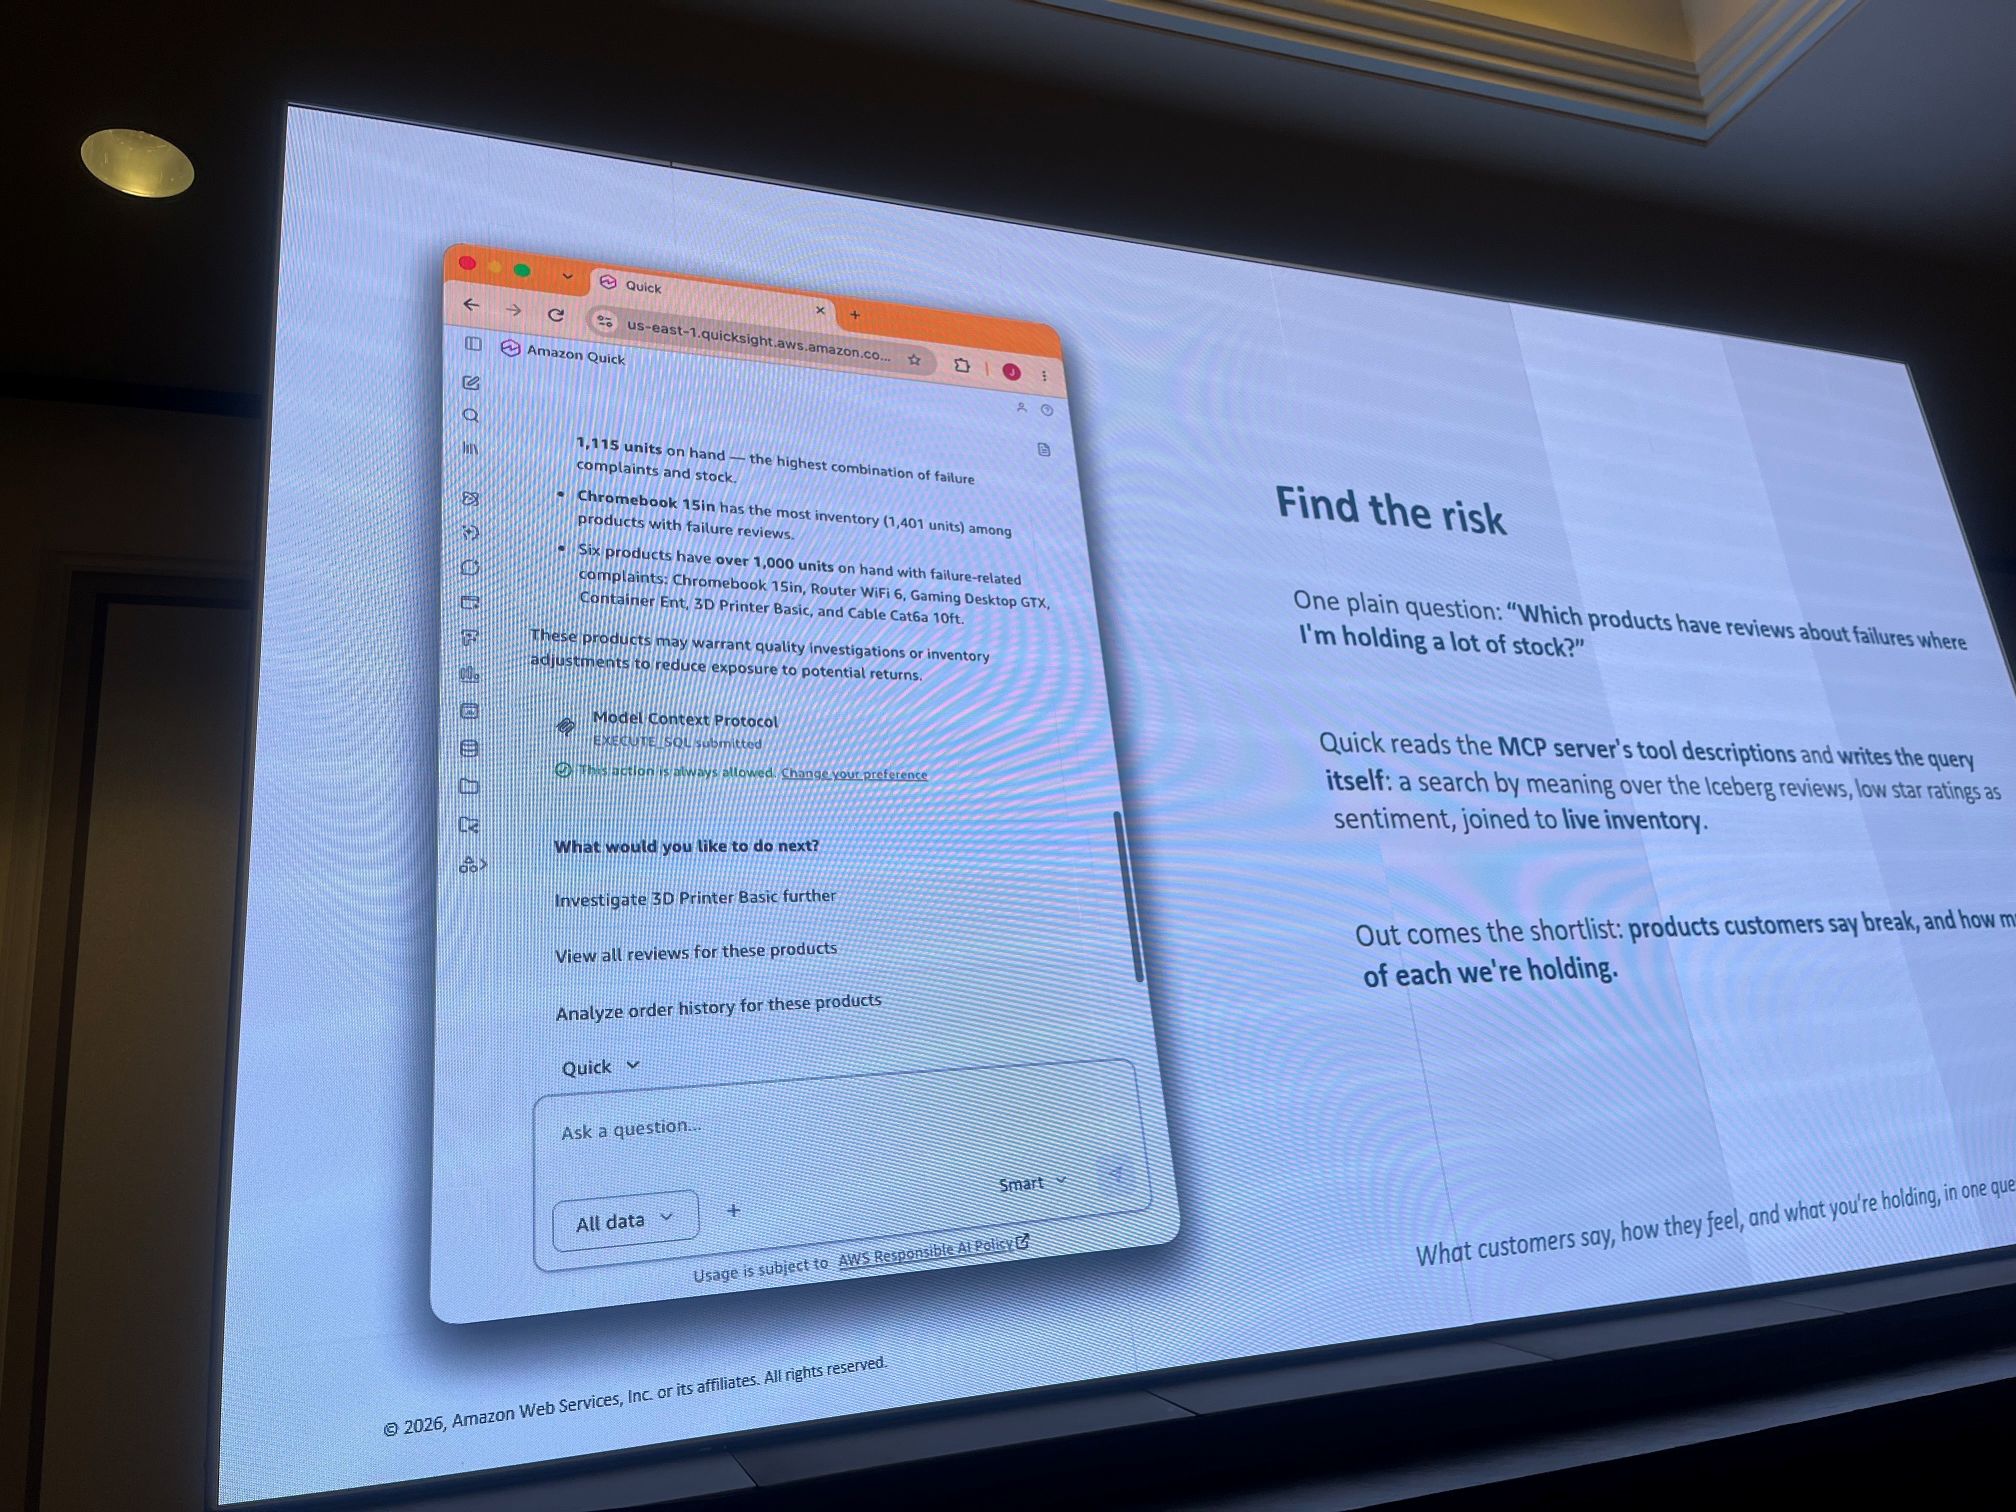
- Quick に「故障のレビューがあり、在庫を多く抱えている商品はどれか」と 1 つの質問を投げるというデモもありました。
- Quick は MCP サーバーのツールの説明を読み、自分でクエリを書く
- 意味による検索(Iceberg のレビュー)、低い星評価を感情の指標とする分析、リアルタイムの在庫を組み合わせる
- 結果として、在庫が 1,000 台を超えるのに故障関連のレビューがある商品が 6 つ示された
- さらに「Act on email」では、顧客から「注文 2402 はどこですか」というメールが届く場面で、Quick に「注文 2402 のメールに対応して」と頼むと返信メールの下書きが提示されました。スライドの結びは「Quick does the legwork; I make the call.(下調べは Quick、判断は人)」でした。
Microsoft:Foundry と Copilot から Oracle へ
Ignite 2026 で発表される連携
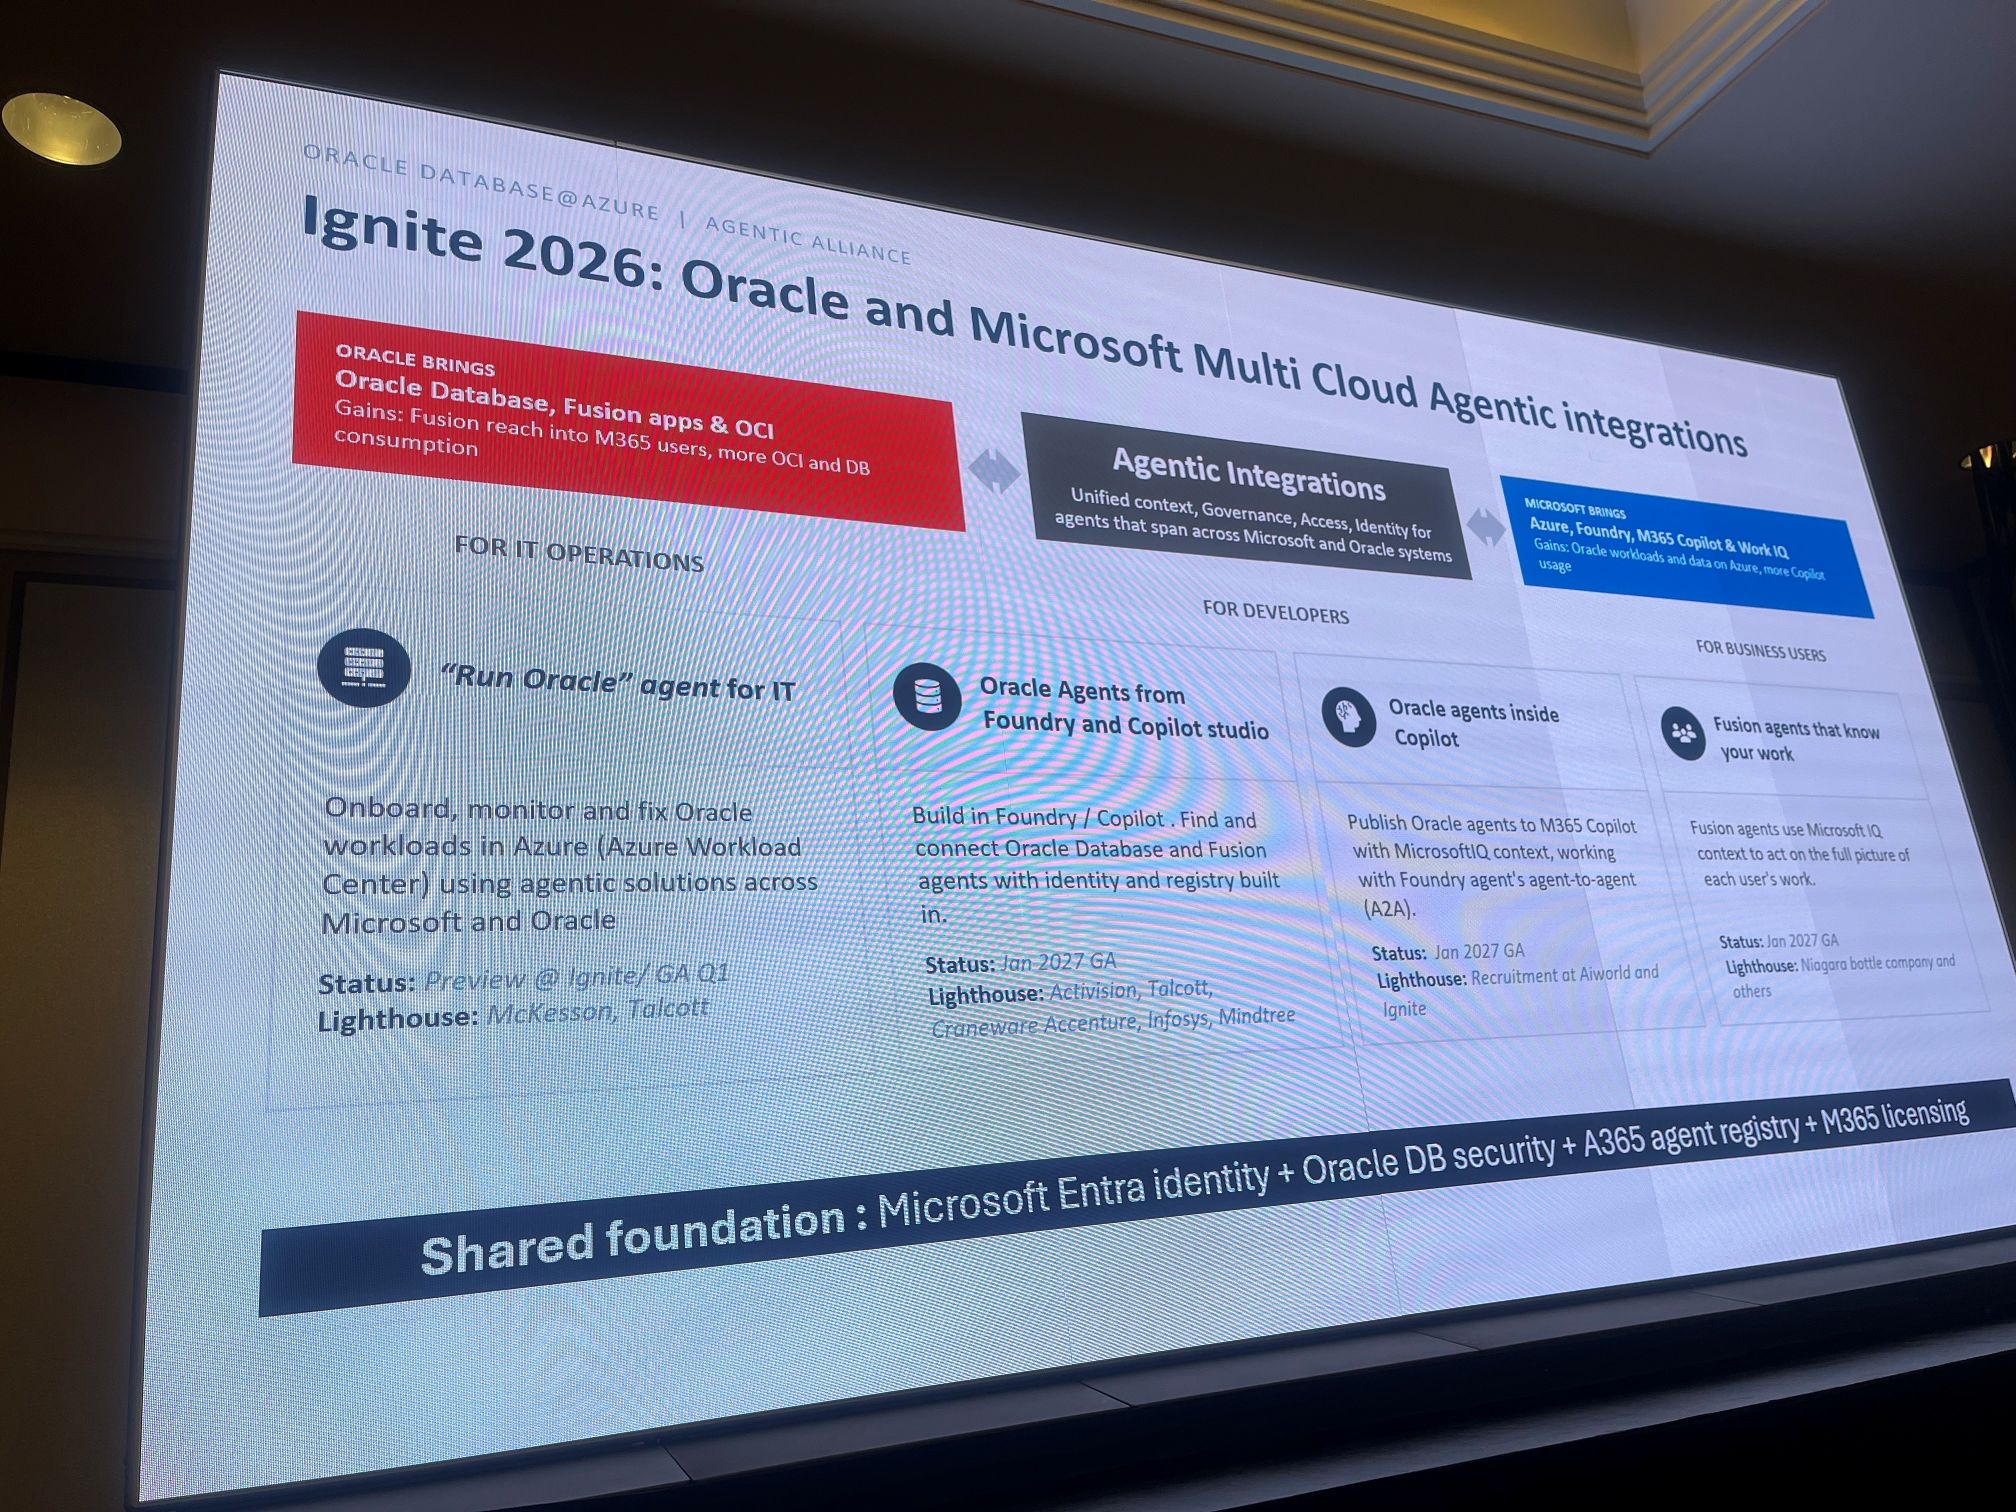
- スライドのタイトルは「Ignite 2026: Oracle and Microsoft Multi Cloud Agentic integrations」でした。それぞれの役割は次のように示されていました。
- Oracle が提供するもの:Oracle Database、Fusion apps、OCI
- Microsoft が提供するもの:Azure、Foundry、M365 Copilot、Work IQ
- 共通基盤:Microsoft Entra ID、Oracle DB のセキュリティ、エージェントレジストリ、M365 ライセンス
- 連携の領域は 4 つです。
- IT 運用向け「Run Oracle」エージェント:Azure 上の Oracle ワークロードのオンボード、監視、修復。スライドの Status は Ignite でのプレビュー、一般提供開始は Q1
- Foundry と Copilot Studio からの Oracle エージェント:Oracle Database や Fusion のエージェントを、ID とレジストリを組み込んで見つけ、つなぐ(Jan 2027 GA)
- Copilot の中の Oracle エージェント:M365 Copilot に Oracle エージェントを公開(Jan 2027 GA)
- 仕事を知っている Fusion エージェント:Fusion のエージェントが、Microsoft IQ のコンテキストを使い、各ユーザーの仕事の全体像に沿って動く(Jan 2027 GA)
- セッションでは、Foundry はプロ開発者向け、Copilot Studio はローコード/ノーコード(市民開発者)向けのビルダーとして説明されていました。
Foundry から A2A でつなぐ安全な売上分析エージェント
- 「Build a Secure Sales Analytics Agent」では、課題が 3 つ挙げられていました。
- ビジネスユーザーは、企業データへ自然言語で質問したい
- 開発者は、エージェントを信頼できるデータベースにつなぐ必要がある
- データを別の AI アプリケーション層へコピーすると、複雑さとセキュリティのリスクが生じる
- まとめのスライドは次のとおりです。
- Microsoft Foundry がエージェント体験を統括する
- Oracle AI Database が信頼できる企業データから答える
- A2A がデータを複製せずにシステムをつなぐ
- 開発者は、チャットでのテストからコードへ移れる
OpenAI:ChatGPT から Oracle AI Database へ
Oracle と OpenAI:4 つの新しいリリース
- スライドでは、ChatGPT、Codex、先進的な AI を、Oracle のアプリケーション、データ、OCI にまたがって使う 4 つのリリースが紹介されました。
- Oracle AI Security Mesh:脆弱性を見つけ、修正を検証する
- Oracle AI Workspace:アプリ、データ、承認されたアクションをつなぐ
- Oracle App Composer:Codex でアプリを作り、OCI 上で共有する
- Oracle AI SMB Bundle:AI ツール、NetSuite、OCI クレジットから始める(Oracle の公式発表では、年間 12,000 ドル分のクレジットを含むとされています)
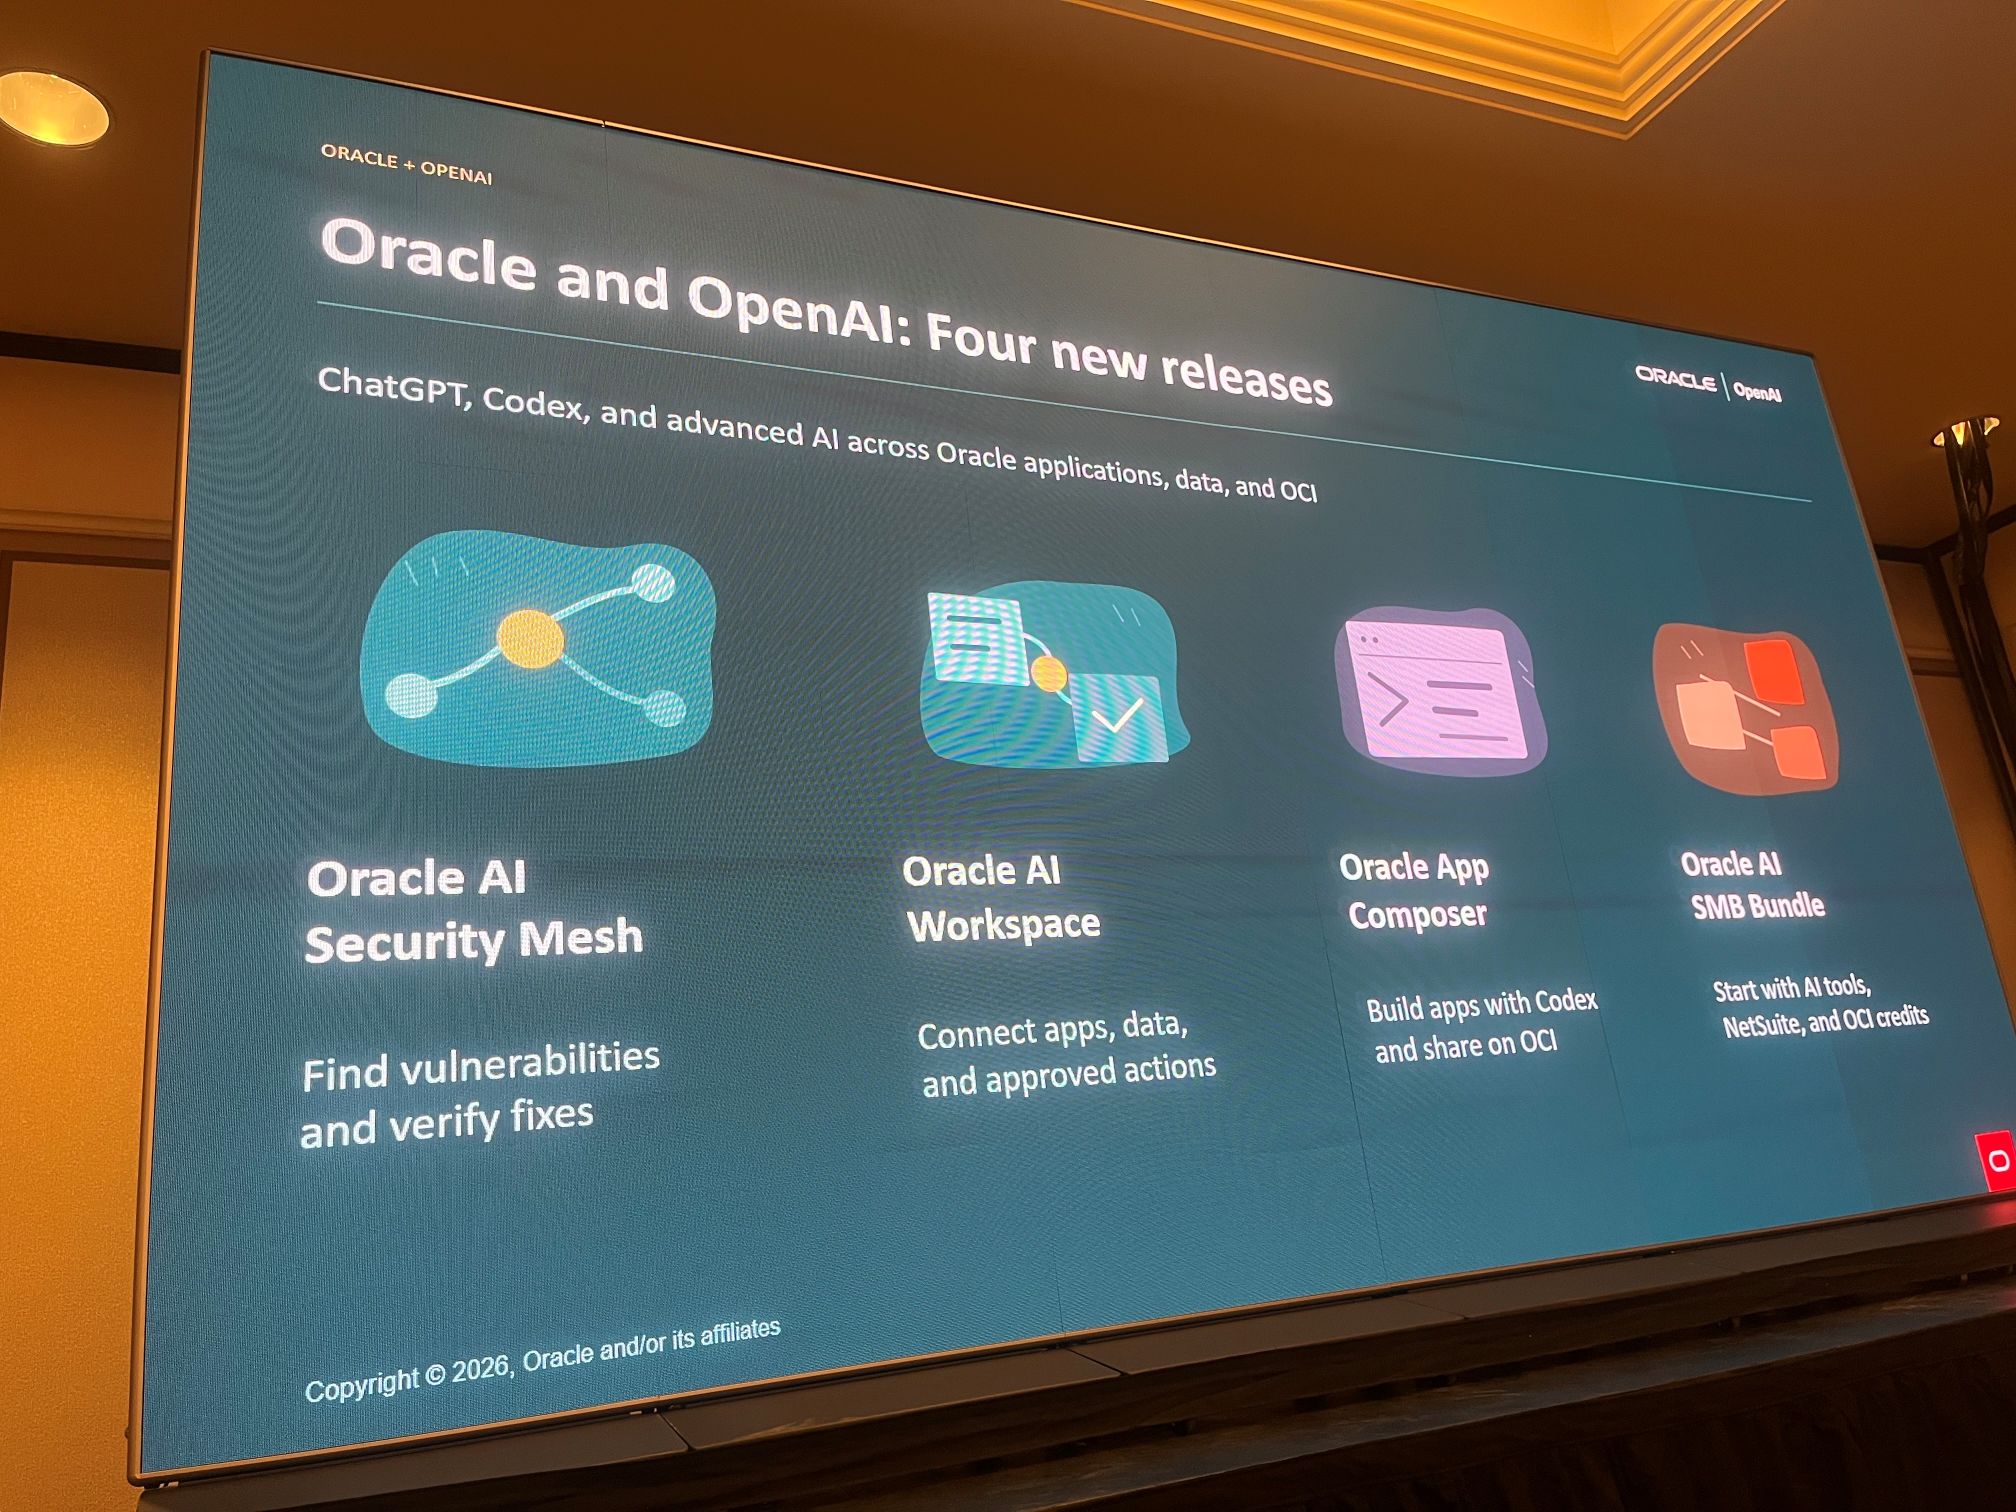
- Oracle AI Workspace は、Fusion、NetSuite、Oracle AI Database、OCI をまたいで、ChatGPT のプラグインから承認済みの業務を扱えるようにするものです(Oracle の公式発表)。セッションでは、App Composer は、大企業で Codex を使って素早く作ったアプリを、安全にポリシーに沿って動かすという課題への答えである、と語られました。
ChatGPT から Oracle AI Database へ
- ChatGPT から Oracle AI Database へのつなぎ方は、スライドで次のように示されていました。
ChatGPT → Oracle AI Database プラグイン → OCI Database Tools MCP Server → Oracle AI Database(ライブデータへのクエリ)
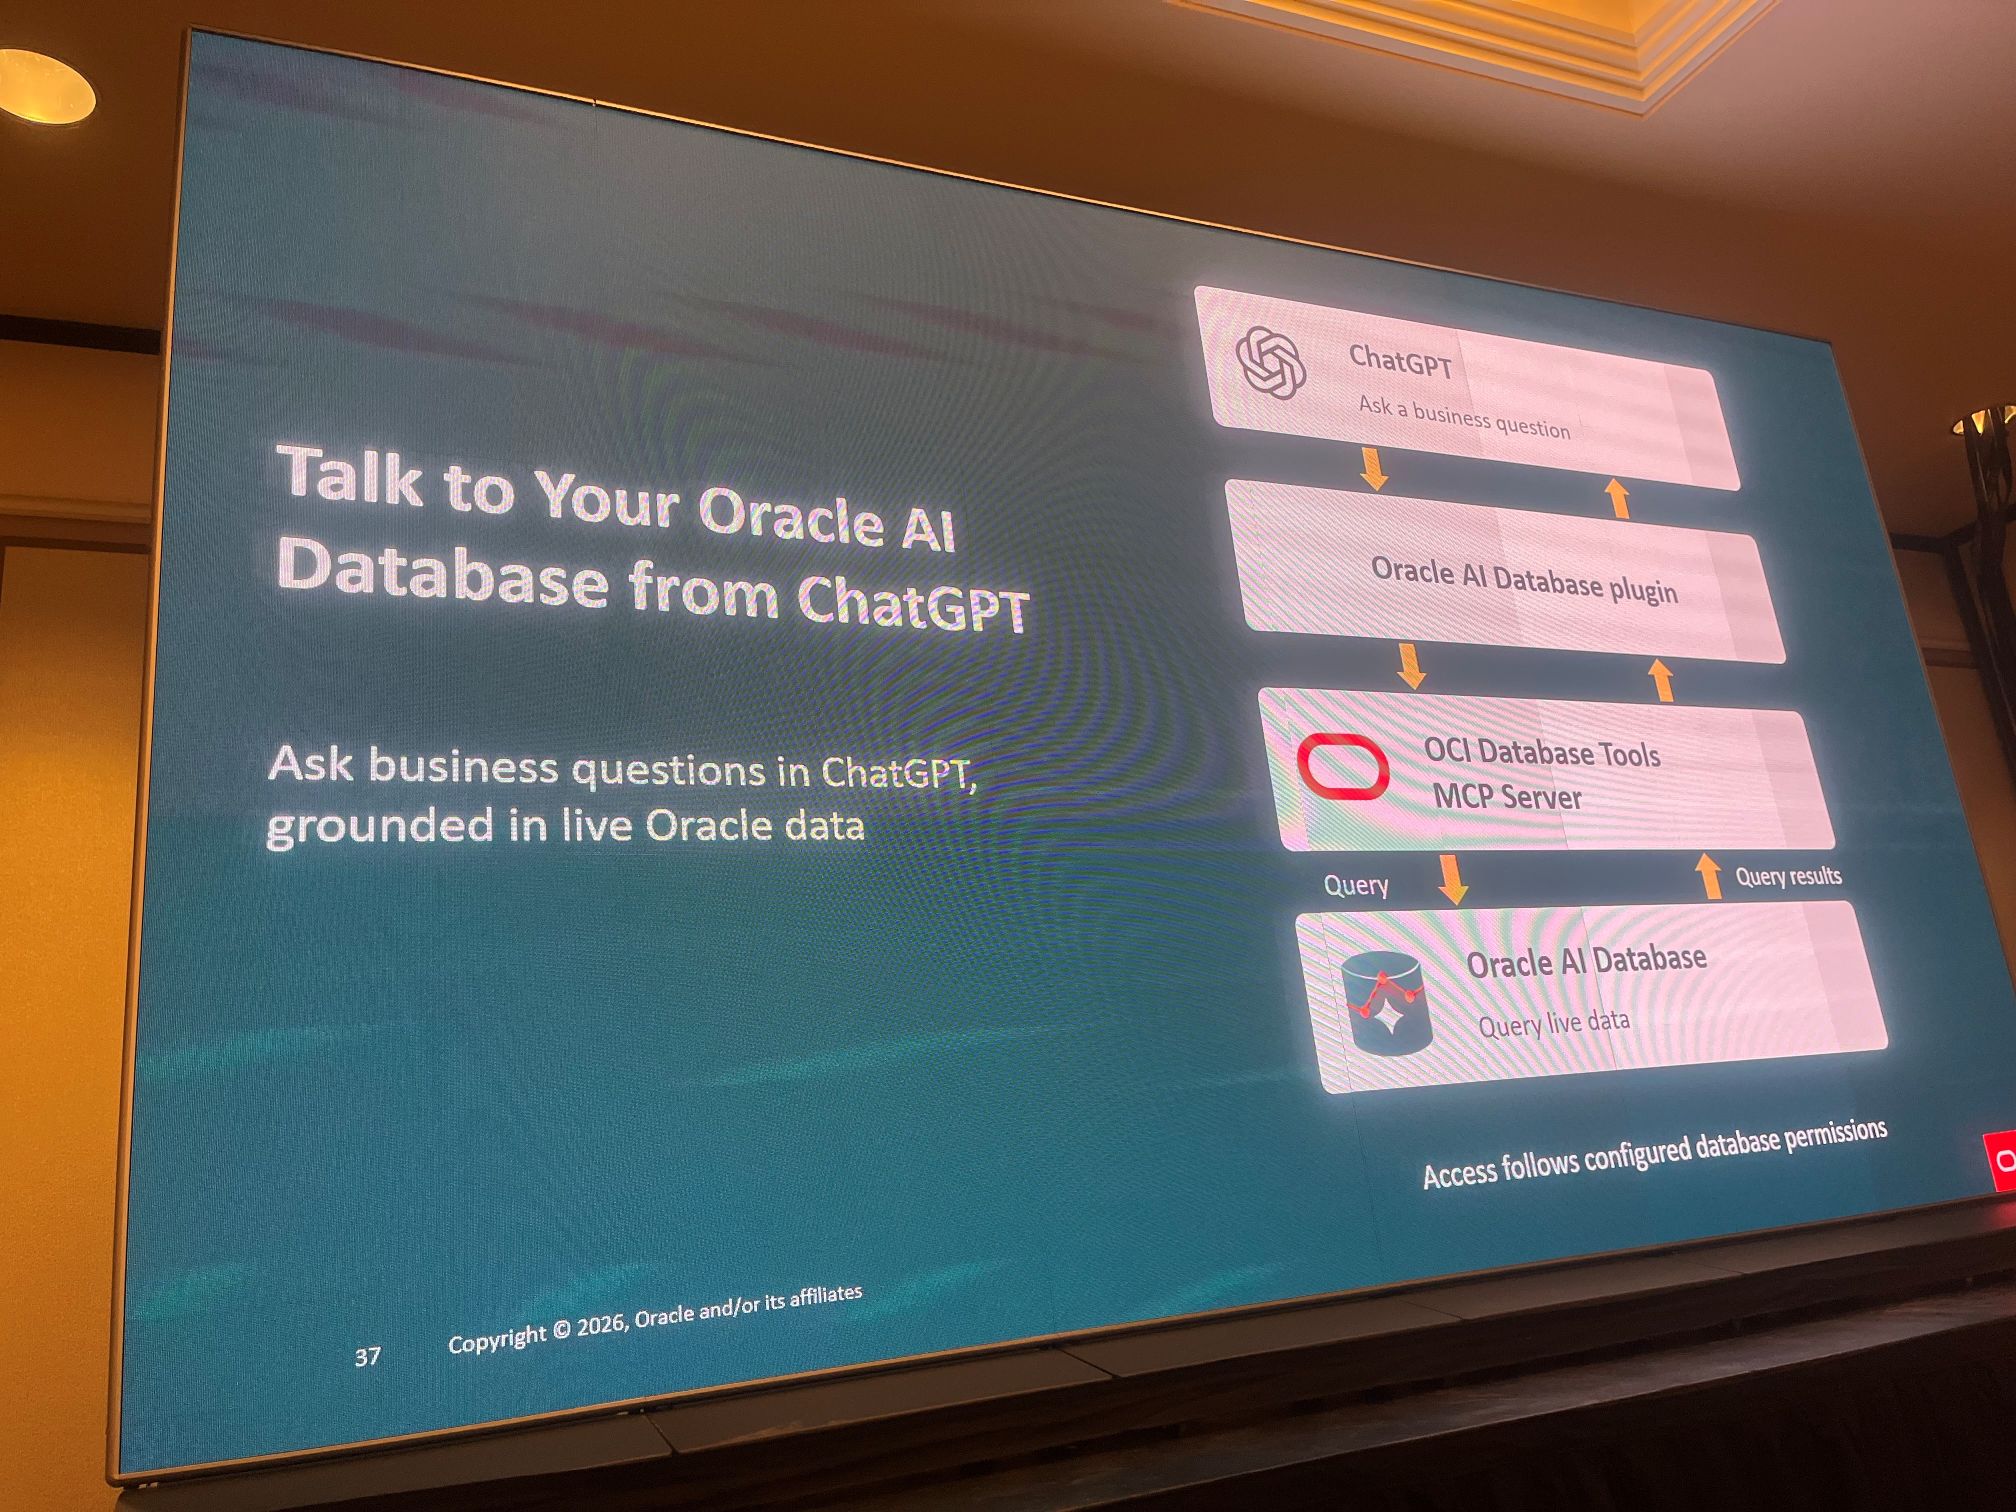
- スライド下部の説明は「Access follows configured database permissions(アクセスはデータベースに設定された権限に従う)」でした。
- セッションでは、ChatGPT のプラグイン画面で「カスタム MCP サーバーを追加」を選び、名前、説明、MCP サーバーの場所を入れるだけでつなげるという操作が見せられました。
Oracle の MCP サーバーの選択肢
- 接続先の MCP サーバーは複数あり、スライドでは次の種類が並んでいました。
- Autonomous AI Database MCP
- ORDS MCP
- MCP Toolkit(AI Full Stack Toolkit。クラウドに依存しない MCP サーバーツール、A2A エージェント、MCP Apps、A2UI フロントエンドを作る、オープンソースのフレームワーク)
- OCI Database Tools MCP(マネージドサービス)
- SQLcl MCP(と VS Code プラグイン)
- Database Navigator Builder で生成したもの
- DB Tools Python
まとめ
どのクラウドの AI からでも、同じ Oracle のデータへ
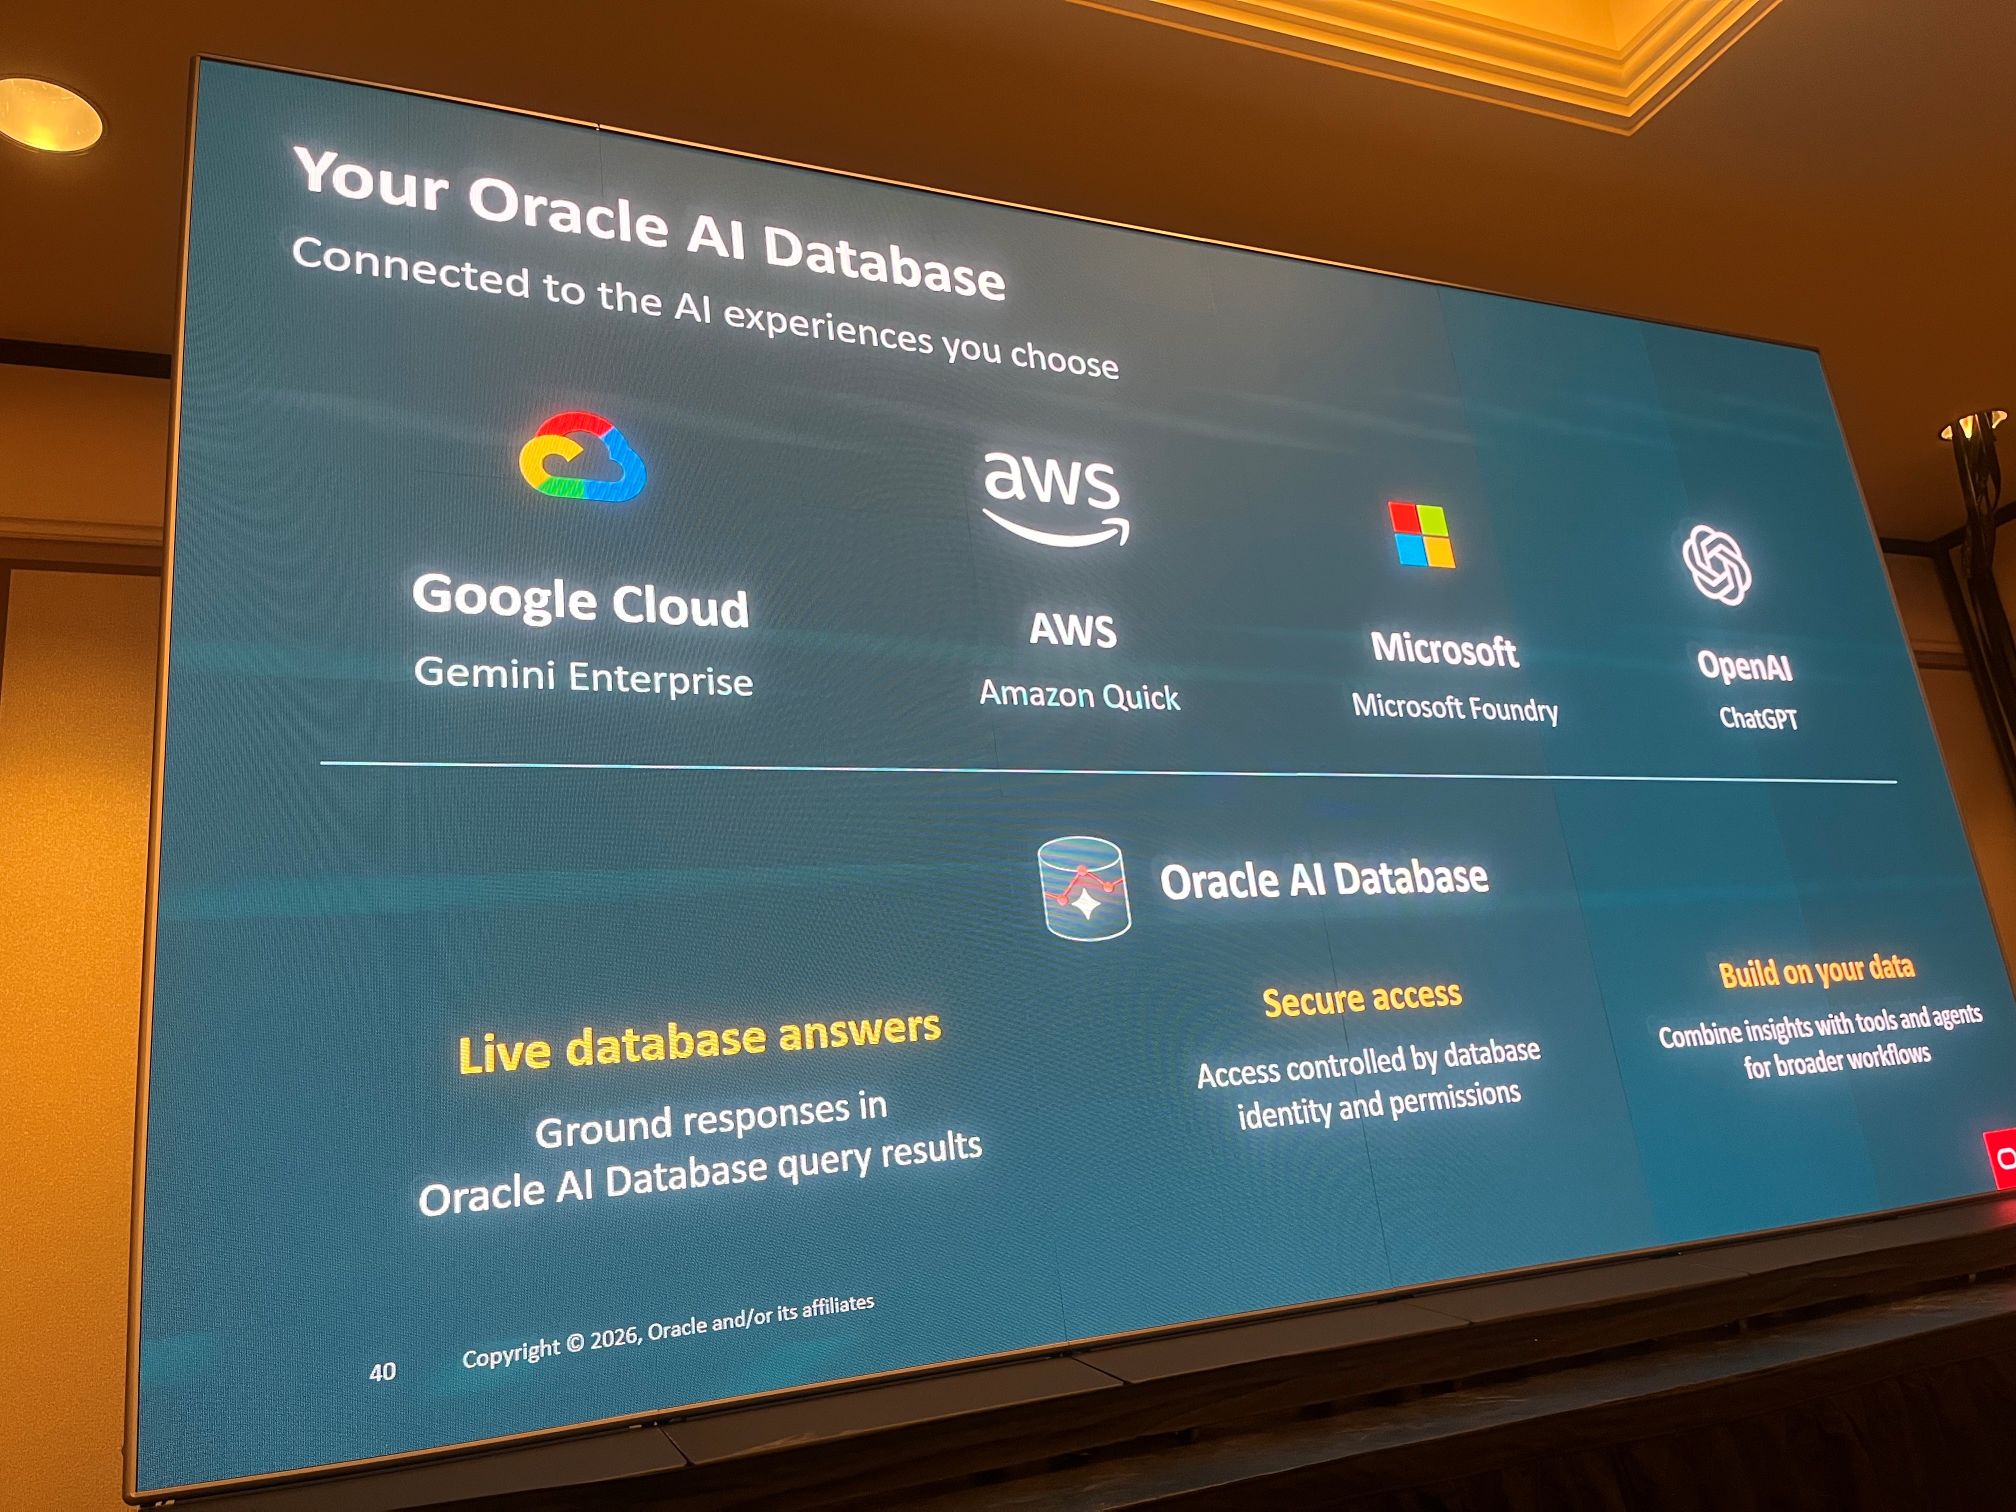
- 最後のスライドでは、Oracle AI Database に接続できる AI 体験として、Google Cloud の Gemini Enterprise、AWS の Amazon Quick、Microsoft の Microsoft Foundry、OpenAI の ChatGPT が並んでいました。共通して示されたのは次の 3 点です。
- Live database answers:Oracle AI Database のクエリ結果に基づいて回答する
- Secure access:データベースの ID と権限でアクセスを制御する
- Build on your data:ツールやエージェントと組み合わせて、広いワークフローを作れる
おわりに
- Oracle AI Database に AI から直接接続できるようになったことで、データベースを使ってできることの幅が大きく広がったと感じました。SQL を書けない人でも、普段使っている AI アシスタントから権限の範囲内で社内データに問い合わせられます。
- また、Oracle だけでなく、Google、AWS、Microsoft、OpenAI の 5 社が同じ場でそれぞれの連携を説明していました。パートナーシップが築かれていること、そして Oracle AI Database が各社から評価されていることがうかがえ、安心して選べる構成だと感じました。
- 一方で、どのデモにも共通していたのは、ID と権限をデータベース側で制御すること、更新系の操作は人の承認を挟むことでした。AI にデータを使わせる際は、この統制の設計が前提になります。まずは小さなスキーマから試して、自分たちの環境でどこまでできるかを確かめていきたいと思います。
 簡単30秒