


TL;DR
- セッション「Unify Intelligence with Federated Data: Introducing Live AI Hub」で、散らばったデータを複製せずに Autonomous AI Database からつなぎ、AI に使わせる Live AI Hub が紹介された。
- Autonomous AI Lakehouse と好きな LLM を組み合わせた構成で、DB リンクや外部テーブルでデータソースにつなぎ、まとめた経路に DB のセキュリティ機能をかける。
- 本記事では、データ統合のレベル感の中での位置づけと、セキュリティの価値を、考察を交えて紹介する。
はじめに
2026 OCI Top Partner Engineers の今井です。
2026年10月25日〜28日にラスベガスで開催された Oracle AI World 2026 に参加した。
本記事では、2026年10月27日 8:00〜8:45(PDT)に行われたセッション「Unify Intelligence with Federated Data: Introducing Live AI Hub」を取り上げる。顧客事例は本記事では扱わない。
AI がデータをフル活用するための課題の1つに、従来のデータ管理から続く「データのサイロ」がある。これを解消し、AI からさまざまなデータに手が届くようにすることが、これからの AI 活用には欠かせない。
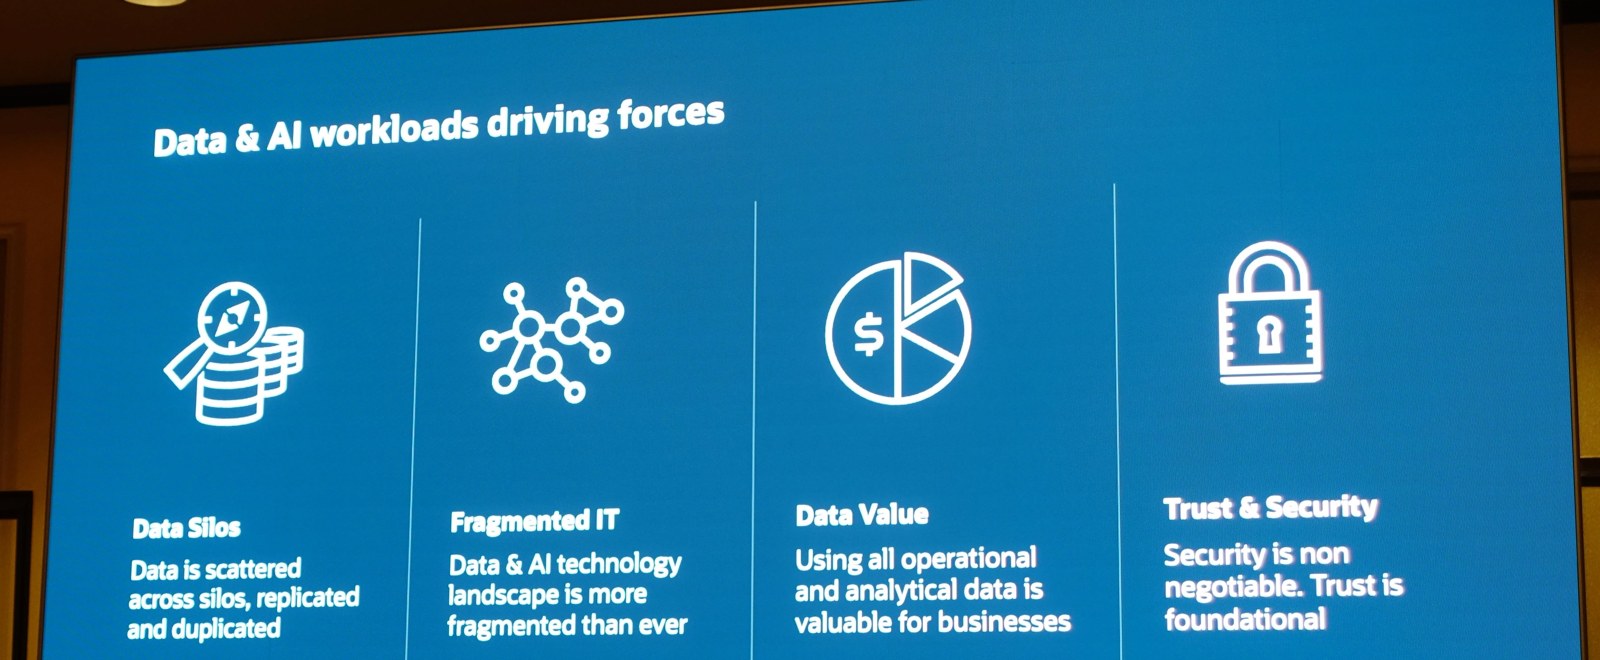
セッションも、データがサイロに散らばり、複製・重複していることを、AI 活用の前提となる課題の1つに挙げた。
Live AI Hub とは?
Live AI Hub は、業務の現場で動いているデータ(運用データ)を含め、さまざまな場所にあるデータを複製せずにつなぎ、エージェント型の AI に使わせる仕組みだ。
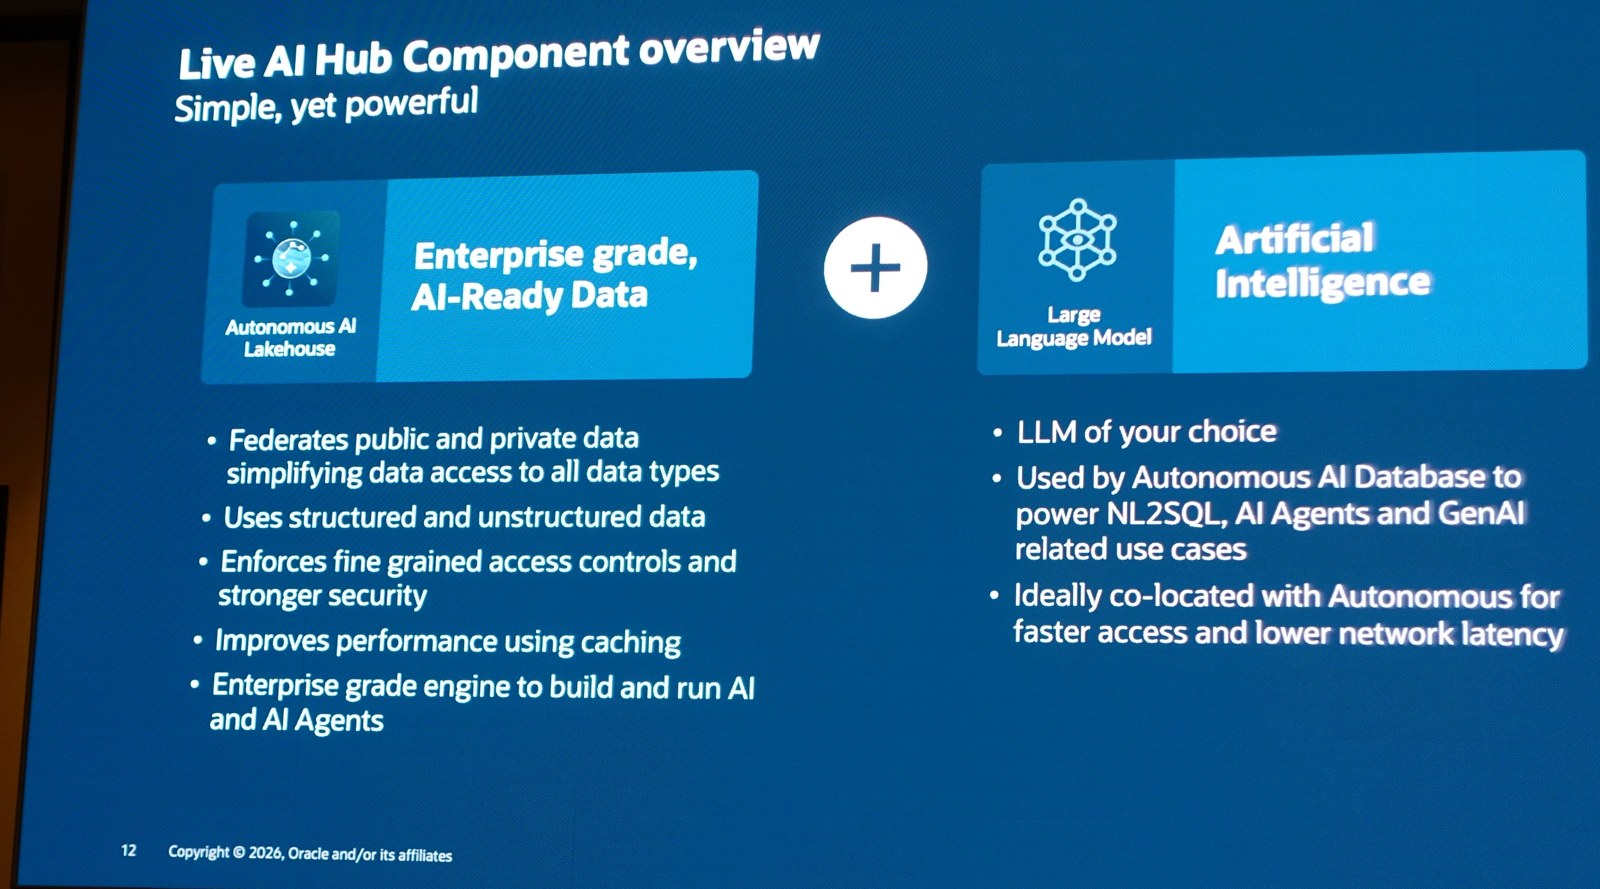
構成要素は、データを担う Autonomous AI Lakehouse と、好きな LLM の2つだ。LLM は Autonomous AI Database が NL2SQL や AI エージェントに使うもので、Autonomous と同じ場所に置くのが望ましいとしている。
登壇者は中核を Autonomous Database とし、別のレイクハウスや小さなウェアハウスは作らず、その場でフェデレーションクエリを実行すると説明した。
Live AI Hub でできること
セッションで紹介された内容を、利用者の目線でまとめると次のとおりだ。
| できること | 中身 |
|---|---|
| データを複製せずに使う | データはその場で問い合わせ、移すのは必要なときだけにする |
| さまざまなデータにつなぐ | SaaS、データベース、データレイク、カタログ、ファイル共有のデータに、OCI 以外のクラウドにあるものも含めてつなぐ |
| OCI 以外でも動かす | Live AI Hub 自体を OCI 以外のクラウドや顧客のデータセンターに置き、その環境の LLM と組み合わせる(組み合わせは次の表) |
| 鮮度に合わせて速くする | データの鮮度の要件に合わせて、マテリアライズド・ビューの自動更新や Lake Cache を使う |
| AI が触れるデータを絞る | SQL Firewall、Database Vault、Deep Data Security、Data Redaction などで、ユーザー・AI・AI エージェントのアクセスを制御する |
置き場所ごとに組み合わせる LLM は、次のとおり紹介された。
| 置き場所 | 組み合わせる LLM |
|---|---|
| OCI | OCI Generative AI |
| Microsoft Azure | Azure OpenAI |
| AWS | Amazon Bedrock |
| Google Cloud | Vertex AI |
| Cloud @ Customer | ローカルまたはリモートの LLM |
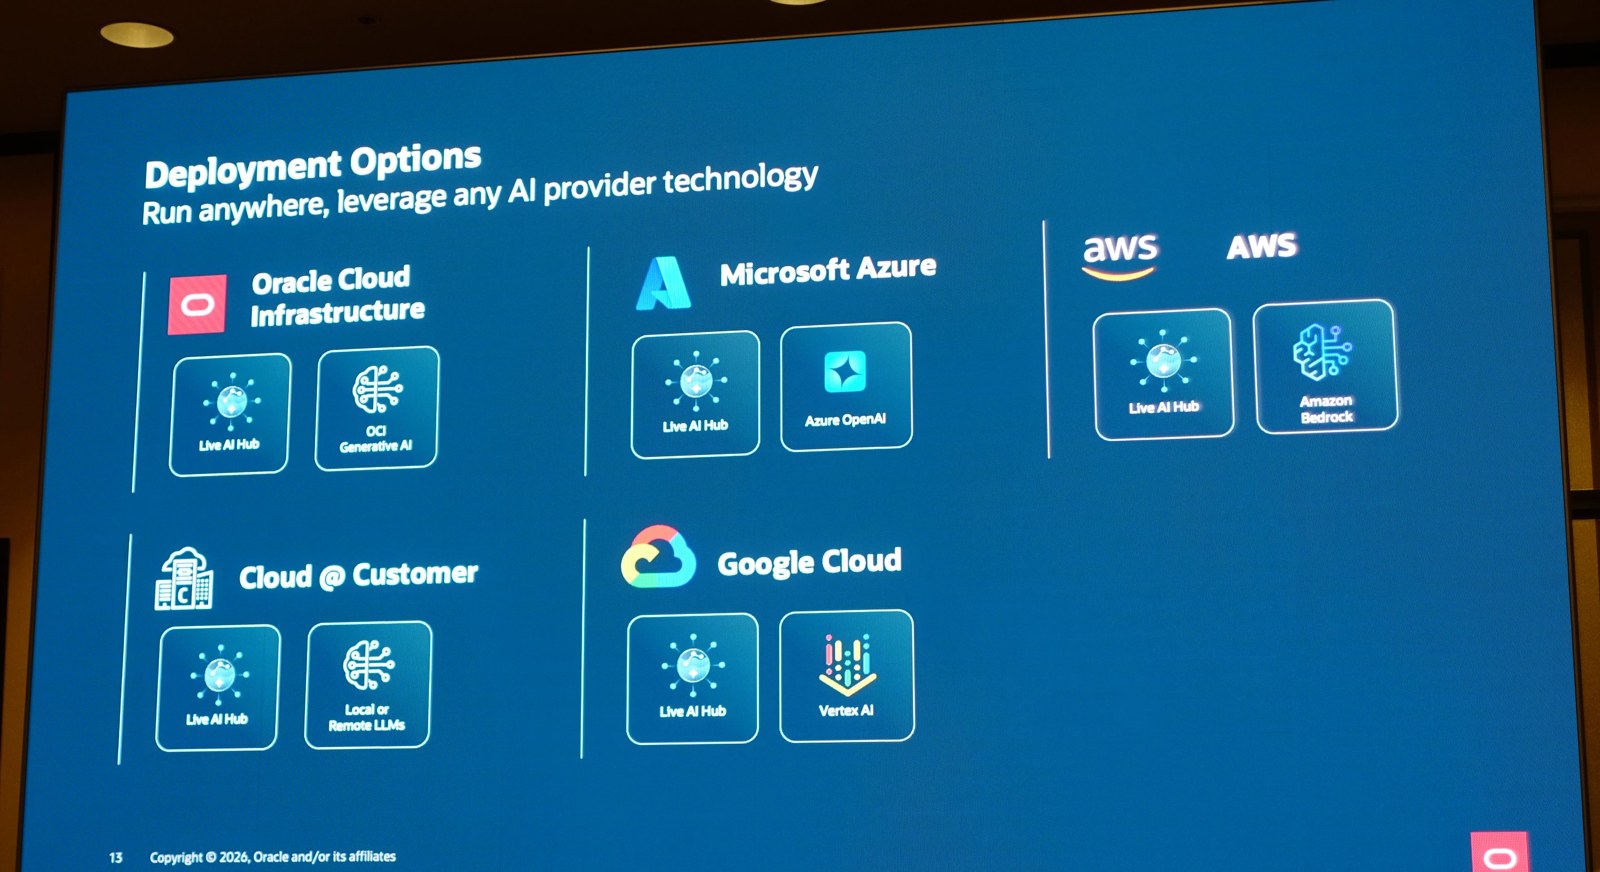
ここで押さえておきたいのは、データを取りに行く先だけでなく、Live AI Hub 自体も OCI 以外に置ける点だ。登壇者は、規制の厳しい業界向けに、顧客のデータセンターやエアギャップの環境に置くこともできると説明した。
発表のポイント
ここからは、私の考察も交えながら、発表のポイントを紹介する。
1. 移行やカタログでの統合を置き換えるものではない
データの統合には、データを1か所に移して集める、従来からの方法がある。物理的に集めずにカタログで統合できる Autonomous AI Lakehouse のようなアーキテクチャも出てきた。 Autonomous AI Lakehouse は、2025年10月に発表されている。
Live AI Hub は、その延長にある。データレイクのような大きなデータから、DB 上の構造化データ、マルチモーダルなファイル・オブジェクト、OCI 以外のクラウドや SaaS まで、形式・プラットフォーム・管理形態の違うデータに AI が届く経路を、文字どおりの Hub として一元的に管理する仕組みだ。
データカタログを完全に整えるにはコストと労力がかかるが、Live AI Hub ならカタログ化されていないデータも含めて手軽につなげる。実装のレベル感としては、その中間にあたる。
セッションでも、移す仕組みは否定されていない。複製はユースケースに応じて例外として行うもので、複製すると遅れが生じるためだと説明された。後述する5段階の最初の段階にも、ZeroETL が必要な場合に OCI GoldenGate を使う選択肢が残されている。
別のセッションでも、Autonomous AI Lakehouse の特徴の1つとして、運用データへのリアルタイムのアクセスを加える機能が挙げられていた。Lakehouse を置き換えるのではなく、その上に組んで、AI とデータのつなぎ目を一本化し、分かりやすくするものだと私は捉えている。
一方で、カタログやメタデータを整える意味がなくなるわけではない。セッションでは、データの意味づけ(セマンティクス)がしっかりしているほど LLM の精度が上がるとされ、Oracle AI Data Catalog が「カタログのカタログ」として紹介された。まずつないで、必要なところからコメントや注釈を足していく進め方ができる。
2. 5段階で組み立て、DB リンクと外部テーブルでつなぐ
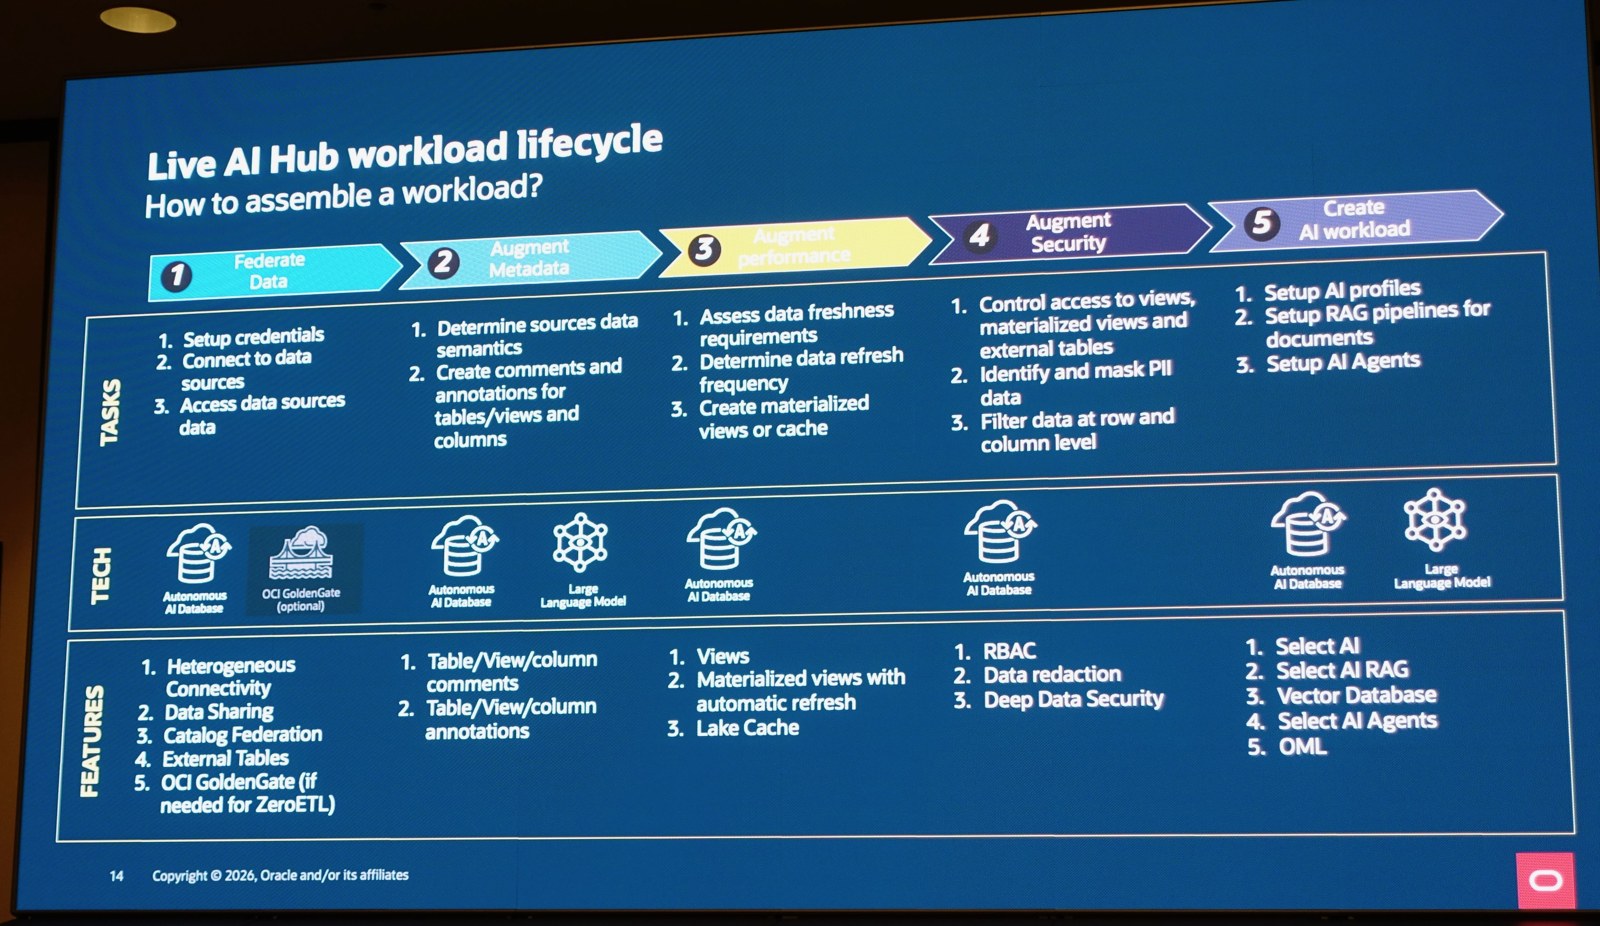
ワークロードの組み立ては、次の5段階で説明された。
| 段階 | やること | 主な機能 |
|---|---|---|
| 1. Federate Data | 認証情報を作り、データソースにつなぐ | Heterogeneous Connectivity、Data Sharing、Catalog Federation、External Tables、OCI GoldenGate(ZeroETL が必要な場合) |
| 2. Augment Metadata | 表・ビュー・列にコメントと注釈を付ける | Table/View/column comments、annotations |
| 3. Augment performance | 鮮度の要件から更新頻度を決め、マテリアライズド・ビューかキャッシュを作る | Views、Materialized views with automatic refresh、Lake Cache |
| 4. Augment Security | ビュー・マテリアライズド・ビュー・外部テーブルへのアクセスを制御し、個人情報をマスクし、行と列で絞る | RBAC、Data redaction、Deep Data Security |
| 5. Create AI workload | AI プロファイル、文書の RAG、AI エージェントを設定する | Select AI、Select AI RAG、Vector Database、Select AI Agents、OML |
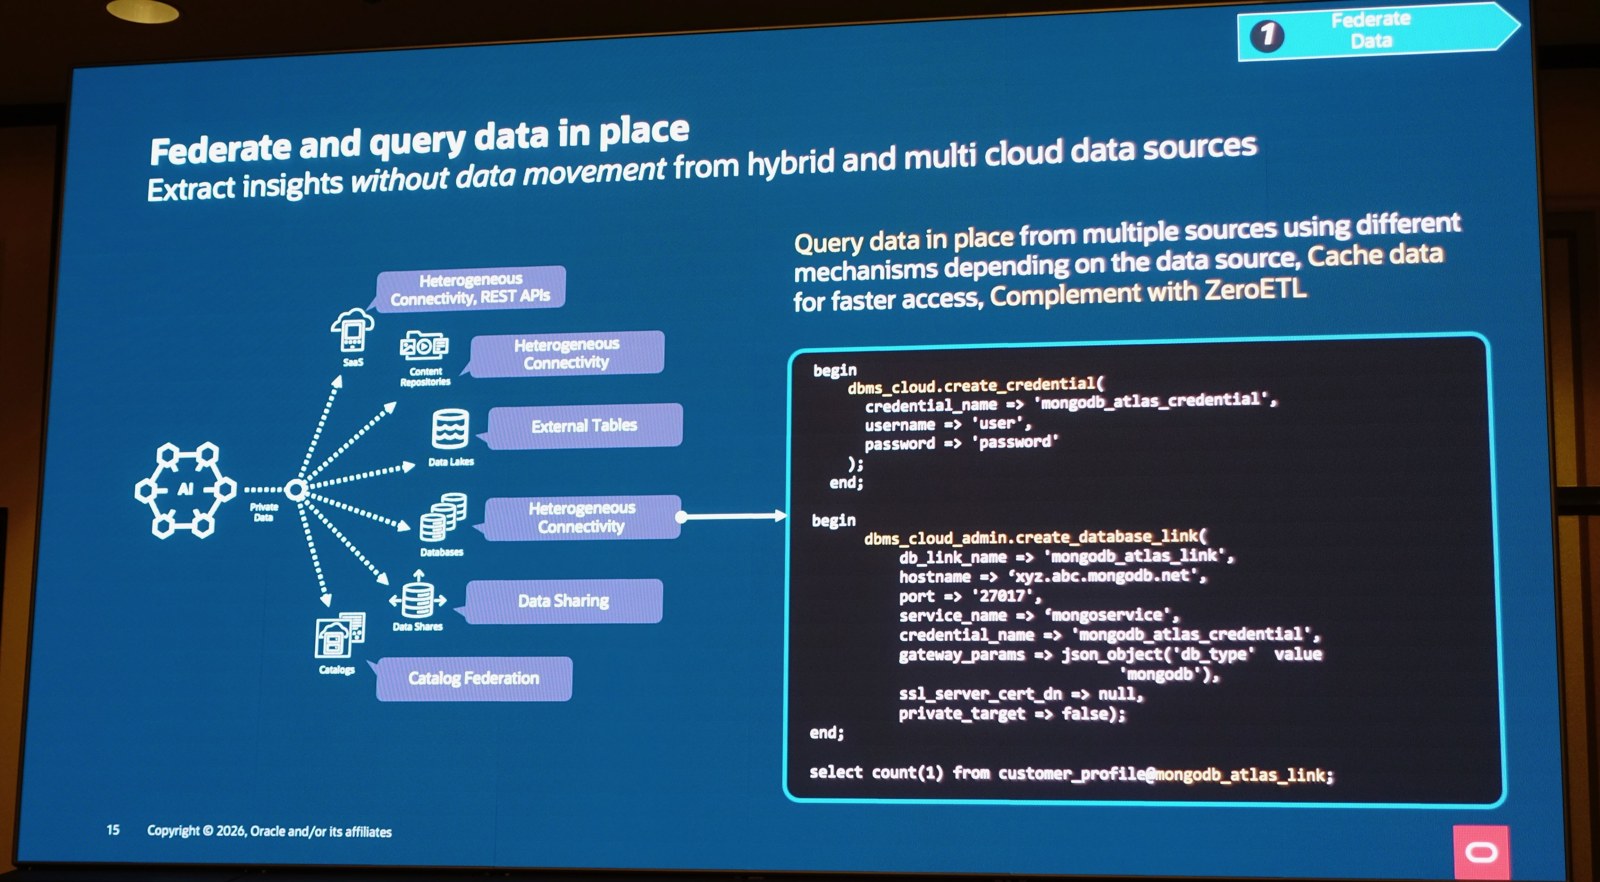
つなぐ部分は、データソースごとに仕組みを使い分ける。他社のデータベースには DB リンク、データレイクには外部テーブル、カタログにはカタログのフェデレーションを使う。
MongoDB Atlas の例では、DBMS_CLOUD.CREATE_CREDENTIAL で認証情報を作り、DBMS_CLOUD_ADMIN.CREATE_DATABASE_LINK の gateway_params に db_type として mongodb を指定してリンクを作る。あとは表名に @mongodb_atlas_link を付けて問い合わせればよい。登壇者は、認証情報とリンクを作る2つの文でつなげると説明した。
DB リンクも外部テーブルも、Oracle Database で以前から使われてきた機能だ。Live AI Hub は、新しい独自の接続方式ではなく、実績のある技術を土台にしている。 Autonomous AI Database から Oracle 以外のデータベースに DB リンクを作る手順は、公式ドキュメントにまとまっている。
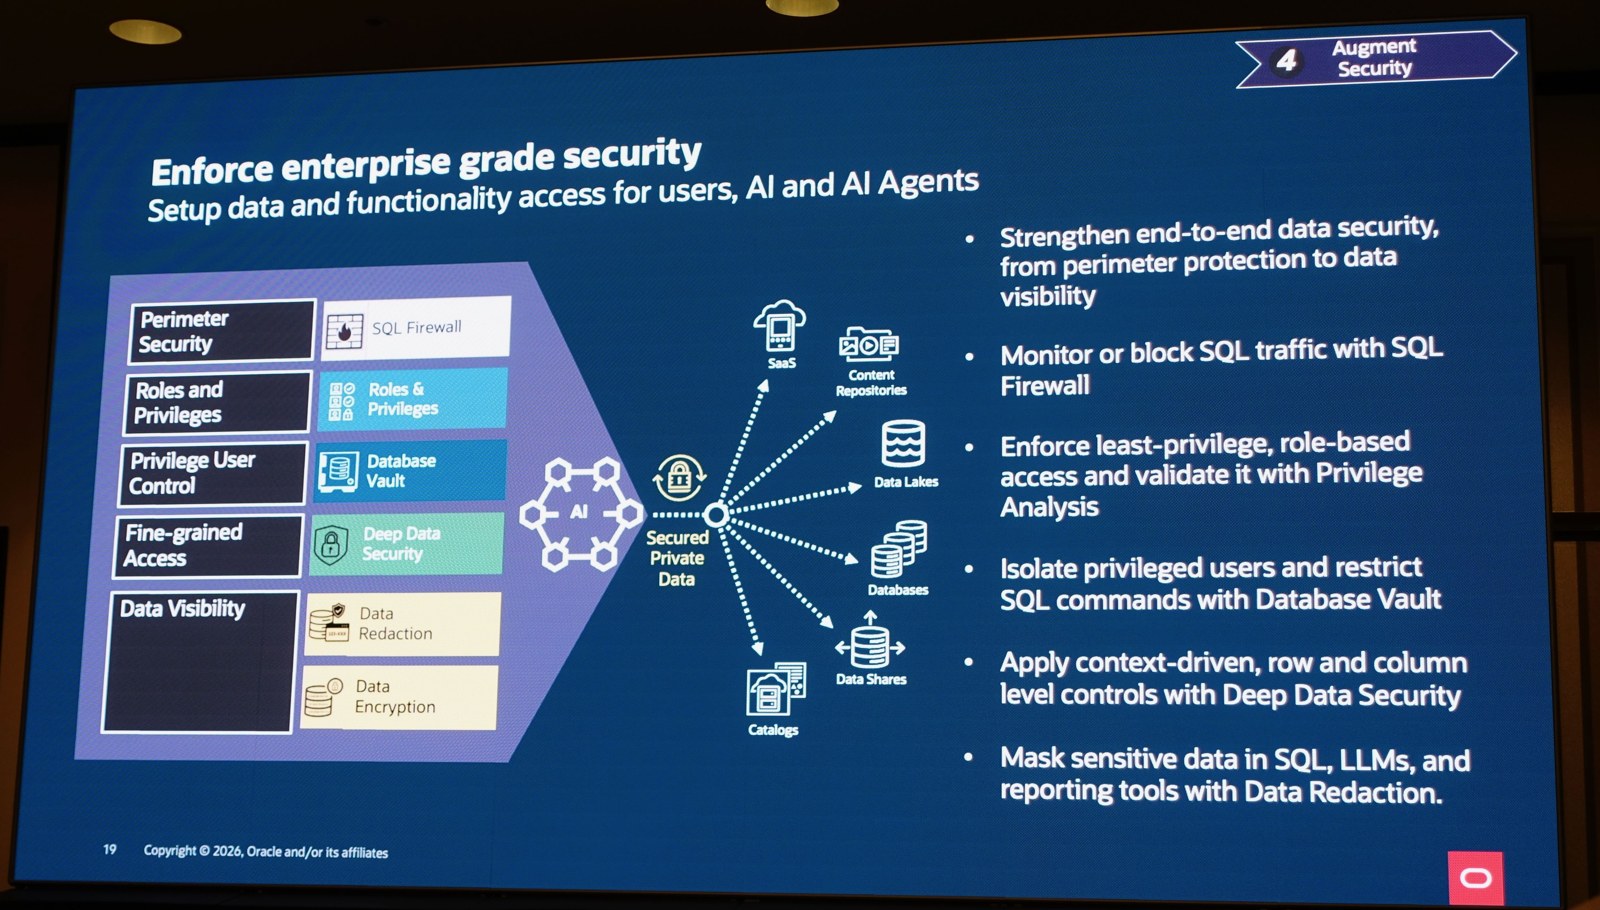
4つめの段階では、DB のセキュリティ機能を、ユーザーだけでなく AI と AI エージェントのアクセスにもかける。登壇者は、エージェントが必要以上のデータに触れないようにして、漏えいの可能性を減らす狙いを説明した。
質疑で登壇者は、アクセスを集約するので、すべてのアクセスが unified auditing に記録され、集約した場所がセキュリティの要所にもなると回答した。
押さえておきたい制約・前提
資料の冒頭には、製品の方向性を示すもので、機能の提供を約束するものではないという注記がある。本記事の内容は発表時点のもので、変更される可能性がある。
Live AI Hub は、Oracle の公式ブログで Autonomous AI Lakehouse の拡張機能の1つとして紹介されており、Autonomous AI Lakehouse がハブになって、つないだ先のシステムにまたがる問い合わせを実行すると説明されている。
提供の時期やリージョンは本記事では扱わない。詳細は公式の情報を確認いただきたい。
考察
私は、Live AI Hub でデータへのアクセスを整流化する本当の価値は、分かりやすさや移行コストの低減だけではないと考える。AI がデータに触れる経路を1か所にまとめることで、その経路に OCI・Autonomous AI Database のエンタープライズグレードのセキュリティを適用できる点だ。
接続先には、Google Drive や Microsoft SharePoint も挙がっていた。たとえば Google Drive 上のスプレッドシートに記録された帳簿データのように、これまでは AI と直接つなぐのが難しいと思われていたデータに手が届くなら、AI を使える場面は大きく広がるのではないか。
AI エージェントに社内のデータを渡すとき、どのデータを、誰の権限で、どこまで見せるかは避けて通れない。経路がデータソースごとに散らばっていると、その確認も散らばる。 まずは AI に使わせたいデータソースを1つ選び、DB リンクでつないだうえで、どの権限で、どの列まで AI に見せるかを確かめるところから始めるとよい。
参考
- Oracle Autonomous AI Lakehouse Enables Open, Interoperable Data Access Across Multi-Platform, Multicloud Environments(Oracle News)
- Oracle Autonomous AI Lakehouseのイノベーションにより、企業全体のデータ資産でAIエージェントを活用(Oracle Blogs)
- Oracle Live AI Hub: AI on live data, wherever it lives(Oracle Blogs)
- Create Database Links to Non-Oracle AI Databases with Oracle-Managed Heterogeneous Connectivity(Oracle Help Center)
 簡単30秒