


TL;DR
- Oracle AI Database の Deep NL2SQL は、自然言語の質問に答えるために必要な「業務の知識」と「データの知識」を、人が AI の支援を受けて用意し、改善し続ける仕組みだ。
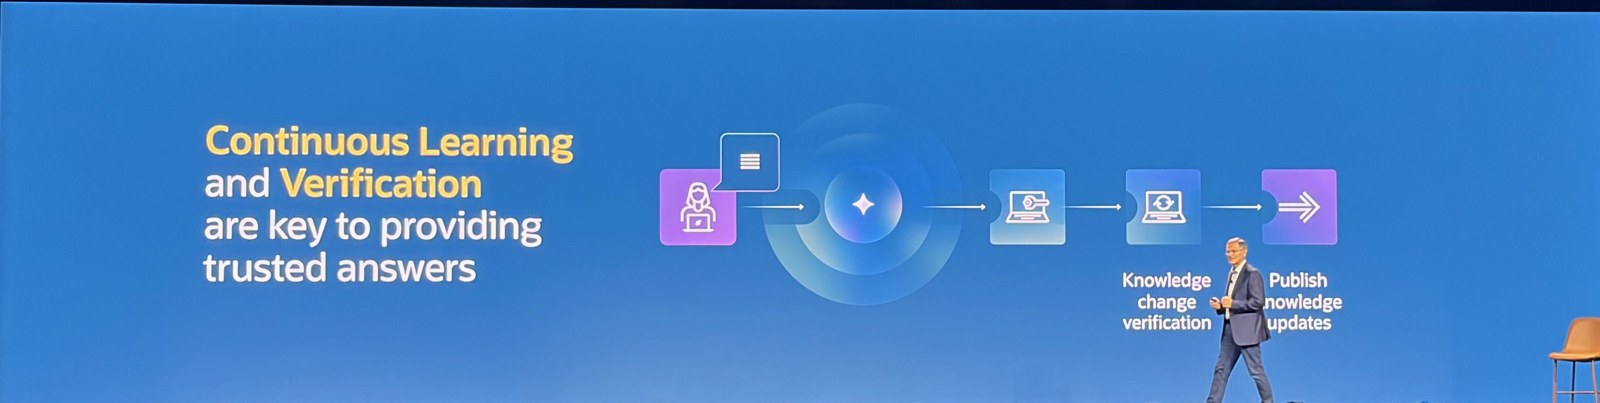
- 今年の違いとして紹介されたのは、誤答へのフィードバックで知識の元を直す Continuous Feedback Learning と、その修正がほかの答えを壊していないかを確かめる Knowledge change verification だ。
- デモは Oracle AI Database Private Agent Factory の画面で行われた。本記事では、デモの流れを中心に紹介する。
はじめに
OCI Top Partner Engineers 2026 の今井です。
2026年10月25日〜28日にラスベガスで開催された Oracle AI World 2026 に参加した。 本記事では、セッション「AI Can Build It, But Can You Trust It? Data Is the Key」のうち、Deep NL2SQL を扱った部分を取り上げる。
Deep NL2SQL とは?
自然言語の質問はあいまいさを含むため、答えを完全には信頼できず、AI の誤解と誤りを減らすことが目標になる、と登壇者は説明した。
そのために AI に必要なのが、業務の知識(business knowledge)とデータの知識(data knowledge)だ。Deep NL2SQL は、この知識を人が AI の支援を受けて用意し、改善し続ける工程を自動化するものとして紹介された。
Deep NL2SQL でできること
| できること | 中身 |
|---|---|
| 誤答へのフィードバックで、知識の元を直す | 利用者のフィードバックが知識の担当者に届き、担当者が AI エージェントの支援を受けて原因を突き止め、知識ベースを直す(Continuous Feedback Learning) |
| 知識を変えたら、これまでの正解で確かめてから公開する | 以前に正しかった答えを再確認し、劣化があれば直す(Knowledge change verification) |
| あいまいな言葉は推測せずに聞き返す | 「よく売れた」が数量か売上かを利用者に確認する |
| 業務の知識を business topic ごとに持たせる | 用語の意味・ルールと、答えに使うデータを topic ごとに決める |
| データの知識をデータベース(DB)に持たせる | SQL Annotations と Analytic Views で、データの意味と使い方を DB に書く |
登壇者は、フィードバックによる学習と知識変更の検証を Deep NL2SQL に組み込んだことが今年の違いだと述べた。表の上の2行が、今回の新しい点にあたる。
ここで重要なのは、知識はモデルが勝手に覚えるのではなく、人が用意して直すという点だ。 登壇者は、知識は人から来るもので、AI が間違えるたびに人が直す必要があると説明した。
発表のポイント
1. 業務の言葉の意味を business topic に書いておく
業務の知識は、製品・顧客・サービスのような business topic ごとに整理し、topic ごとに文脈、用語とルール、関係するデータを持たせる。
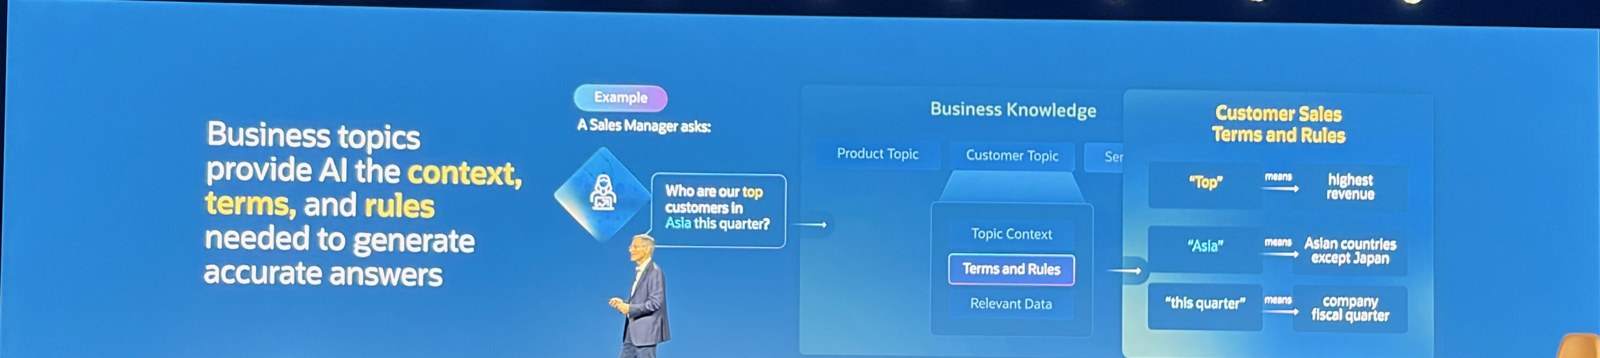
例として挙がったのは、営業マネージャーの「今四半期のアジアの上位顧客は?」という質問だ。この会社では、「上位」は売上が最も高いこと、「アジア」は日本を除くアジアの国、「今四半期」は会社の会計四半期を指す。日本が別の事業部門だという社内の事情を知らなければ、AI の答えは必ず間違える、と登壇者は述べた。
business topic は、答えに使うデータも決める。顧客の topic なら、顧客・注文・地域・明細のデータだ。
2. 列の意味を SQL Annotations で DB に書いておく
データの知識は、データが何を意味し、どう整理されていて、どう使えばよいかを説明するものだ。
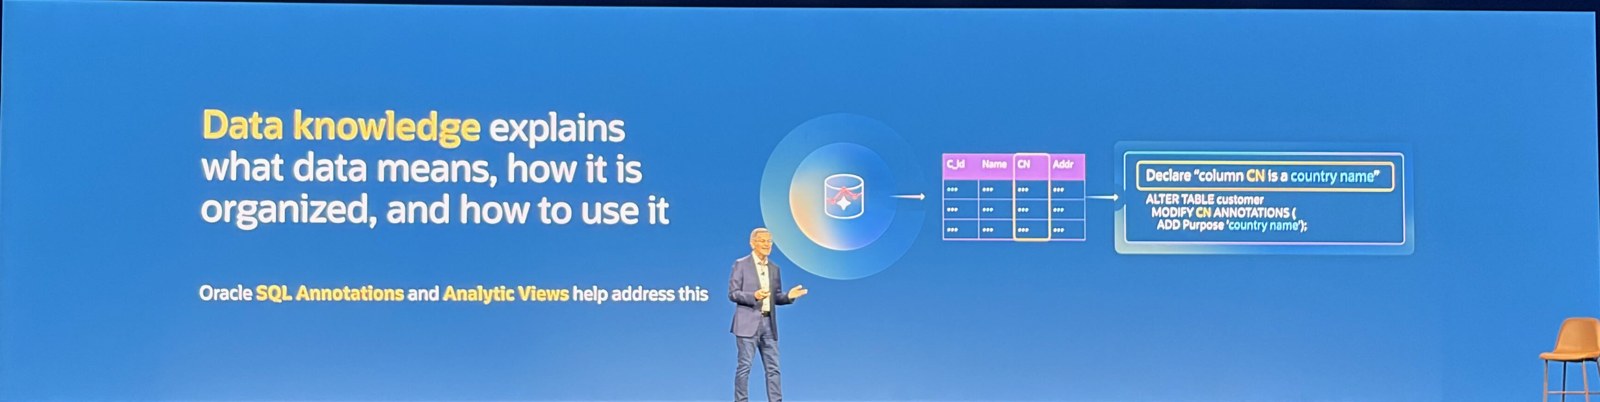
例では、CN という分かりにくい列名が国名を表すことを、ALTER TABLE で注釈として付けていた。
ALTER TABLE customer
  MODIFY CN ANNOTATIONS ( ADD Purpose 'country name');
もう1つの方法が Analytic Views で、ディメンション・ファクト・メジャー・階層についての知識と、それらへの簡単なアクセスを提供する。登壇者は、この2つを DB にデータの知識を足す新しい方法と呼び、ほかにオントロジーやグラフ、コメントなども挙げた。
3. デモ1 聞き返しと返品を除いた再計算
1本目のデモは、商品の品ぞろえを計画する担当者が「Labor Day 以降、ネバダ州で一番売れた感謝祭の飾りは?」と尋ねるところから始まった。
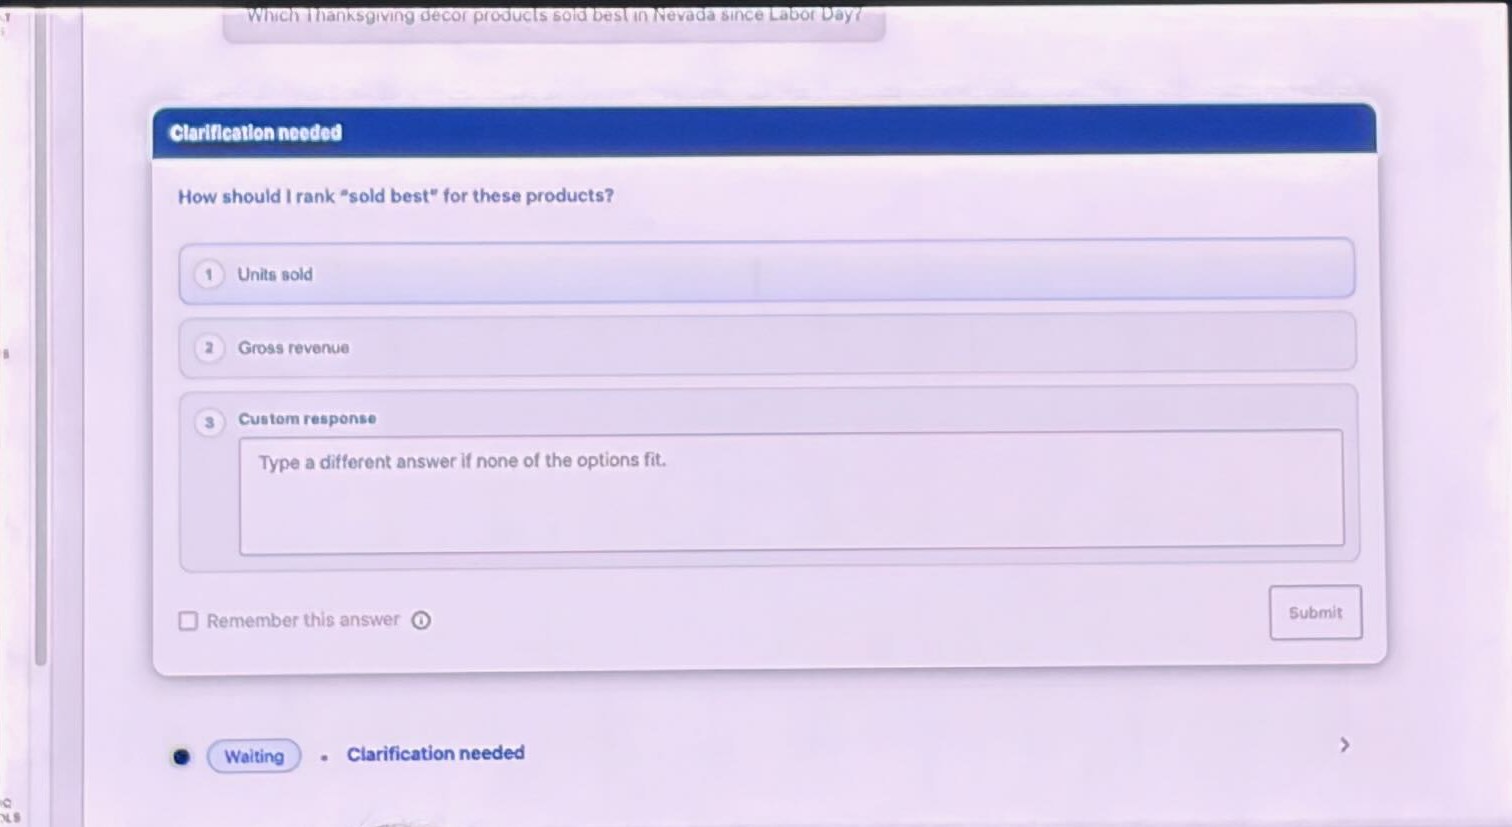
エージェントは「sold best」をあいまいと判定し、数量と総売上のどちらで順位を付けるかを聞き返した。担当者が総売上を選ぶと、Harvest Wreath が1位になった。
数字が高すぎると感じた担当者が返品を除いたかを尋ねると、エージェントは総売上が返品を差し引いていなかったことを見つけ、計算し直した。
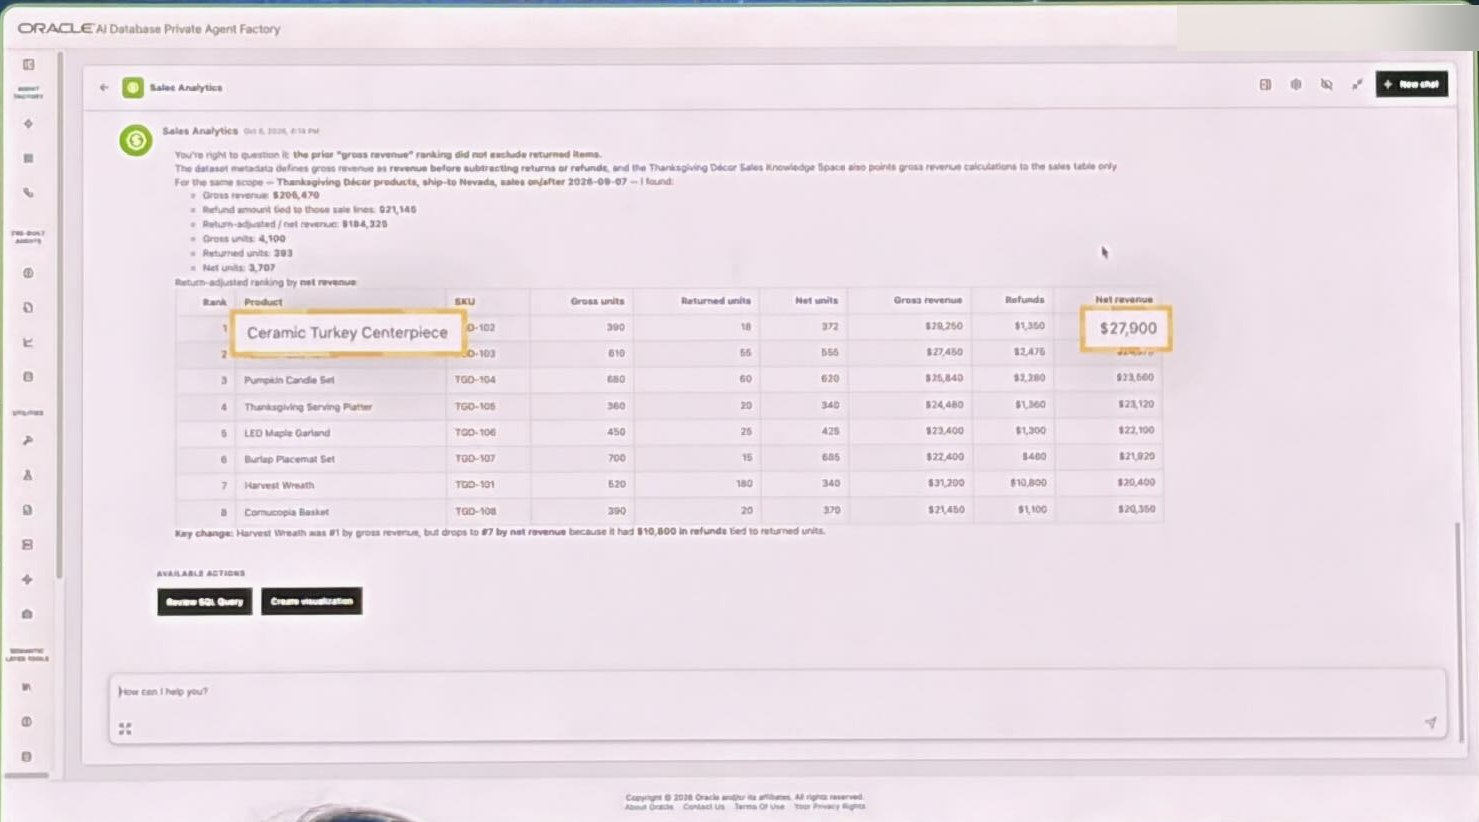
計算し直すと Ceramic Turkey Centerpiece が1位になり、Harvest Wreath は7位に下がった。
担当者は、会社の売上の定義はほかの利用者にも役立つ知識だとして、この1件の答えを直すだけでなく、組み込みのフィードバックの仕組みで修正を記録した。
4. デモ2 知識の修正と検証
2本目のデモでは、このフィードバックが一覧に届いていた。
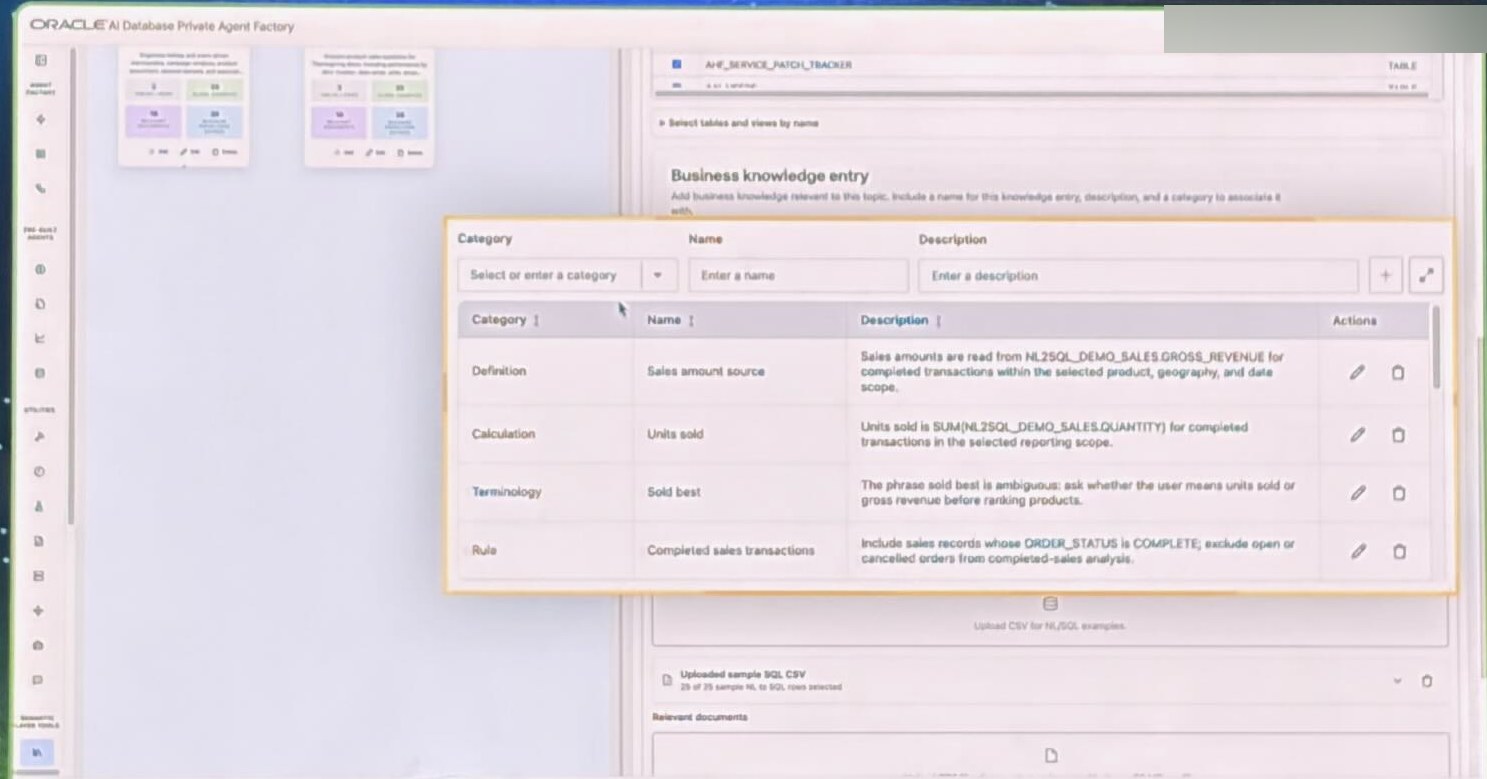
画面は Business Knowledge Graph で、テーブルやビュー、業務の知識の項目などをまとめて持っている。業務の知識は、定義・計算・用語・ルールの分類で登録されていた。用語の項目には、「sold best」はあいまいなので、順位を付ける前に数量か総売上かを聞く、という定義があった。
1本目のデモの聞き返しは、この知識によるものだと考えられる。
知識を編集すると未公開の状態になり、公開の前に検証用の質問で評価を走らせるよう求められる。
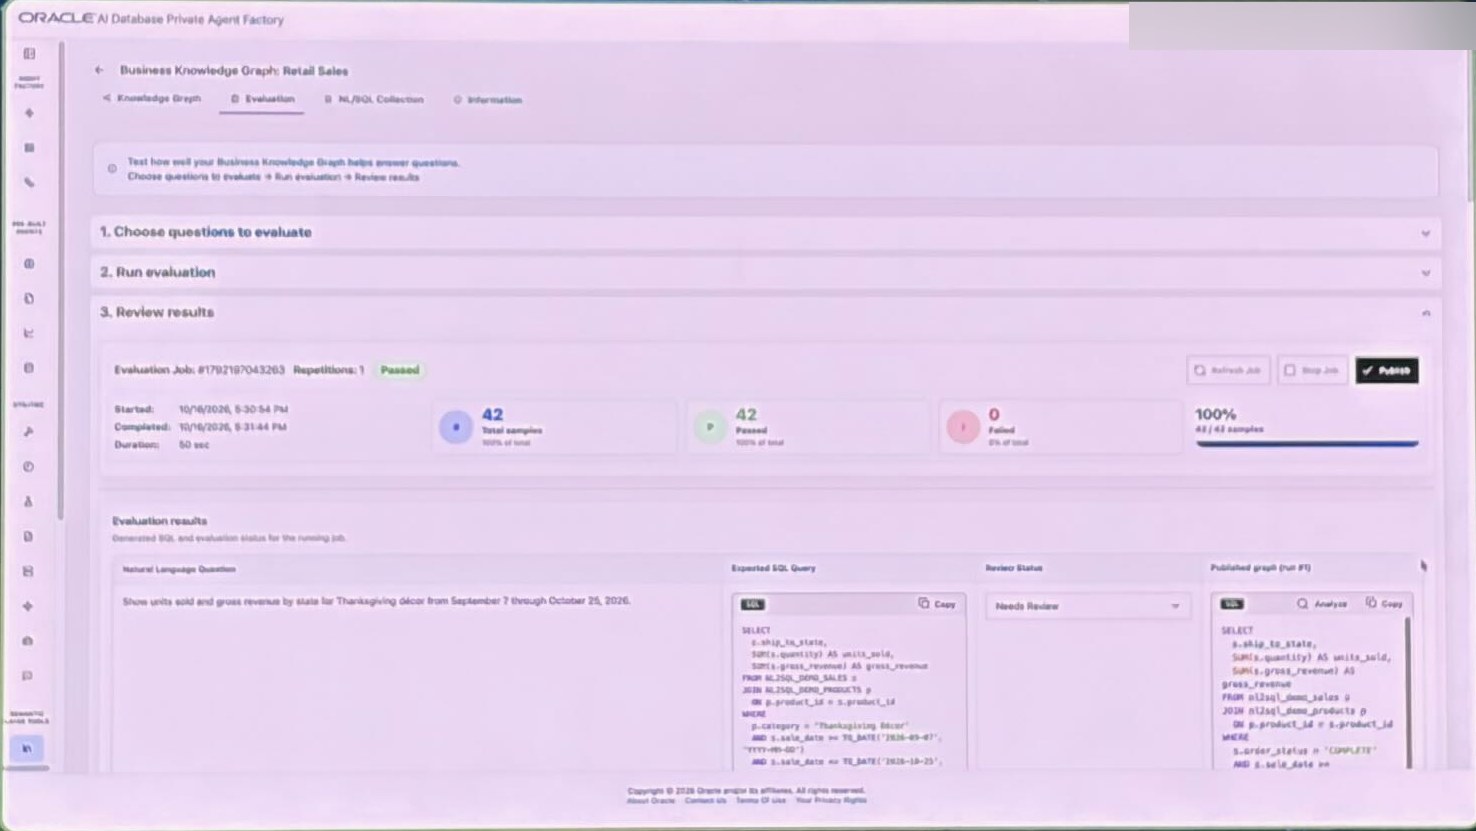
デモでは42件の質問すべてが合格し、更新を本番に出せる状態になった。登壇者は、1つの答えを直すための知識の変更が、ほかの質問の答えを壊さないようにする必要があると説明していた。
押さえておきたい制約・前提
セッションでは、Deep NL2SQL を使うのに必要な製品やバージョン、提供状況は個別には説明されなかった。デモは Private Agent Factory の画面で行われた。
会期中の2026年10月26日に公開された Oracle の公式ブログでは、Oracle AI Database Private Agent Factory 26.10 のリリースで Deep NL2SQL が加わったと発表している。公式ブログによると、Deep NL2SQL は Business Knowledge Graph を使い、関係するテーブル、業務の定義、指標、ルール、文書、質問と SQL の例を topic ごとに整理する。知識の変更を、代表的な質問と参照用の SQL で評価してから公開する評価のワークフローも挙げている。セッションのデモで見た流れは、この発表の内容と重なる。
ダウンロードページには、Linux(x86-64 と ARM)と Mac 向けの 26.10 のインストーラーが、2026年10月26日にリリースされたものとして掲載されている。一方、公式ブログには、対応する Oracle AI Database のバージョンなどの前提条件は書かれていない。試す前に、製品ドキュメントの 26.10 のページで前提条件と導入方法を確認いただきたい。
ユースケースの考察
たとえば「最近3か月の売上推移」という質問も、「最近3か月」が暦の月か会計期間か、「売上」に返品や値引きを含むかで、答えが変わる。言葉の意味を知らない AI は、正しく動く SQL で、間違った答えを返してしまう。
登壇者は、業務の知識とデータの知識を用意して改善し続けることが、データの専門家や DBA にとってますます重要な仕事になると述べた。講演の最後にも、AI に業務とデータの知識を与えることを、欠かせないものとして挙げていた。
私は、この「意味」の情報こそが、これからの AI のデータ活用の土台になると考えている。 モデルやツールは次々に新しくなるが、列の注釈、業務の言葉の定義、正解の分かっている質問は、DB の側に残り、次の仕組みにも持ち越せる。
だからこそ、早い段階で整理しておいた組織ほど、新しい AI の機能が出たときに、すぐに自社のデータで試し、業務に載せられる。意味の整理は後回しにしがちな地味な作業だが、AI の活用の速さを左右する先行投資になる。
まずは「売上」「上位」「今期」のように、よく使う業務の言葉の定義を洗い出し、正解の分かっている質問を検証用に集めるところから始めるとよい。
 簡単30秒