


クラウドインテグレーション事業部の片山です。
2026年10月26日〜28日(現地時間)にラスベガスで開催されたイベント、Oracle AI World 2026に今年も現地参加してきました!
今回は帰国後の後追いレポートとして、「Agents Need Infrastructure Too: Building the Backbone for Agentic AI」というセッションの内容をお届けします。
セッション表紙スライド「Agents Need Infrastructure Too — Building the Backbone for Agentic AI」
セッション概要
AIエージェントを本番で動かすとき、インフラのどこがボトルネックになるのかを、Oracle・NVIDIA・Daytonaの3社が解説した45分のLearning Sessionです。前日の10月27日にOCIでNVIDIA Vera CPUの一般提供(GA)が発表されたばかりで、その中身と使いどころを説明する、インフラ寄りの技術セッションでした。
登壇者は、OracleからSanjay Basu氏(Senior Director, AI Infrastructure & Quantum Apps, OCI)、NVIDIAからHannah Coutand氏(Director, Product Marketing, CPU)、DaytonaからJosh Chang氏(Chief Revenue Officer)の3名でした。
Oracleが検証とリファレンス構成、NVIDIAがCPUの設計思想、Daytonaが実際のサービスでの使われ方を語るという、3社の役割分担がはっきりした構成でした。
セッション内容:エージェントの実行基盤をCPUに、推論をGPUに分ける
エージェントの仕事の大半はCPUで動いている
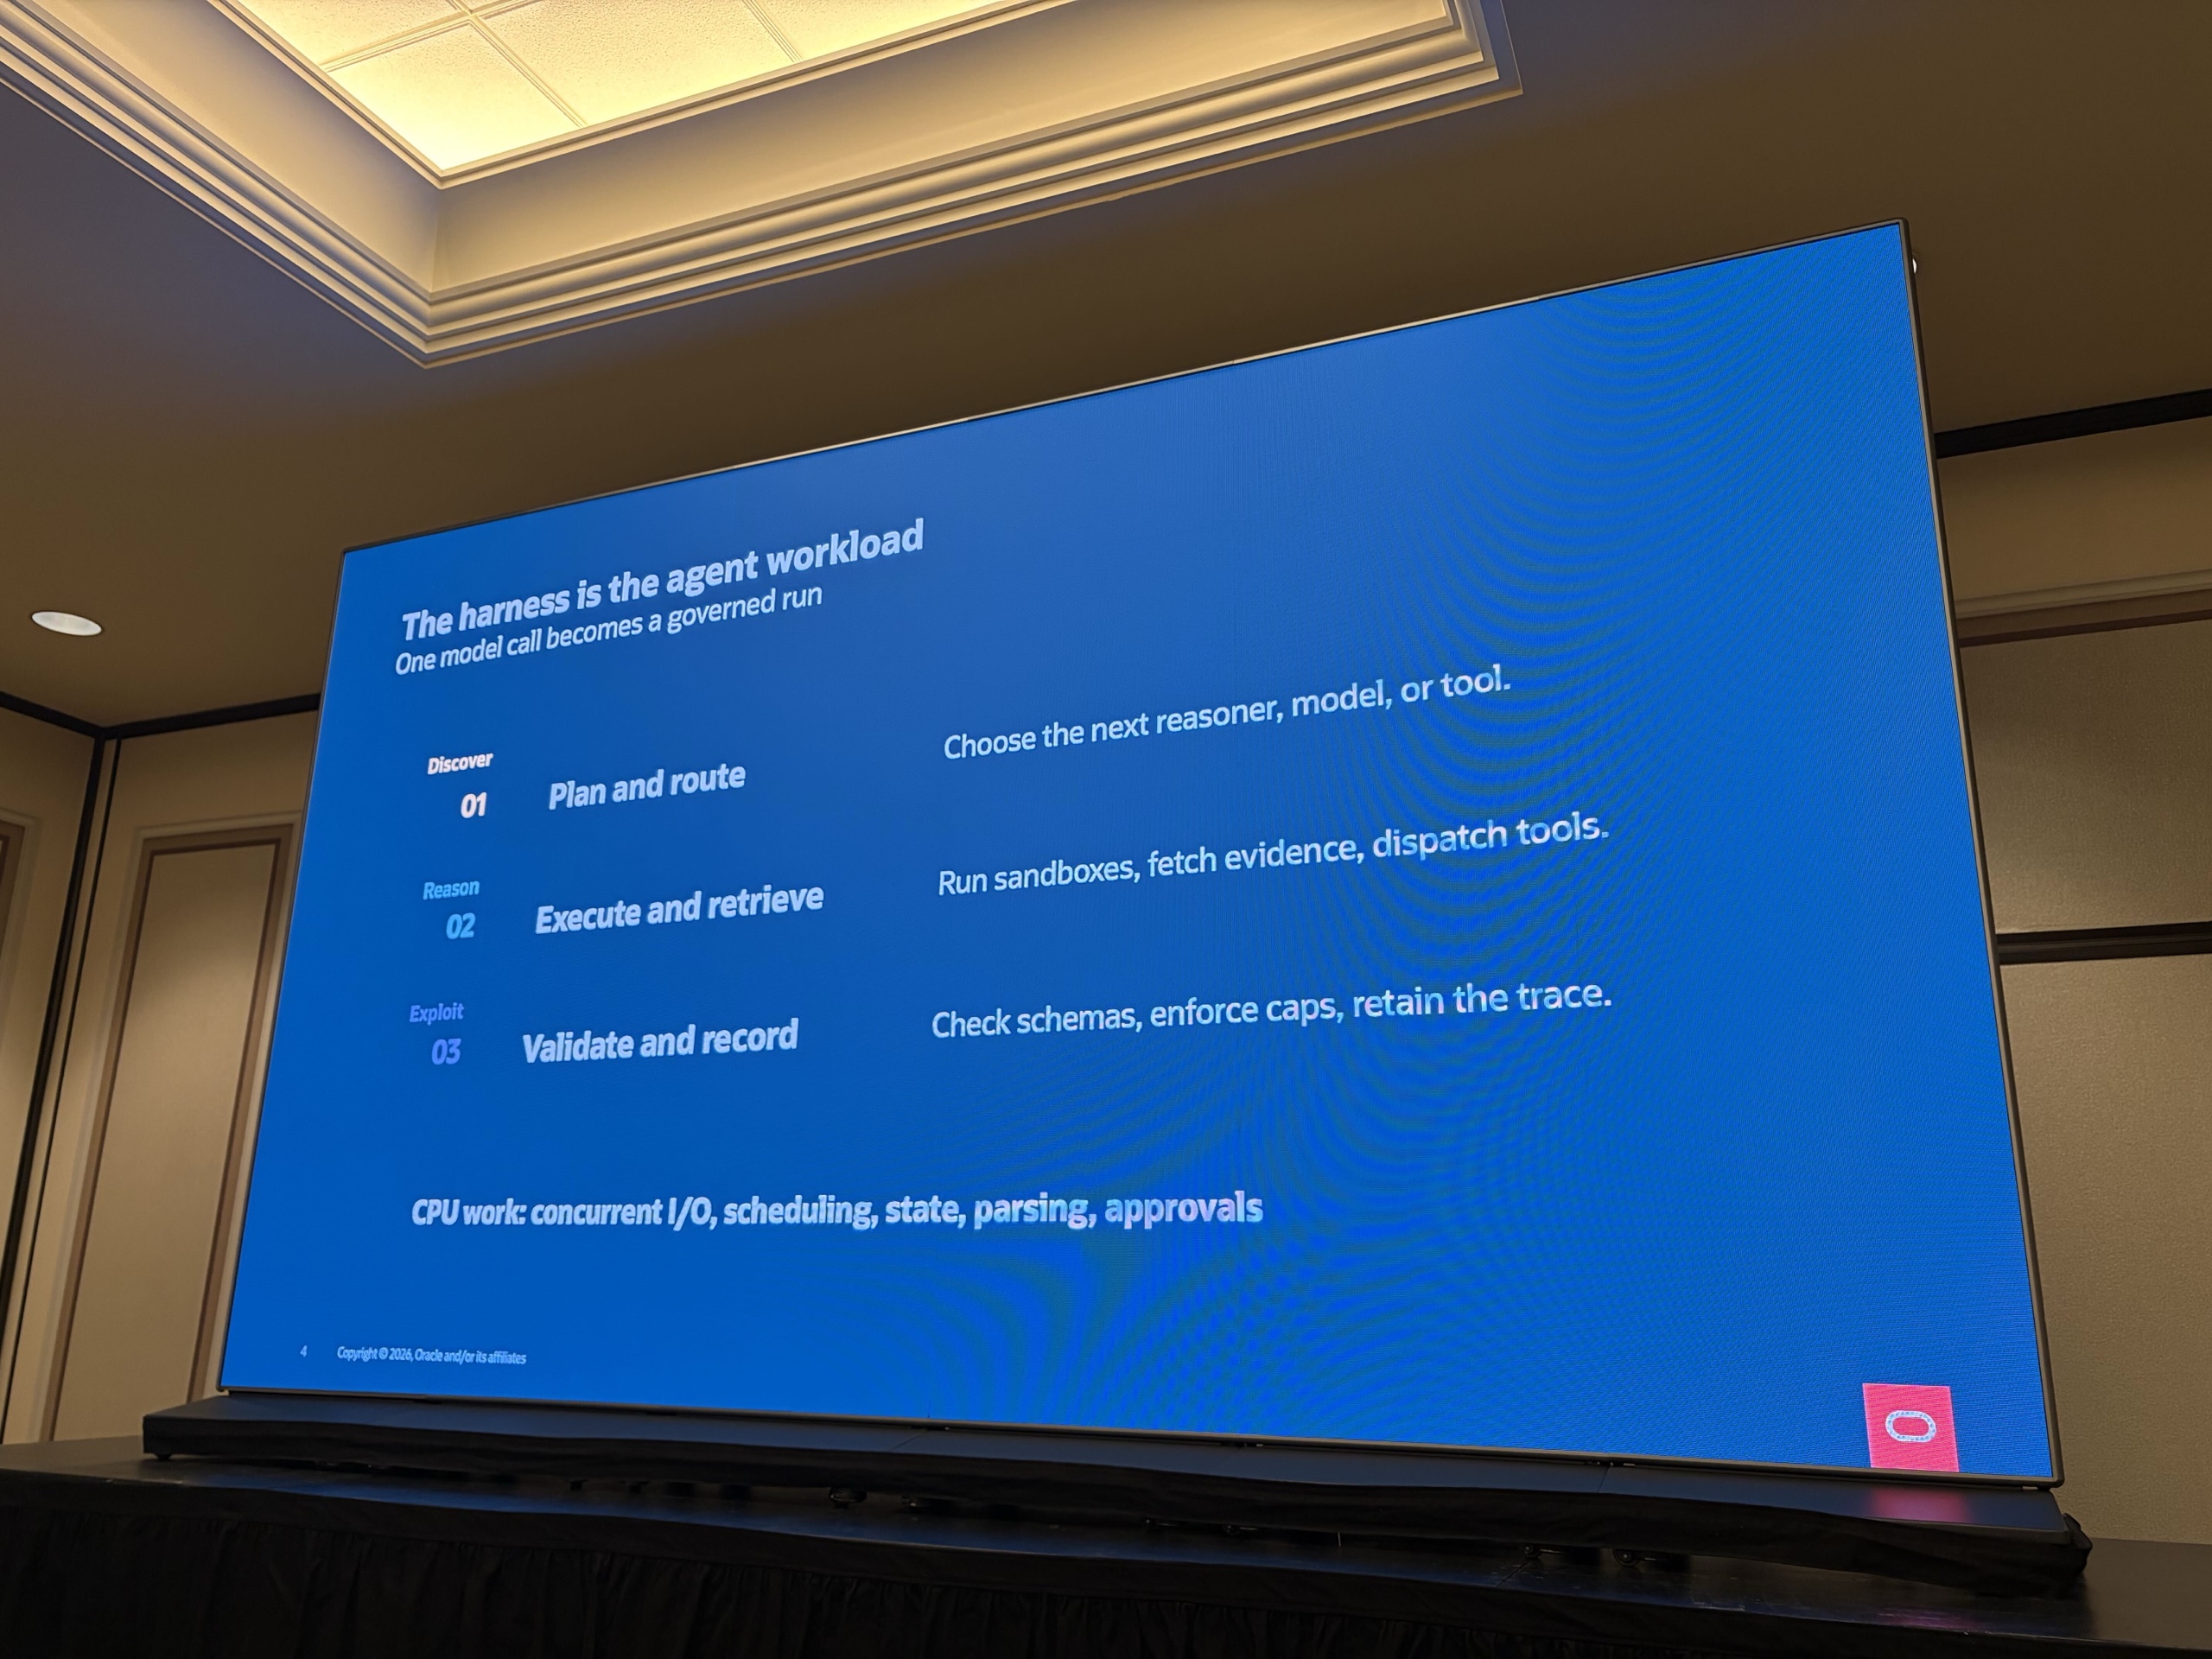
「The harness is the agent workload」。1回のモデル呼び出しが「計画とルーティング」「実行と取得」「検証と記録」を伴う統制された実行になることを示すスライド
Sanjay Basu氏は、エージェントを「従来のアプリケーションのロジックを推論エンジンに置き換え、自律性を持たせたもの」と定義したうえで、ワークフローをharness(エージェントの実行基盤)とLLMの2つに分けて説明しました。次に使うモデルやツールの選択、sandbox(隔離された実行環境)でのコード実行、結果の検証やログ記録は、どれもCPUの仕事です。
以前はharnessもGPUインスタンス上で動かしていたものの、harnessが動いている間はGPUがほとんど使われず、採算が合わなかったそうです。「だからharnessとLLMを同じインスタンスに載せるべきではない」という主張が、セッション全体の出発点になっていました。
OCIのリファレンス構成:harnessと推論を分けてサイジングする
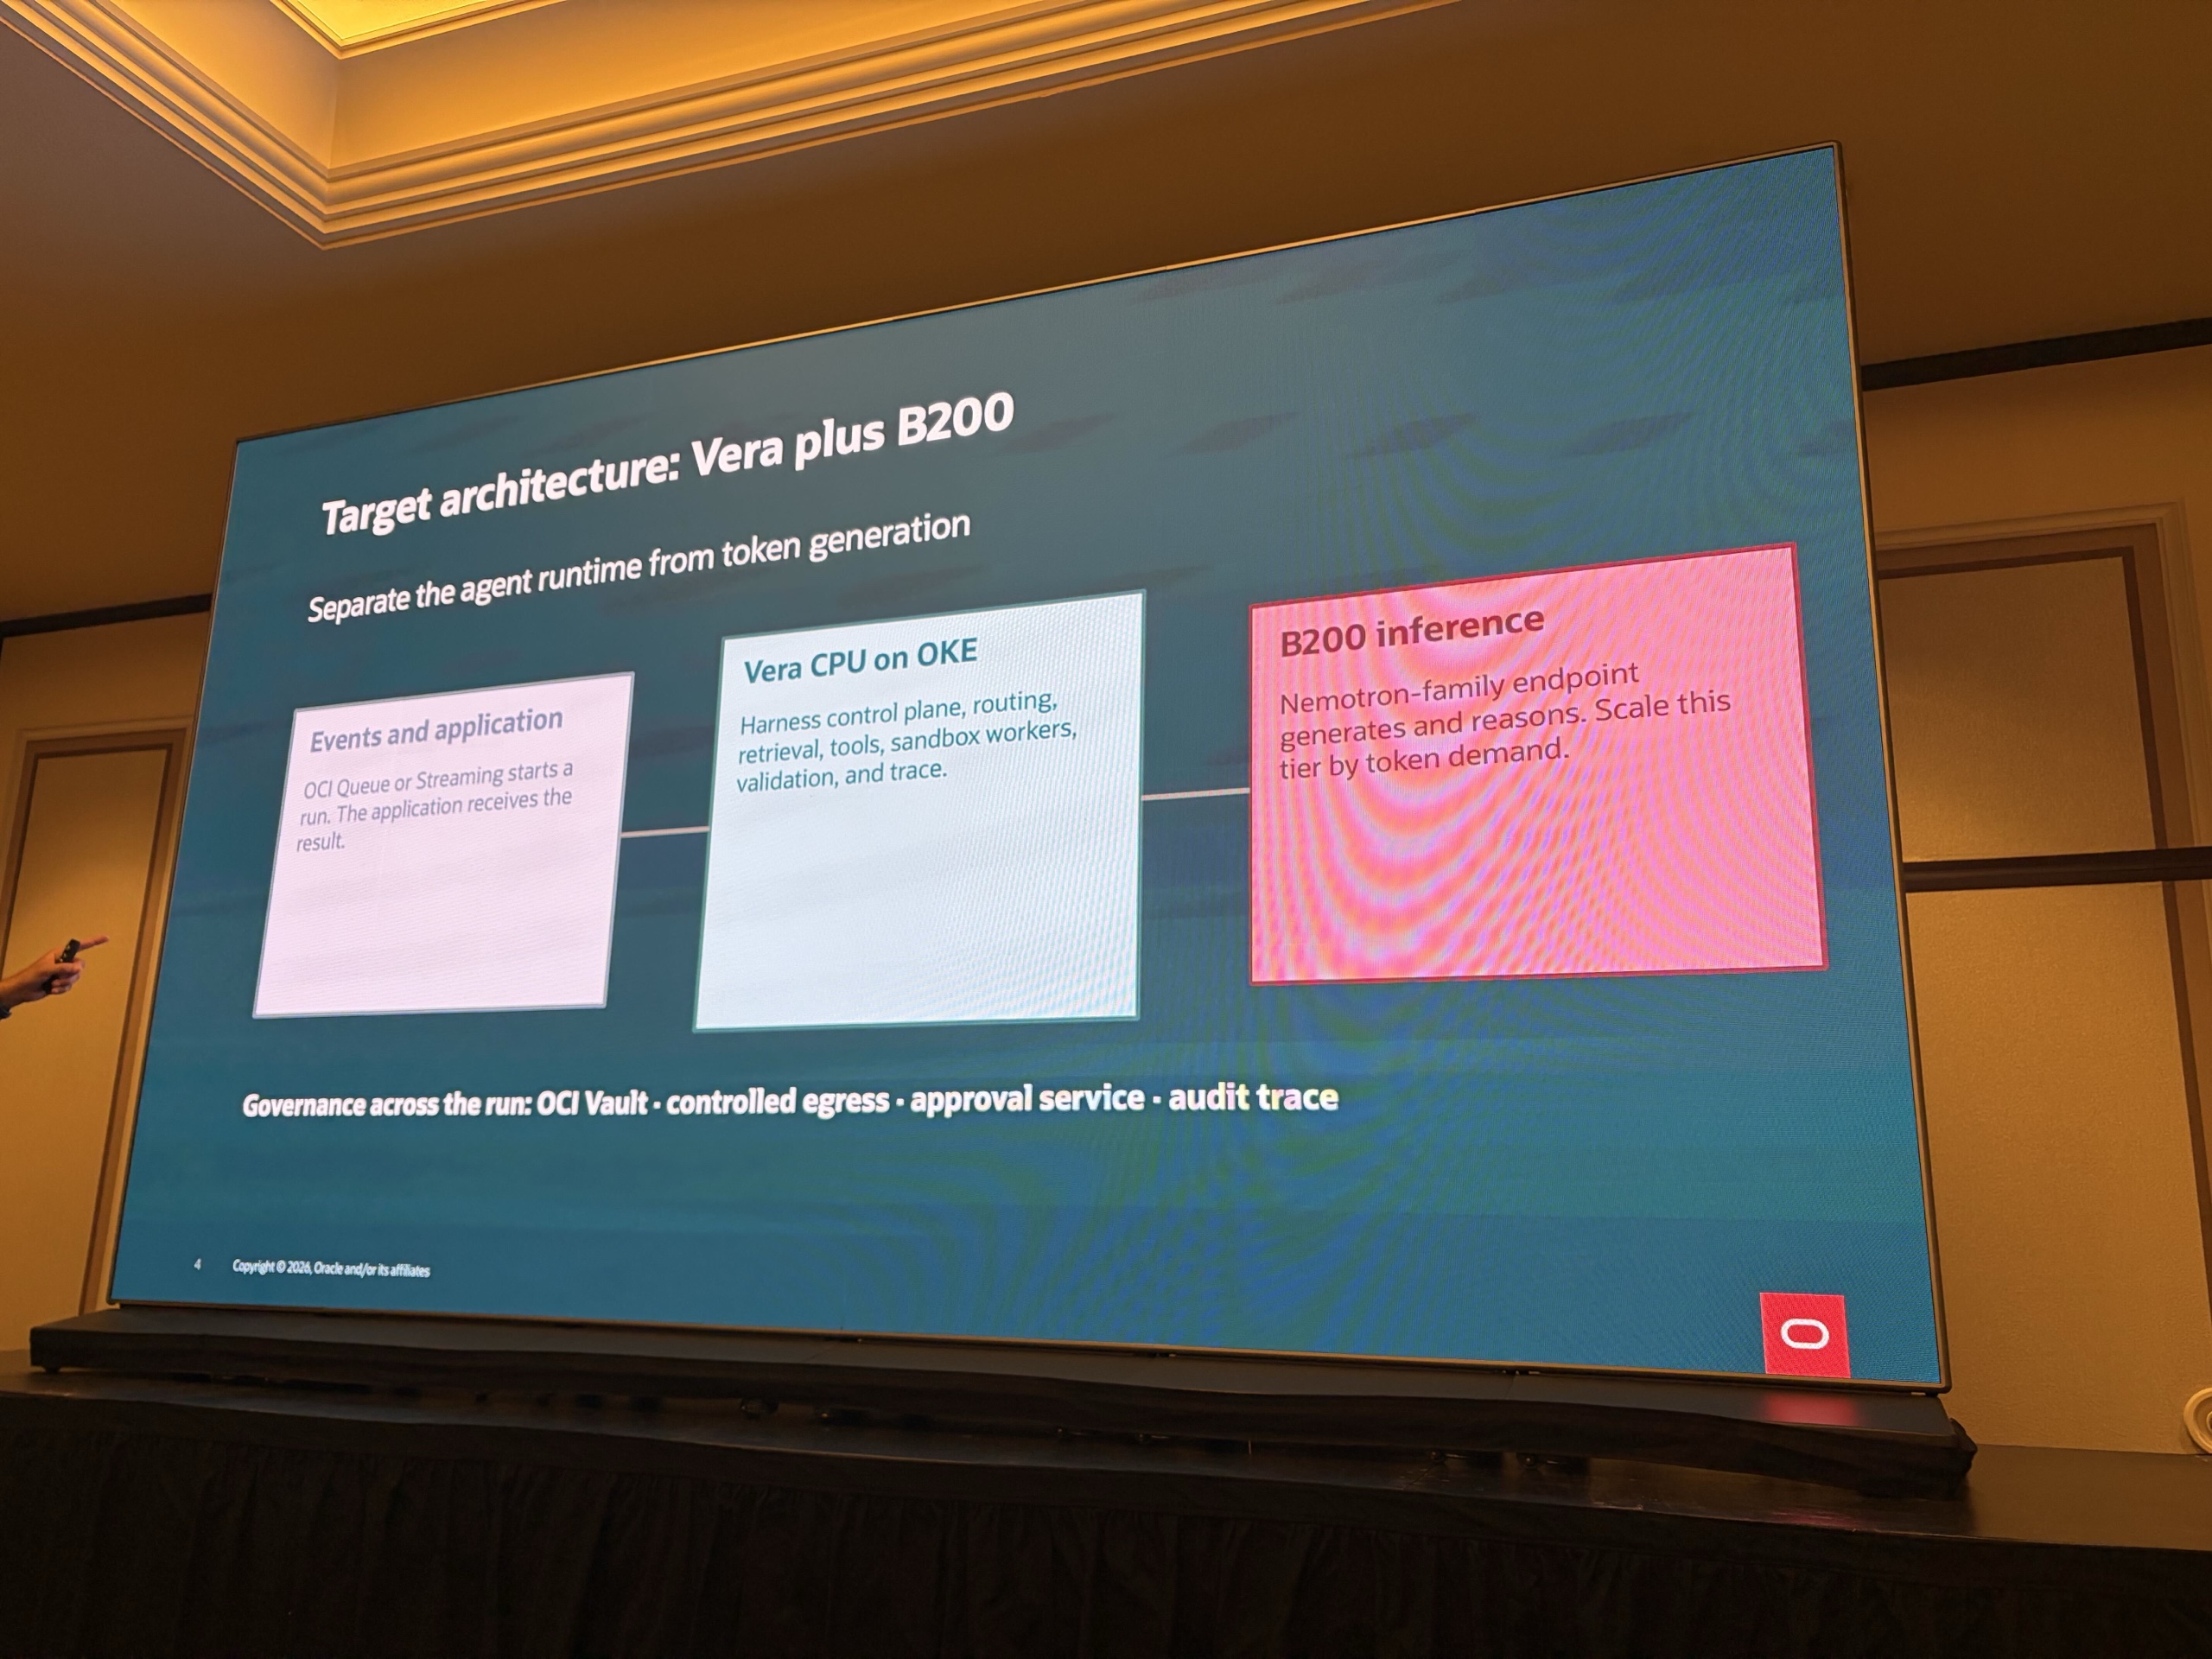
「Target architecture: Vera plus B200」。イベントとアプリケーション、Vera CPU on OKE、NVIDIA B200の3層構成
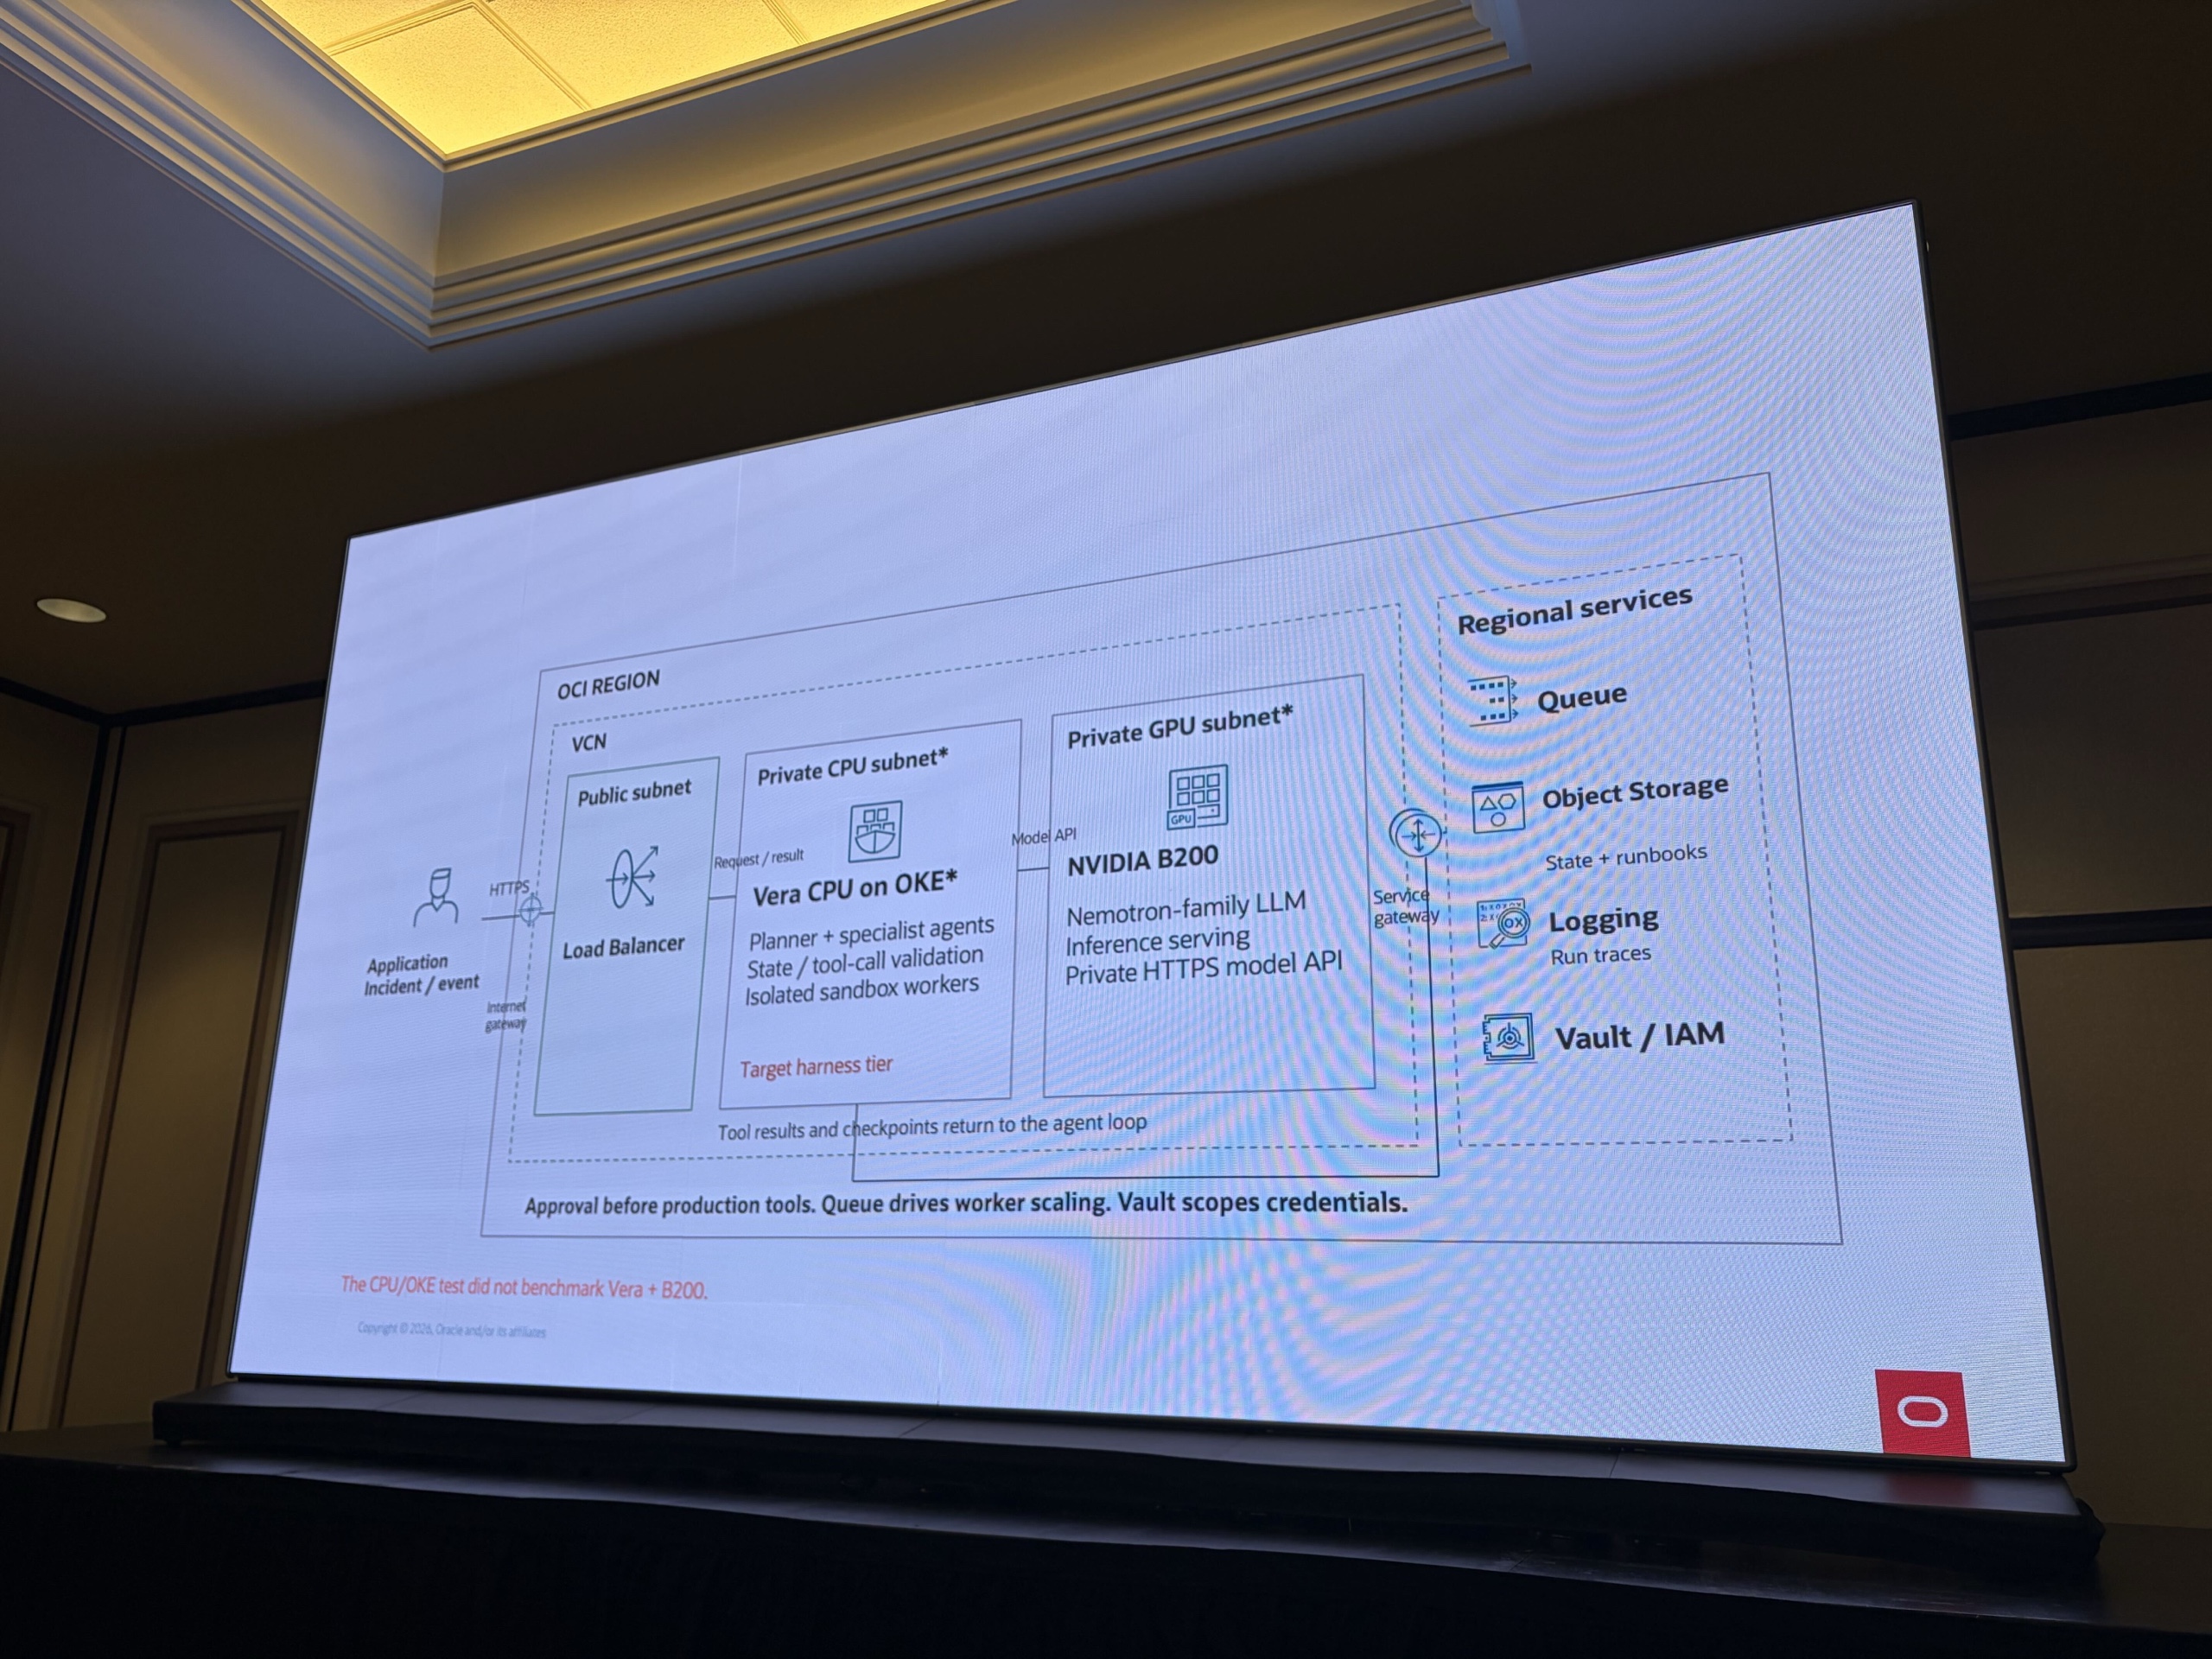
OCIリージョン内の構成図。Private CPU subnetのVera CPU on OKEとPrivate GPU subnetのNVIDIA B200を分け、Queue・Object Storage・Logging・Vault/IAMをService Gateway経由で使う
示された構成は3層です。OCI QueueやStreamingで実行を開始し、harnessはOKE(Oracle Kubernetes Engine)上のVera CPUで動かし、推論はB200上のNemotron系モデルのエンドポイントに任せます。キャッチフレーズは「エージェントの実行基盤とトークン生成を分ける」で、CPU層とGPU層をそれぞれの需要に合わせて別々にスケールさせる考え方です。
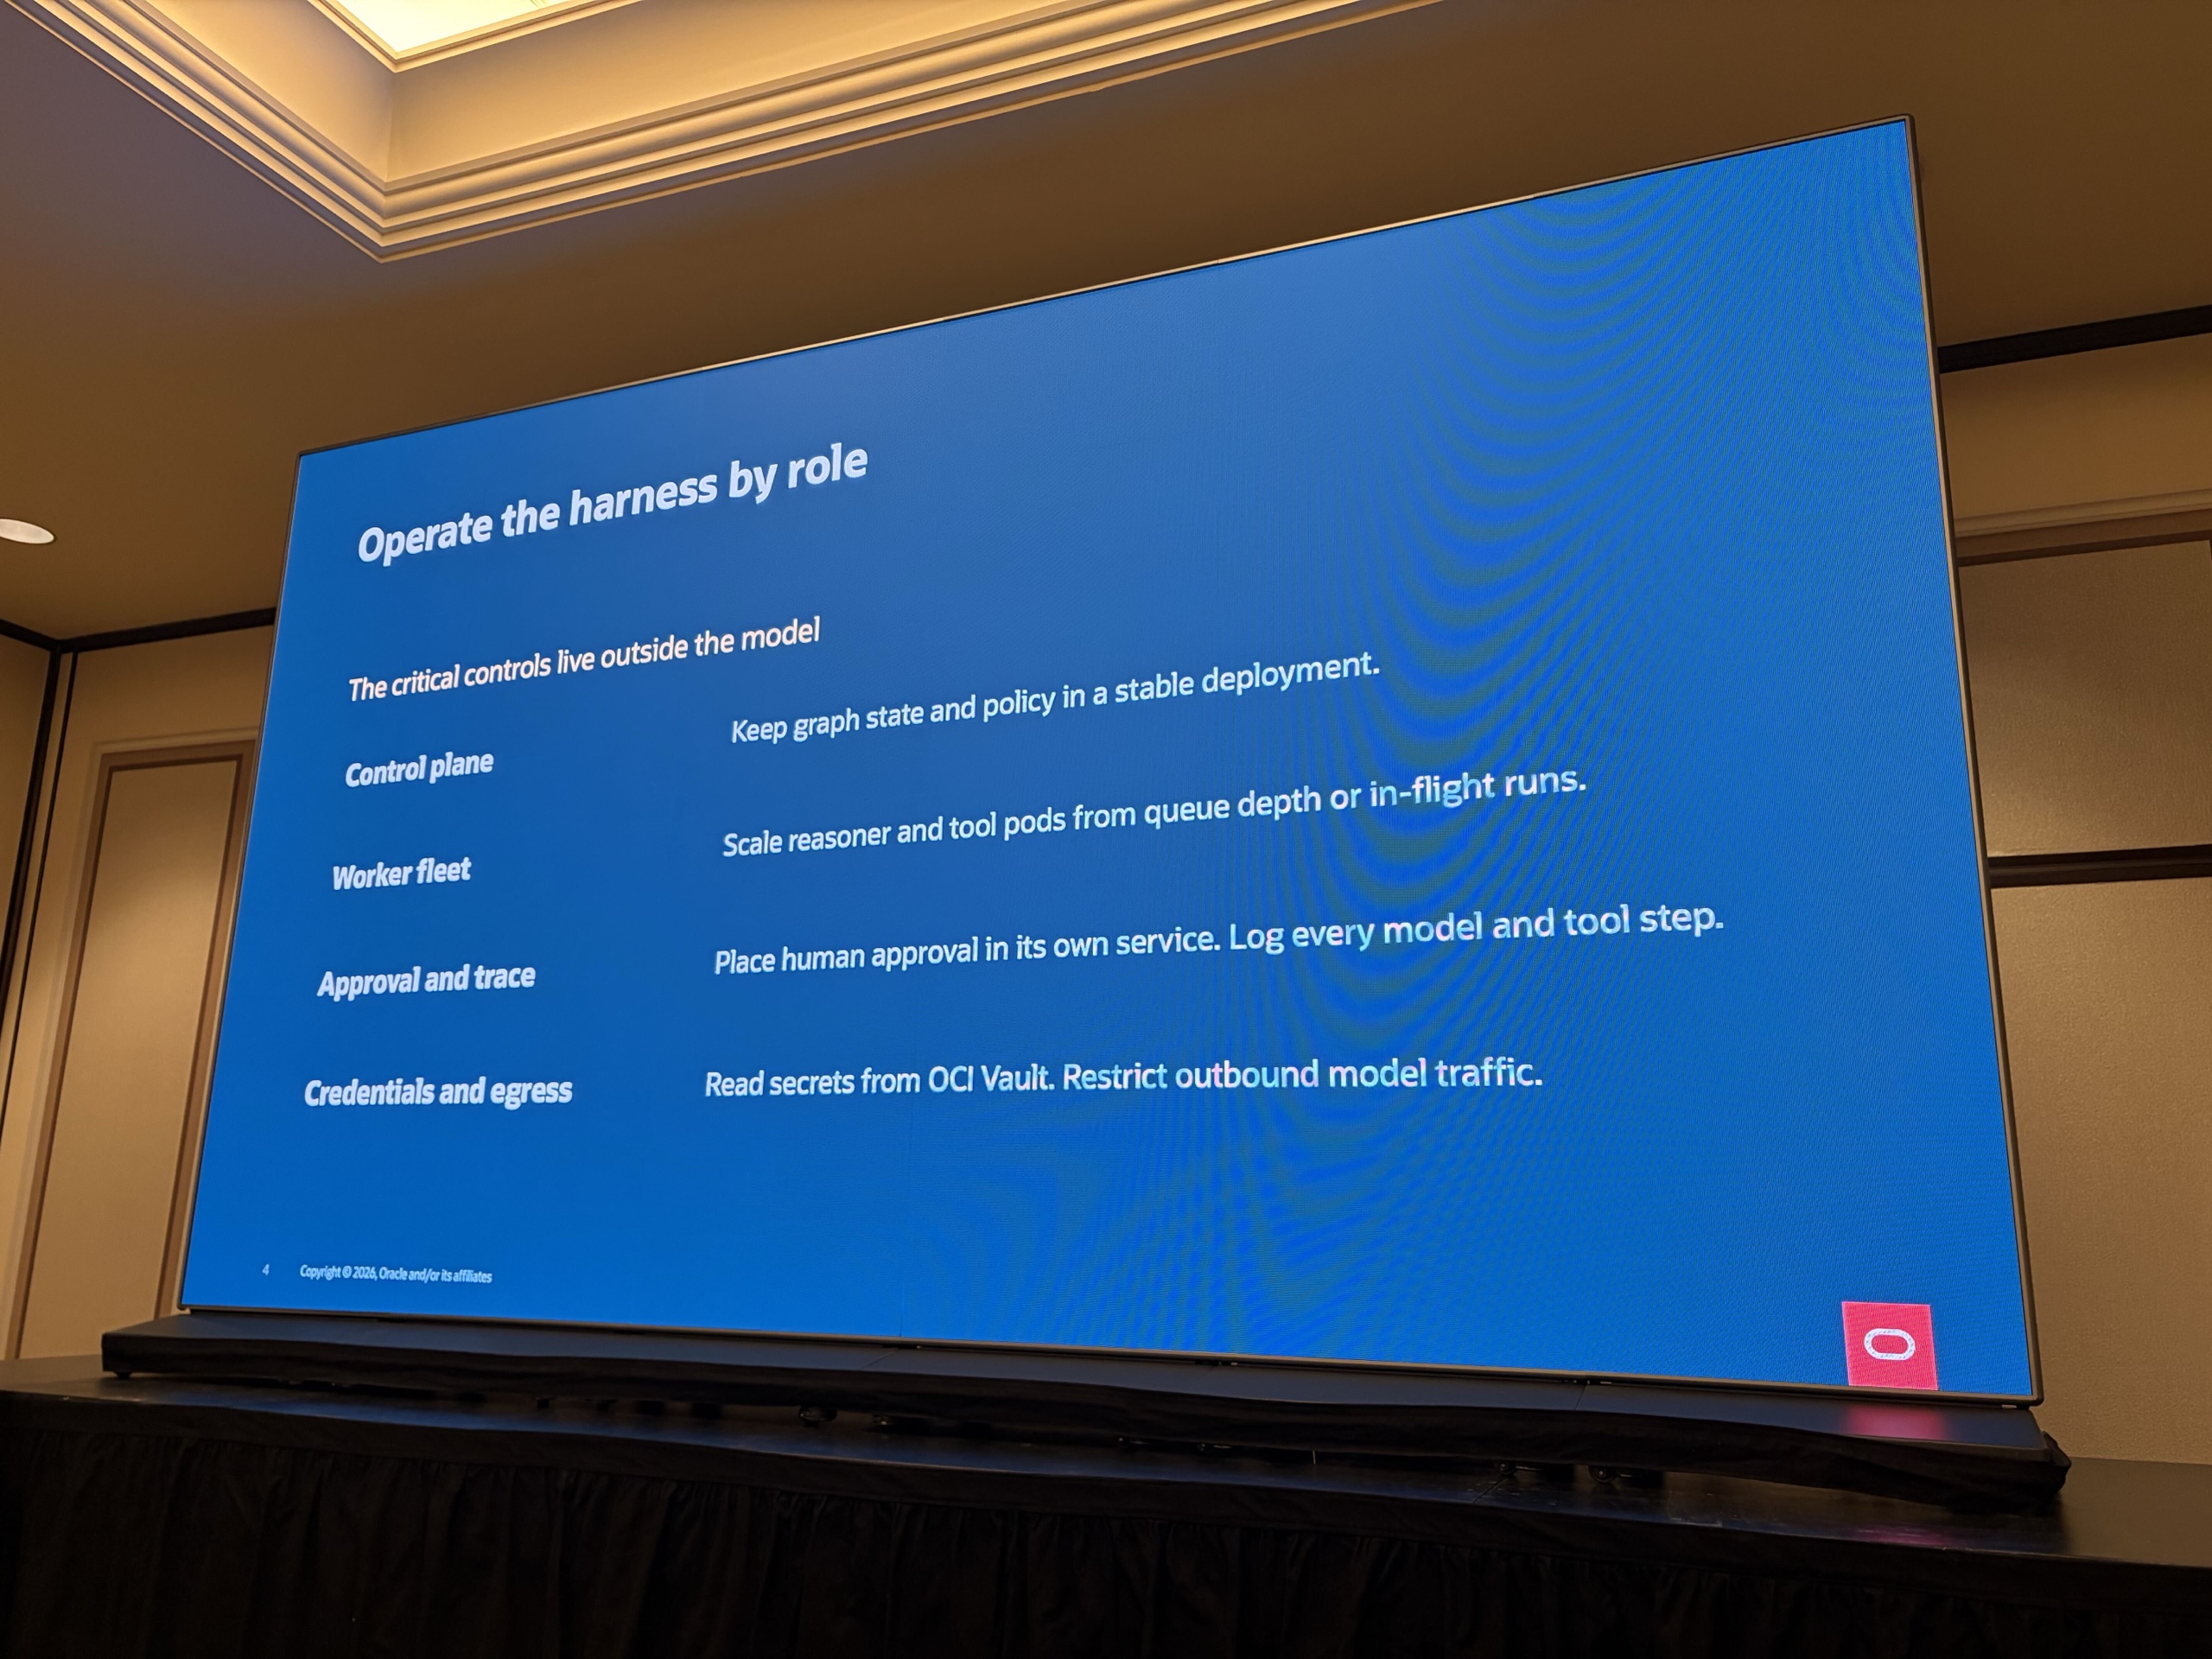
「Operate the harness by role — The critical controls live outside the model」
運用面では、「重要な制御はモデルの外に置く」として次の4点が挙げられていました。
- コントロールプレーン:グラフの状態とポリシーは、安定したデプロイに置く
- ワーカー群:推論とツールのPodは、CPU使用率ではなくキューの深さや処理中の実行数でスケールさせる
- 承認とトレース:人による承認は独立したサービスにし、モデルとツールの全ステップをログに残す
- 認証情報と通信先:シークレットはOCI Vaultから読み、外向きの通信を制限する
どの処理をVera側に寄せるかの判断軸は、並列度が高いか、メモリを活発に使うかの2点です。具体的には、セッション状態やルーティングを扱うオーケストレーション、短いコード実行を大量に繰り返すsandbox、インメモリのインデックスを使う検索とサービング制御が候補とされていました。
移行の手順について
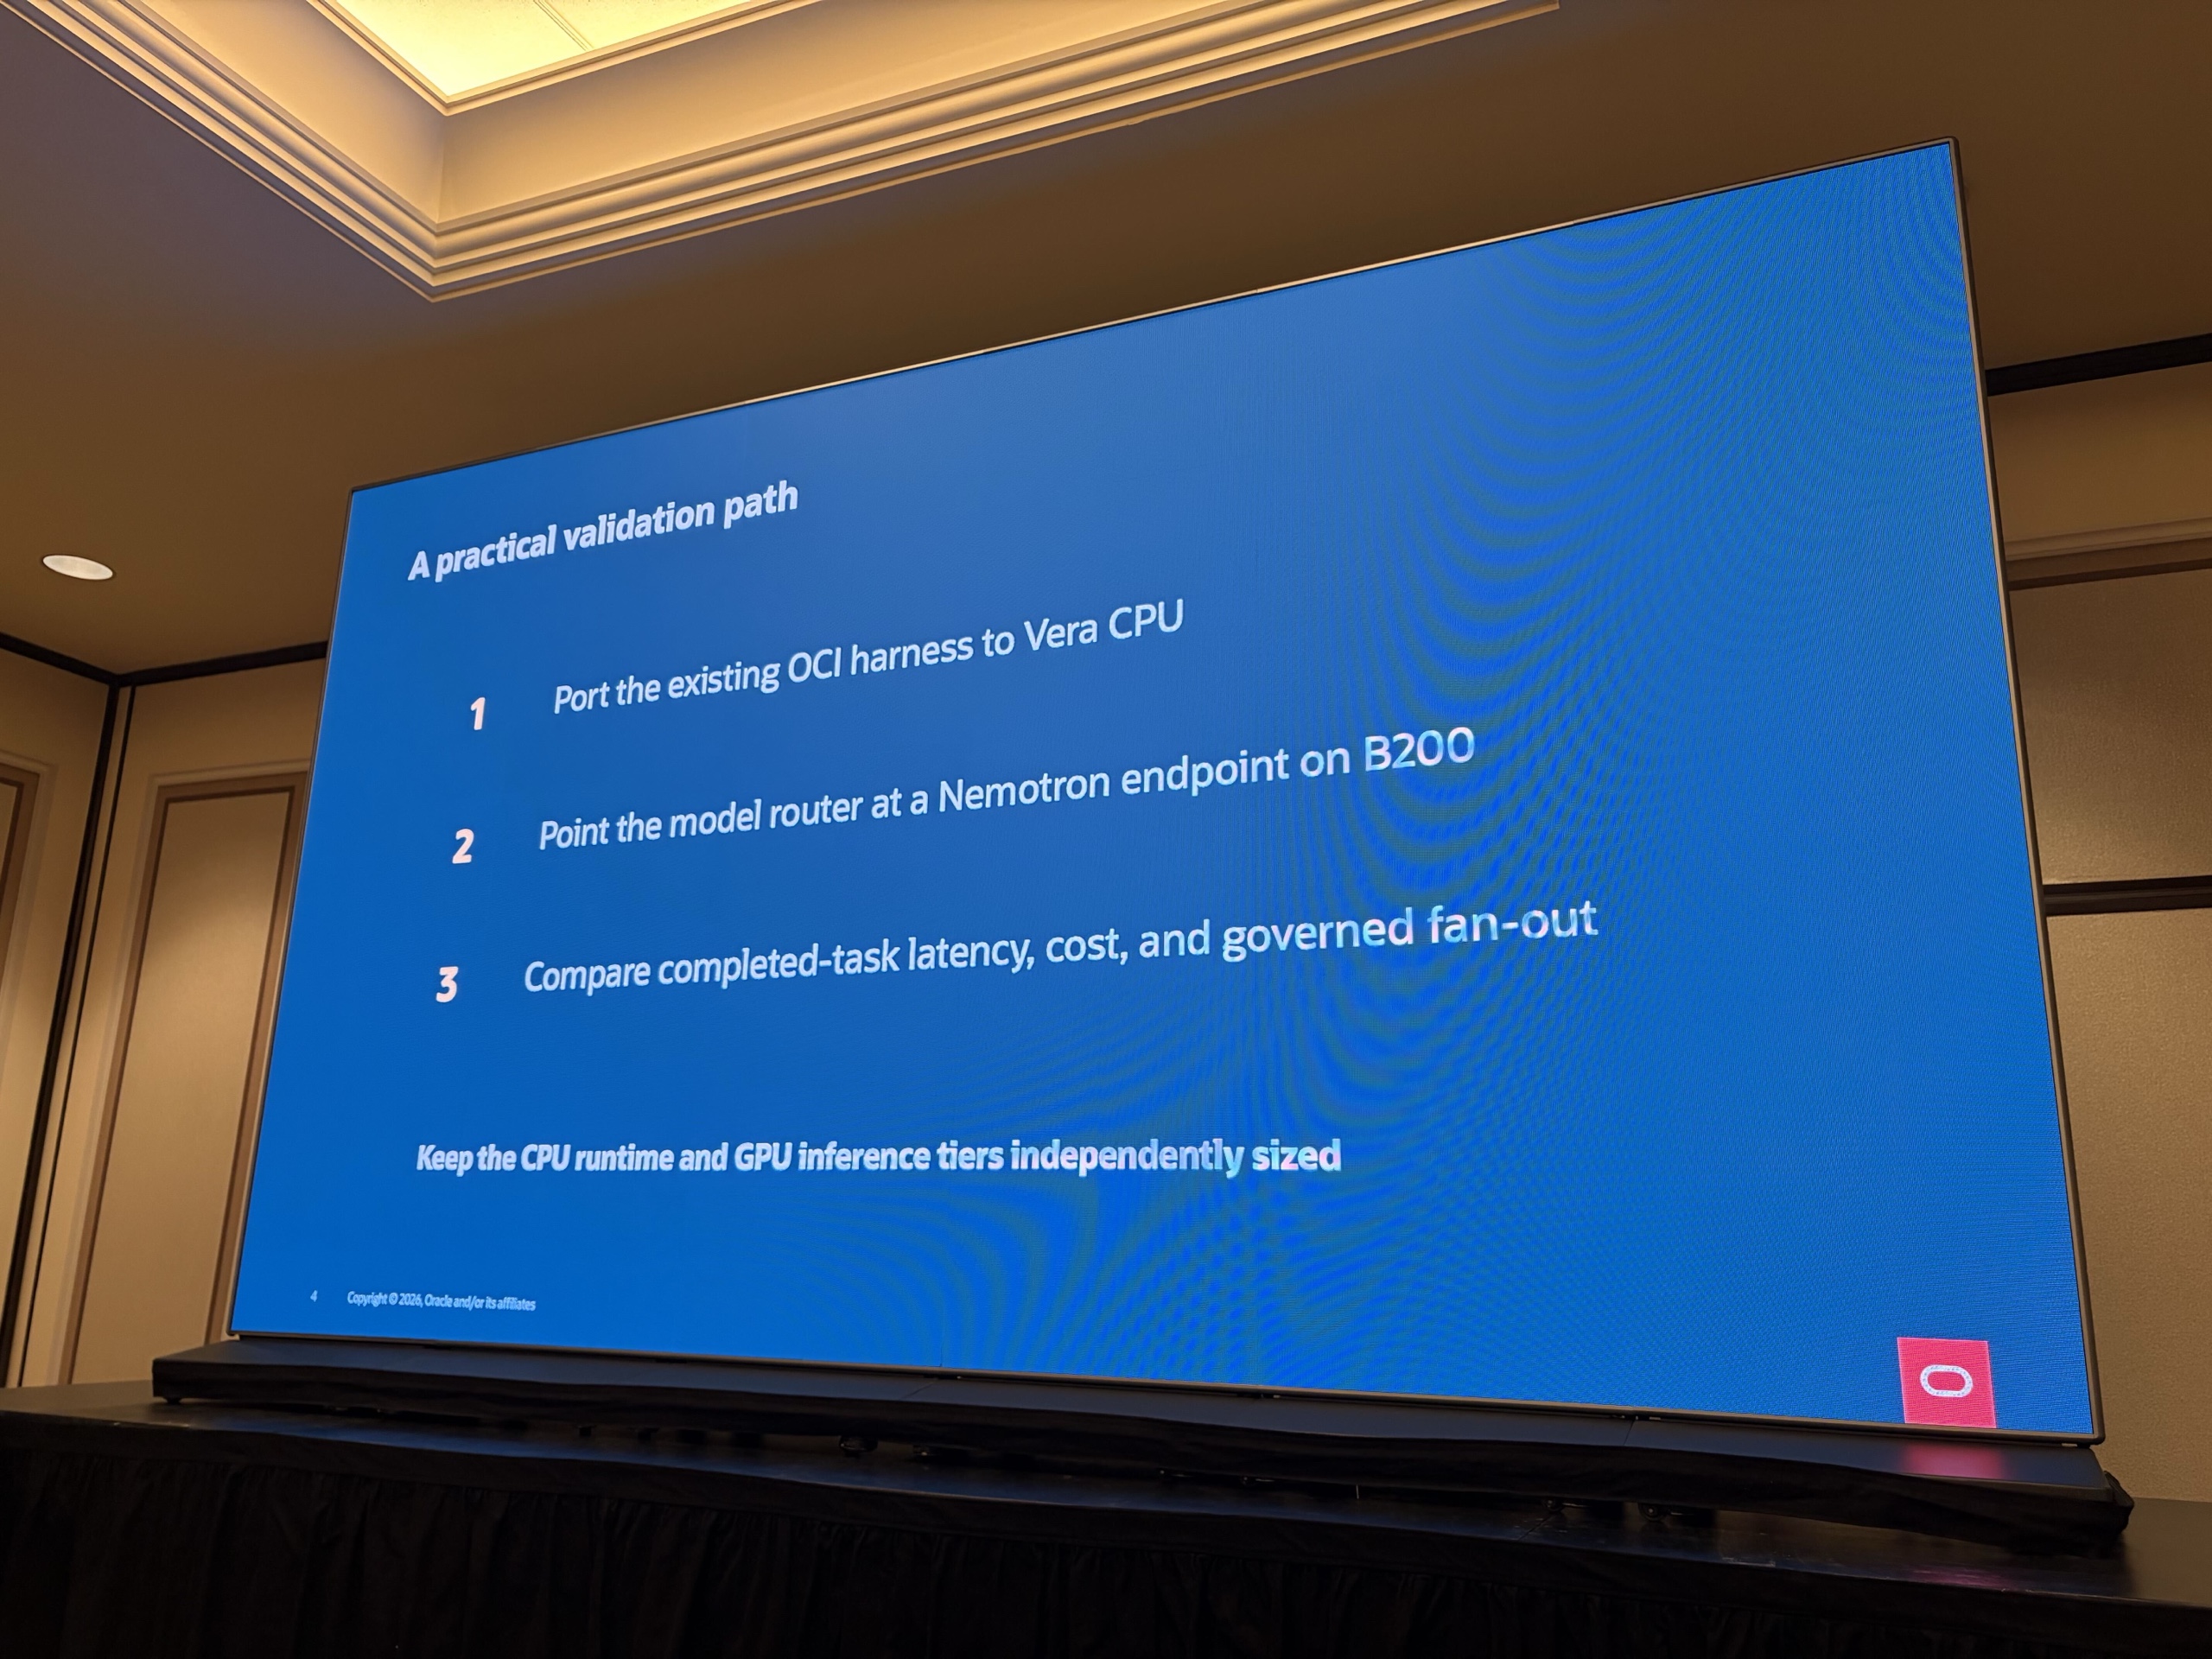
「A practical validation path」。既存のharnessをVera CPUへ移し、モデルルーターをB200上のNemotronエンドポイントに向け、タスク完了までのレイテンシとコストを比べる3ステップ
移行の進め方は、①既存のOCI上のharnessをVera CPUに移す、②モデルルーターをB200上のNemotronエンドポイントに向ける、③タスク完了までのレイテンシ・コスト・統制された並列実行を比べる、の3ステップで示されました。他のクラウドから移す場合も含めたプレイブックを用意している、とのことです。
なぜ今CPUなのか:コア数より1コアの速さ
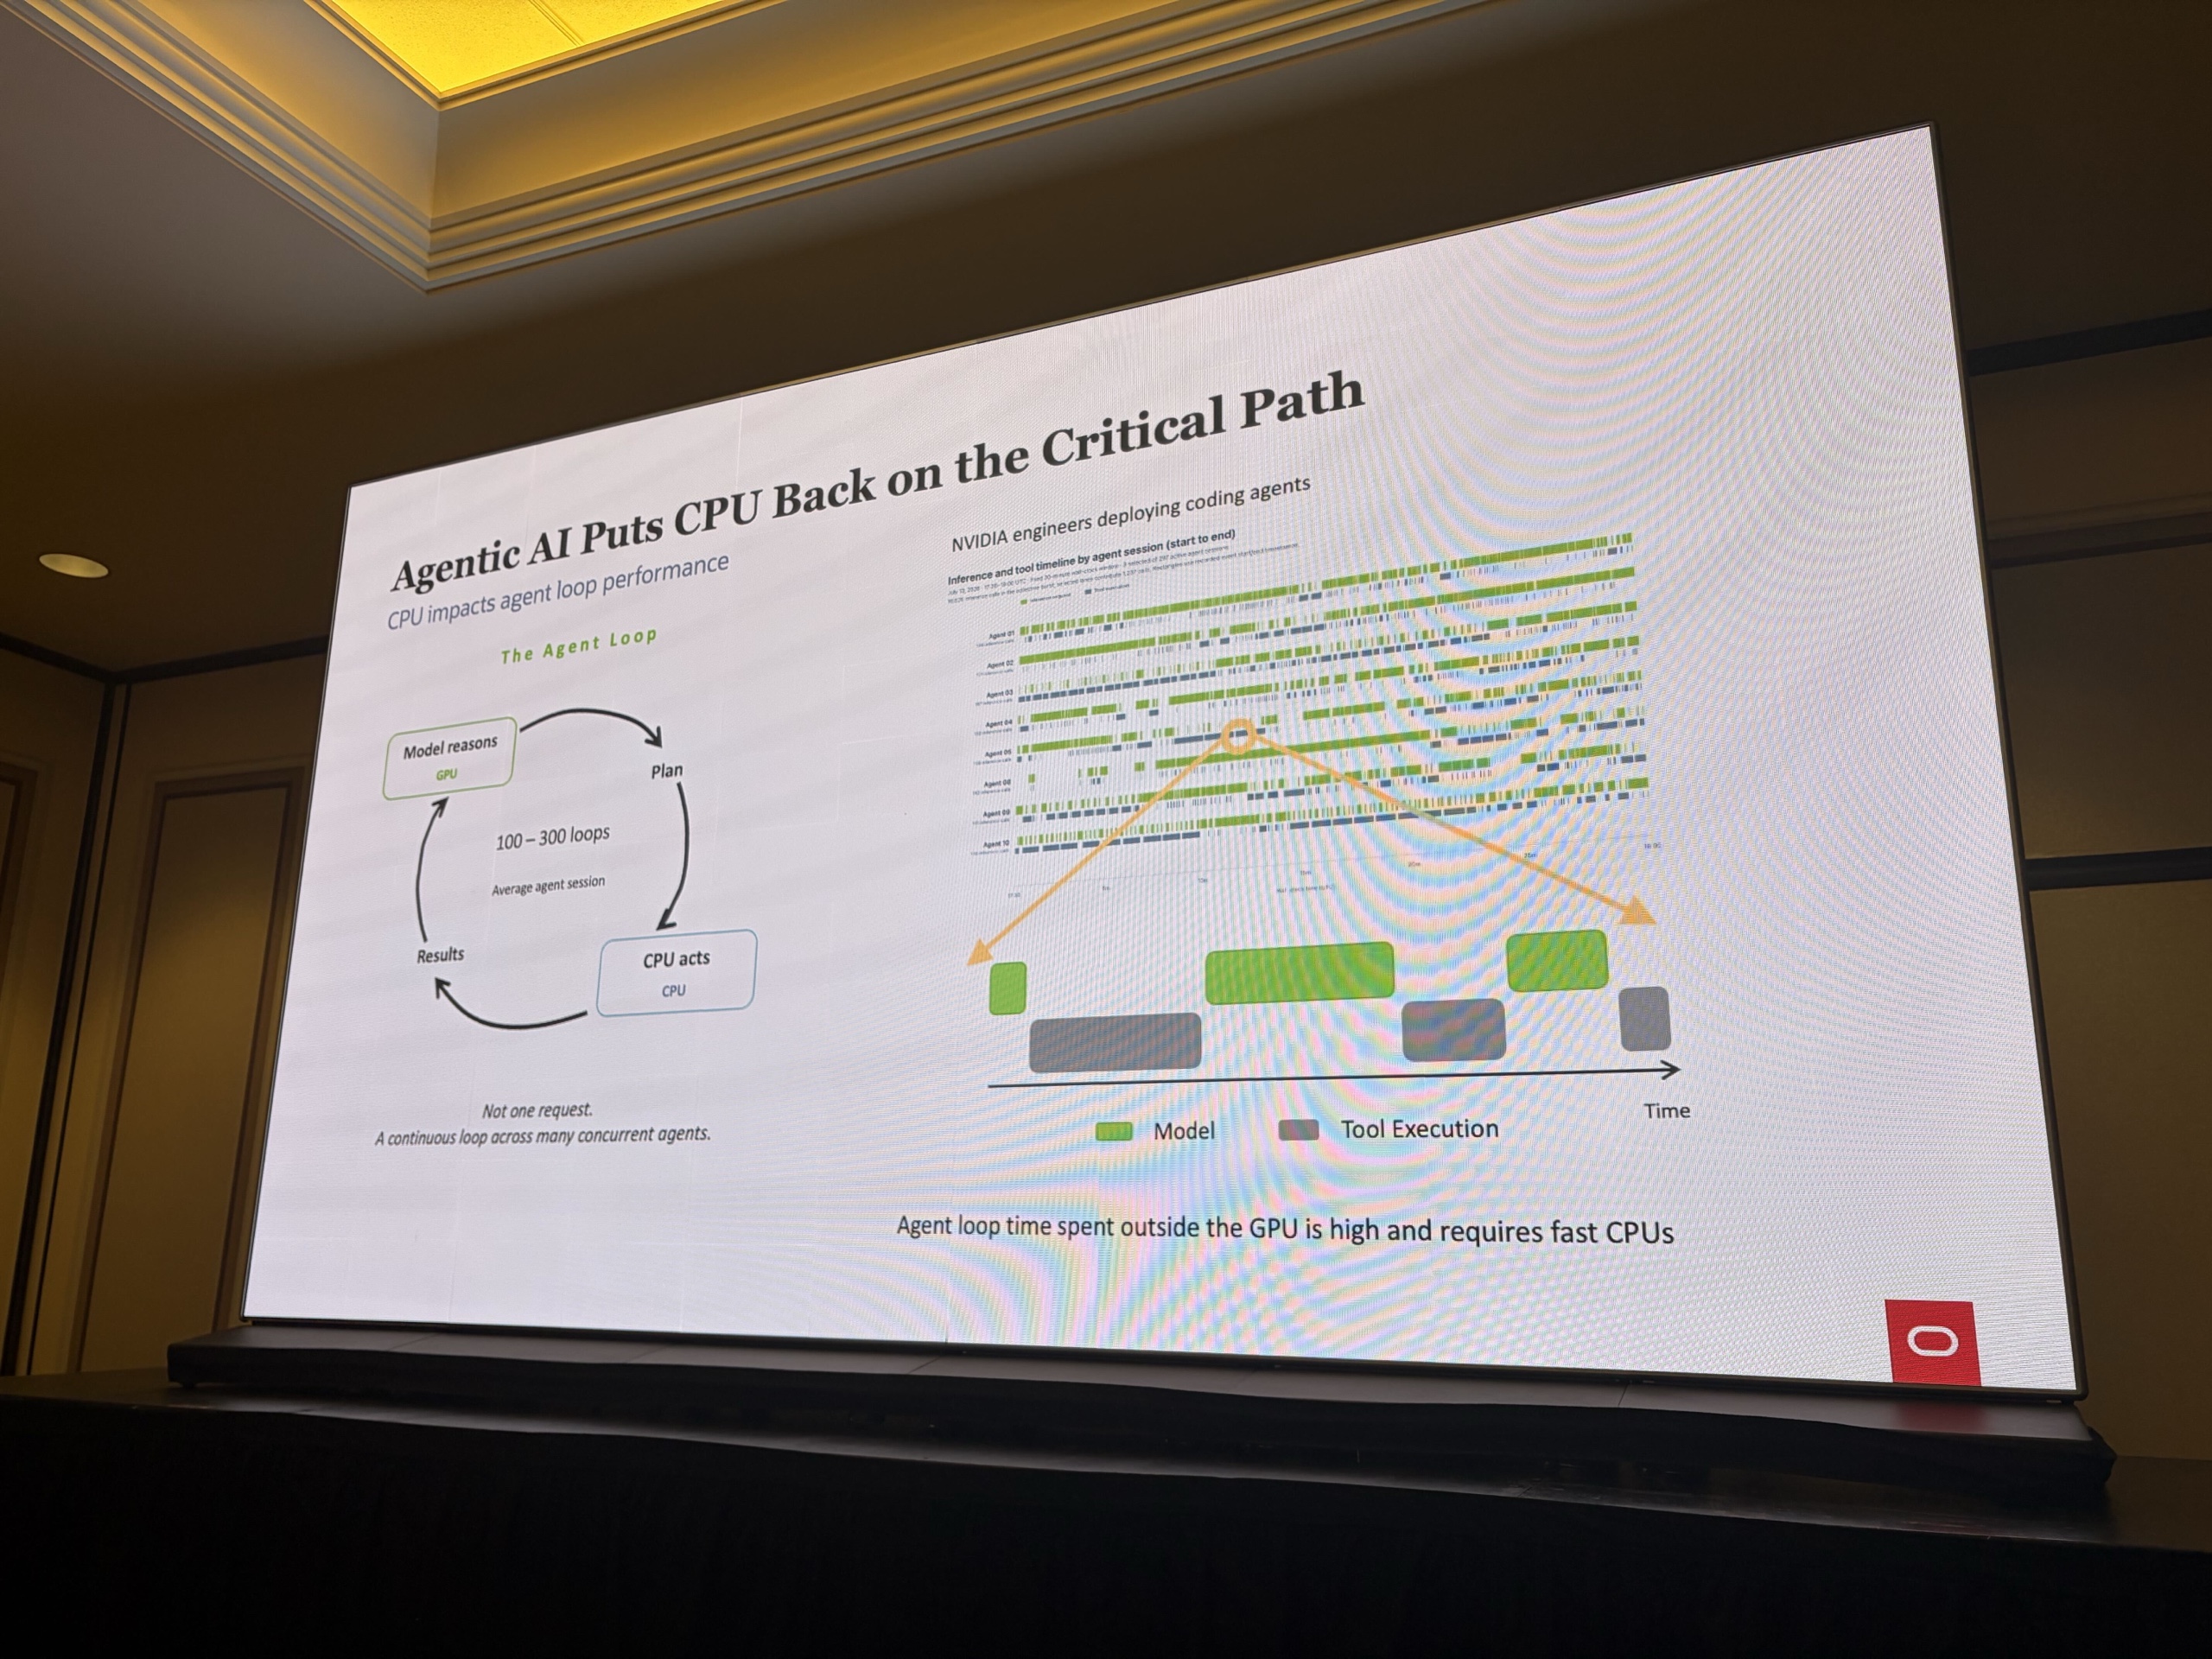
「Agentic AI Puts CPU Back on the Critical Path」。モデル(GPU)とツール実行(CPU)を行き来するエージェントのループと、NVIDIA社内のコーディングエージェントのタイムライン
Hannah Coutand氏は、データセンター向けCPUの歴史から話を始めました。クラウドの規模の経済に合わせて、CPUはコア数とスループットを伸ばす方向に進化し、1コアあたりの性能の伸びは控えめでした。
ところがエージェントは、GPUでの推論とCPUでのツール実行を1セッションで100〜300回往復します。1つのループは逐次処理なので、CPU側の時間を縮めるにはコア数ではなく1コアの速さが効く、という説明は非常に分かりやすいものでした。
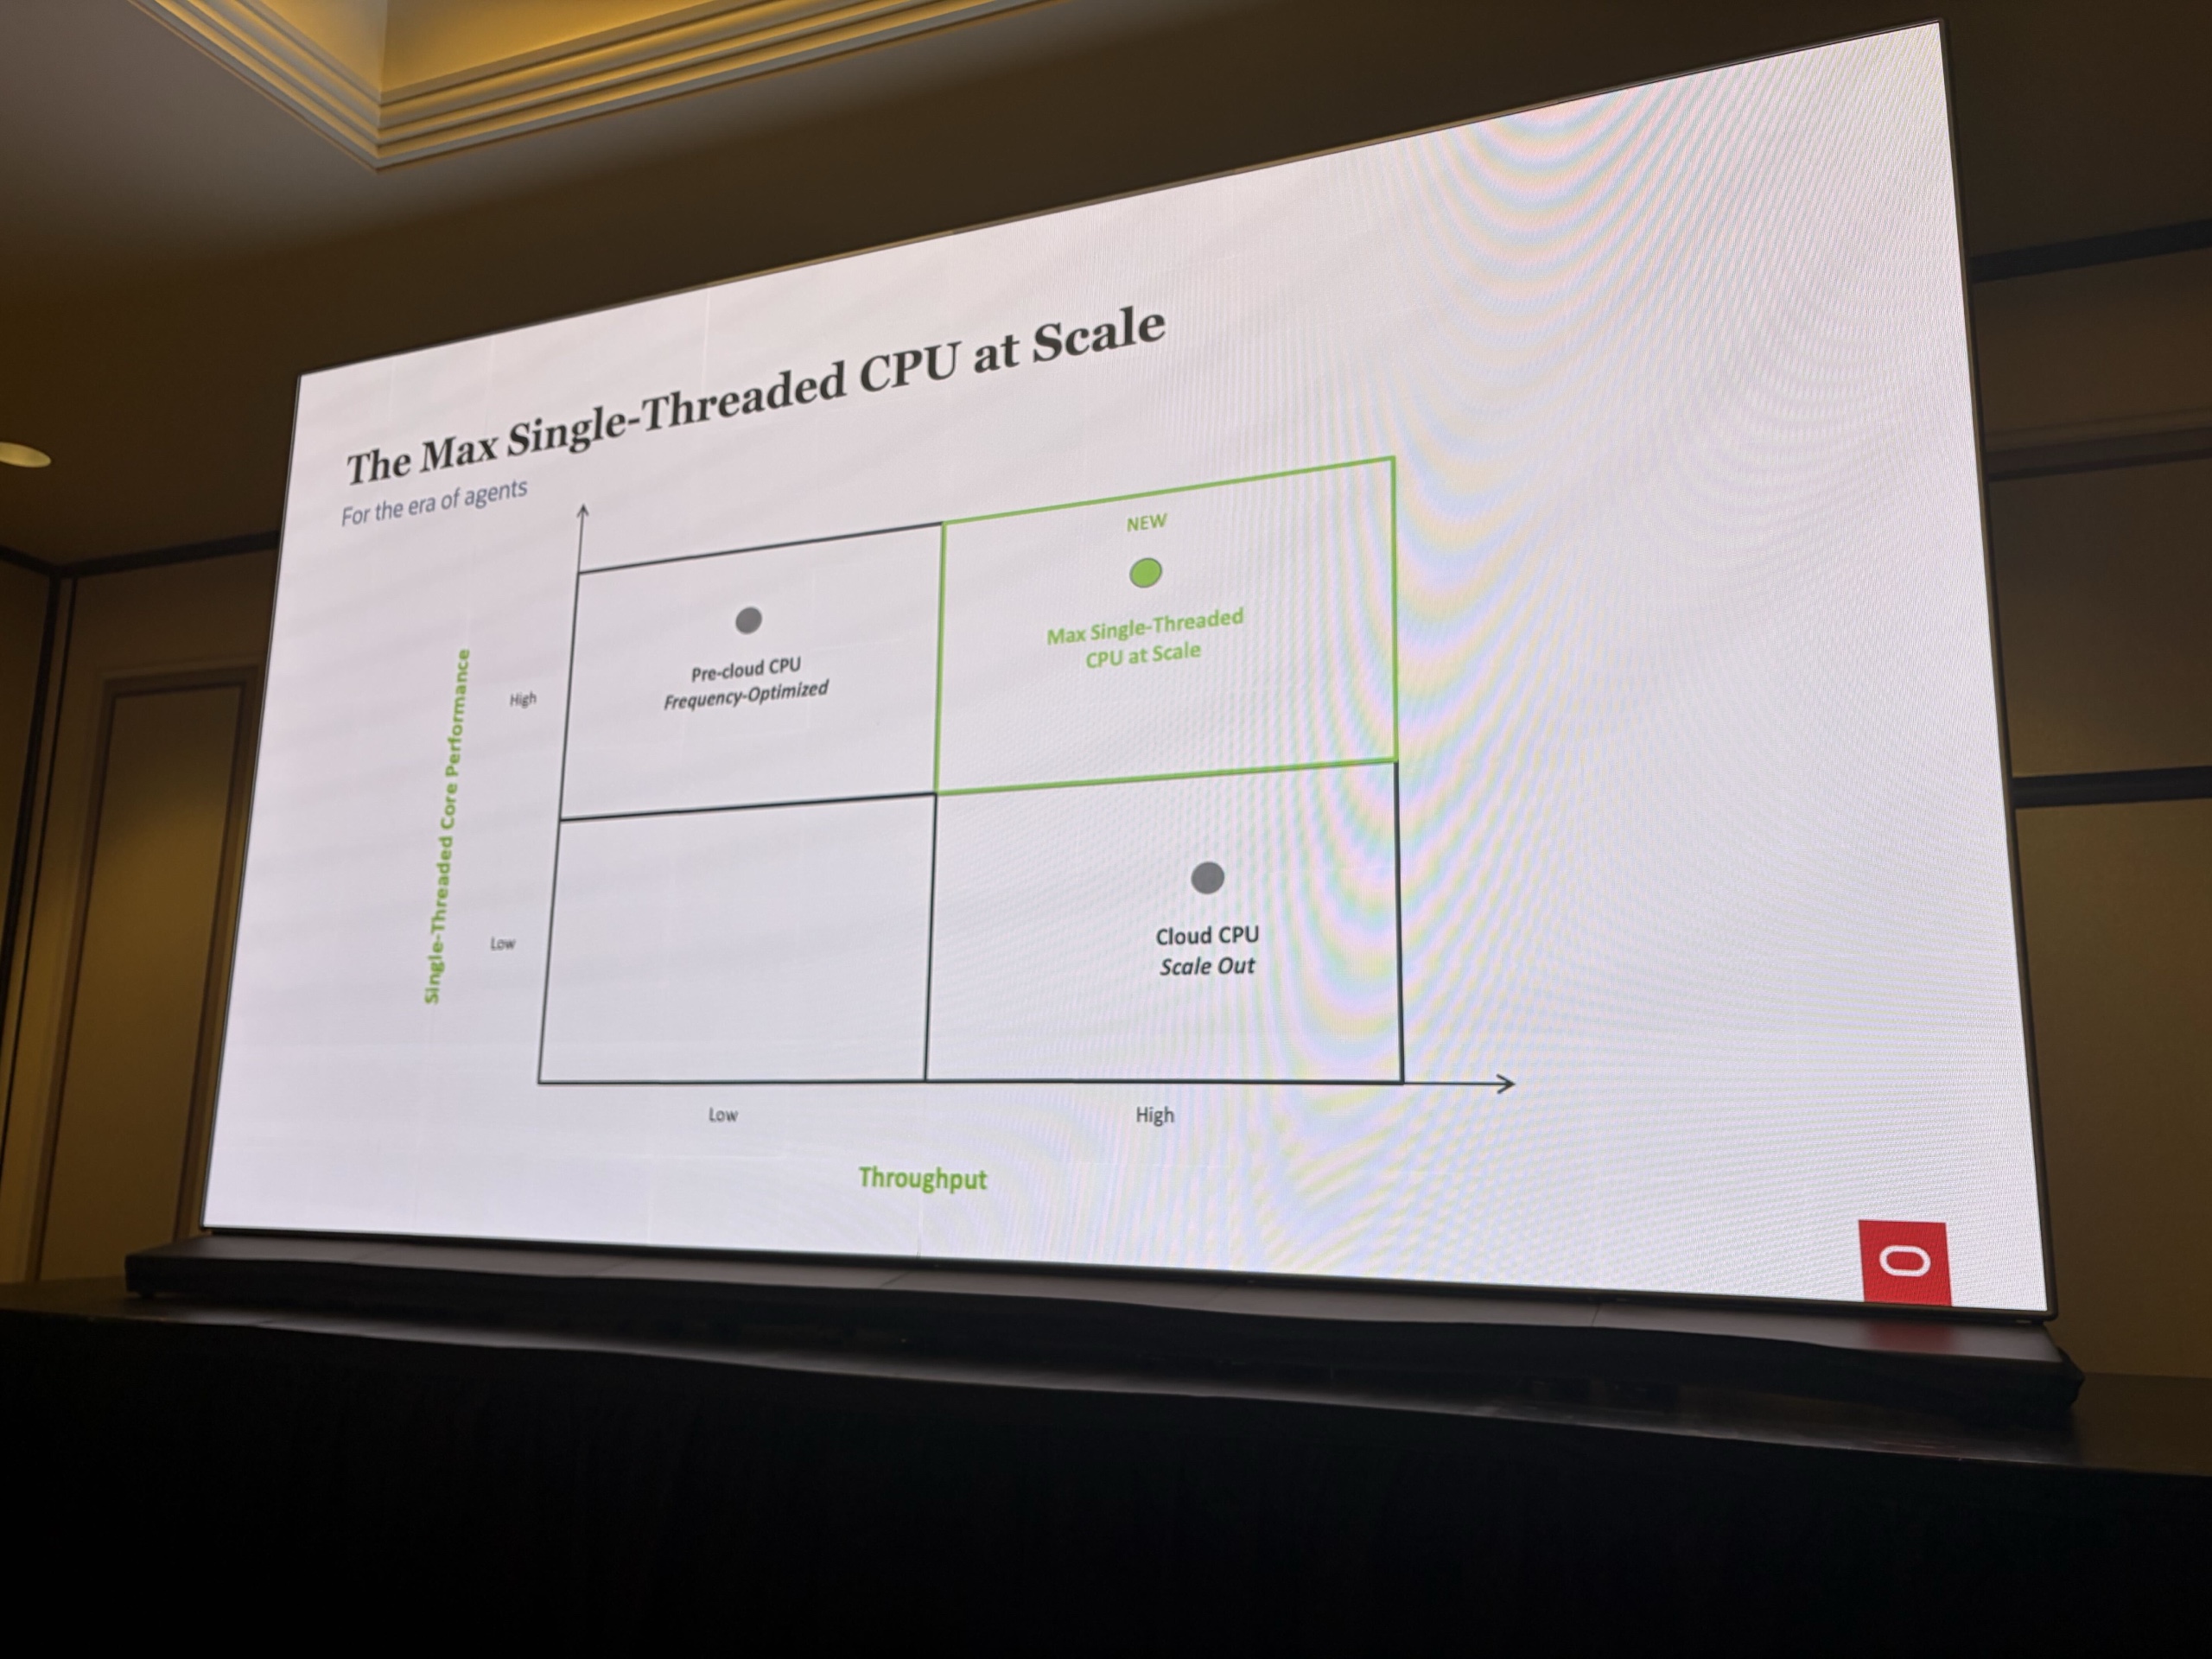
縦軸シングルスレッド性能、横軸スループットの4象限で、右上に「Max Single-Threaded CPU at Scale」を新しく置いたスライド
Vera CPUの3つの柱とOCIでの提供形態
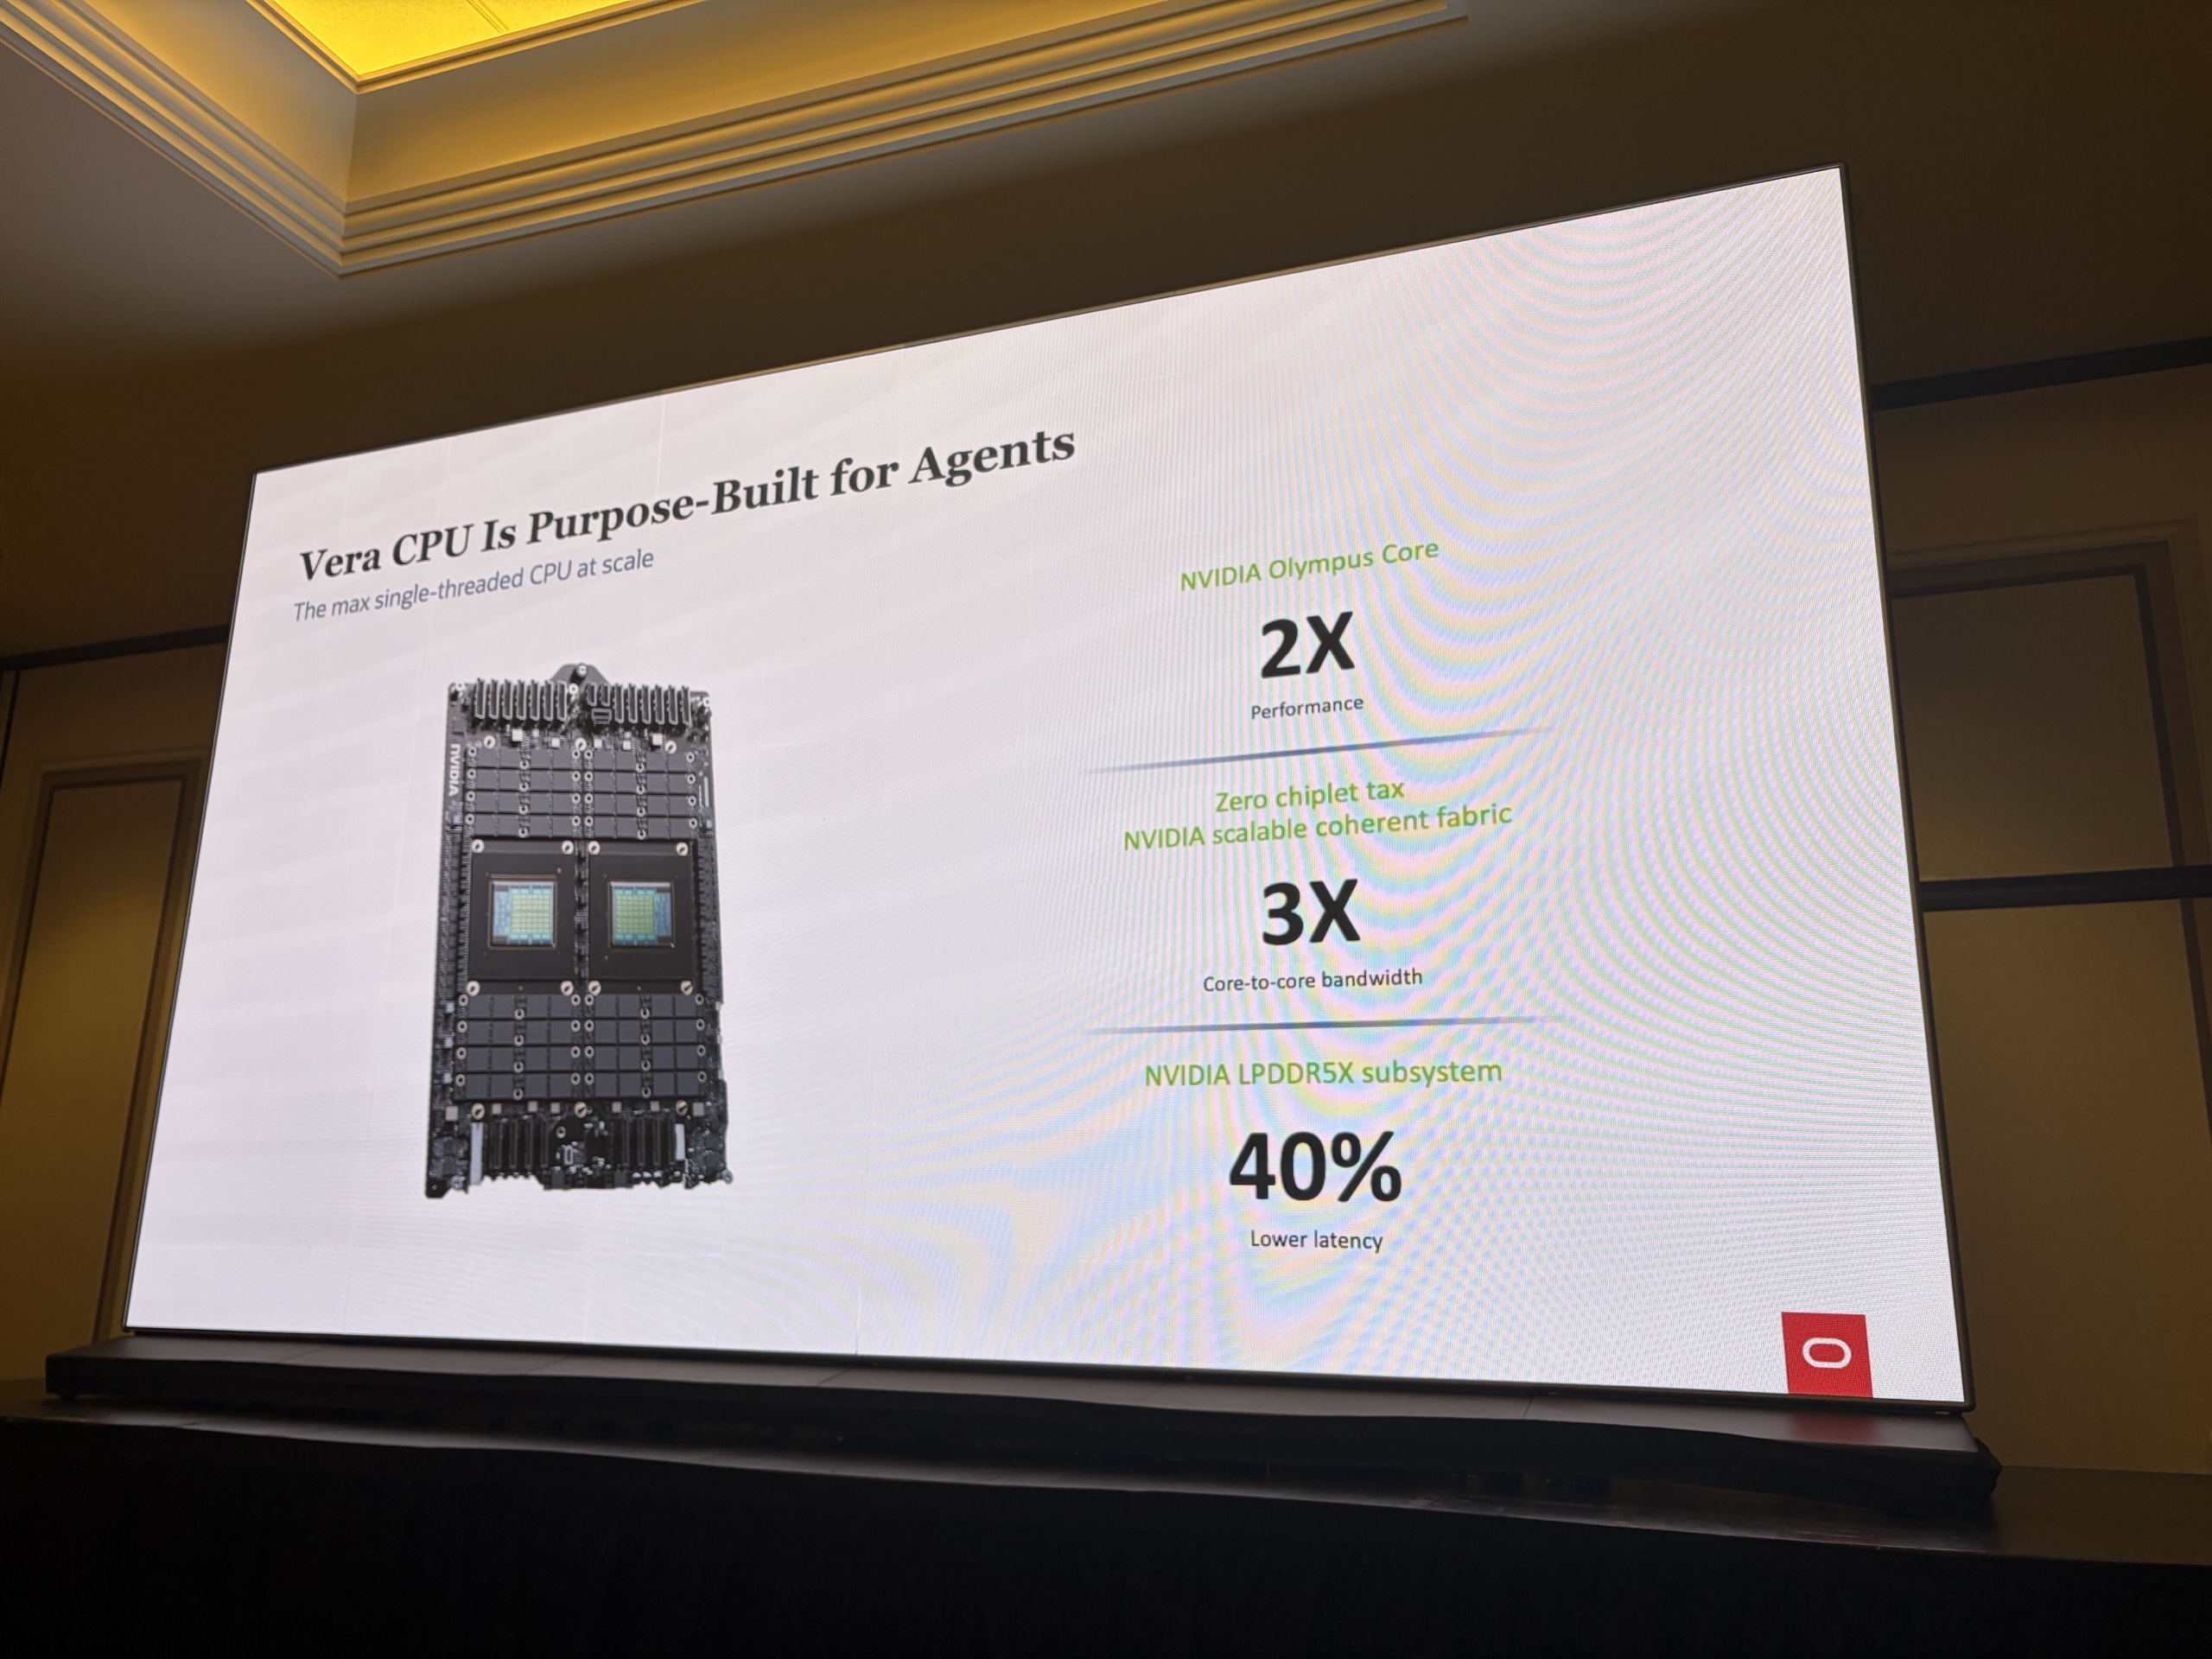
「Vera CPU Is Purpose-Built for Agents」。Olympusコア、Scalable Coherent Fabric、LPDDR5Xメモリの3本柱
Veraの特徴は次の3点に整理されていました。
- Olympusコア:NVIDIA初の独自設計のデータセンター向けCPUコアで、88コア/176スレッドの構成
- 全コアを1枚のチップに集積:チップレット間をまたぐ遅延をなくし、コア間帯域は3.4TB/s
- LPDDR5Xメモリ:1ソケットあたり最大1.5TB・1.2TB/sの帯域で、負荷が高い状態でもレイテンシが急に悪化しにくい
なお10月27日のOracleの発表によると、OCIのVeraインスタンスは2ソケットで176コア、メモリ1TB、ローカルNVMe 7.68TB、200Gbpsのネットワークを備え、Bare MetalとFlex VMで提供されます。当初15万CPUを用意し、今四半期中に一部のリージョンから提供を始める予定で、リージョン名と価格はまだ公開されていません。また、NVIDIAが示す「最大80%高速」は同社のベンチマークであり、OCIのインスタンス上で計測した値ではないと、Oracle自身が注記しています。
sandboxを1台に詰め込む時代と「Vera Sandboxes」
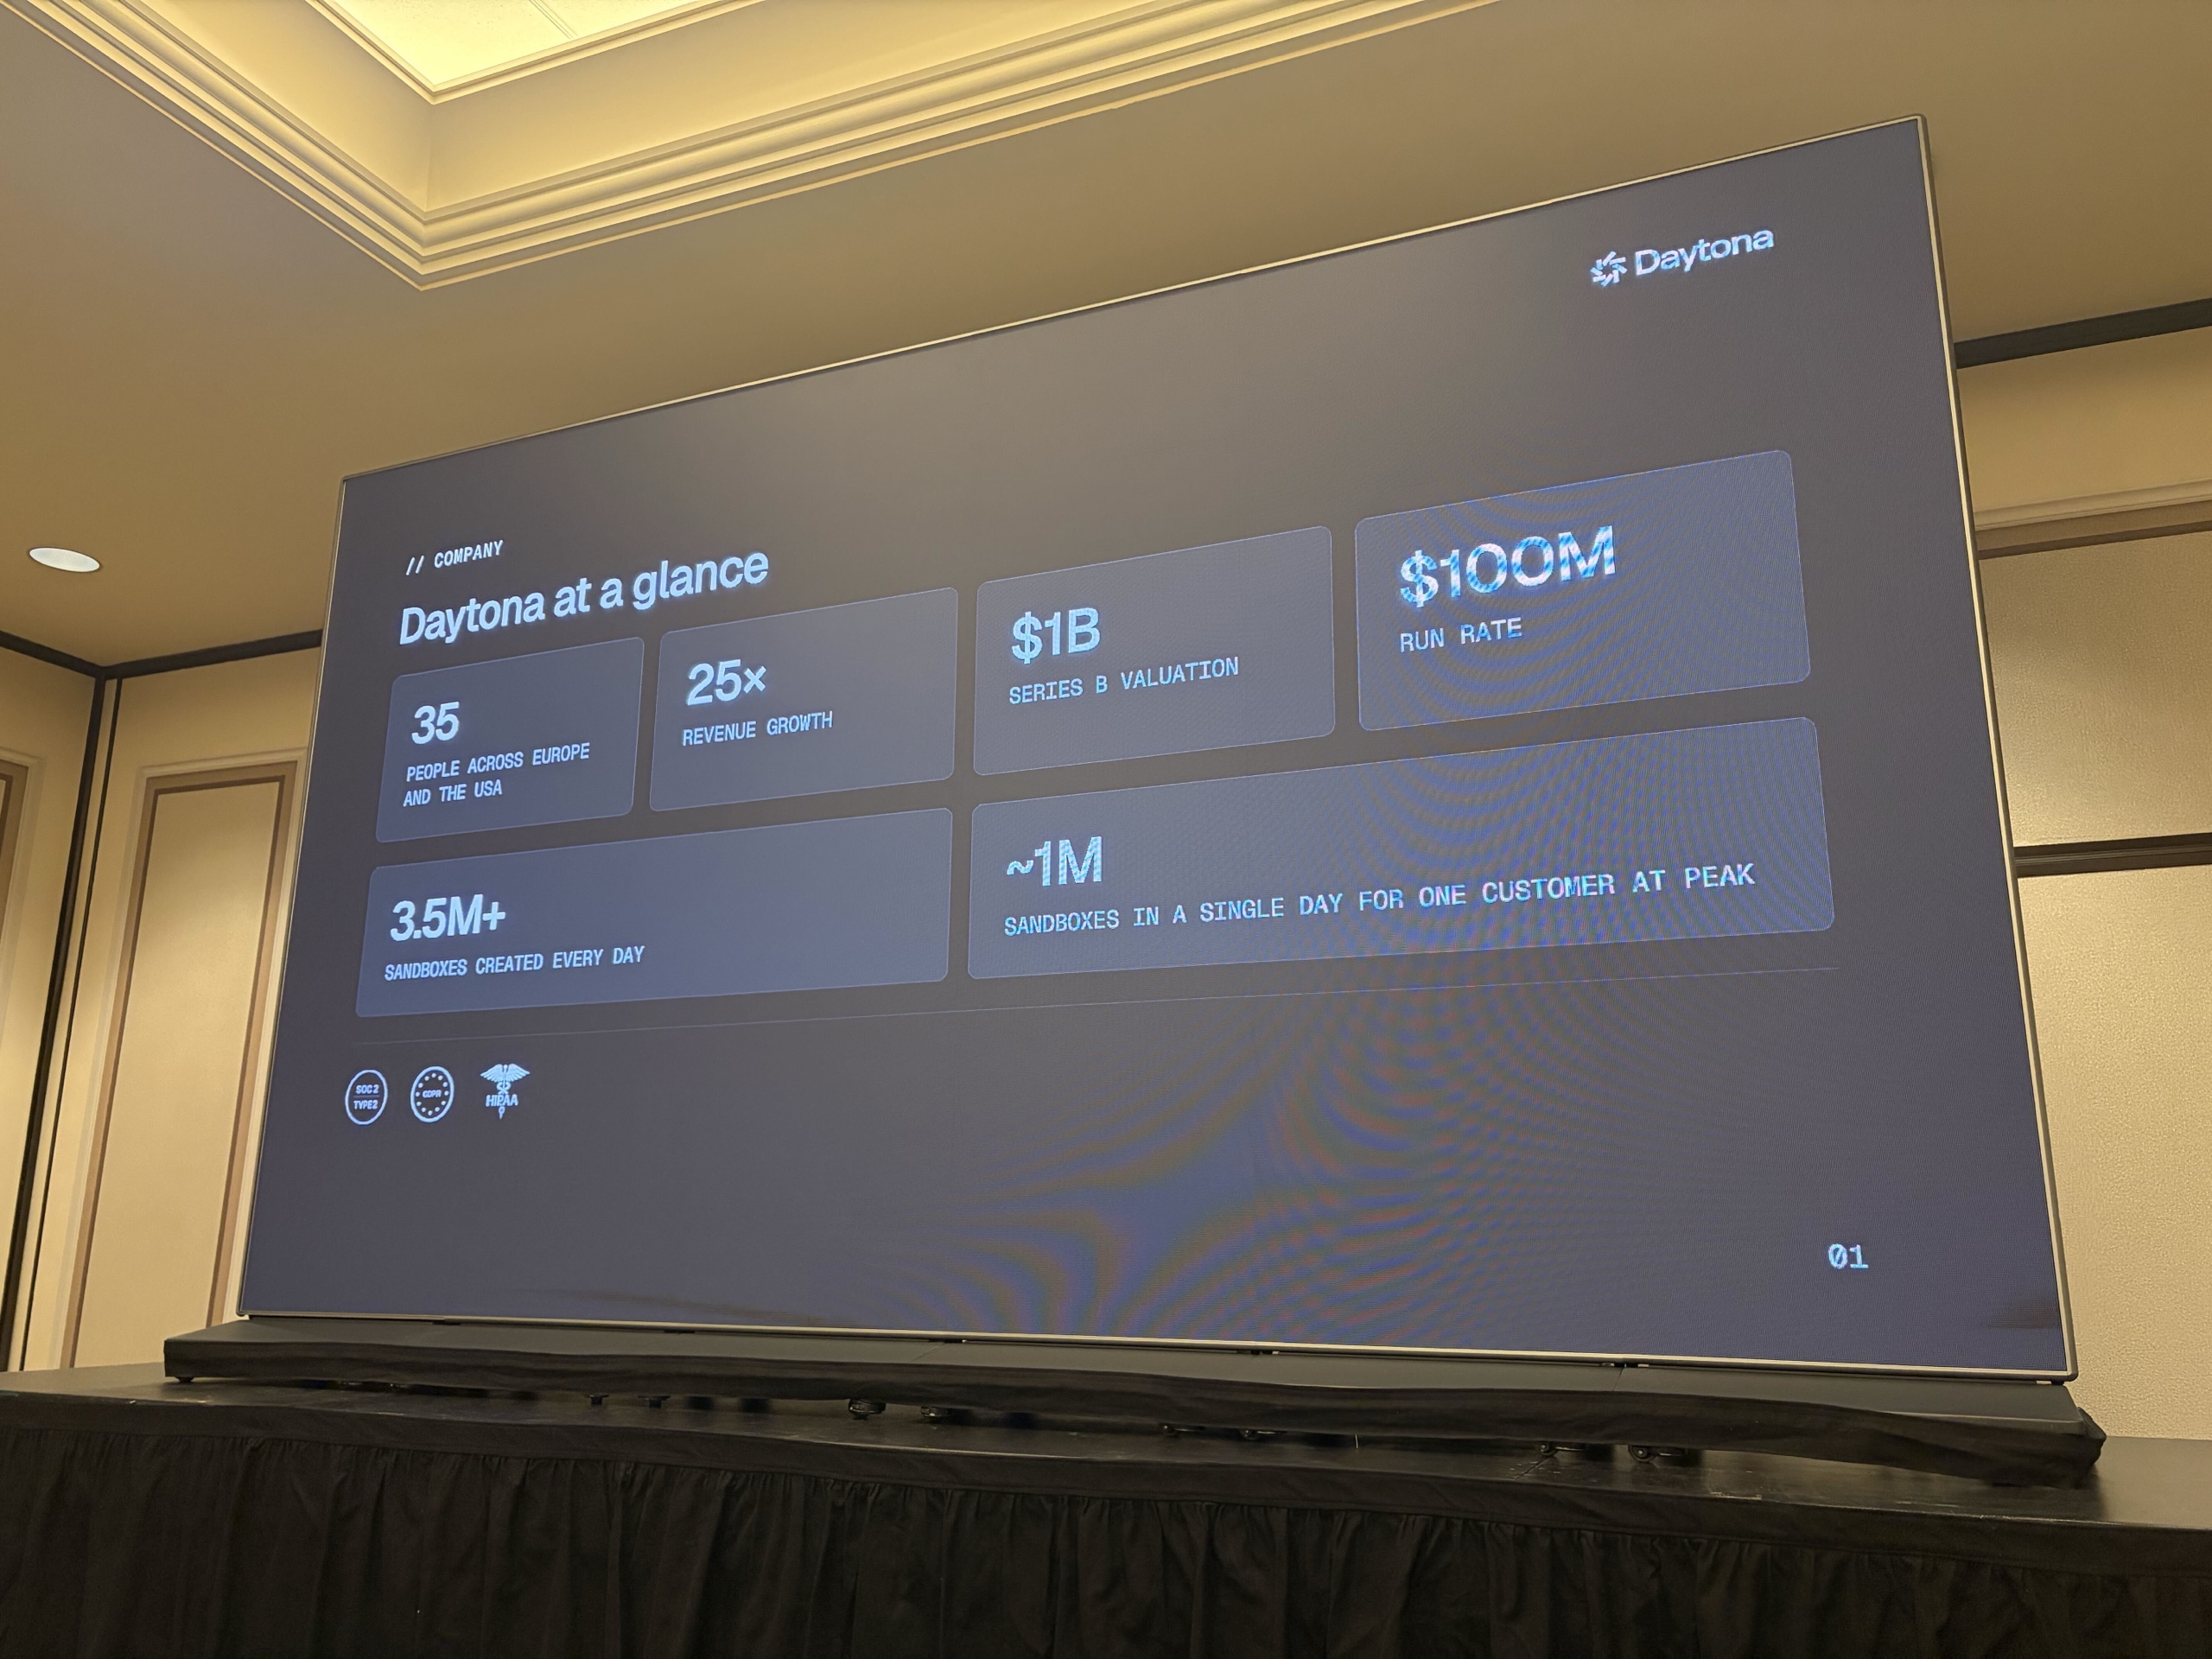
「Daytona at a glance」。Daytonaの事業規模を示したスライド
Josh Chang氏は、Daytonaを「エージェントにコンピュータを提供する会社」と紹介しました。主な用途は、モデルの強化学習で数千の隔離された環境を作っては壊す使い方と、PCを閉じても裏で何時間も作業を続けるバックグラウンドエージェントの2つです。毎日350万以上のsandboxを作成しているとのことでした。
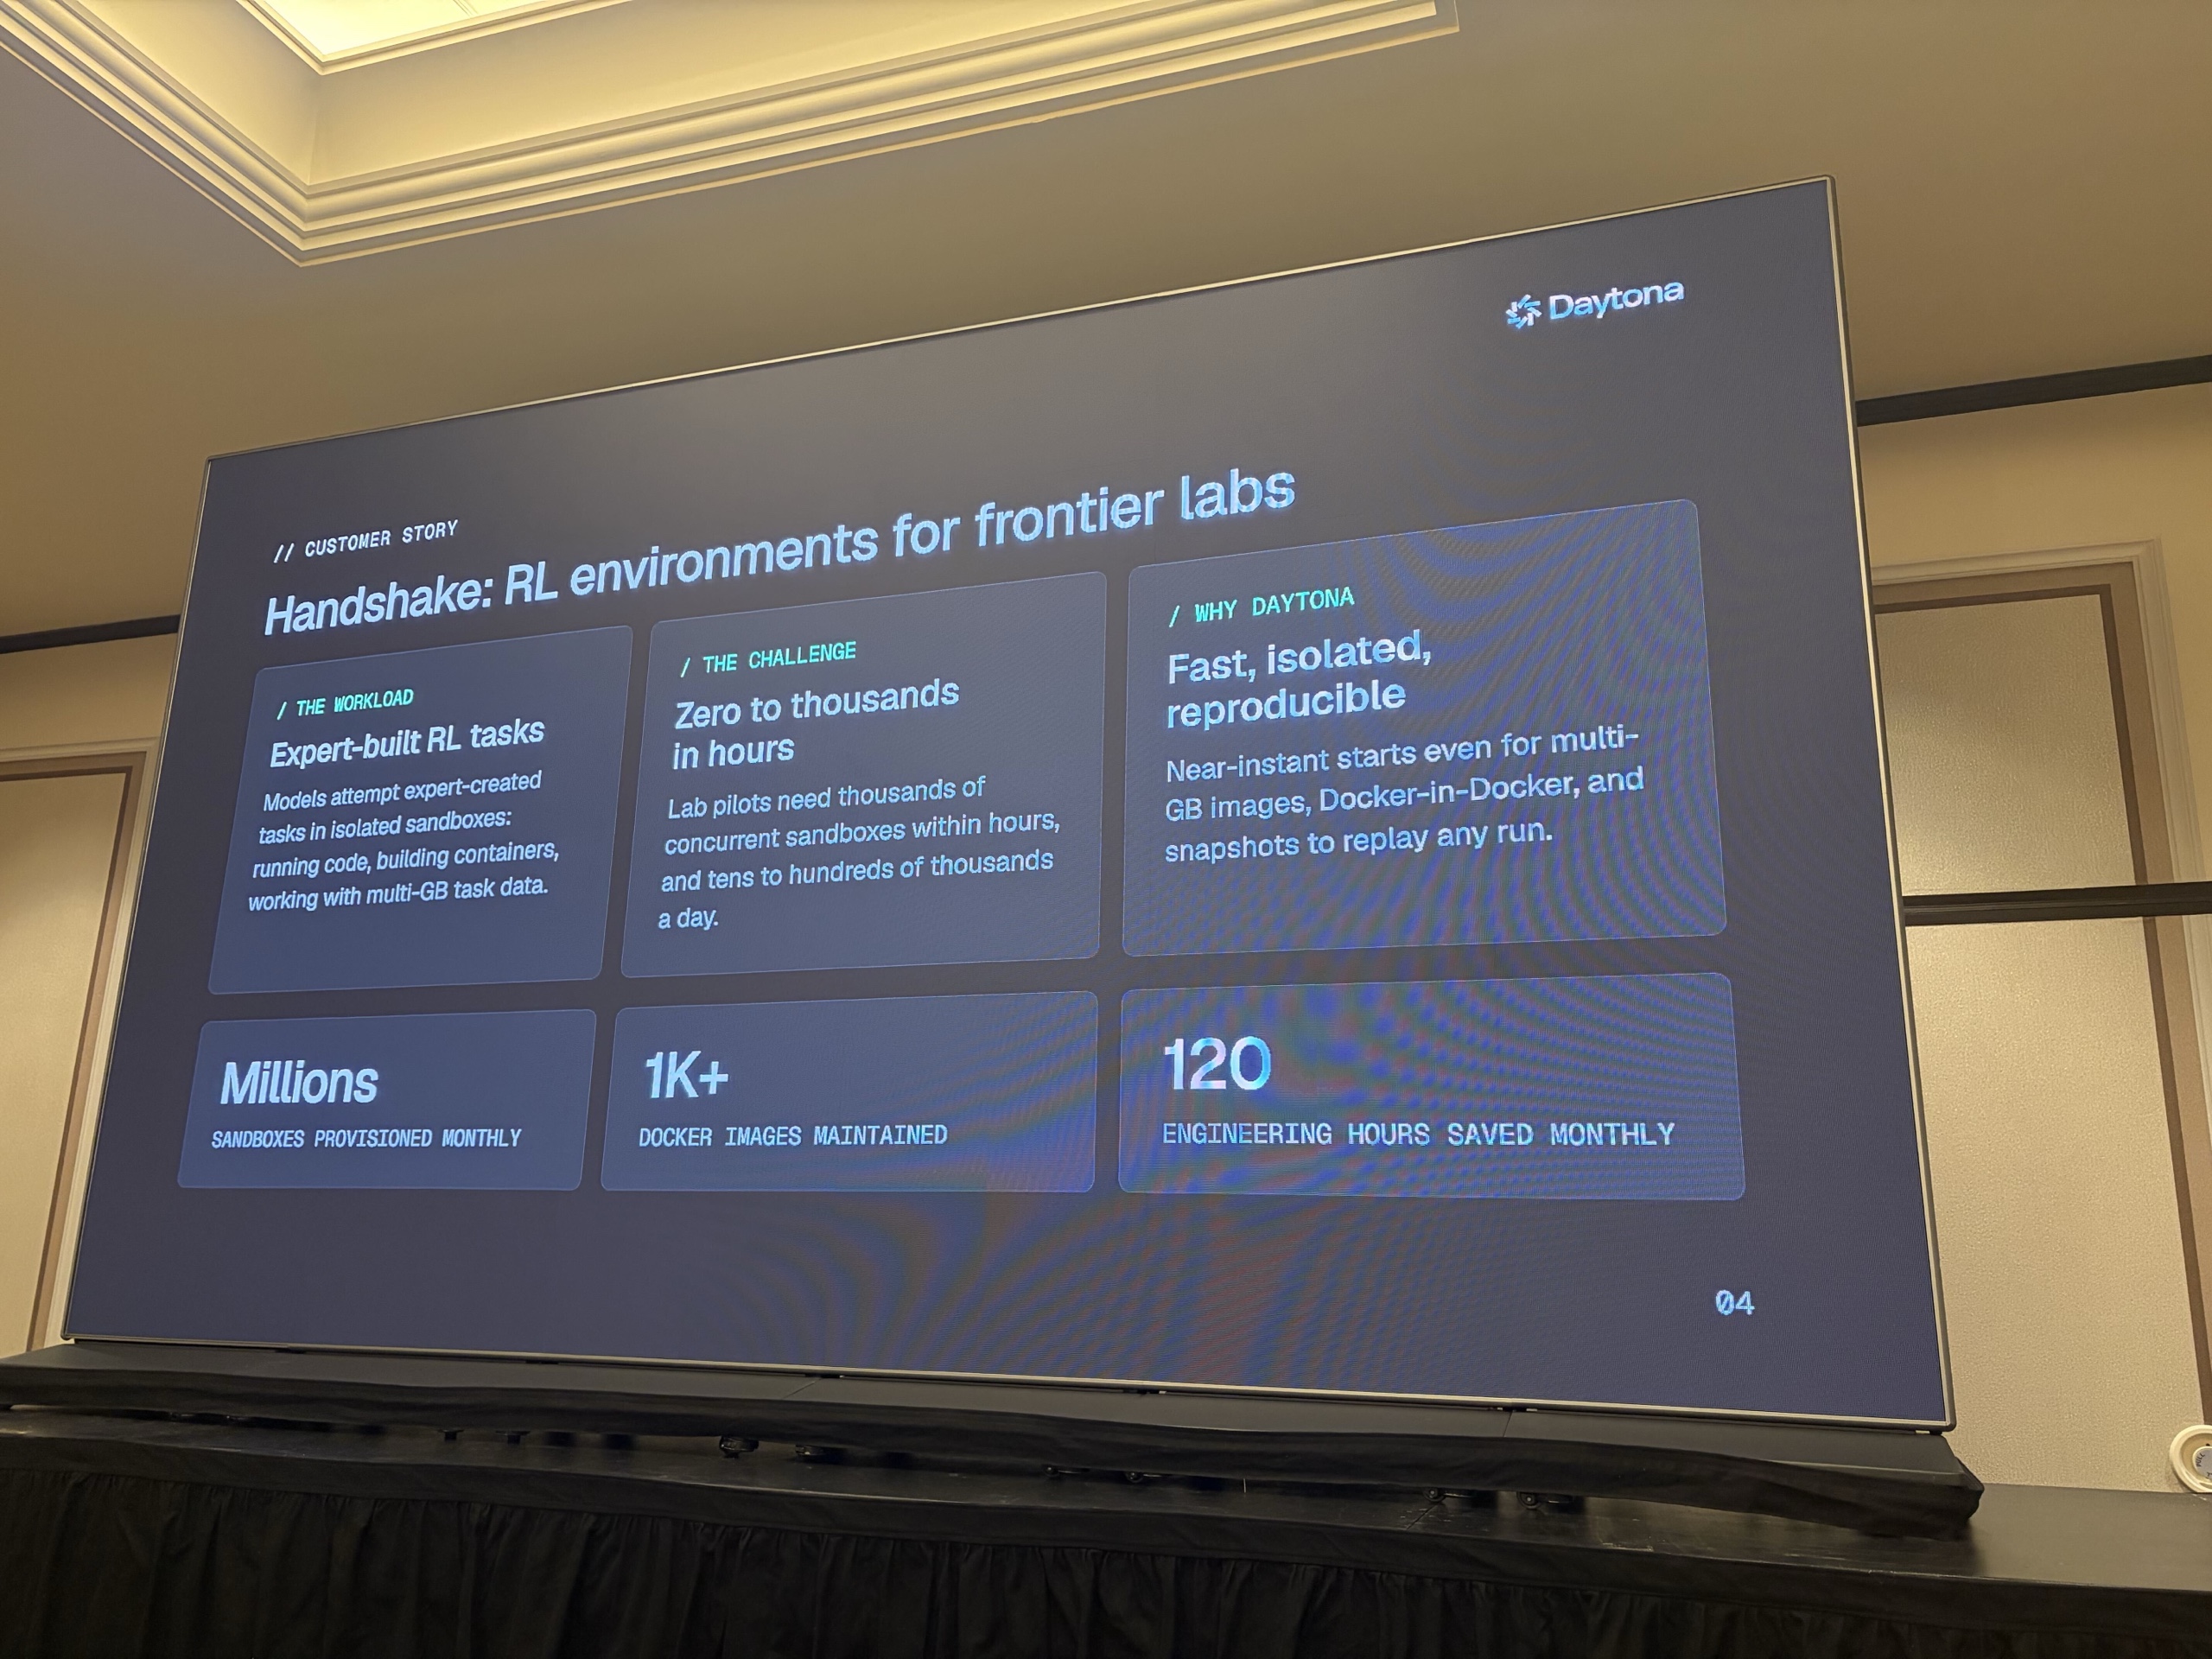
Handshake社の事例。フロンティアラボ向けの強化学習環境を、数時間で数千のsandboxまで立ち上げる
Veraについては、1台のホストにsandboxを詰め込むほど他社CPUとの差が広がる、という検証結果が紹介されました。Daytonaは10月7日に自社ブログでも、Vera上で1,000のsandboxを10.8秒、2,000のsandboxを27.4秒で立ち上げた結果を公開しています。
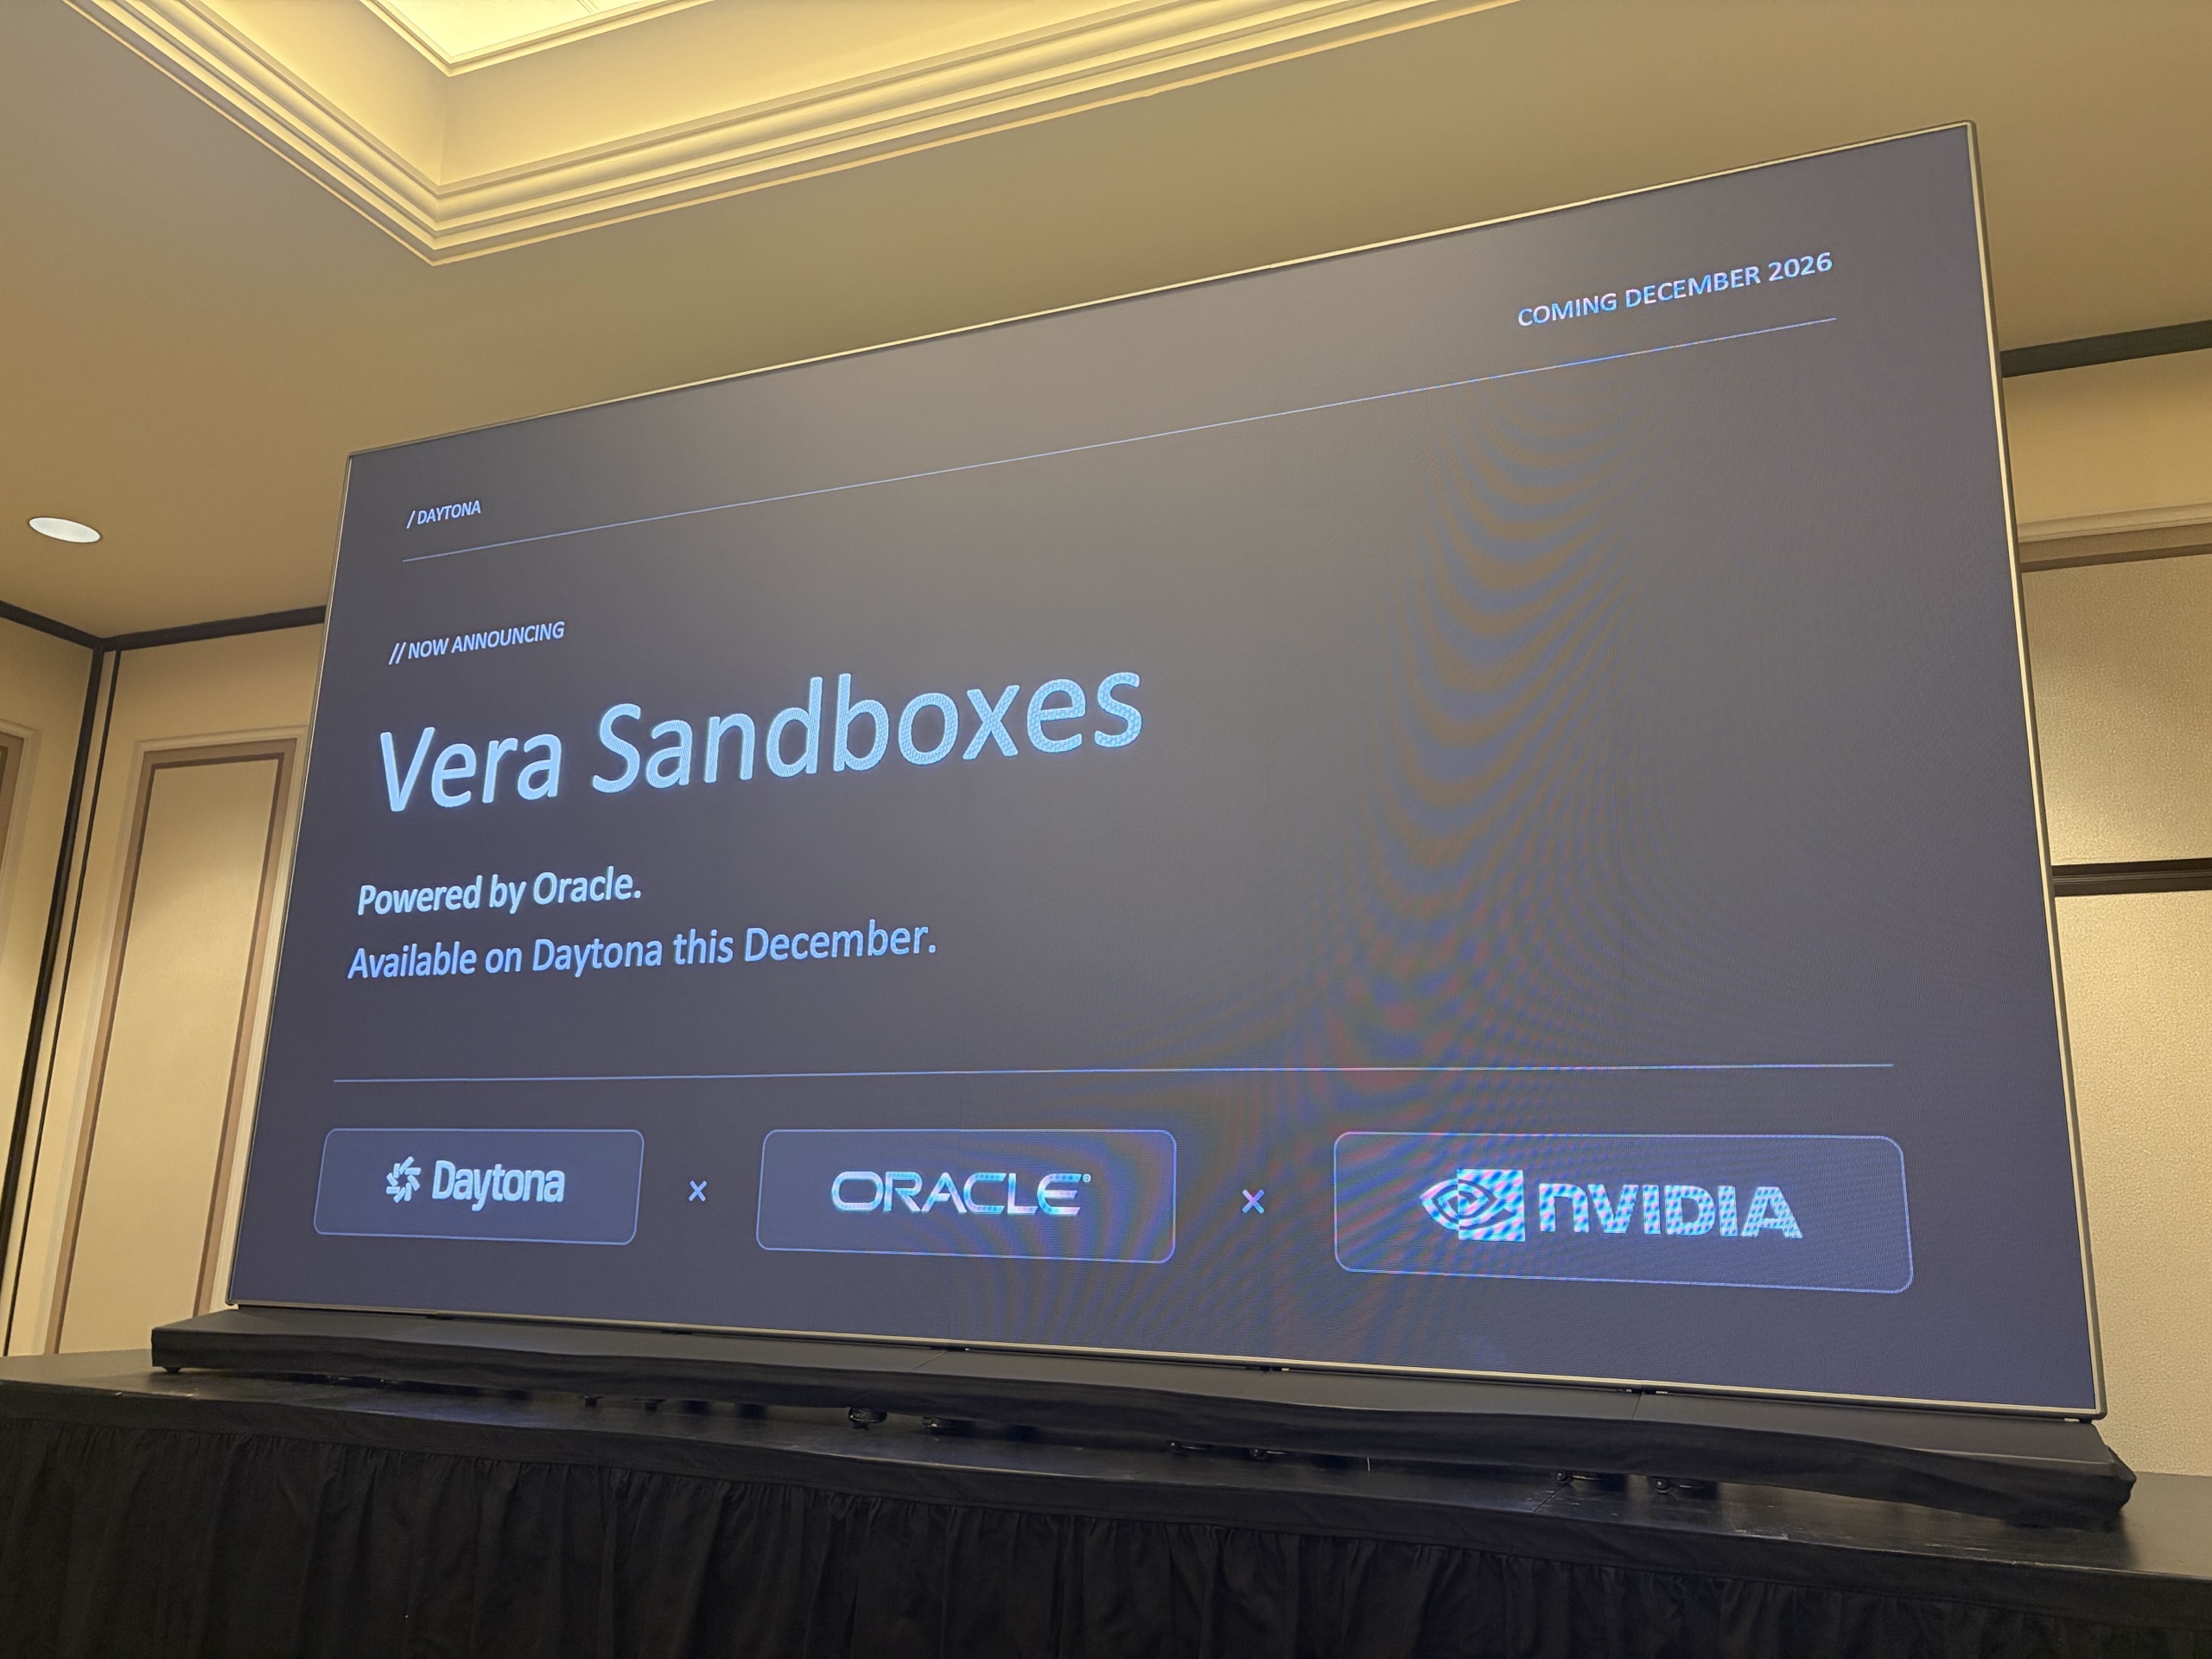
「NOW ANNOUNCING: Vera Sandboxes — Powered by Oracle. Available on Daytona this December.」
最後に、Oracle・NVIDIAとの協業による「Vera Sandboxes」を2026年12月にDaytonaで提供開始すると発表され、セッションは締めくくられました。
おわりに
以上、「Agents Need Infrastructure Too: Building the Backbone for Agentic AI」に現地参加してのセッションレポートをお届けしました。
本セッションを通して感じたのは、AIインフラの議論が「どのGPUを何枚確保するか」から、「モデル呼び出しの間に何が動いていて、それをどこで動かすか」へ広がりつつあることです。harnessと推論を分け、それぞれの需要で別々にスケールさせる。承認やログ、認証情報はモデルの外に置く。Vera CPUという新製品の話でありながら、その前提となる設計の考え方は特定のハードウェアに依存しないものでした。
最後までお読みいただきありがとうございました!
 簡単30秒