


サービスプラットフォーム事業部の佐久間です。
2026 年 6 月 25 日・26 日に幕張メッセで開催された AWS Summit Japan 2026 に現地参加してきました。
普段は自治体のガバメントクラウド環境(AWS)の運用保守を担当しています。規模の異なる複数の自治体を並行して見ている立場です。
そのため今回は、新サービスの発表よりも「運用の現場がどう変わるのか」という視点でセッションを選びました。
その中で一番刺さったのが、日本電気株式会社(NEC)様のスポンサーセッション「まだ人力?! 生成 AI を使ったクラウド運用作業効率化を始めよう!生成 AI を使ってクラウド・ガバメントクラウドの運用を楽にしませんか?」(セッション ID:PRT215-S、6 月 25 日)でした。聞きながら、これは今まさに自分が手でやっていることだと感じ、多くのメモを取りました。
この記事では、そのセッションの内容と、私が普段の運用業務で生成 AI をどう使っているかを並べて書きます。
※ 本記事は筆者個人の取り組みと見解によるもので、所属組織の公式見解ではありません。セッションの内容および記事中の数値は、当日の筆者の記録に基づく再構成であり、正確性を保証するものではありません。数値はいずれも登壇者の環境での実測・試算値であり、一般的な水準を示すものではありません。また制度や契約条件は変更される可能性があるため、実際の検討にあたっては最新の公式情報をご確認ください。
なぜ「ガバメントクラウド × 生成 AI」が気になったのか
自治体のガバメントクラウド運用は、やることが決まっている定型業務の比率がかなり高いです。よくあるものを挙げると、ざっとこれくらいあります。
- 日次:複数 AWS アカウントのバックアップ取得状況の確認と、作業記録表への記録
- 週次:AWS コストの週次比較と、増減があった場合の報告
- 月次:請求額と AWS 側の実績コストの突き合わせ
- 月次:数十ページ規模の運用報告書の作成
- 随時:Security Hub や Trusted Advisor の指摘に対する対応方針の整理
どれも難しい作業ではありません。ただ、案件の数だけ同じことを繰り返すのと、間違えると信用に直結するのが厄介なところだと思っています。
この手間を何とかしたい、というのはずっと思っていました。
ガバメントクラウドで生成 AI を使うための条件と活用法
以下、セッションで話されていた内容を私の理解で整理したものです。
1. クラウドに移行しても運用の手間はなくならない
登壇者の方がまず強調していたのが、移行したから運用が楽になるということはない、むしろ新しく発生する手間がある、という点でした。例として 2 つ挙げられていました。
アップデートへの追随
クラウドは日々アップデートされます。更新を確認するということは、そのまま自分たちが運用している環境への影響確認になります。場合によっては評価も必要ですし、運用手順書の書き直しまで発生します。
さらにガバメントクラウド自体のアップデートについても、セッションでは「年 2 回を上限に実施されることが予告されている」と説明されていました。この点は私の方で公開資料の裏を取れていないので、検討される際は最新の公式情報をご確認ください。
これらに工数を当てはめていくと、最大で年間 6 人月程度がここに取られる、という試算が示されていました。
日々のアラート対応
もう一つがアラートです。セッションで示されたのは 475 件/月という数字でした。注意したいのは、これがアプリケーションを載せる前、基盤を構築しただけの状態で発生した件数だという点です。
アップデート追随とアラート対応を合わせると、年間で最大 2,000 時間程度の対応コストになり得る、という話でした。
とはいえ、基盤だけでこれだけ鳴るというのは、運用に入っている方なら頷くところかなと思います。
2. ガバメントクラウドで生成 AI を使う 3 条件
ここが、公共の案件をやっている人間としては一番ありがたいパートでした。最新モデルが出たからすぐ使える、とはならないという話です。条件は 3 つ挙げられていました。
① 国内で利用可能なモデルであること
ガバメントクラウドは国内リージョン(東京・大阪)の利用が前提となるため、AI モデルについても国内リージョンで提供されているものを選ぶ必要があります。ただ、同じモデルでもバージョンによっては国内リージョンで提供されていない場合があるので、都度の確認が必要とのことでした。
② ISMAP 要件を満たすこと
ガバメントクラウドではサービス要件として、原則 ISMAP クラウドサービスリストへの登録が求められます。一方で、生成 AI モデルそのものが ISMAP に登録されているケースはほとんどありません。
では使えないのかというと、そうではありません。ここで示されたのが、クラウドサービスプロバイダーの生成 AI 開発基盤(AWS でいえば Amazon Bedrock)が ISMAP の言明対象範囲に含まれていれば、その基盤上で提供される個々の生成 AI モデルについては必ずしも ISMAP に登録されている必要はない、という整理でした。
この整理については、AWS も公式ブログ(Amazon Bedrock は ISMAP の言明対象であることについての考え方)で同様の見解を出しています。つまり Bedrock 経由で使う、という構成が効いてくるという話です。
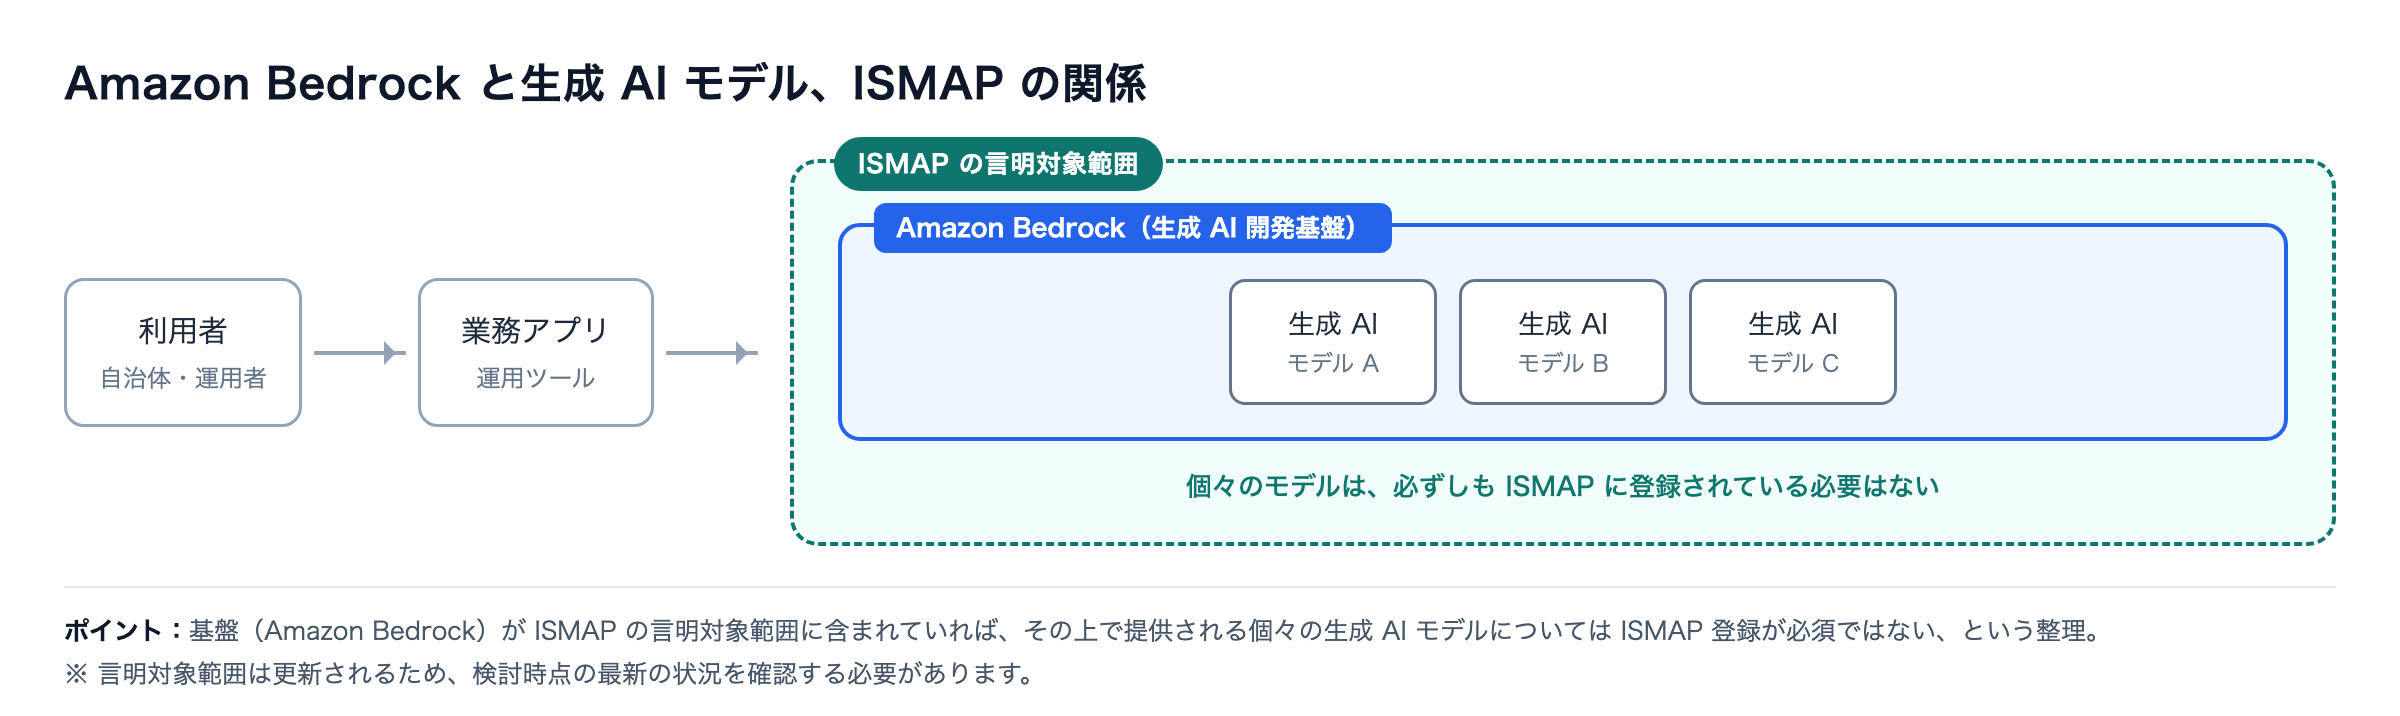
※ 上図は、AWS 公式ブログ「Amazon Bedrock は ISMAP の言明対象であることについての考え方」の内容を参考に筆者が作成したものです。
ただ、ISMAP の言明対象範囲は更新されるので、検討される時点での最新の登録状況は確認が必要かなと思います。
③ 契約関係の整理
見落としやすいのはここだと思いました。クラウドサービスの契約と、生成 AI モデルのライセンス契約が別建てになる場合があるため、AI ベンダー・デジタル庁・利用組織の契約関係を事前に確認することが推奨されていました。
あわせてセッションでは、ガバメントクラウドでは原則として AWS Marketplace が利用できないため、生成 AI モデルを利用する際にはその制限の緩和が必要になる、と説明されていました。具体的な手続きについては私の方で公開情報を確認できていないので、実際の検討時はデジタル庁や利用組織へご確認ください。
そして登壇者の方が付け加えていたのが、この契約関係の整理は民間環境でも同じように該当します、という一言でした。ガバメントクラウドに限った話ではないというのは、持ち帰るべきところかなと思います。
3. 紹介されていた 4 つの活用法
条件を踏まえた上で、NEC 様の取り組みとして 4 つ紹介されていました。
① クラウド最新情報の AI 自動分析・通知
AWS が公開するサービスの新着情報を、RSS(Web サイトの更新情報を自動で受け取る仕組み)を使って定期的に集めます。同じ内容が重複して流れてくることもあるので、それを整理したうえで、自分たちの AWS 環境でどのサービスをどう使っているか、という構成の情報と照らし合わせます。
そのうえで AI が、自分たちに関係のある更新かどうか、どれくらい重要か、確認や対応が必要かを判断します。内容を要約し、必要な情報だけをメールや Microsoft Teams へ通知する、という仕組みです。
AWS の新着情報を人が毎回すべて読むのではなく、一次的な仕分けを AI に任せて、人は影響がありそうなものだけを見る。そういう考え方です。
効果として挙げられていたのは、更新情報を自動取得するので対象サービスを取りこぼさない、属人性を排除できる、翌営業日には配信されるのでチームで同じ情報を見ながら検討できる、の 3 点でした。
誰かが情報を整理して展開する運用から、AI に代行させて人は判断に集中する運用へ、という言い方が印象に残っています。
② GCAS ガイドの自然言語検索
GCAS はデジタル庁が提供しているオンボーディング用の Web サービスで、情報提供・問い合わせ対応・利用申請などを担っています。その中の GCAS ガイドに運用関連の情報がまとまっていて、一部が一般公開されています。
ただ、情報量が膨大なので、キーワード検索だと目的の記述になかなか辿り着けません。そこでセッションでは、登壇者から「この情報は利用者による加工が認められている」という説明があり、GCAS ガイドを定期的に取り込んで、LLM を挟んだ検索(RAG:Retrieval-Augmented Generation)を構成した、という事例が紹介されていました。
同じことを試される場合は、GCAS ガイドのサイトポリシーとコピーライトポリシーをご自身でご確認いただいた方が良いかと思います。
デモでは「Government Cloud のモダン化の定義って何ですか」「利用者はまず何をやるべきでしょうか」「利用してはいけない AWS サービスはありますか」といった漠然とした質問に対して、日本語の回答と、出典元がガイドのどこに書かれているかが返ってくる様子が紹介されていました。
出典が示されるのは、公共の案件ではかなり重要な点だと思います。
③ セキュリティアラートの AI 自動分析・通知
AWS Security Hub などから上がってくるイベントを集約して、自組織の環境情報やセキュリティ方針を加味して、推奨対応つきの要約に変換して配信する仕組みです。
ここで語られていた効果が、個人的には一番共感できました。
- アラート対応の平準化(人による判断のブレを解消して、対応のスタートラインを揃える)
- 夜間・休日でも同じ品質で対応できる
- あらかじめ設計情報や組織の対応方針を与えておくことで、その組織にとってのベストプラクティスに沿った対応を運用者が実行できる
膨大すぎて、そもそも見なくなるという状態が一番まずい、という指摘はまったくそのとおりだと思いました。
④ MCP を活用したプロアクティブな運用
4 つ目が MCP(Model Context Protocol)を使って、人に尋ねるような感覚で、運用している AWS 環境の情報を取得・検索するという活用です。
デモで示されていた問いかけは、たとえばこういうものでした。
- 「過去 6 か月でクラウド環境に問題が起きていないか教えてください」
- 「直近 6 か月の AWS 利用料を月別・サービス別に集計し、20%以上増加したサービスがあれば原因を分析してください」
実際の環境情報を取得した上で回答するので、ハルシネーションを一定抑制できる、という点も触れられていました。
興味深かったのが、ここから先の現場の制約の話です。MCP を使うと生成 AI が運用ツールを直接操作できてしまいます。一方で利用端末にはソフトウェアの追加導入制限やインターネット利用制限があって、そもそも MCP クライアントを入れられないケースも多いです。
では、こういうときに公共セクターは何をしてきたかというと、「分離しましょう」という答えでした。
セキュリティレベルの異なる環境同士を、セキュアな方法で橋渡しするという考え方です。具体的には、運用者は専用網を経由して AWS 上の分離 PC やセキュアブラウザにアクセスし、そこから LLM・MCP サーバー経由で分析対象の AWS 環境を調査する、という構成でした。
リモートデスクトップ側でファイルの授受やクリップボード経由のやり取りを制限できるので、手元の端末はセキュアなまま AI と MCP を使える、という形です。
昔からある考え方をそのまま当てはめてきているのが、かえって実装として現実的だと感じました。
生成 AI を日次・週次・月次の定型運用に使う
ここからは、私が普段の運用業務で生成 AI をどのように使っているかを書きます。
具体的な作業環境や接続方式、認証構成については、案件ごとの運用ルールやセキュリティ要件に依存するため、本記事では扱いません。日次・週次・月次の定型作業を効率化するときの考え方と、実際に何を処理させているかに絞って紹介します。
前提:権限と情報の取り扱い
手順の前に、前提を書いておきます。
- AI に渡す情報は、作業手順や判断基準など、業務上必要な範囲に限定し、案件ごとのルールに従って取り扱っています
- 生成 AI に任せているのは情報の確認と分析が中心で、本番環境への変更操作は自動実行させていません
処理を確認と分析に限ることは「壊さないこと」の担保にはなりますが、「情報が外に出ないこと」の担保にはなりません。運用で生成 AI を使う場合は、権限設計と、入力してよい情報の範囲を必ずセットで決める必要があると思っています。どこまでの情報を、どのサービスに、どういう契約条件のもとで渡すのか。ここは組織のルールに沿って個別に判断すべきところで、記事として一般化して言えることではありません。
日次:バックアップ取得状況の確認
複数の AWS アカウントについて、AWS Backup の保護対象リソースと最終バックアップ日時を確認して、正常であれば作業記録表にチェックを入れる、という作業です。
これを「日次確認お願い」と投げるだけで済むようにしました。裏側でやっているのは、
- AWS Backup の保護対象リソースと最終バックアップ日時を取得
- リソース種別ごとの件数と最終バックアップ日を集計して、平常時の基準値と突き合わせる
- 結果を報告して、問題がなければ作業記録表の該当日の列にチェックを入れる
という流れです。
地味ですが、効いているのは 2 の基準値との突き合わせだと思っています。平常時のリソース構成を基準値として AI 側に持たせておくことで、件数が減っていること自体に気づけるようになりました。目視だけだと「日付が今日なら問題なし」と流してしまいがちなところです。
実際、この確認を仕組み化したことで、バックアップ自体は走っているけれど特定のリソースだけ対象から外れている、といった日付を見るだけでは気づけない類の異常を拾えるようになりました。
なお、記録表への書き込みの前には必ず現在値を読んで、日付列が一致しているか、二重記入になっていないかを確認するようにしています。
週次:コストの週次比較
先週(月〜日)と先々週(月〜日)の AWS コストを比較して、大きな増減があれば定例会で報告する、という作業です。
ここは、AI に任せる前に人間側が落とし穴を言語化しておく必要があった典型例でした。素朴に「直近 7 日と、その前の 7 日を比べて」と頼むと、次の 3 つで簡単に誤判定します。
- Cost Explorer の直近 1〜2 日は未確定。S3 が丸ごと 0 だったりするので、含めると「減った」と誤って判定する
- 月初 1 日目には月次課金が乗る。毎月同額で計上される固定費があって、通常日とは桁の違う日が出る
- 上記 2 つが重なると、月をまたぐ「直近 7 日」では +50% みたいな数字が平然と出てくる
そこで「確定した週どうしを、月曜〜日曜で区切って比較する」という条件を明示的に持たせています。これは運用手順書が想定している比較単位(確定した 1 週間どうし)を読み解いた上での整理です。
AI に渡す前提条件の質が、そのまま出力の質になるというのが、週次作業で一番学んだところかなと思います。
月次:請求額と実績コストの照合
請求された月額と、AWS 側の実績利用料が一致するかをアカウント単位で照合して、結果を報告する作業です。
対象月のコスト実績を取得して、当月の為替レートで円換算して突き合わせます。ポイントは USD を丸めずに計算して、円換算後に四捨五入することです。ここを厳密にしないと数円ずれて、そのたびにどちらが正しいのかを調べ直すことになります。
もう一つ、これは AI ではなく私が踏んだ失敗なのですが、対象月の指示を一度取り違えたことがありました。当月を指定すると月途中のデータになるので、一致率が 67% 程度まで落ちます。この数字で気づけたので、報告前に対象月を修正できました。
そのため今は「一致率が 60〜70% 台なら、まず対象月の取り違えを疑う」という判断基準自体を AI 側に持たせています。
失敗を手順書に書き足すのではなく、AI への指示に書き足す。同じ失敗が二度と起きないようにする方法としては、これはかなり有効でした。
月次:運用報告書の作成
一番手間がかかっているのがこれです。数十ページ規模の月次運用報告書を、複数の案件ぶん毎月作成しています。
材料はチケット管理システムのエクスポート、CloudWatch と Trusted Advisor の確認結果、Cost Explorer の実績、セキュリティ関連のレポート類です。これらを決まったフォーマットに落とし込んでいく作業になります。
AI に任せているのは、
- 前月分の報告書と当月の材料を突き合わせて、更新すべき箇所を差分として抽出する
- コストのグラフを実績値から作図する
- 各スライドの数値の内部整合を計算し直す(各列の合計が全体合計になっているか、平均解決時間が個別の解決日数の平均と一致しているか、当月の「前月発生件数」が先月の実績と一致しているか)
このあたりです。
また、毎回必ず行っているのが 19 項目の自己検証です。前月分の成果物と機械的に比較して、フォント・文字サイズの揺れ、段落の配置やインデント、表の寸法と枠からのはみ出し、旧月・旧ファイル名の残存、空セル、表記ゆれ、といった観点をチェックしてレビュー記録表にまとめています。
この検証を入れてから見つかるようになった不具合で、これは人手では難しいと感じたものが 2 つあります。
- 結合セルの中に文字が入っている。表示上は見えないのでレビューでは気づけないのですが、中身としては「記入したつもり」になっているので、実質記入漏れです
- Unicode の正規化形式の違い(NFC / NFD)によって、半濁点や濁点が別の文字として分離されることがあります。「ポ」が「ホ + ゚(半濁点)」の 2 文字になるなど、見た目は同じでも文字コード上は異なるため、単純な文字列検索では一致しません。
こういう見た目では分からない差分を機械的に潰せるのは、AI というより自動化全般の効能ではあります。ただ、毎月ゼロから検証スクリプトを書かなくてよくなったのは、間違いなく生成 AI のおかげかなと思っています。
線引き:私の担当範囲で決めていること
ここは意識的に決めています。以下は私が担当している案件での運用ルールで、会社としての統一方針を示すものではありません。
- 生成 AI を活用する処理は、情報の確認・分析を中心とし、本番環境への変更操作は自動実行させない。コード化や差分の提示までは AI、適用は人の手か CD パイプライン経由にする
- 顧客や社外から見える書き込みは、必ず人の承認を経る。チケットの起票、メール送信、成果物の提出やアップロードなど
- 社内で完結する定型記録については、書き込み前に現在値を読んで、日付列の一致と二重記入でないことを機械的に確認した上で記録する。記録した結果は人が目視で確認する
この線引きをはっきりさせたことで、どこまで任せていいか迷う時間がなくなりました。運用で生成 AI を使う上では、実は機能そのものより効いている部分かなと思っています。
セッションの内容と自分の運用を突き合わせて
聞いていて一番良かったのは、向かっている方向が同じだったことです。
セッションで繰り返し語られていたのは、AI が要約・整理・提案を行って人は判断と改善に集中する、属人化を排除する、夜間休日も同じ品質で、という点でした。私が日次・週次・月次でやっていることも、突き詰めれば判断基準を言語化して AI 側に持たせて、人間は例外だけを見る、という同じ構造かなと思います。
一方で、特に印象に残ったのは次の 2 点です。
環境情報の渡し方を設計しているか
私のやり方は、必要なときに必要な前提条件を都度渡す形です。対してセッションで紹介されていたのは、自組織の環境設計情報を RAG やインコンテキストで常に参照させるという構成でした。アラートの要約にも、更新情報の優先度判定にも、同じ設計情報が効いてきます。ここは仕組みとして一段上だと思いました。
セキュリティ要件まで含めて設計すること
セッションで印象的だったのは、生成 AI や MCP を運用環境へ組み込むときには、AI の機能だけでなく、既存のセキュリティ要件やアクセス経路まで含めて設計する必要がある、という点でした。分離 PC やセキュアブラウザを利用する構成は、そのための一つのアプローチとして紹介されていました。
ガバメントクラウドで生成 AI を使う話は、モデルの性能の話ではなく経路と契約の話である、というのが今回の一番の学びでした。
また、条件の 3 つ目にあった、契約関係の整理は民間案件でも該当するという指摘についても、持ち帰って確認しようと思っています。
なお、ガバメントクラウドまわりの記事は iret.media にほかにもあります。過去の同イベントのレポート【AWS Summit Japan 2024】ガバメントクラウドで考えておくことや、運用管理補助者の視点で書かれたガバメントクラウドの接続トラブルシューティングも、あわせて読んでいただければと思います。
さいごに
AWS Summit というと新サービスの発表に目が行きがちですが、今回持ち帰ったのは運用の現場を変えるための条件整理の方でした。
ガバメントクラウドで生成 AI を使うには、国内リージョンでの提供、ISMAP 要件(CSP の生成 AI 基盤の言明対象範囲という整理)、契約関係と Marketplace 制限への対応、この 3 つを確認する必要があります。使えるかどうかの出発点がサービス選定にあるというのは、提案する側として押さえておきたいところです。
その上で、日々の運用でできることは思っているより多いというのが実感です。私自身、最初にやったのは大げさな基盤構築ではなく、毎日やっている確認作業の判断基準を文章で書き出すというだけのことでした。それが結果的に、そのまま AI への指示になっています。
運用手順の言語化は、これまで引き継ぎのためにやることでした。これからは AI に渡すためにやることになっていくのかなと思います。
受け身の運用から、問い合わせる運用へ。まずは身近な定型業務を一つ、というところから始めてみてはいかがでしょうか。
最後までお読みいただき、ありがとうございました。

 簡単30秒