


はじめに
DX開発事業部の田村です。
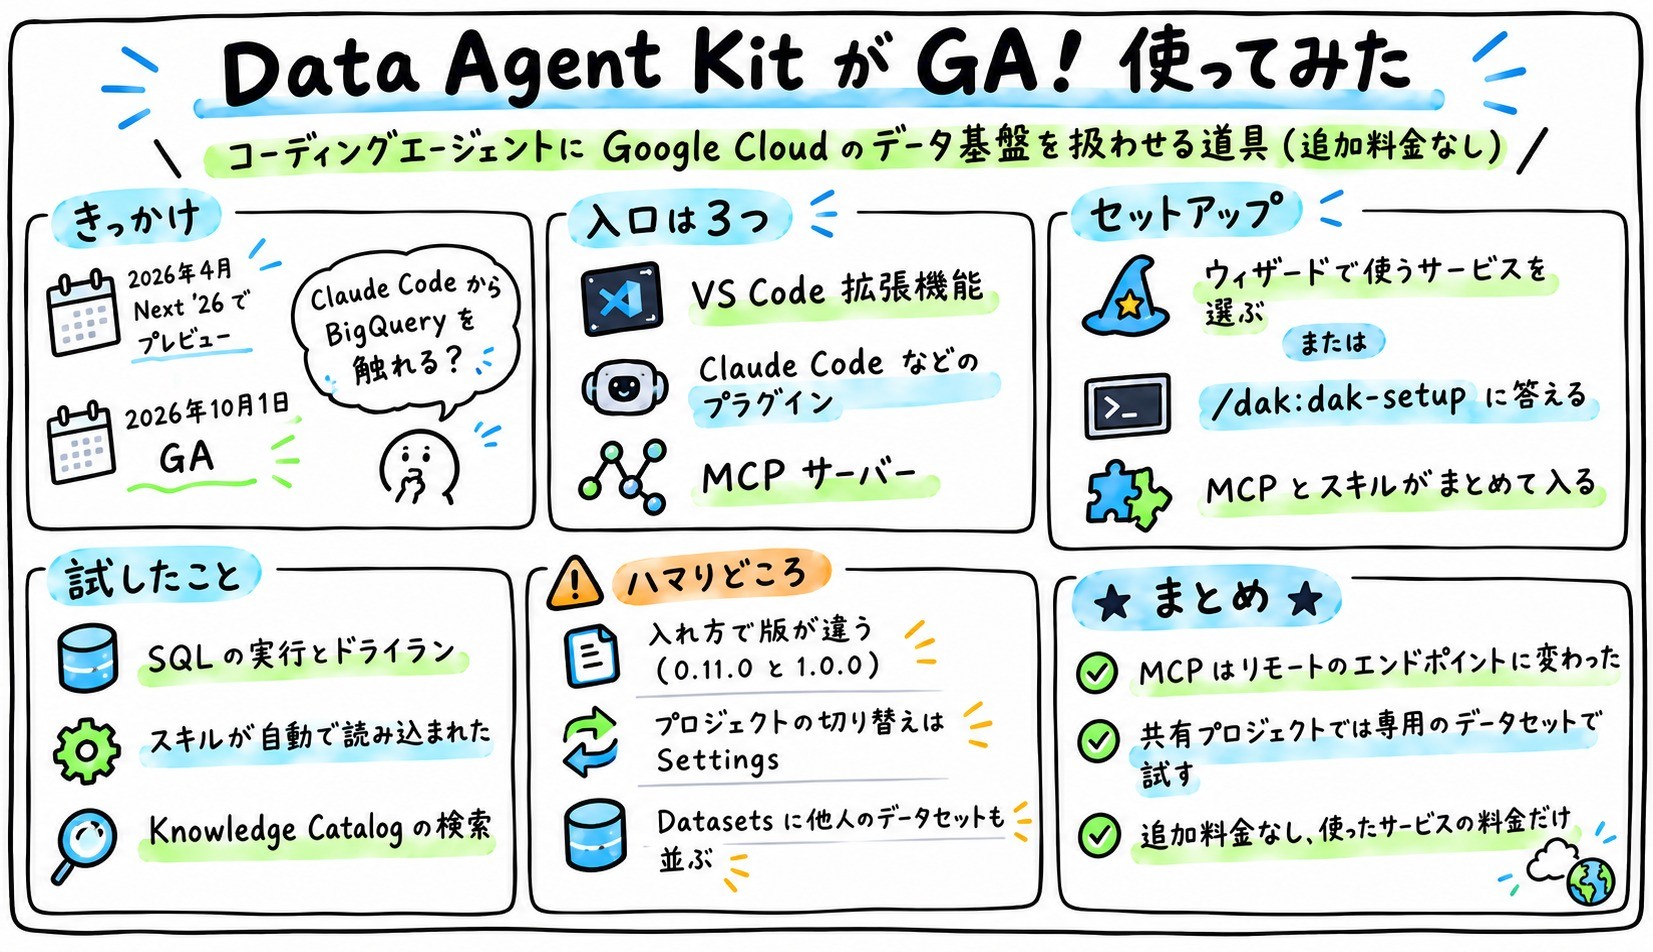
2026年10月1日に、Google Cloud の公式ブログで Data Agent Kit の GA が発表されました。Claude Code などのコーディングエージェントや VS Code から、BigQuery をはじめとする Google Cloud のデータ系サービスを操作するための仕組みです。2026年4月の Google Cloud Next ’26 で発表され、プレビューを経て、今回 GA になりました。
「エージェントに BigQuery を触らせる」という使い方は、これまでも MCP サーバーを自分で立てれば実現できました。それが公式の拡張機能とスキルのセットになり、GA したことで何が変わるのかが気になったので、実際にプロジェクトへリソースを作って試しました。
TL;DR
Data Agent Kit とは
公式ブログとドキュメントによると、Data Agent Kit は次の 2 つの形で提供されています。
| 形態 | 中身 | 対象 |
|---|---|---|
| IDE 拡張機能 | VS Code 系エディタ向け。データ資産のツリー表示、SQL エディタ、ノートブックなど | VS Code、Cursor、Antigravity IDE |
| エージェント用プラグイン | MCP ツールとスキルを、自然言語で使えるようにする | Claude Code、Codex CLI、Antigravity CLI など |
ライセンスは Apache-2.0 で、GitHub の GoogleCloudPlatform/data-agent-kit-plugin で公開されています。
GA で加わったものとして、ブログでは次が挙げられています。
- BigQuery Graph(グラフの作成と GQL でのクエリ)
- Bigtable
- Managed Service for Apache Spark
- セットアップの簡略化(サインインして、使うサービスを選ぶだけ)と、カタログ読み込みの高速化
Cloud Shell と Cloud Workstations には、拡張機能が最初から入っているそうです。
対応しているサービス
ブログとドキュメントの記載を整理すると、次のとおりです。
| 分類 | サービス |
|---|---|
| 分析 | BigQuery、BigQuery Graph |
| データベース | Spanner、AlloyDB、Cloud SQL、Bigtable |
| 処理 | Managed Service for Apache Spark、Dataflow、Managed Service for Apache Airflow、Cloud Storage |
| カタログ | Knowledge Catalog |
| 連携 | AWS Glue、Databricks Unity Catalog(取り込まずにクエリ) |
概要のドキュメントには制限事項として、AlloyDB は IAM データベース認証のみに対応していること(Cloud SQL は IAM 認証と組み込み認証の両方に対応)、オーケストレーションの自動デプロイは GitHub Actions のみ対応であることが書かれています。
ADK との違い
名前が似ている Agent Development Kit(ADK)は、エージェントを自分で作って動かすためのフレームワークです。Data Agent Kit は、すでに使っている Claude Code などのエージェントに、Google Cloud のデータを扱う機能を足すものです。
検証環境
BigQuery に、検証用のデータセットとテーブルを用意しました。
| 項目 | 内容 |
|---|---|
| データセット | dakblog_verify(asia-northeast1) |
| テーブル | orders(500 行)。注文 ID、顧客 ID、注文日、商品、金額 |
| 商品 | book、pen、bag、lamp の 4 種 |
ほかの作業と区別するため、専用のデータセットを使いました。
VS Code 拡張機能から使う
拡張機能のインストール
拡張機能は googlecloudtools.datacloud v1.0.0 を使いました。
空のフォルダーをワークスペースにして開き、フォルダーを信頼すると、アクティビティバーに Data Agent Kit のビューが出ます。ツリーには CATALOG、CLOUD STORAGE、BIGQUERY、APACHE SPARK、DATAFLOW、DATABASES、DATA ENGINEERING、SETTINGS が並びます。
BIGQUERY を開くと、「BigQuery integration is not enabled」と表示されます。BigQuery API 自体は有効なプロジェクトでも出ました。API の状態ではなく、拡張機能の側でそのサービスを使う設定がまだ、という意味のようです。
この項目を選ぶと、「Select services」のウィザードが開きます。
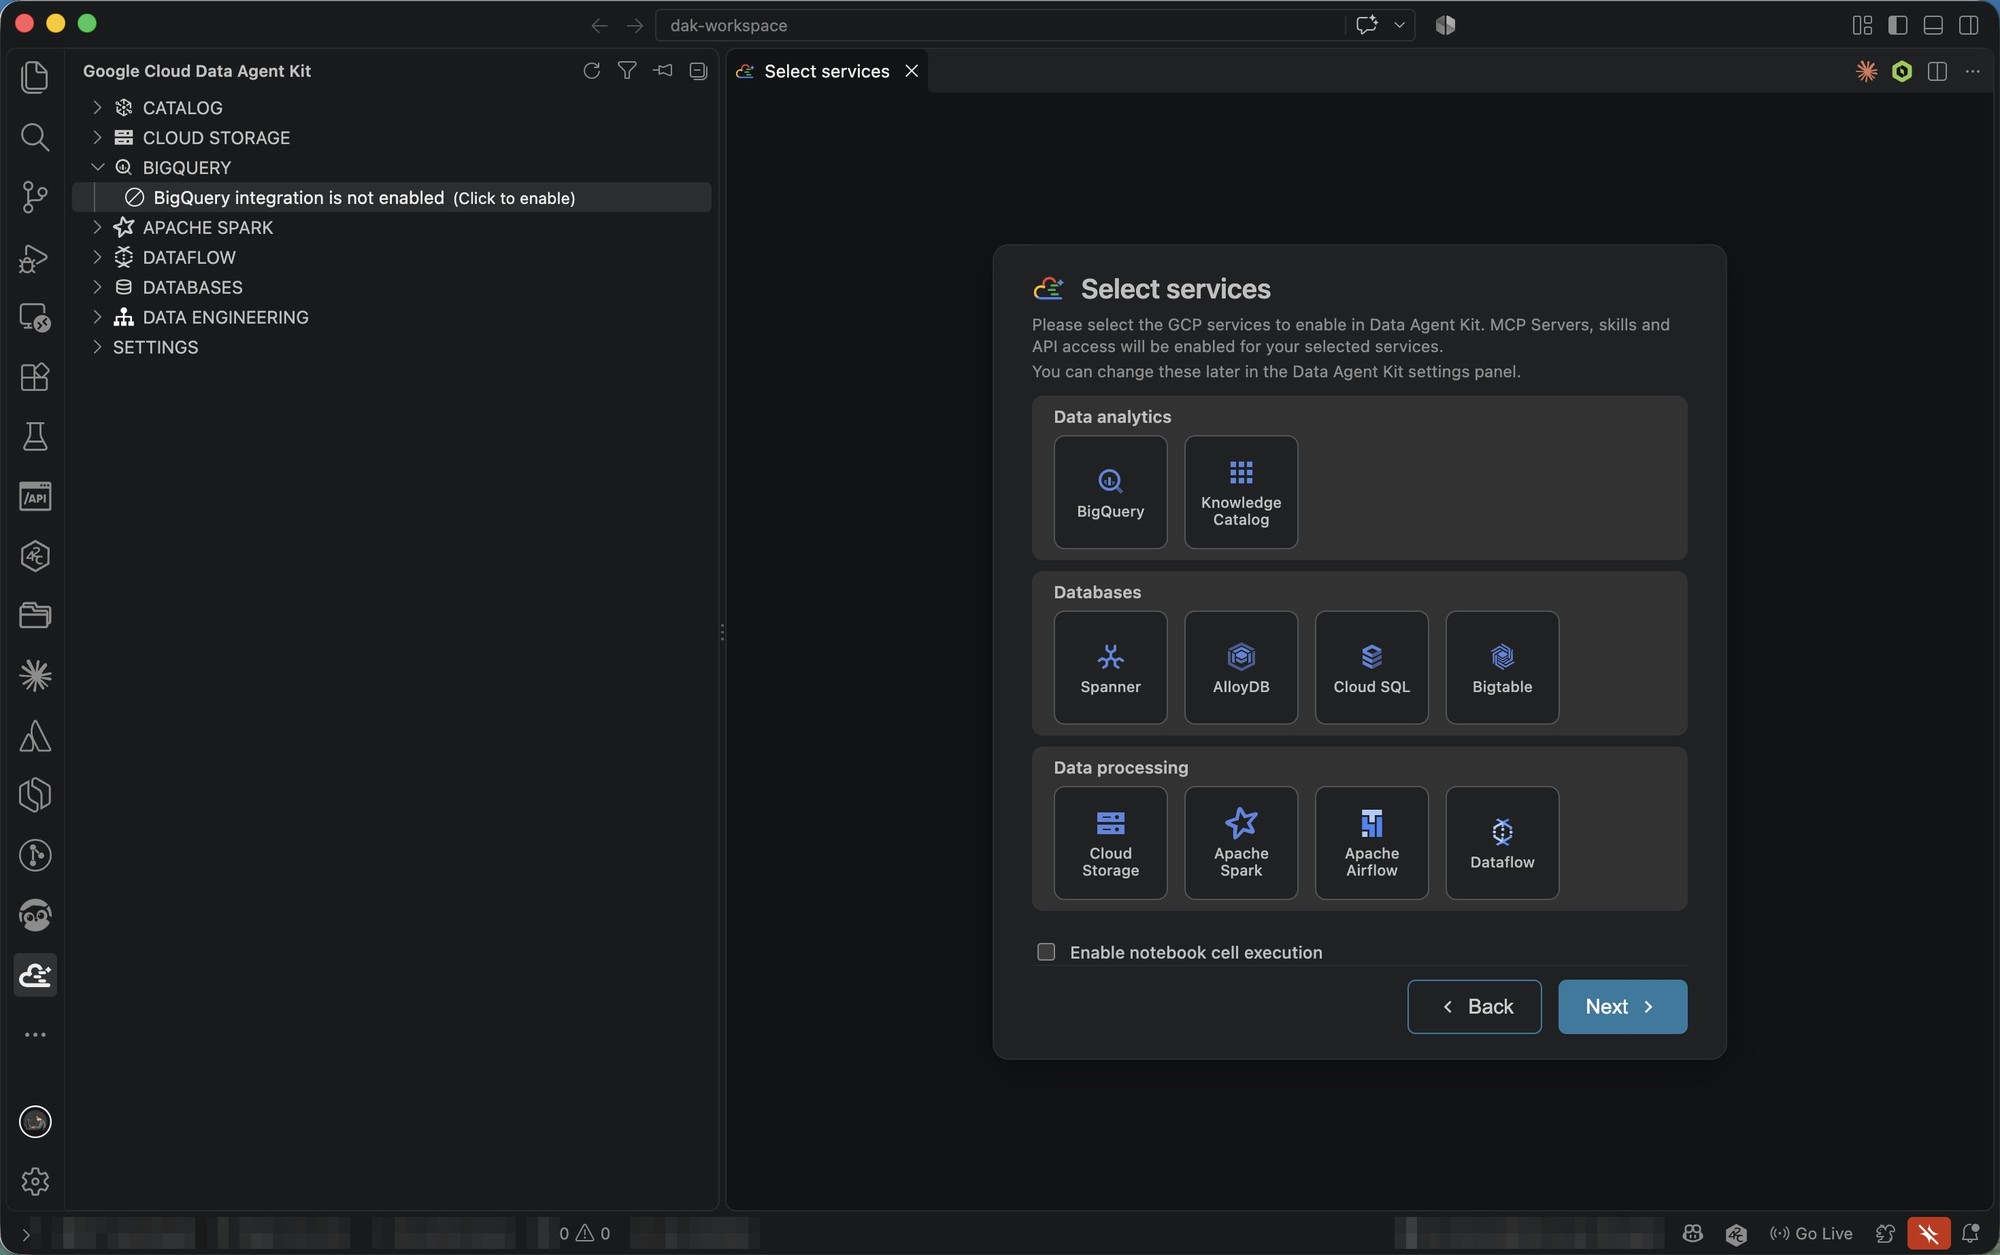
画面の説明文には、選んだサービスの MCP サーバー、スキル、API アクセスが有効になると書かれています。ここでは BigQuery と Knowledge Catalog を選んで、Next を押しました。
BigQuery のデータを見る
セットアップが終わると、Quick Start Guide が開き、BIGQUERY の下に次の項目が並びます。
- New BigQuery Notebook
- New Query
- Datasets
- Jobs
- Saved Queries
- Data Transfers
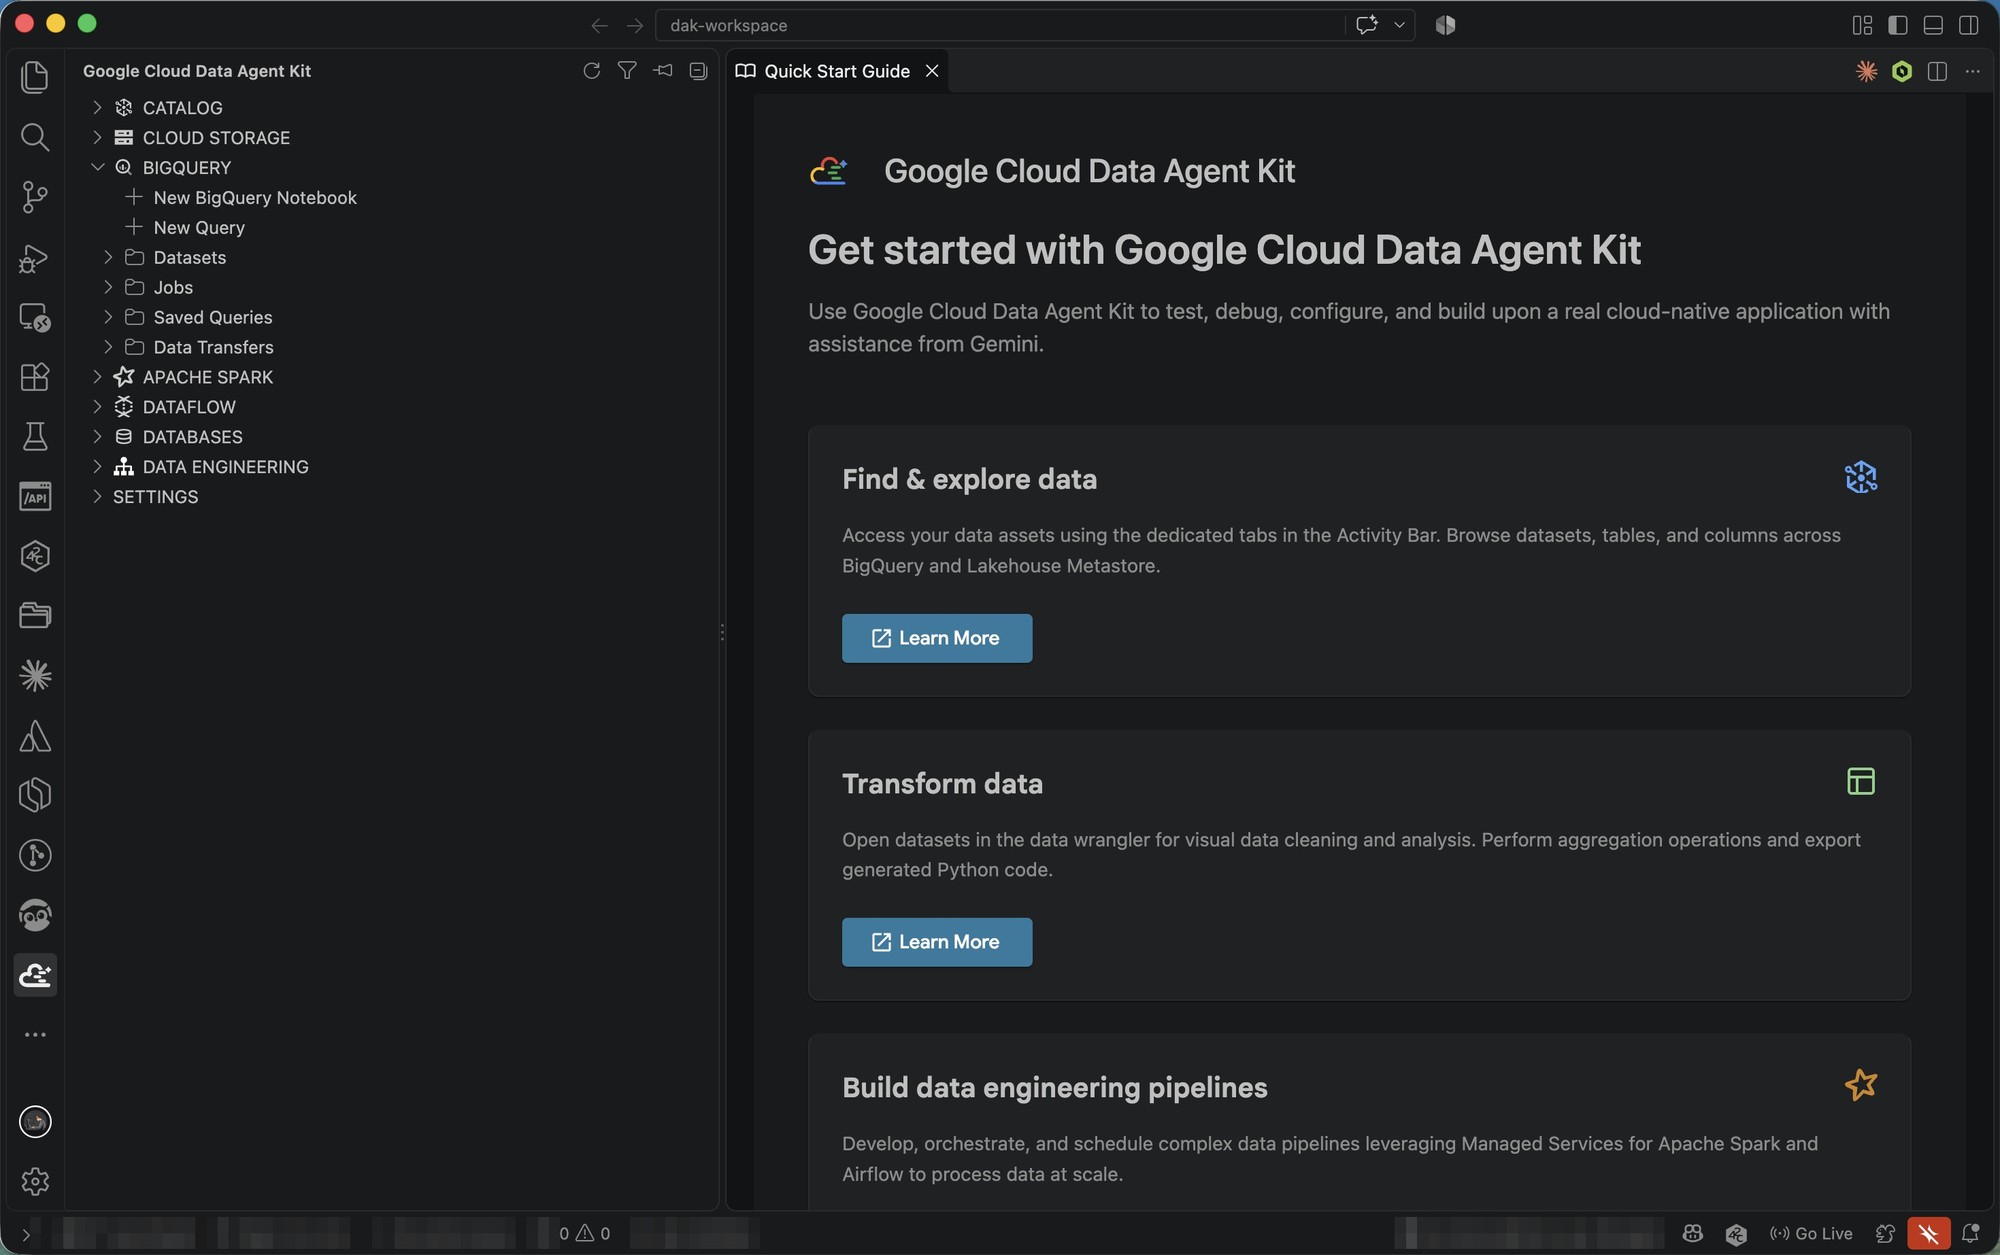
Datasets を開くと、プロジェクト内のすべてのデータセットが並びます。共有プロジェクトでは他の人のデータセットも見えるので、画面を共有するときは注意が必要です。
dakblog_verify の下には「Property Graphs」と orders があります。Property Graphs は、GA で加わった BigQuery Graph 用の入り口のようです。
orders を開くと、Data、Schema、Details、Insights、Lineage、Relationships、Data Profile、Data Quality の 8 つのタブがあるビューになります。データは 500 件中 50 件が表示されました。
クエリを実行する
New Query を選ぶと、SQL ファイル(Untitled.sql)が開きます。先頭には、折りたたまれた @datacloud.settings のコメントが入っています。
Enter で実行すると、下部の Query Results に結果が出ます。タブは Job Information、Results、Visualization、Execution details の 4 つです。
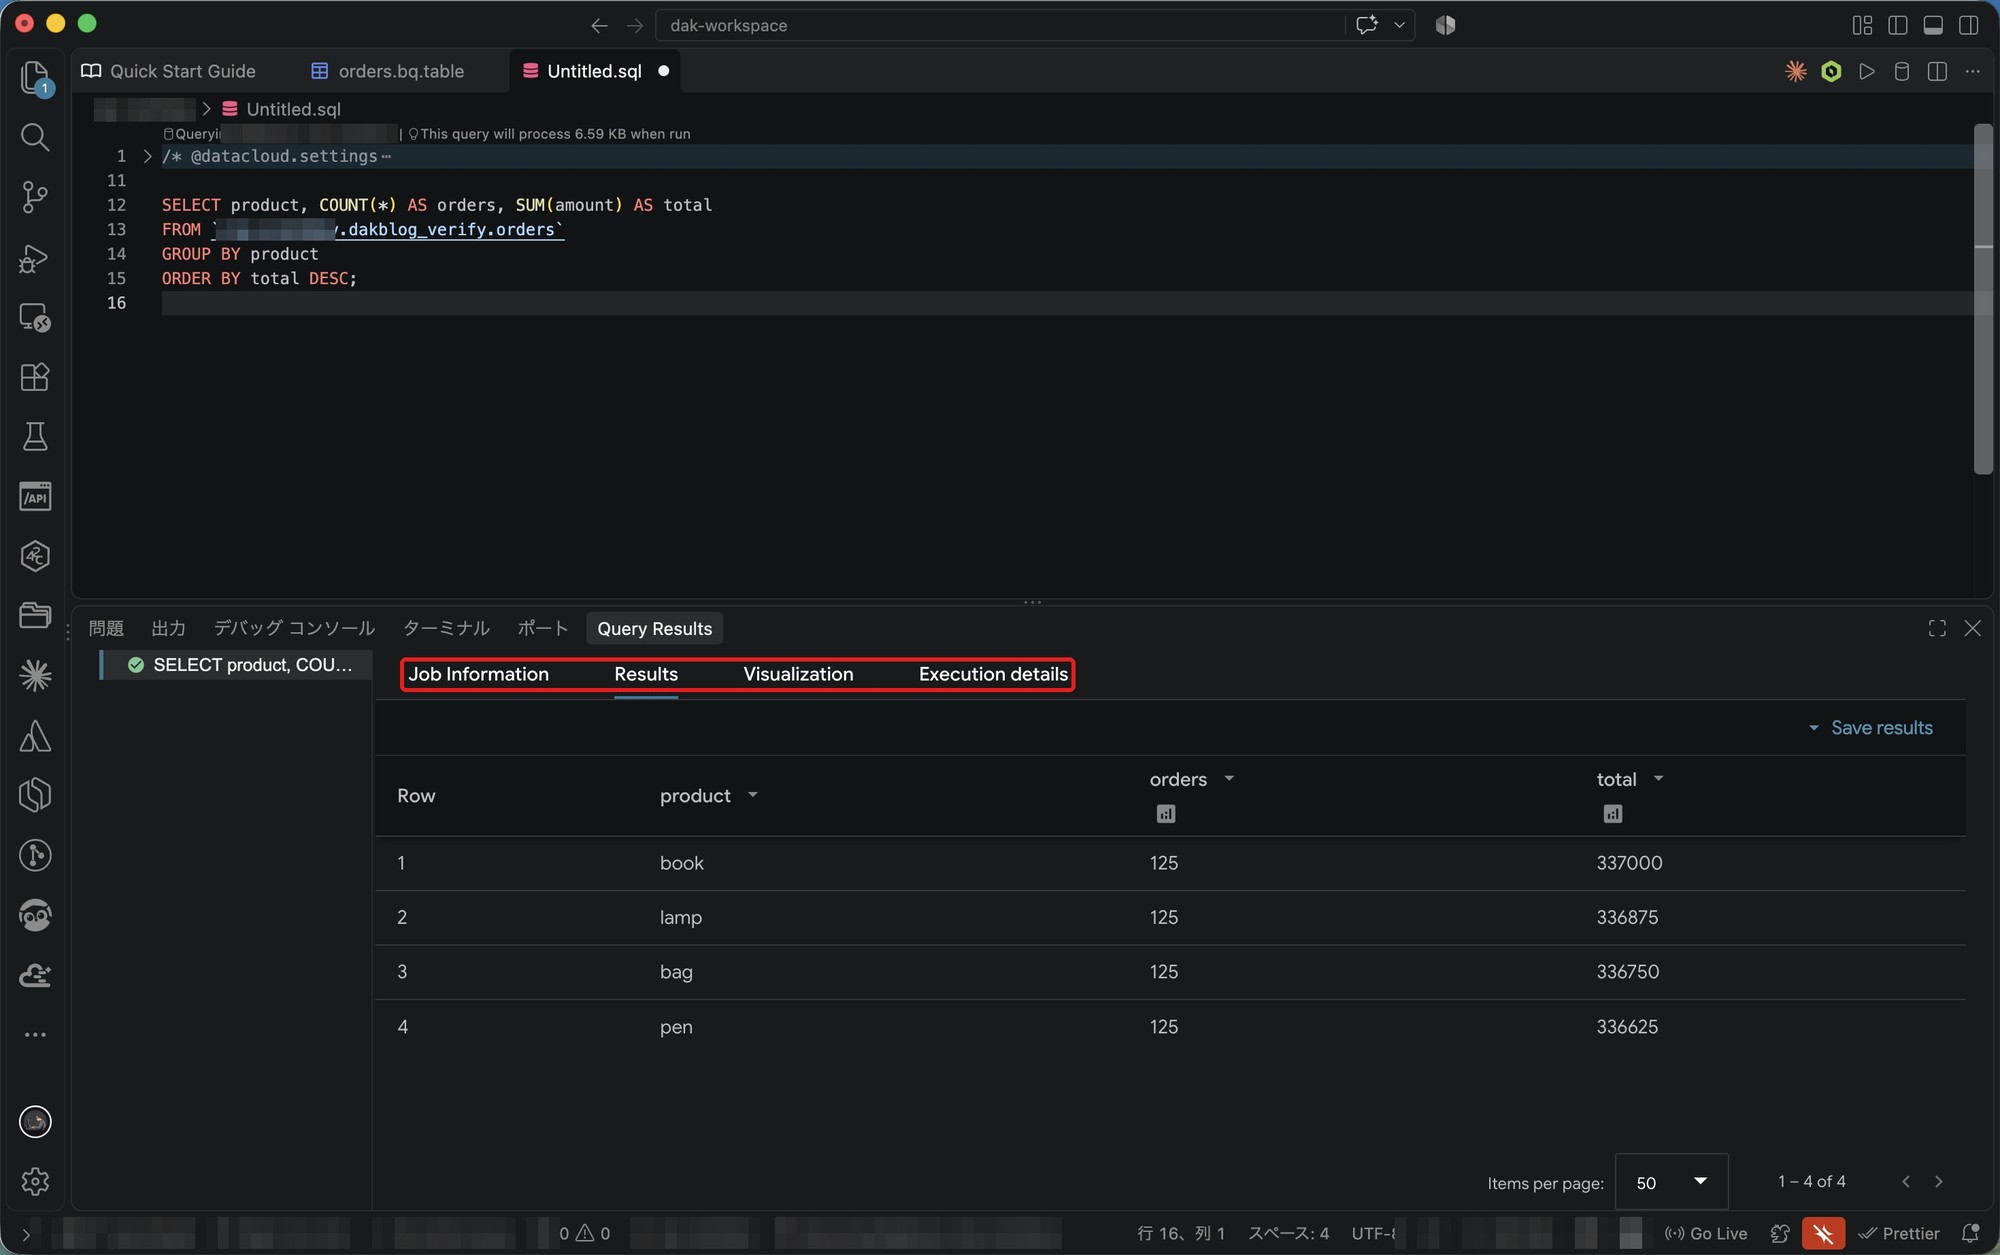
BigQuery のコンソールで実行するのと、ほぼ同じ感覚でクエリを実行できました。VS Code から離れずに試せます。
Claude Code から使う
プラグインのインストール
| 入れ方 | 入った版 | dak-setup |
|---|---|---|
ドキュメントのコマンド(claude plugin install data-agent-kit-starter-pack@claude-plugins-official) |
0.11.0 | なし |
GitHub の README のコマンド(claude plugin marketplace add でリポジトリを登録し、claude plugin install dak@dak-marketplace) |
1.0.0 | あり |
GitHub では 1.0.0 が 9月29日に出ています。ドキュメントのコマンドは、マーケットプレイスを更新しても 0.11.0 のままでした(2026年10月1日現在)。以降は 1.0.0 の結果です。検証用の空のディレクトリに、プロジェクト単位(project スコープ)で入れました。
セットアップ(dak-setup)
| 手順 | 内容 |
|---|---|
| 1 | gcloud が入っているか確認する |
| 2 | ADC があるか確認する。なければ gcloud auth application-default login を案内する |
| 3 | プロジェクト ID とリージョンを聞く |
| 4 | 使うサービスを 11 個から選ばせる(BigQuery、Knowledge Catalog、AlloyDB、Cloud SQL、Spanner、Bigtable、Firestore、Cloud Storage、Apache Spark、Apache Airflow、Dataflow) |
| 5 | 同梱のスクリプトを実行する |
| 6 | 再起動を促す。再起動するまで、ツールは使えない |
Claude Code で /dak:dak-setup を実行すると、この順で聞かれました。最初に「プラグインがまだ設定されていないので、セットアップを進めます」と断りが入り、gcloud と ADC の確認が済むと、プロジェクト ID、リージョン、サービスを一度に聞いてきます。プロジェクト ID とリージョンは、gcloud の既定値が候補として出ました。
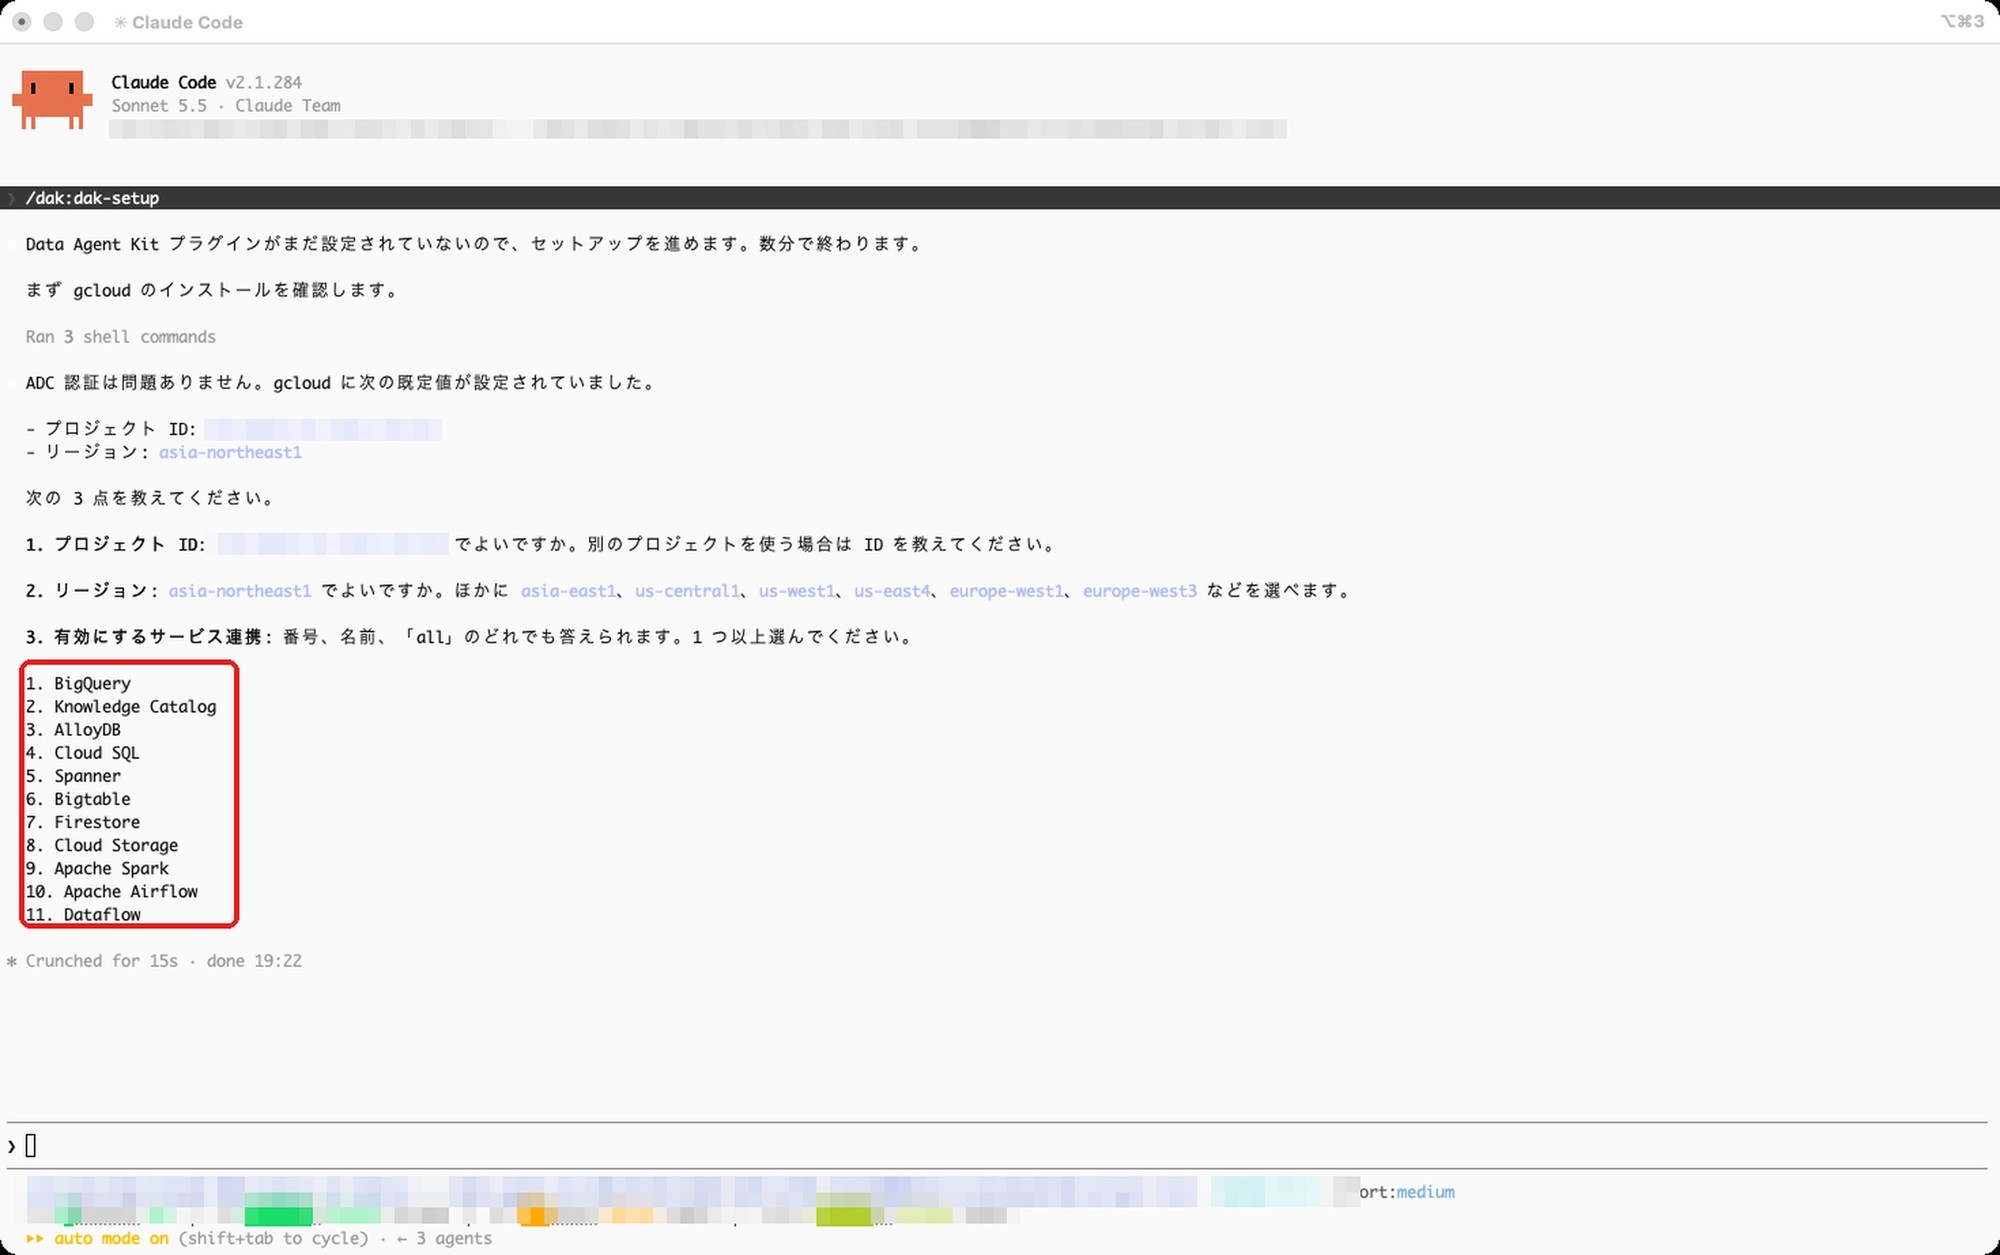
プロジェクト ID、リージョン、サービス(1 と 2)を一度に答えると、スクリプトが 1 回実行されて、設定が終わりました。
セットアップのあとは、選んだサービスに合わせてスキルが絞られ、Bigtable、Airflow、Cloud Storage まわりのスキルが外れていました。設定は ~/.config/data-agent-kit/config.json に、プロジェクト ID、リージョン、サービス名として書かれました。同梱のスクリプトを自分で実行しても同じ設定が作られるようです(node .../dak-setup.js save --project-id ... --region ... --services ...)。
MCP サーバーのつなぎ先
5月に入れたプレビュー期の v0.2.0 では、MCP サーバーがローカルで動いていました(npx で @toolbox-sdk/server を起動)。1.0.0 では、サービスごとに Google が提供するエンドポイントへ、同梱のプロキシでつなぎます。
| サーバー | つなぎ先 |
|---|---|
dak-bigquery |
bigquery.googleapis.com/mcp |
dak-kc |
dataplex.googleapis.com/mcp |
dak-spark |
dataproc-<リージョン>.googleapis.com/mcp |
| ほか | Spanner、AlloyDB、Cloud SQL、Bigtable、Cloud Storage、ノートブック、可視化 |
BigQuery を操作する
プラグインの入ったディレクトリで Claude Code を起動し、orders テーブルの商品別の注文件数と金額合計を、先にドライランで処理量も教えてもらったうえで出すように頼みました。
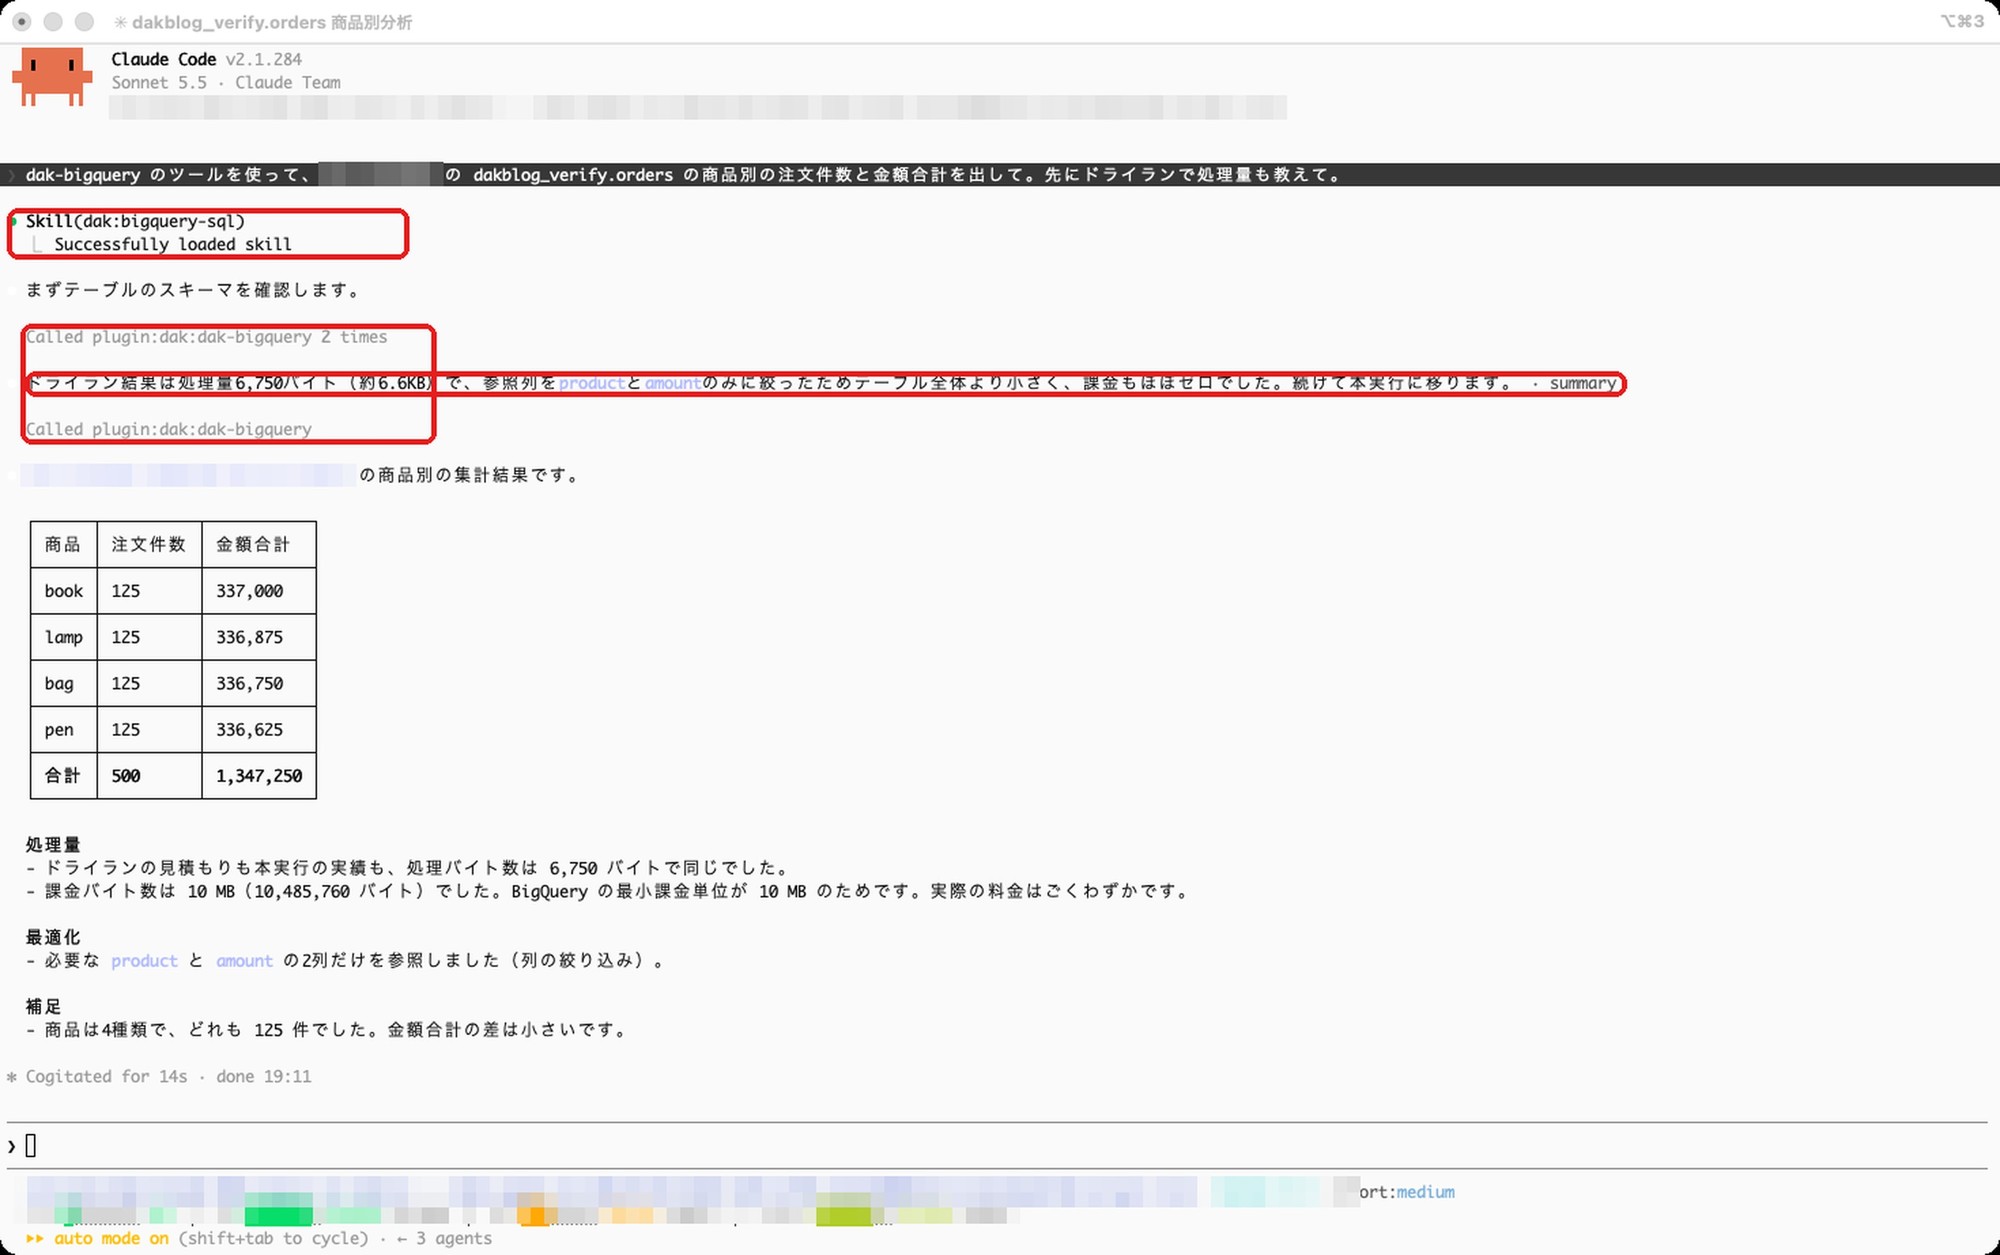
画面の表示は次のとおりです。
| 画面の表示 | 内容 |
|---|---|
Skill(dak:bigquery-sql) |
クエリを書く前に、プラグインのスキルが自動で読み込まれた |
Called plugin:dak:dak-bigquery 2 times |
スキーマの確認とドライランに、MCP ツールが 2 回呼ばれた |
| 処理量 6,750 バイト | 必要な列(product と amount)だけを参照するクエリになっていた。SELECT * の 16,750 バイトより小さい |
| 課金バイト 10 MB | BigQuery の最小課金単位のため。実際の料金はごくわずか |
集計結果は、book が 125 件で 337,000、lamp が 336,875、bag が 336,750、pen が 336,625 でした。
入っているスキル
1.0.0 には、BigQuery まわりのほかにも、Spark、Airflow、Cloud Storage などのスキルが入っています。ここでは BigQuery まわりのものを紹介します。ほかのスキルは、ぜひご自身でも触ってみてください。
| スキル | 内容 |
|---|---|
dak-setup |
プラグインの初期設定を案内する |
bigquery-sql |
クエリの最適化、コストを抑える書き方 |
bigquery-ai-ml |
時系列予測、外れ値検出、キードライバー分析、生成 AI 関数 |
bigquery-bigframes |
BigQuery DataFrames を使った Python コードの生成 |
bigquery-graph-author / bigquery-graph-query |
プロパティグラフの作成と照会 |
federate-lakehouse-catalog |
Databricks Unity や AWS Glue のカタログを連携する |
schema-mapping |
ETL の前に、スキーマの対応を整理する |
enforcing-resource-attribution |
bq や gcloud の実行時、ラベルを付けさせる |
ほかにもスキルがありますので、ぜひご自身でも触ってみてください!
まとめ
Data Agent Kit は、VS Code と Claude Code から BigQuery を操作するための、拡張機能・MCP・スキルのセットでした。
VS Code では、コンソールと同じようにクエリを実行でき、Claude Code では dak-setup に答えるだけで MCP とスキルが入り、MCP サーバーの設定ファイルを自分で書く必要はありませんでした。
BigQuery を普段から使っている方は、ぜひ一度お試しください!
 簡単30秒