


はじめに
- こんにちは。新川です。Oracle AI World 2026 に参加するため、ラスベガスに来ています。
- 「From Rack to Supercluster: Building the Infrastructure for Frontier AI [LRN2410]」を聴講しました。OCI が NVIDIA / AMD の GPU を使って、ハイパースケールの AI 基盤をどう作っているかを、ラック単位から電力・冷却・ネットワーク、キャンパスの設計・運用まで一気通貫で解説するセッションでした。
- アプリやサービスの話ではなく、AI の計算を支える建物・電気・水・ネットワークの話が中心です。本記事では、次の流れで整理します。
- AI インフラが「物理システムの課題」になった背景
- Abilene(テキサス州)キャンパスの規模と設計
- 電力・冷却・ネットワークの工夫
- 現場で乗り越えている制約
- スライドの内容を基本とし、登壇者が口頭で補足した内容は「セッションでは」と明記しています。
用語をおさらい
- RoCE:イーサネット上で RDMA(CPU を介さないメモリ間の直接通信)を行う方式。AI の分散学習で低遅延な GPU 間通信に使われます。
- ファブリック:GPU・スイッチ・ケーブルで構成されるネットワーク全体のこと。
- コールドプレート:GPU などのチップに直接取り付け、内部に冷却液を流して熱を奪う板状の部品。
- CDU(Coolant Distribution Unit):ラックに冷却液を循環させるための装置。
- UPS:無停電電源装置。停電や電圧変動時にサーバーへ電力を供給し続ける設備。
- Behind the Meter:電力会社のメーターの内側(敷地内)に発電設備を置き、直接電力を供給する構成。
- ランプレート:電力需要や発電量が変化する速さ(MW/秒など)。急激だと電力網に負担がかかります。
- EDP:スライドで、GPU が数ミリ秒のあいだ通常ピークより電流を増やす現象の指標として示されていた用語。
- スイングバックアップ:電力会社からの給電を補うために、状況に応じて出力を切り替える自家発電のこと。
3 行まとめ
- AI インフラの課題は、ソフトウェアだけでなく、電力・熱・ネットワーク配置を含む物理システムの設計になっている。
- OCI は、電力・冷却・ネットワークをキャンパス単位で一体設計している。
- 水を使わない冷却、GPU 負荷の変動を吸収する電力設計、プレーンを分けたネットワークが特徴。
AI インフラは「物理システム」の課題になった
クラウドの議論が変わった
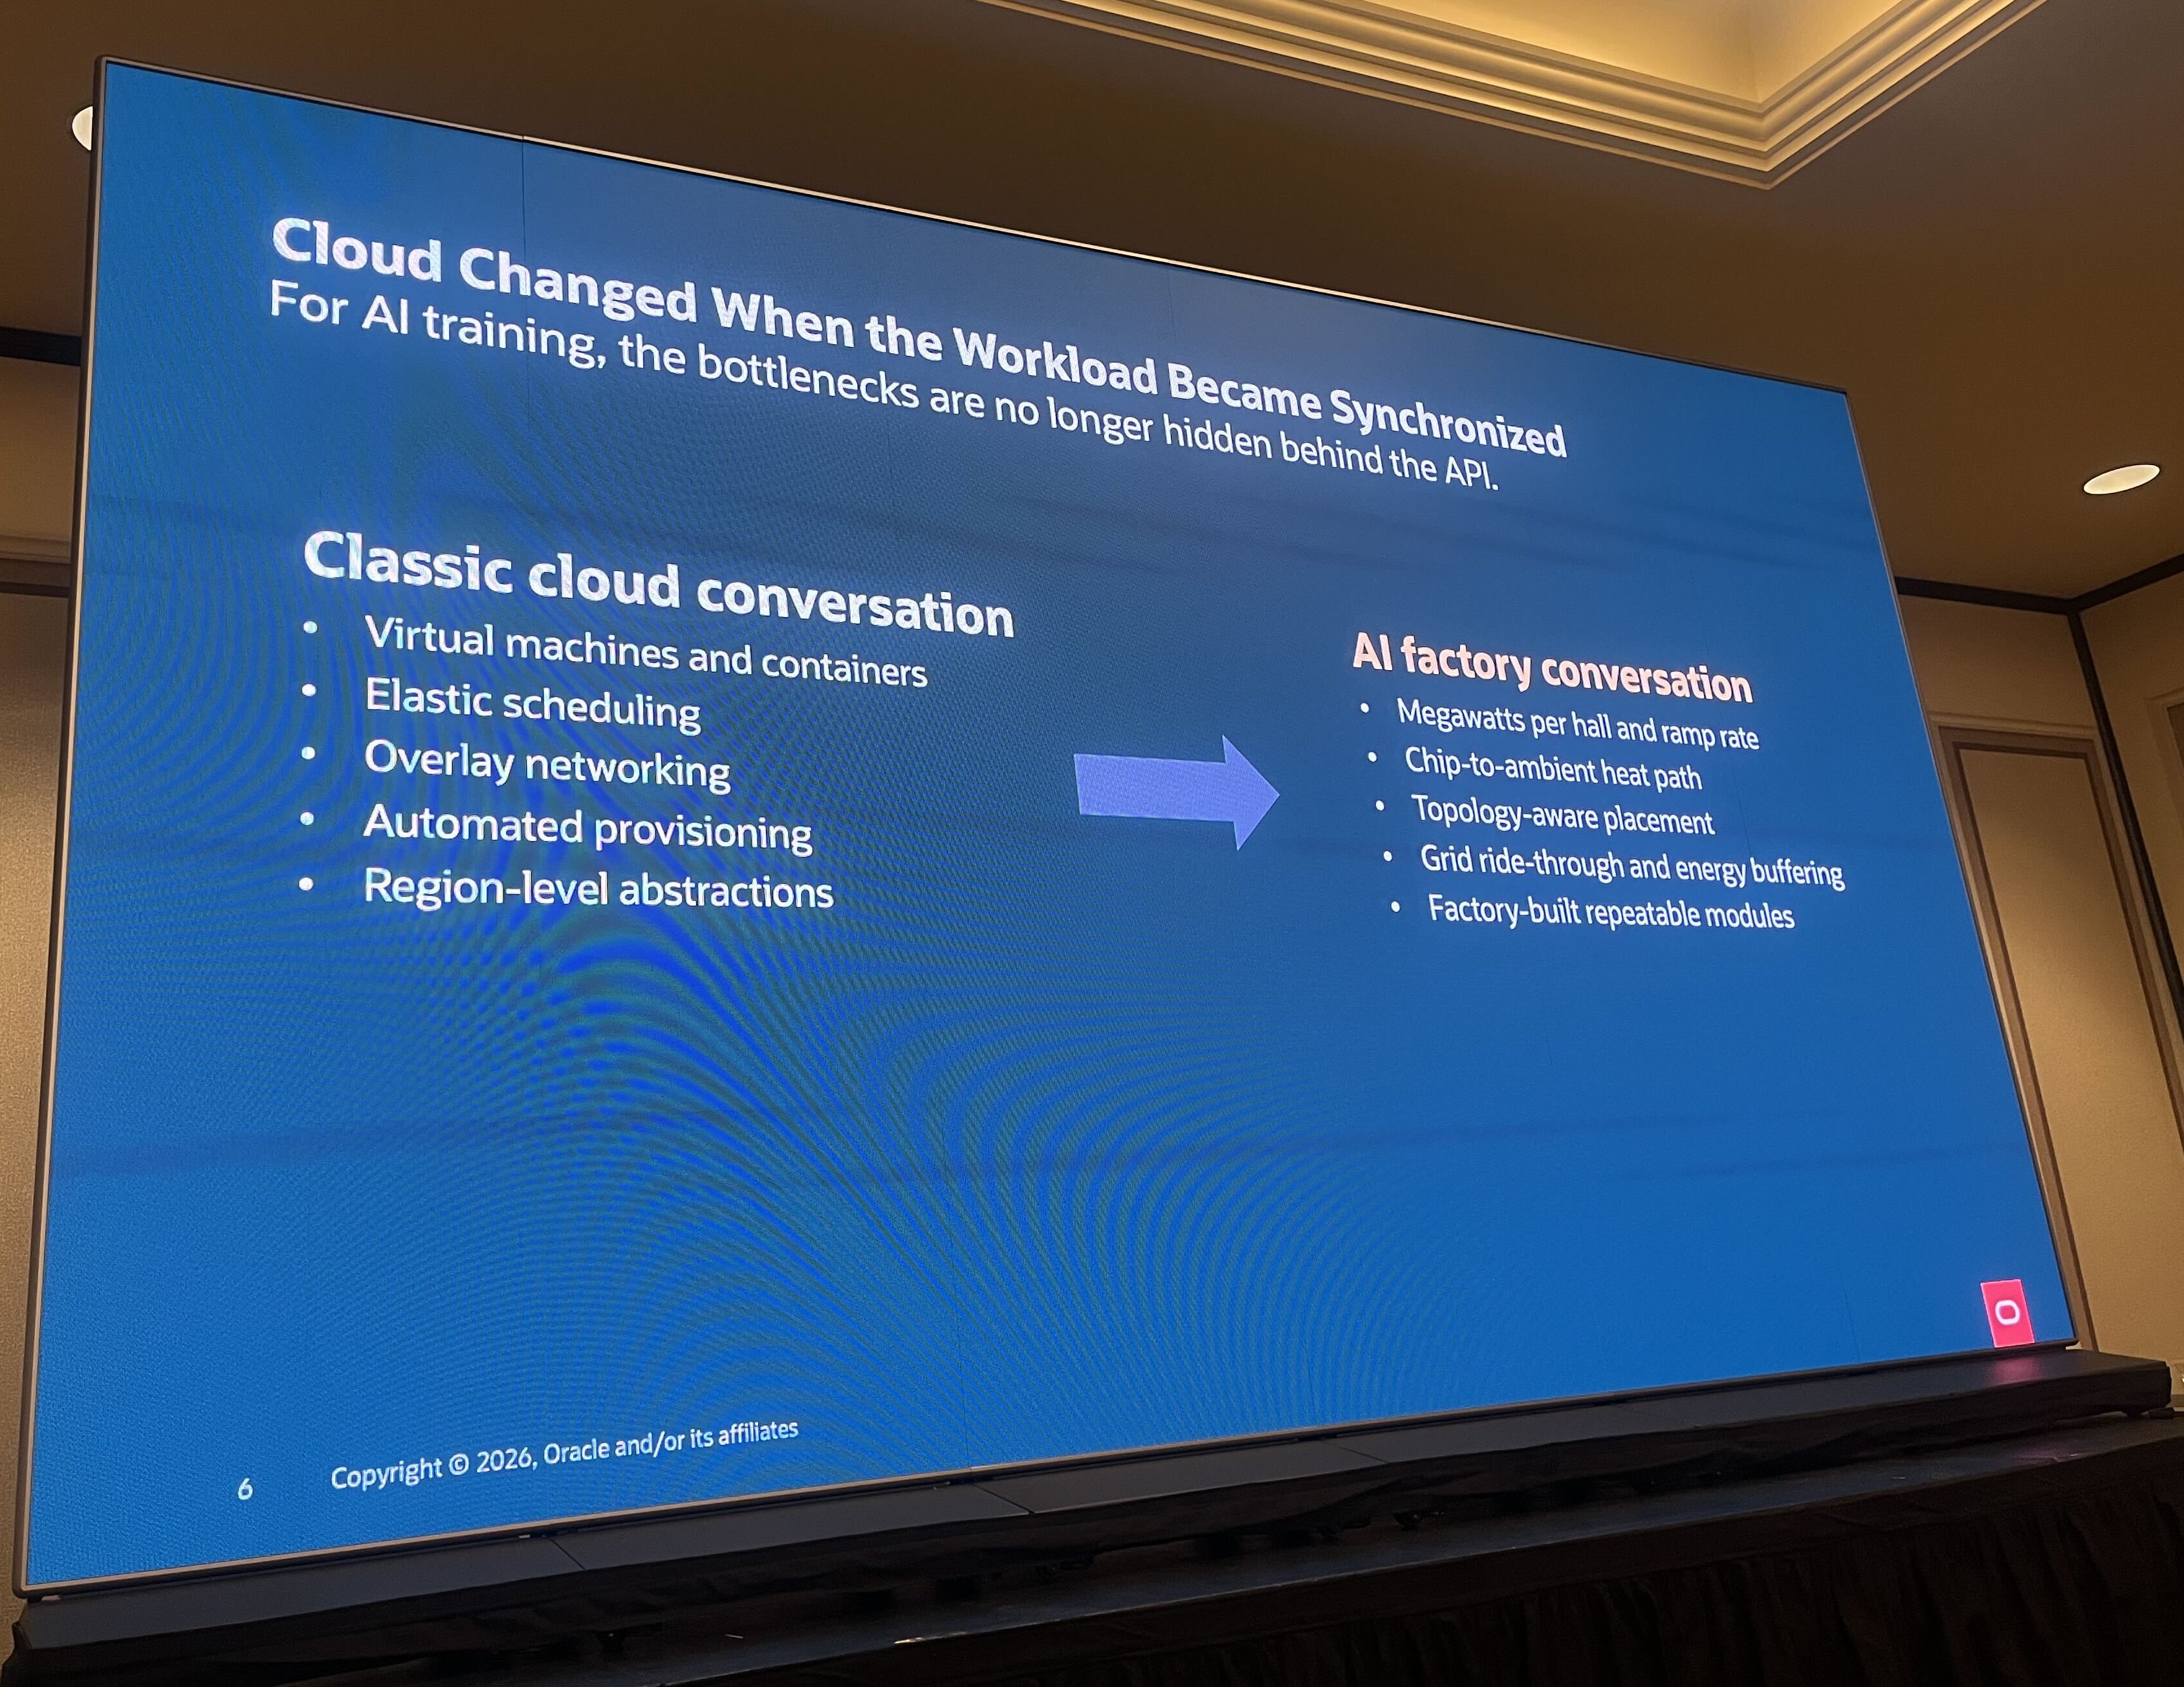
- セッションは、従来のクラウドの議論と AI ファクトリーの議論の対比から始まりました。たとえば、これまで話題の中心だった「仮想マシンとコンテナ」は「ホールあたりのメガワットとランプレート」に、「自動プロビジョニング」は「電力網の瞬断耐性とエネルギーバッファリング」に置き換わっています。
電力・熱・トポロジーを同時に解く
- 設計の軸は次の 3 つです。
- Power:受電、変電所、ランプレート、敷地内発電
- Thermals:チップ、ラック、ホール、キャンパスの各レベルでの排熱
- Topology:遅延、経路の多様性、障害の影響範囲
- スライドには「The winning design pattern is modular, workload-aware, and grid-integrated from day one」とあり、最初からモジュール化し、ワークロードに合わせ、電力網と統合して設計することが勝ち筋だとされています。
AI ファクトリーの 5 つの層
- スライドでは AI ファクトリーを、LLM ベースのアプリケーション、LLM モデル、物理インフラ、データセンター内のラック、GPU の 5 層で整理していました。モデルやアプリケーションの下に、物理インフラが層として含まれているのがポイントです。
Abilene:1 GW 級のキャンパスを作る
Abilene キャンパスの規模
- 「80 万 GPU を、電力網を溶かさずにどうやって電力供給し冷却するか」という問いが提示されました。答えは、銅(電力)、冷却液、コンクリート(建物)、制御、キャンパスのトポロジーであり、ソフトウェアだけでは解けない問題だと整理されています。
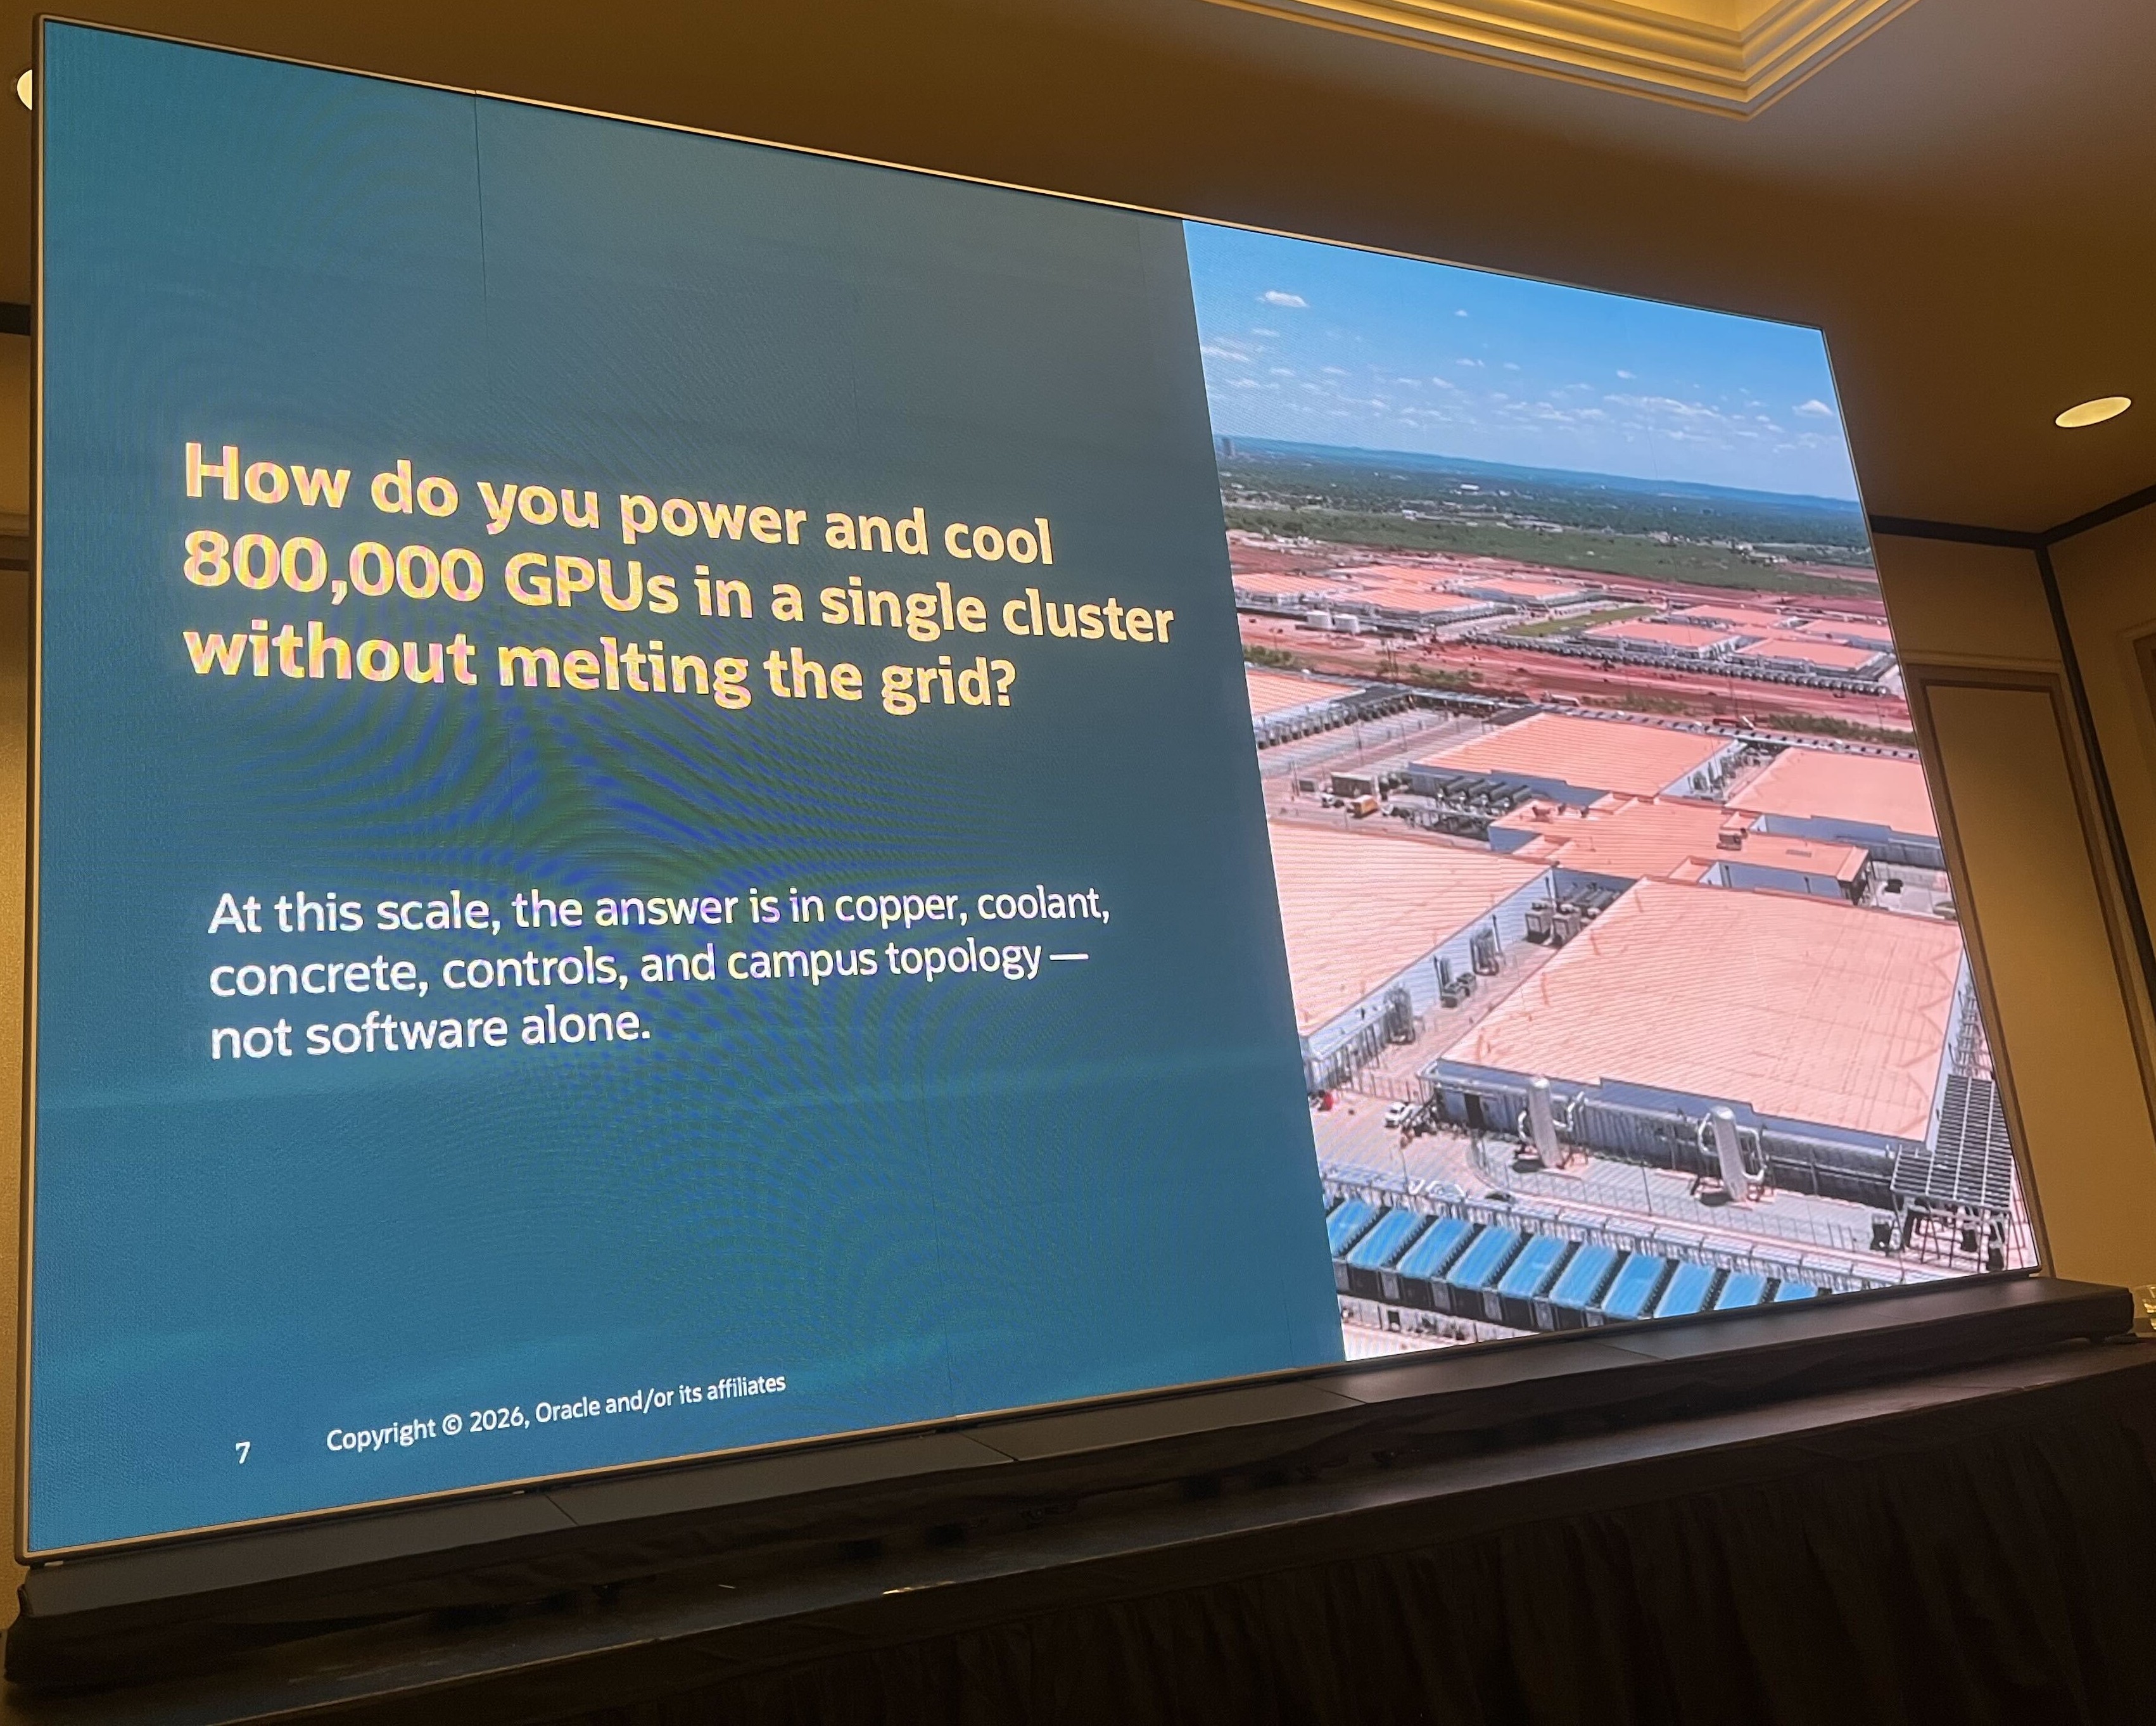
- テキサス州アビリーン(2026 年 5 月時点)は次のとおりです。
- 建物:8 棟(1 年未満で構築)
- 敷地:約 1,100 エーカー
- 延床面積:約 400 万平方フィート
- セッションでは、1 棟におよそ 10 万 GPU、4 つのデータホールで構成されると説明されていました。更地から最初の計算稼働までは約 9 か月とも語られており、スライドの「1 年未満で 8 棟」と合わせて、構築スピードを強調する内容でした。
データセンターを 4 つの「機械」として見る
- Zettascale10 のデータセンターは、次の 4 つの機械の組み合わせとして説明されました。
- 電力:電力会社からの受電と、Behind the Meter(敷地内)での発電(VoltaGrid のレシプロエンジン、Bloom の燃料電池)
- 熱:水を使わない冷却(コールドプレート、CDU、チラー/ドライクーラー)
- スーパーコンピューター:80 万 GPU を RDMA ファブリックで結ぶ
- モジュール型ロジスティクス:工場で作るモジュール、サプライチェーン、試運転、予備部材まで含めて、データセンターを繰り返し作れるようにする基盤
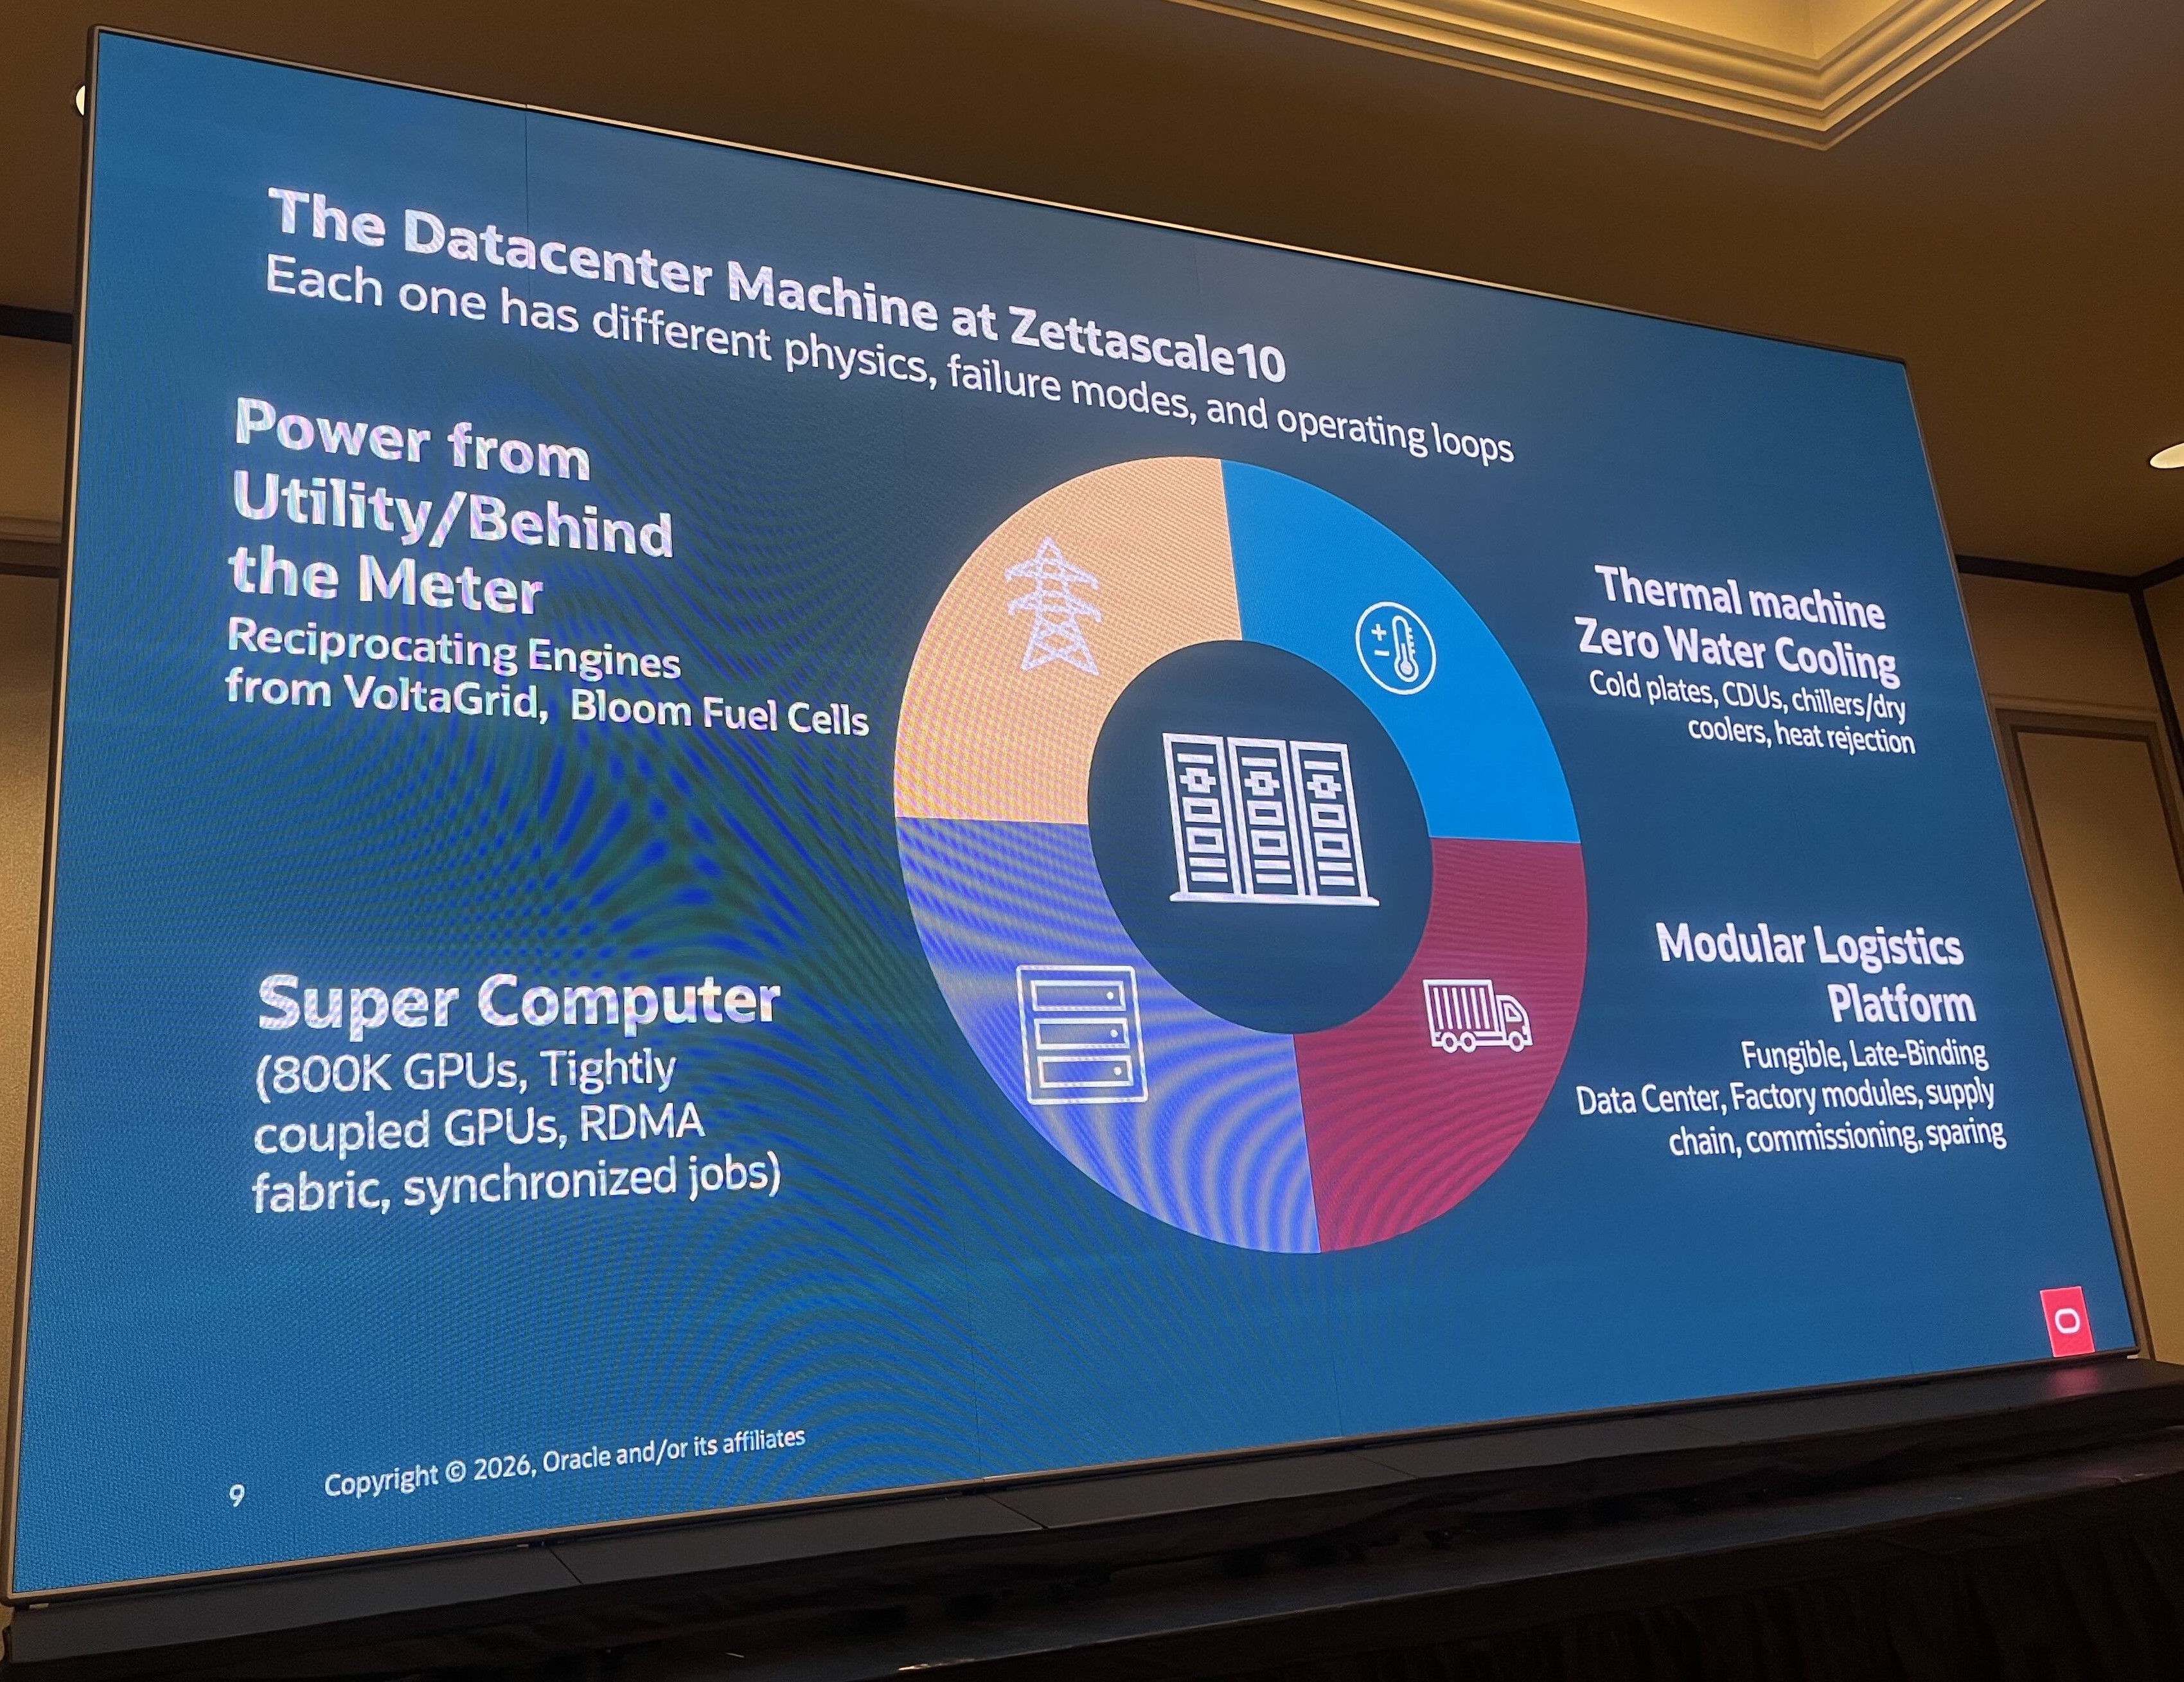
- 設計の目標として FAST / DENSE / EFFICIENT / REPEATABLE が掲げられていました。
サイト選定とモジュール設計
- 1 GW 超のキャンパスは、土地選びから始まります。スライドでは次の項目が挙げられていました。
- 土地の選定
- スパインネットワークの規模の見積もり
- 電力の確保(電力会社、Bloom の燃料電池、ガスパイプライン)
- 柔軟に使えるデータホールのモジュール化
敷地内の設備
- セッションでは、敷地内の設備として、チラー、バッファタンク、変圧器、ガスタービン発電所が紹介されていました。
- ガスタービンは、セッションでは約 300 MW 規模のスイングバックアップ電源と説明されていました。電力会社からの給電が途絶えた場合などに備える位置づけです。
- チラーの隣にある冷水のバッファタンクは、AI の計算負荷が急に上がった際、チラーの出力が追いつくまでのあいだ冷却能力を補う役割として紹介されていました。
電力:GPU の「揺れ」を段階的に吸収する
負荷が大きく揺れる
- AI の学習は、多数の GPU が一斉に計算し、一斉に通信待ちに入る同期型のワークロードです。このためキャンパス全体の消費電力が、100% から 30% 程度まで大きく揺れます。電力網側から見ると、急激な負荷変動が続くことになります。
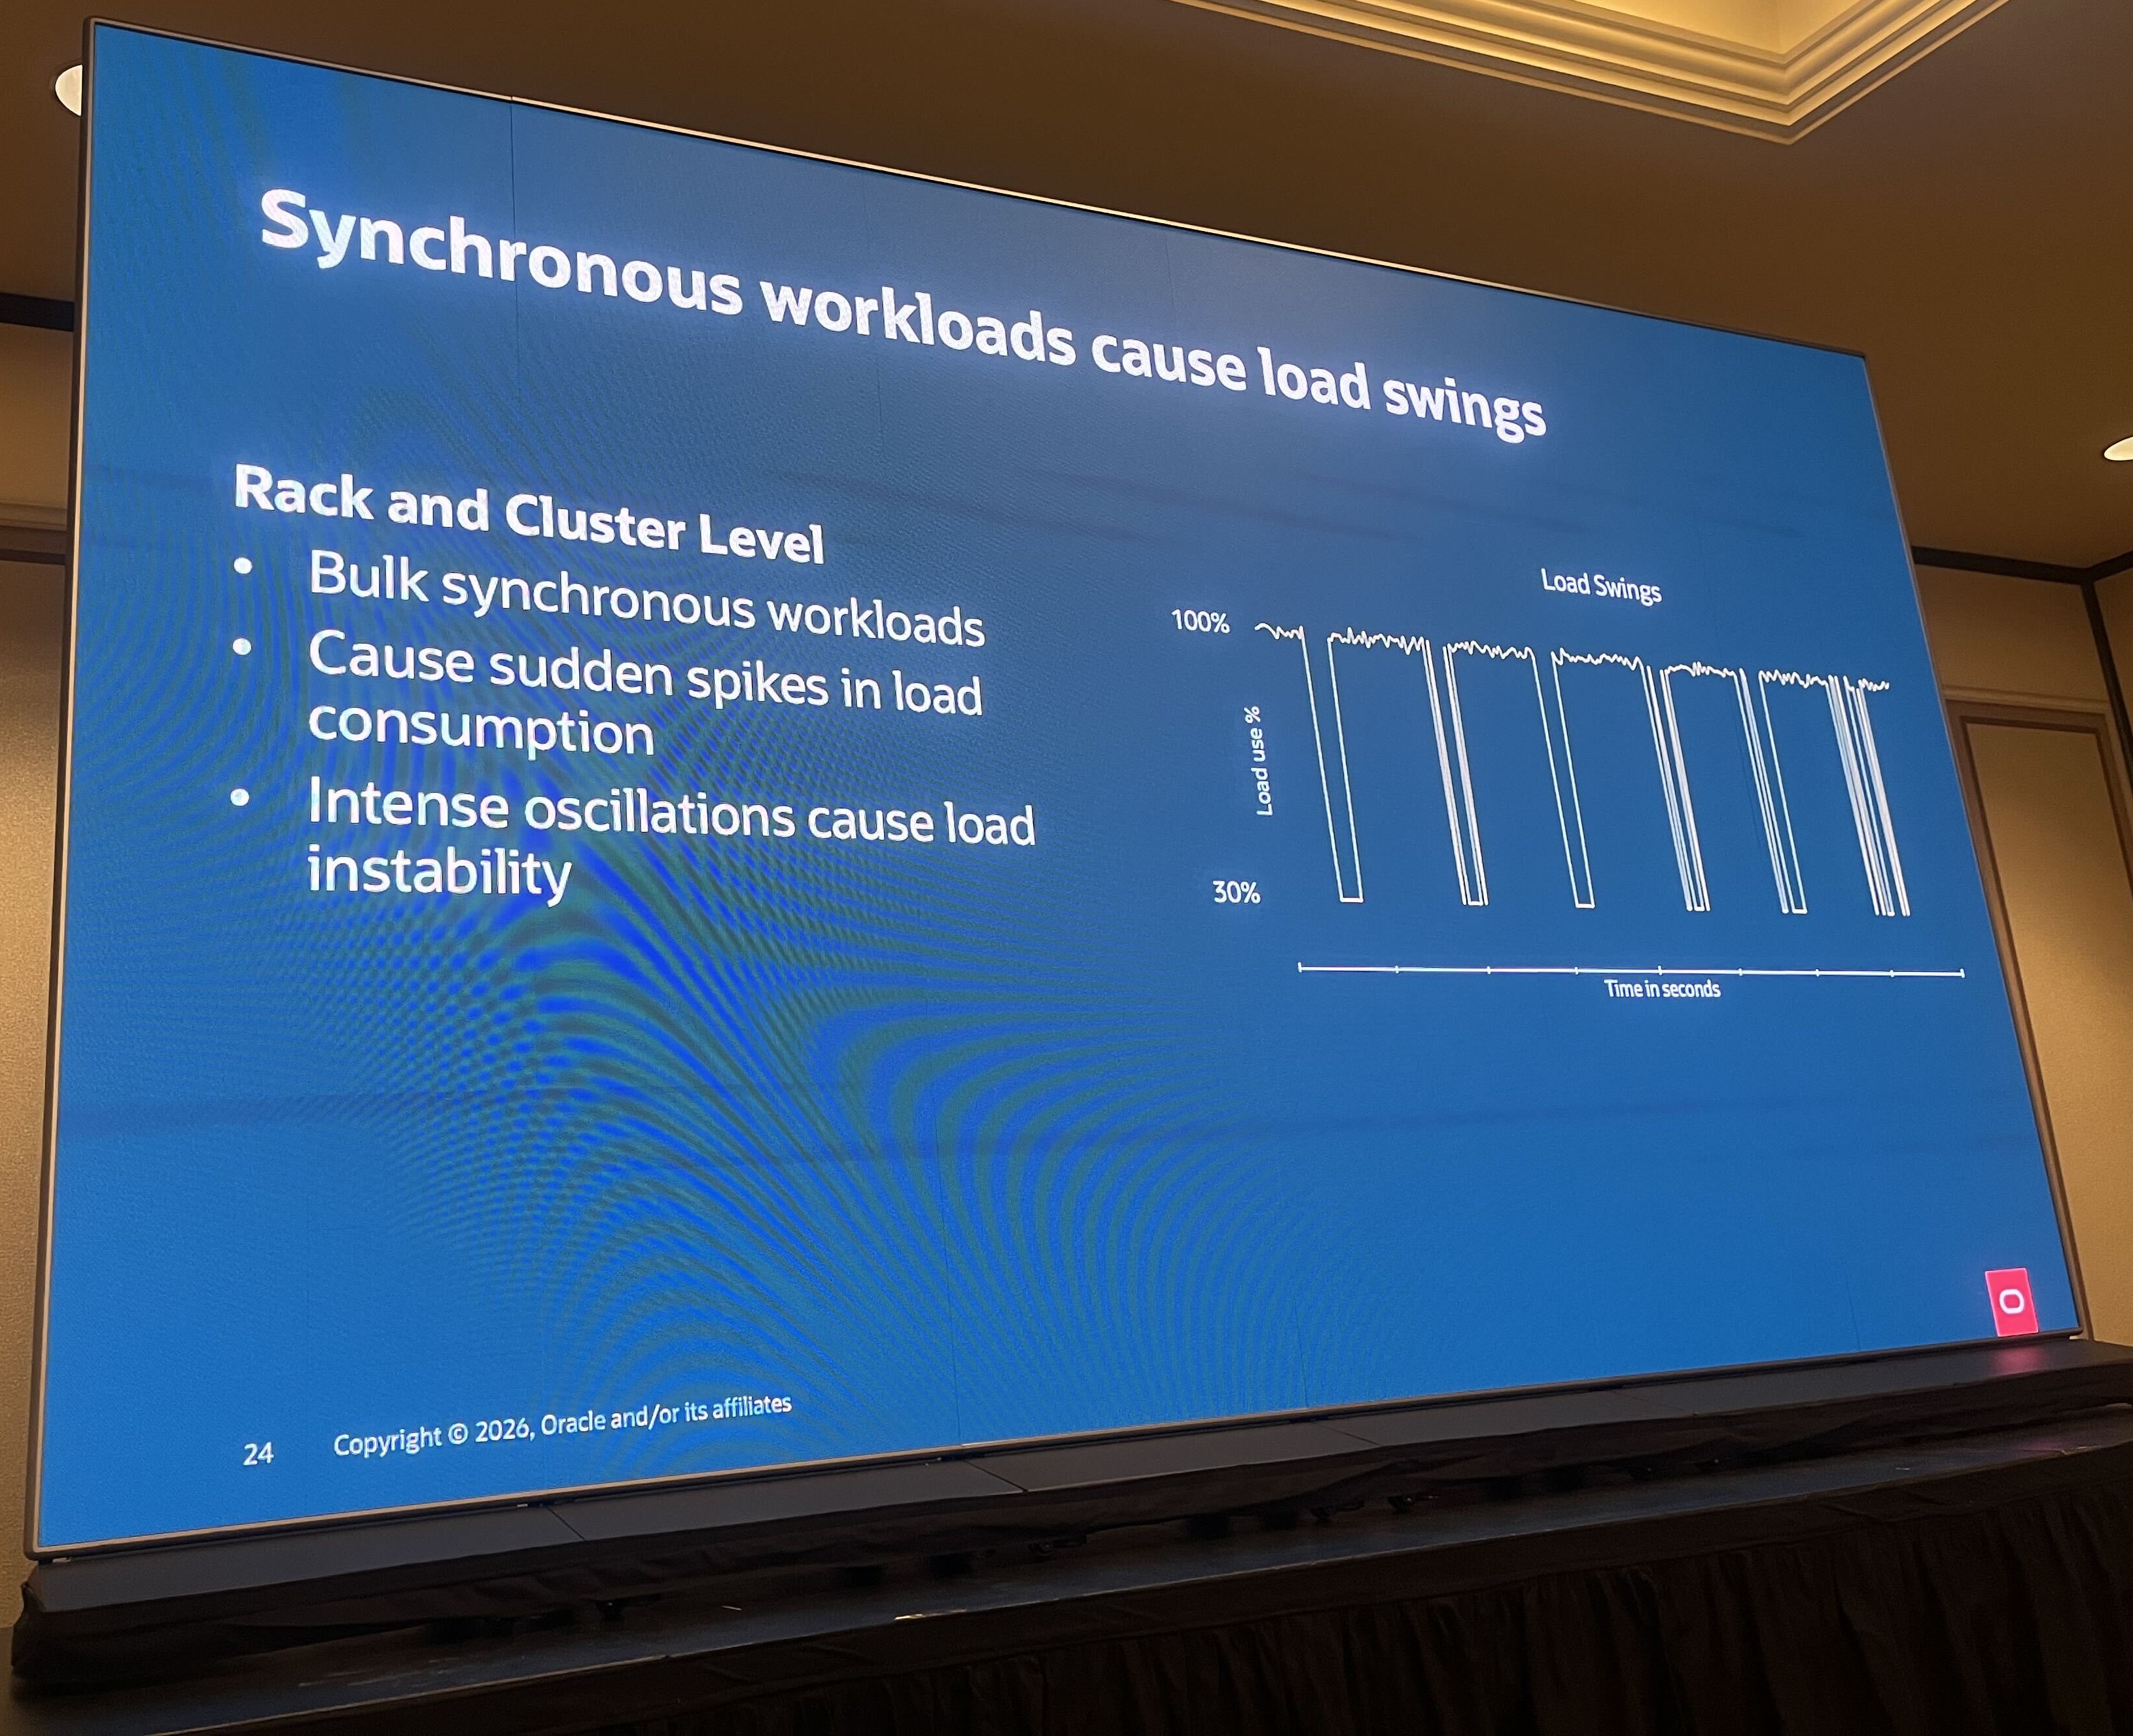
GPU 単位でも電流が脈動する
- GPU 単位でも電流は脈動します。スライドでは、数ミリ秒のあいだ、EDP が通常のピークより 25〜50% 高くなると示されていました。
3 段階で吸収する
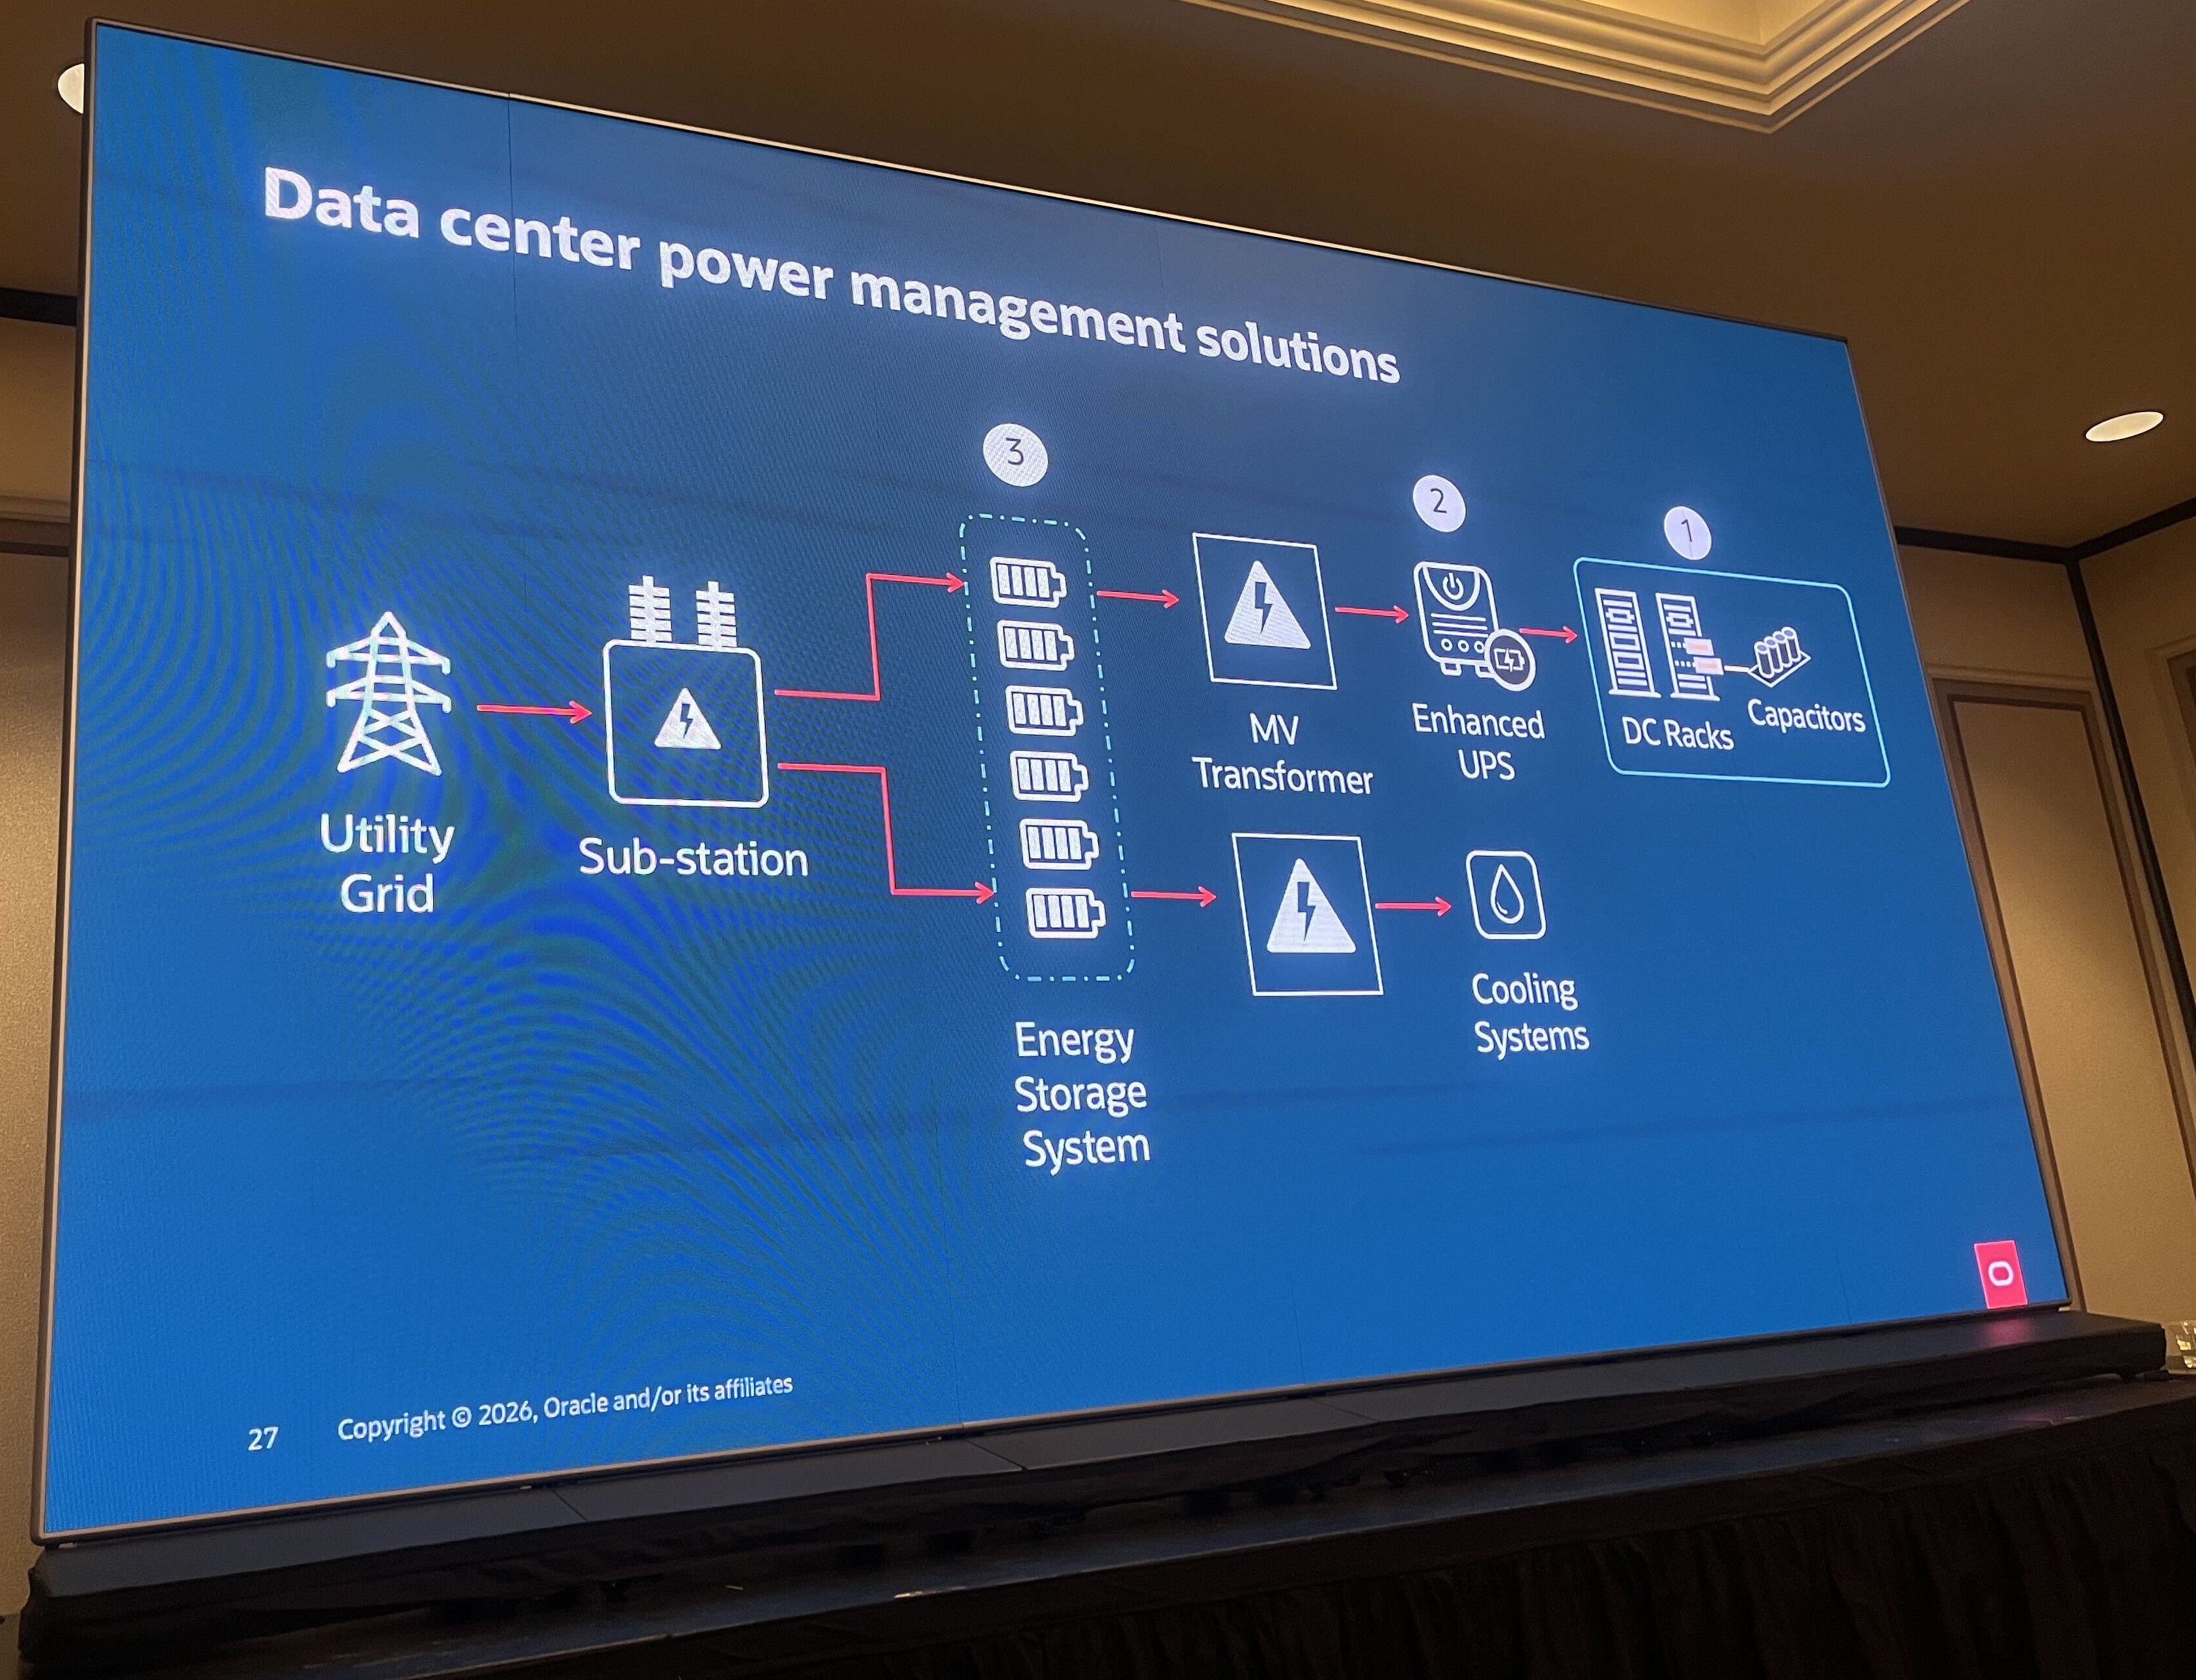
- 対策は、次の 3 段階を組み合わせたものでした。
- DC ラック+コンデンサ:ミリ秒単位の電流の変動を、ラック側で吸収する
- 強化型 UPS:出力の変化を滑らかにする
- ESS(エネルギー貯蔵システム):キャンパスレベルで電力を緩衝する
- 図では、電力会社から変電所と ESS を経て、MV トランス、強化型 UPS、DC ラックの順に給電され、ESS からは冷却設備にも電力が分岐していました。なお、ラックまでの給電は現時点では AC(交流)のままと説明されていました。
冷却:水を使わない直接液冷
コールドプレートによる直接液冷
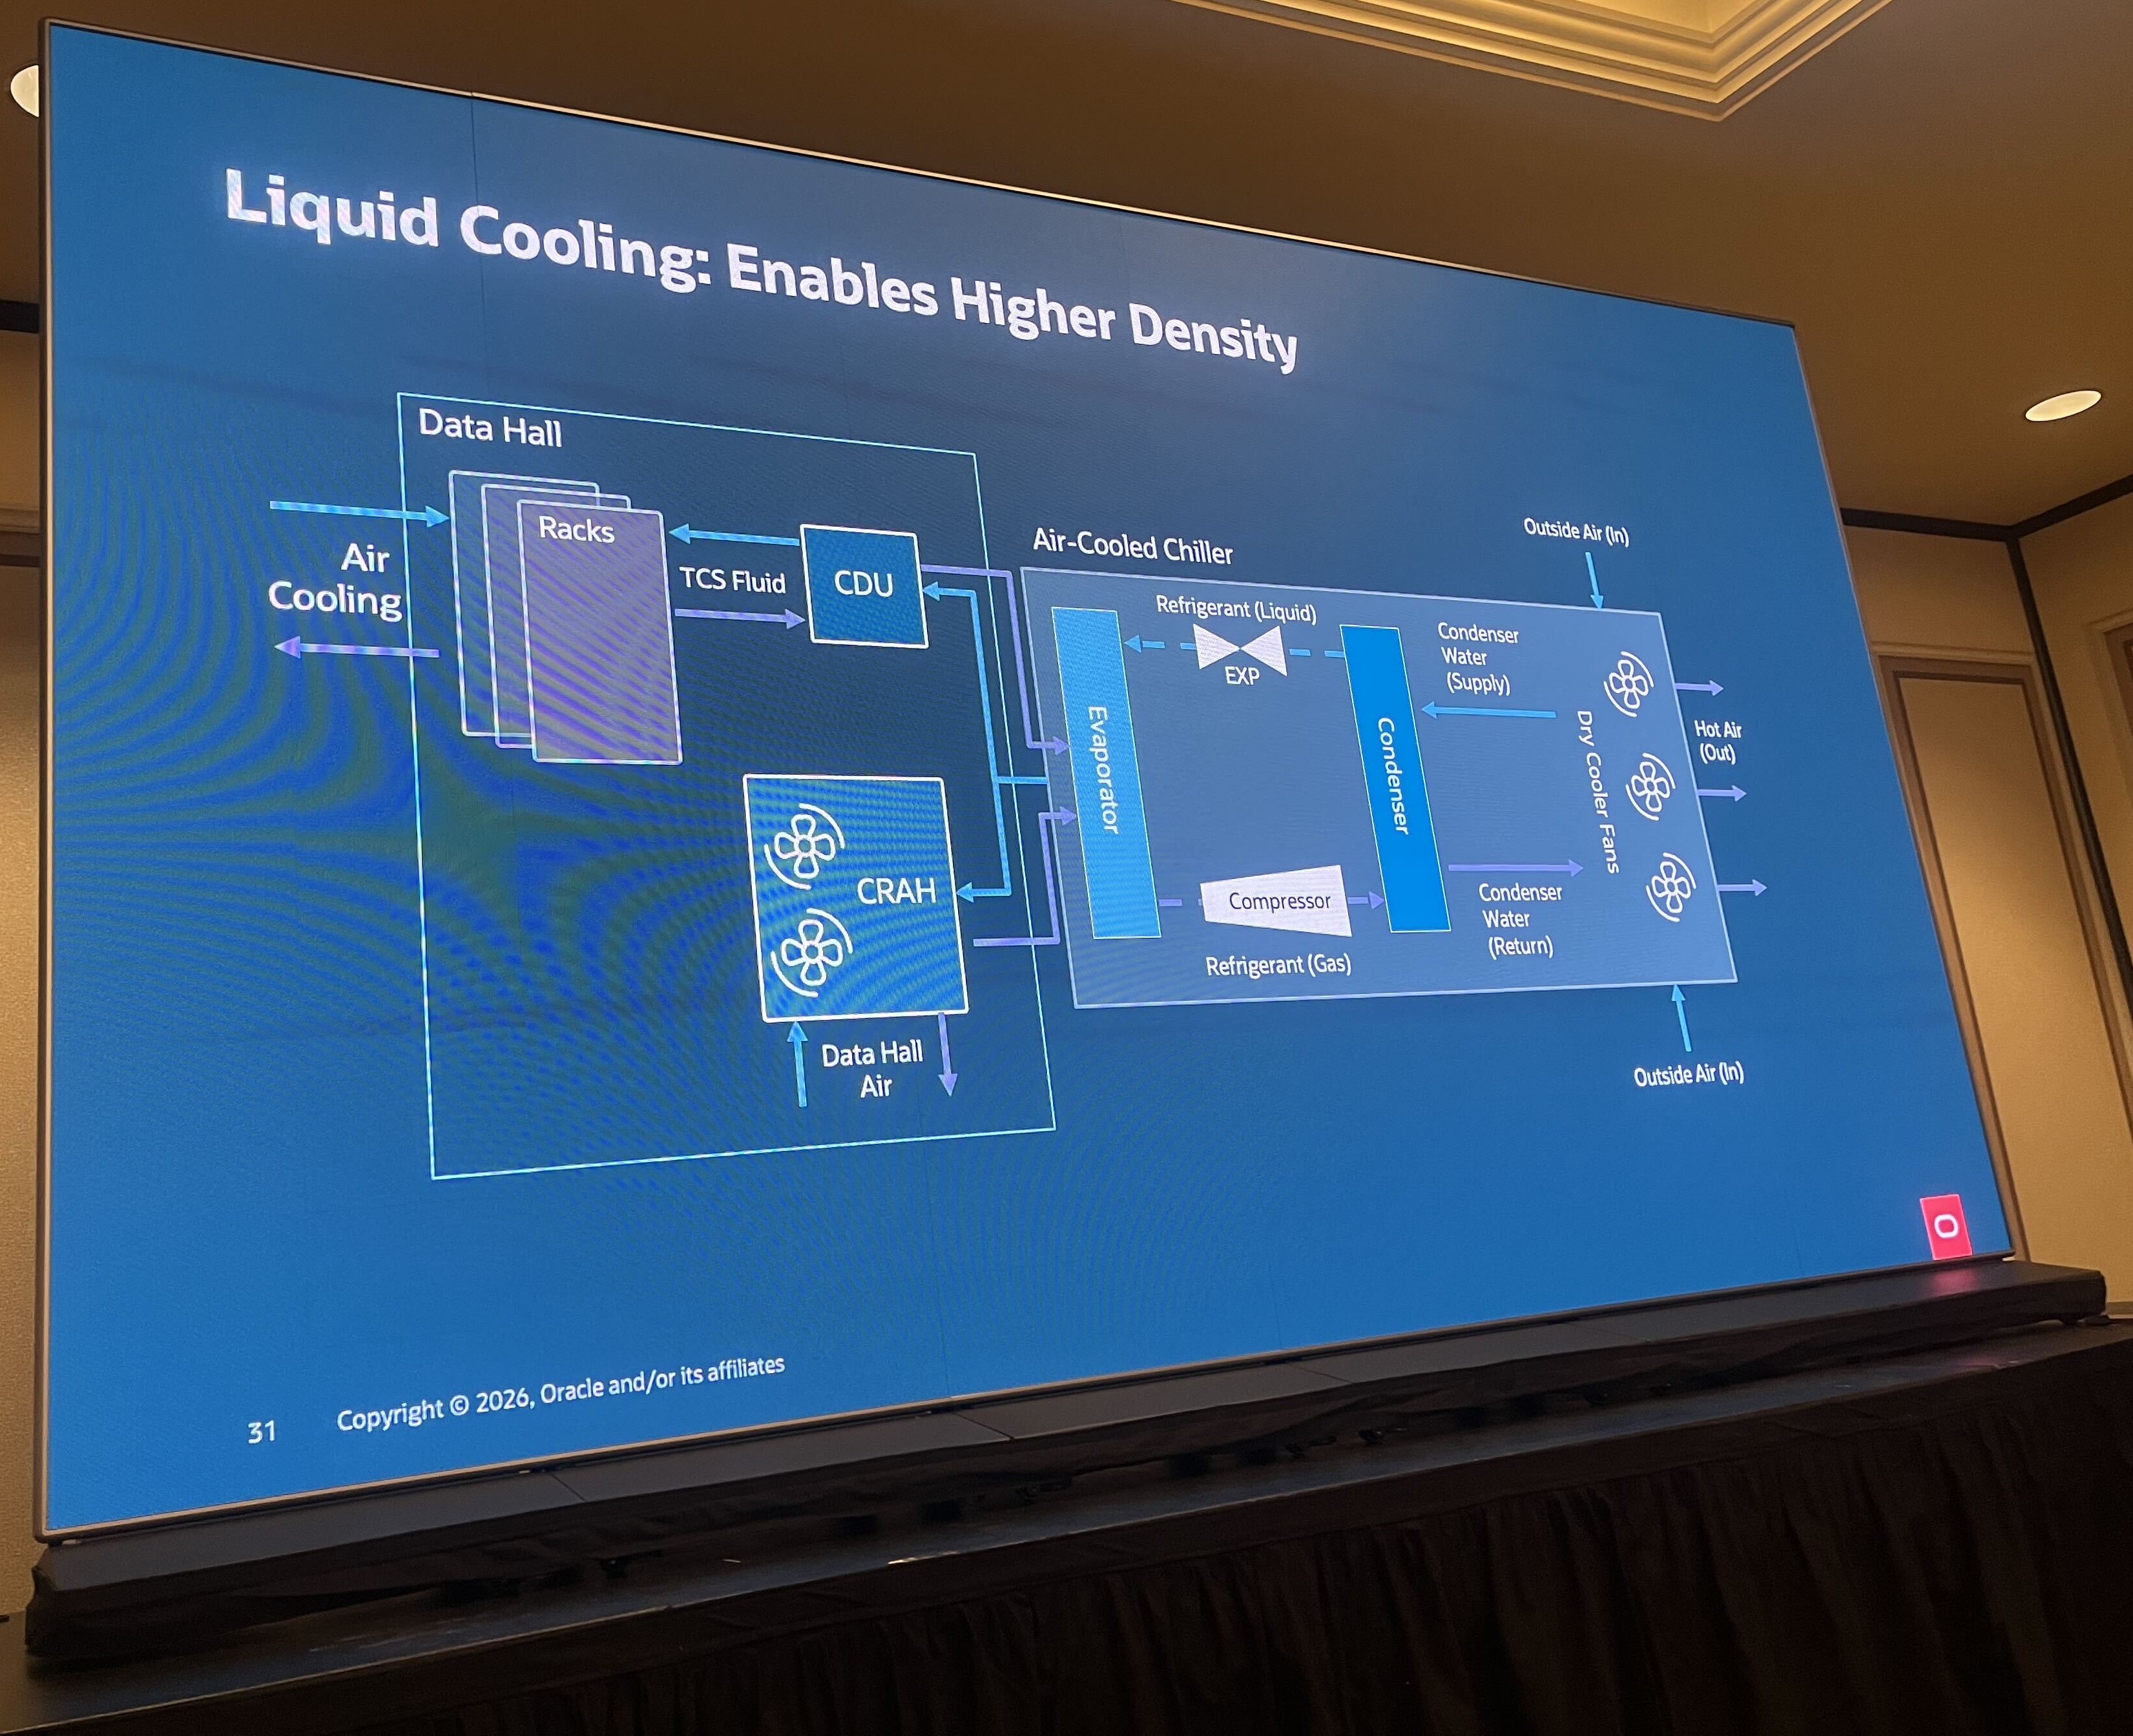
- 次世代の冷却として、GPU、DIMM、NIC などにコールドプレートを取り付け、冷却液で直接冷やす方式が紹介されました。1 ラックあたり 100 kW 以上の熱を扱う前提の設計です。
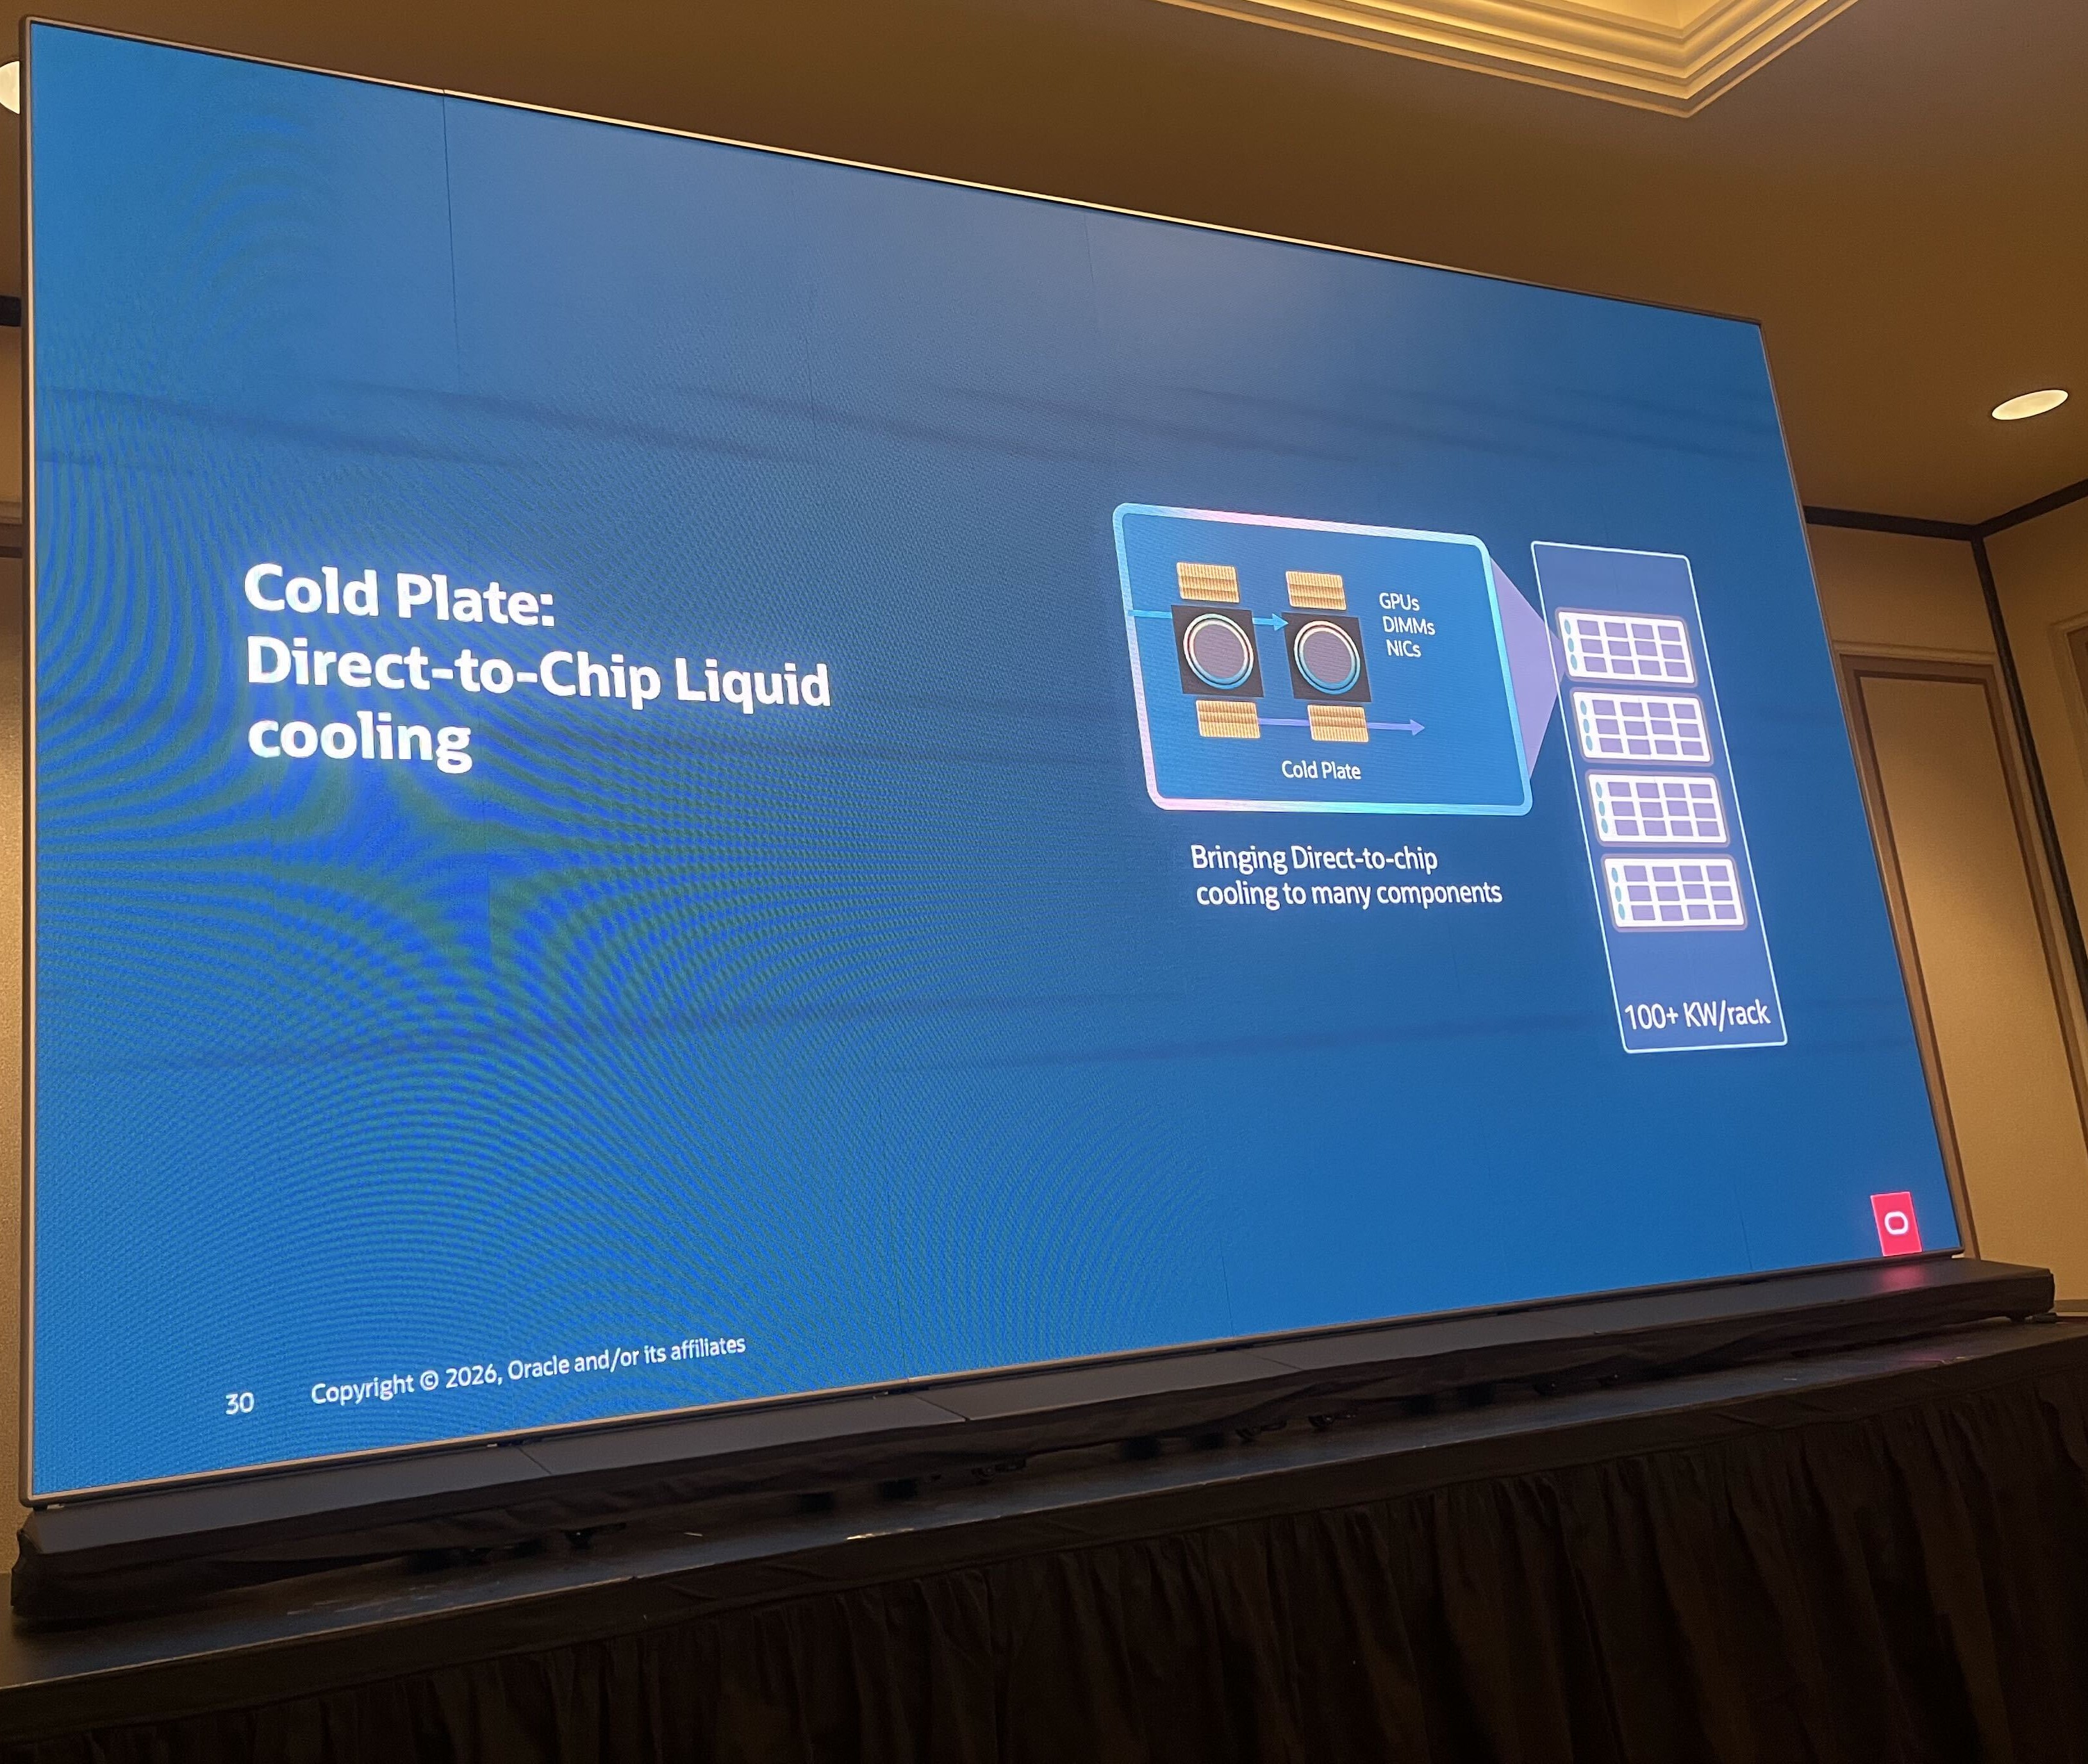
排熱の流れ
- 冷却液(TCS)は CDU を介してラックを循環し、熱は空冷チラーとドライクーラーのファンから外気に逃がされます。水を蒸発させない閉じた回路です。
- 水を蒸発させない方針の代わりに、PUE は 1.2〜1.3 程度を許容しているとセッションでは語られていました。地域の水資源を優先した設計判断です。
ネットワーク:Oracle Acceleron のマルチプレーン
1 つの NIC から複数のプレーンへ
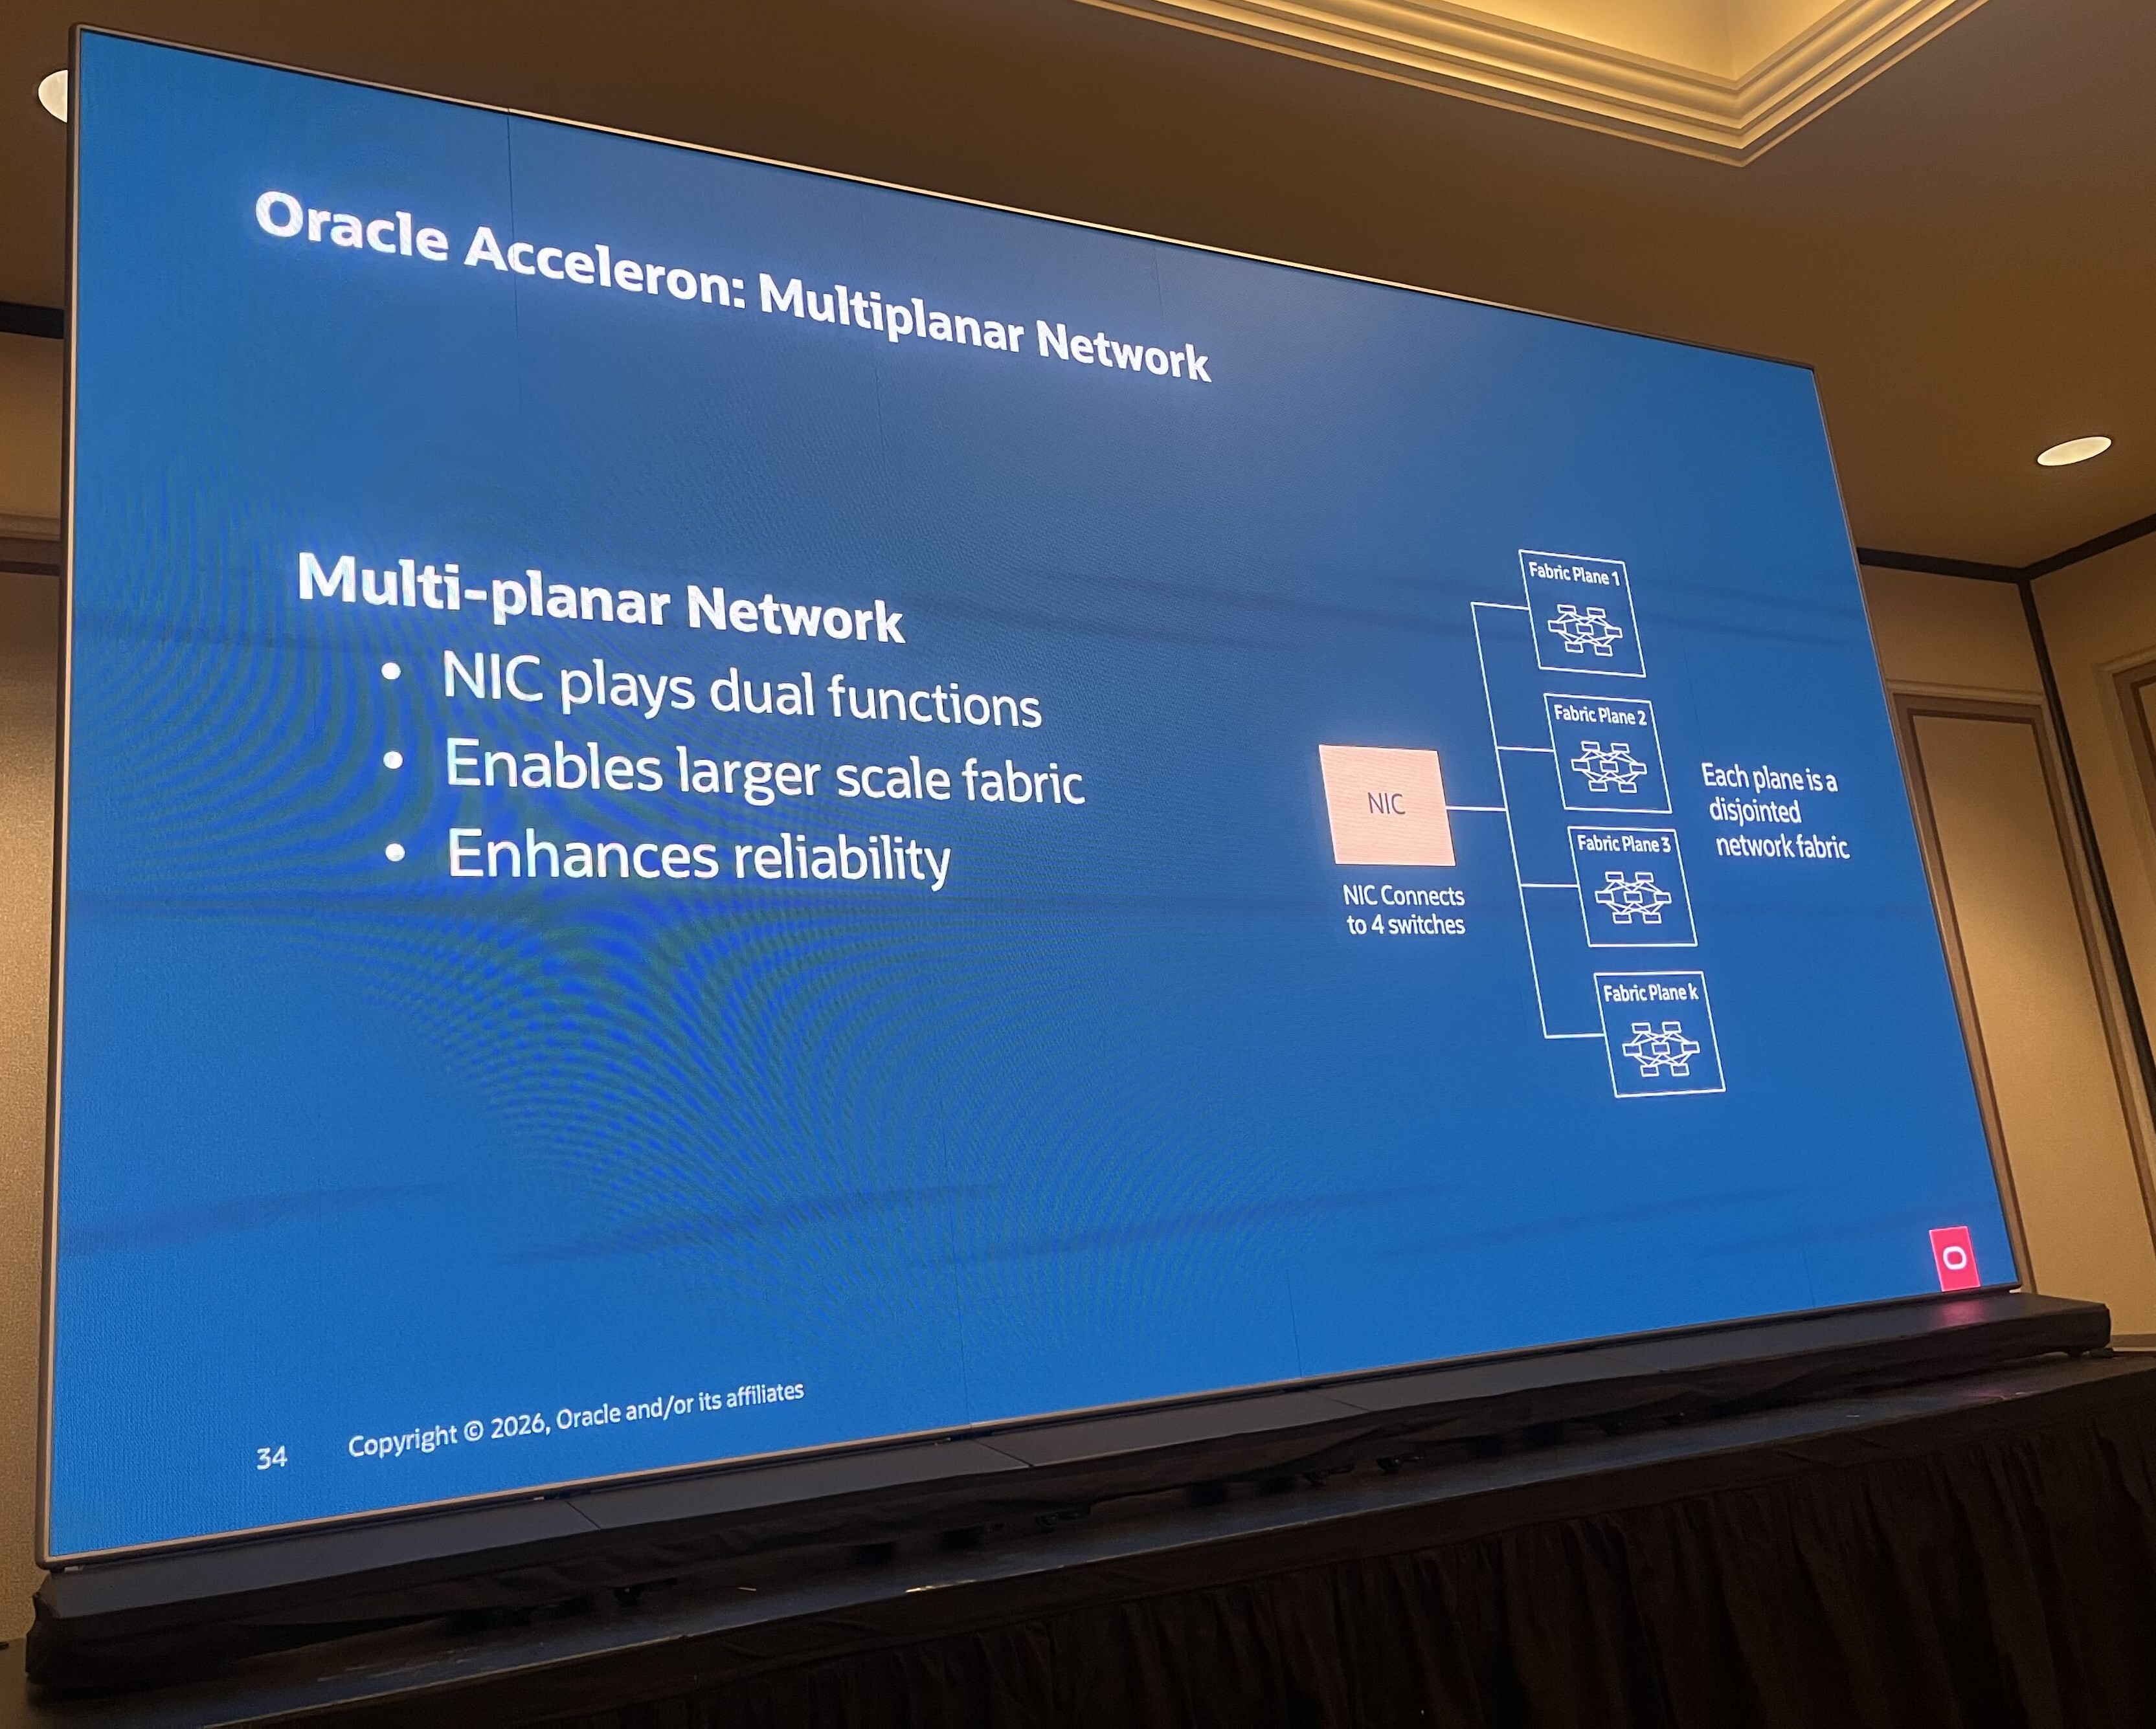
- Oracle Acceleron のマルチプレーン構成では、NIC が複数のスイッチにつながります(スライドでは 4 つのスイッチ)。各プレーンは互いに独立したネットワークです。高基数(High Radix)のスイッチを Tier-0 / Tier-1 の 2 段で構成し、プレーン 1〜k を並べる形でした。
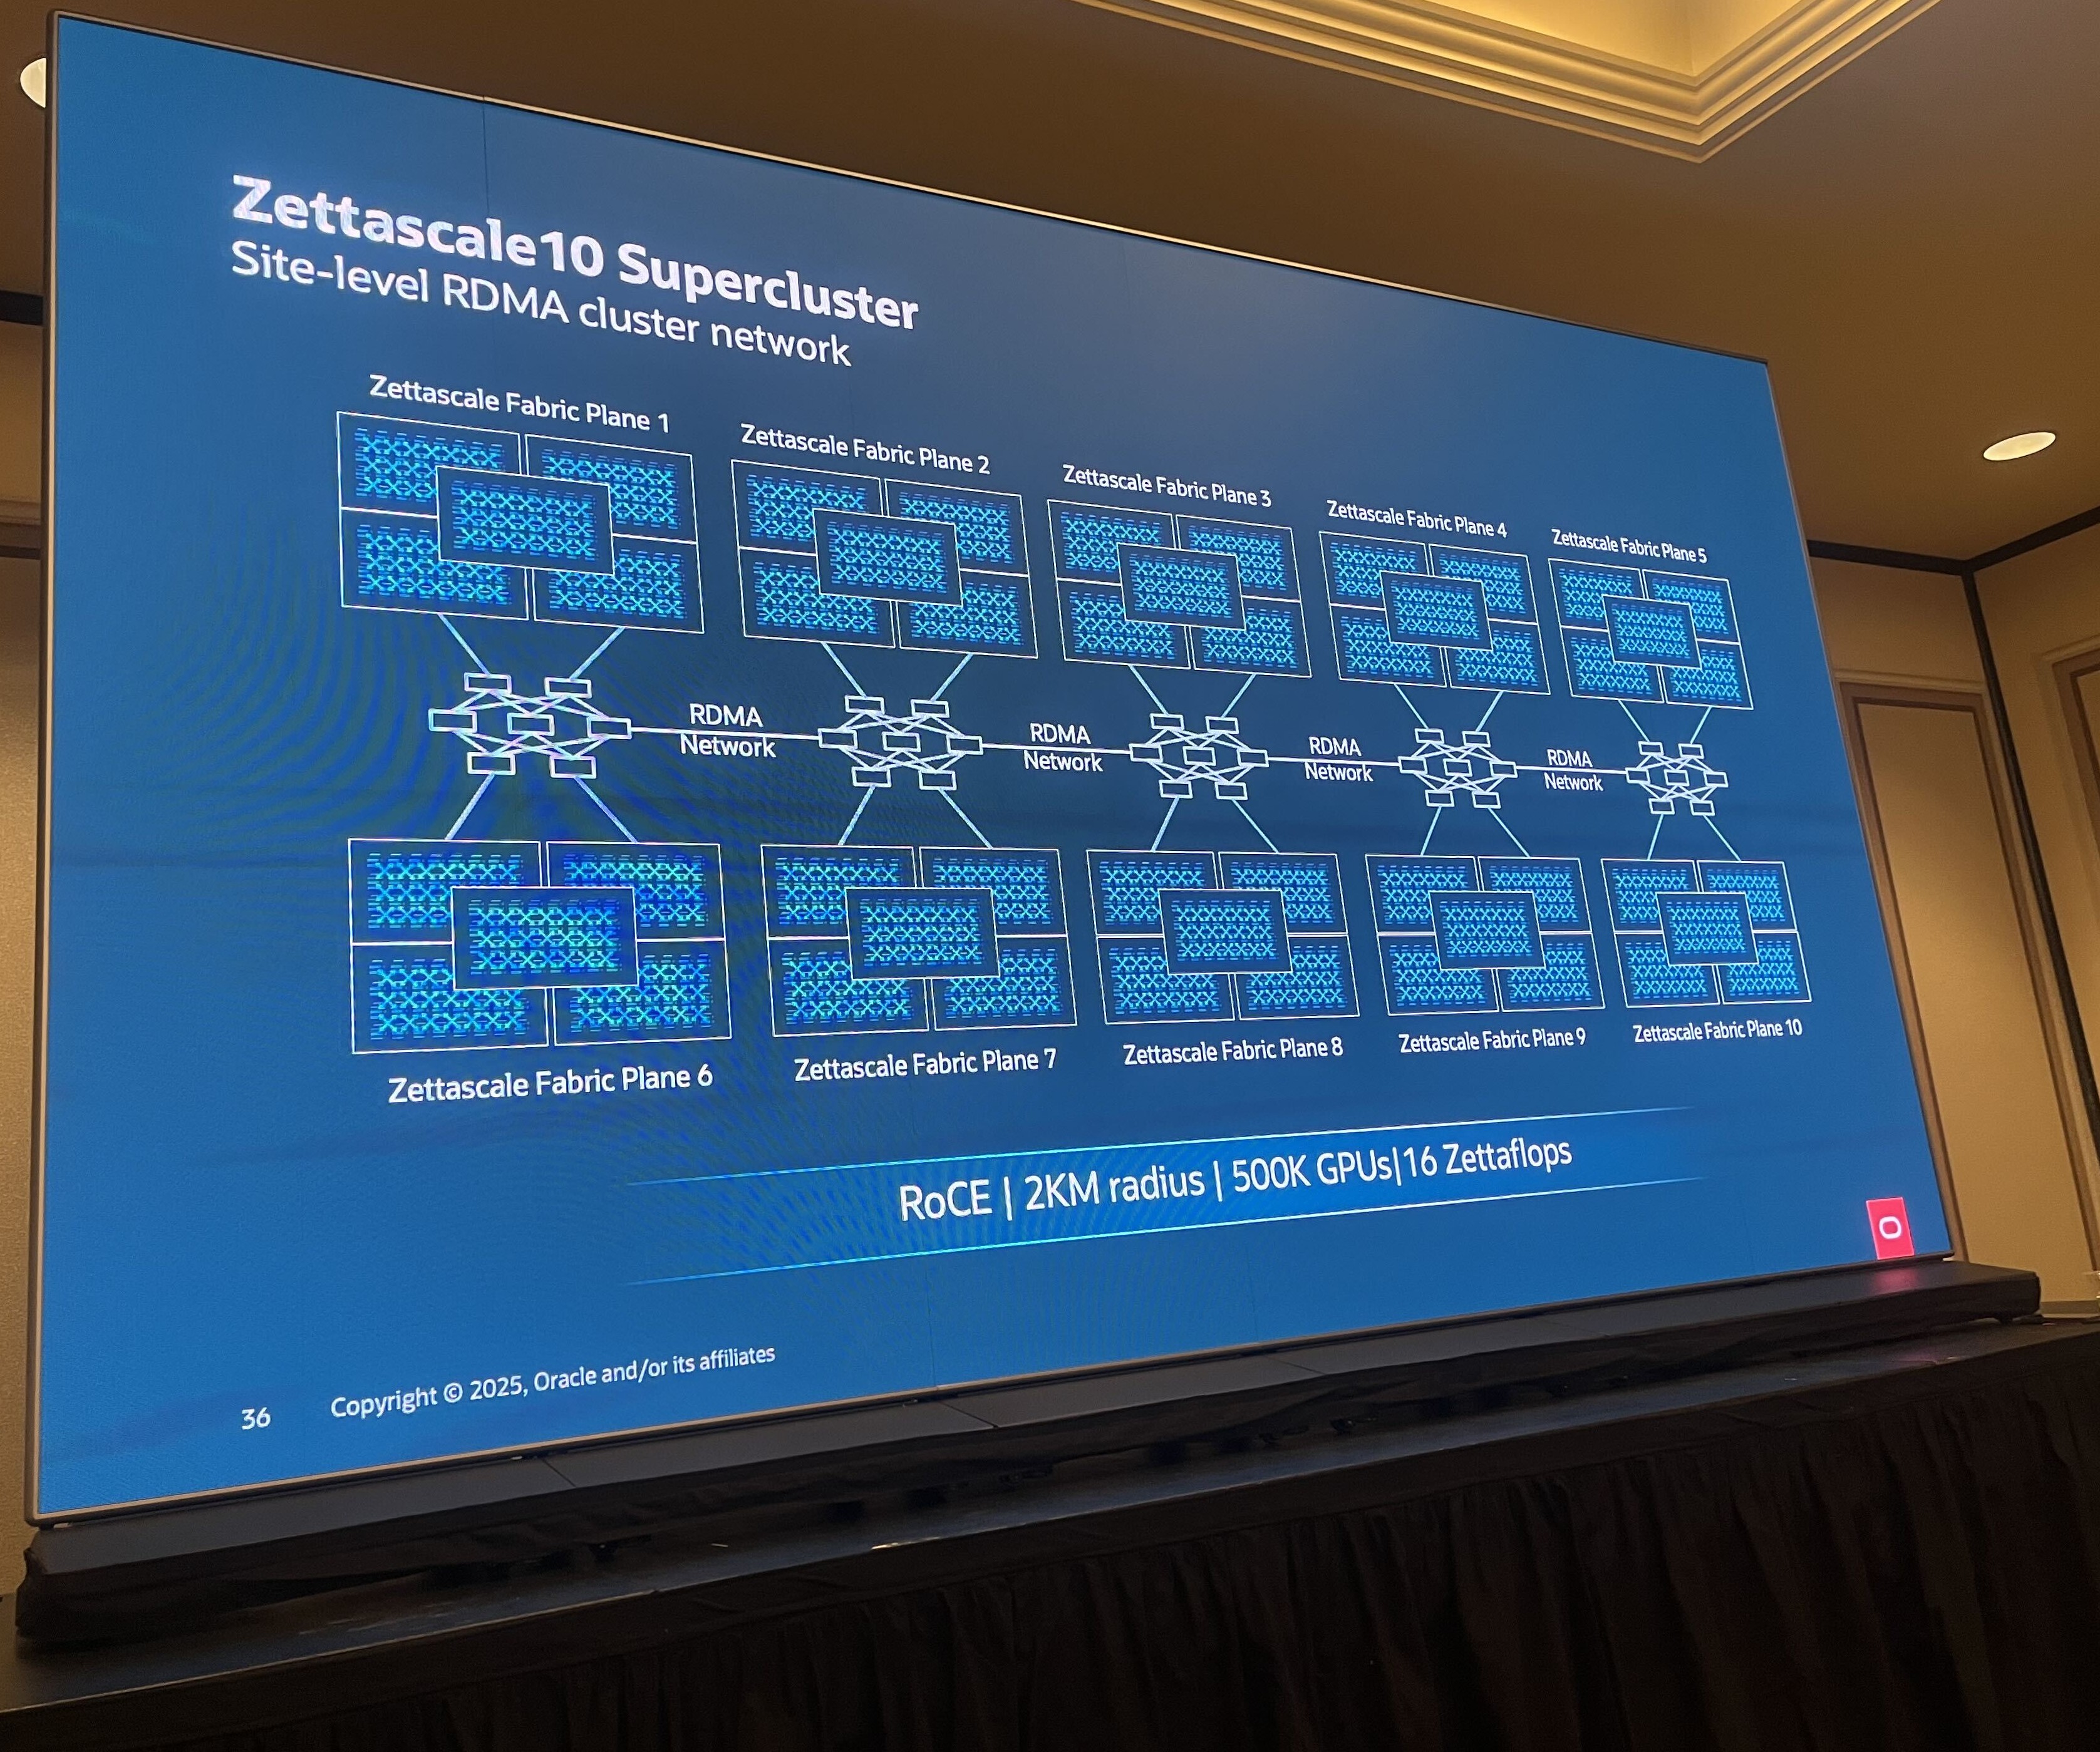
- 送信側のホストが複数のプレーンにトラフィックを振り分け、受信側の NIC で束ねる構成と説明されていました。セッションでは「最大 16 プレーン」と語られましたが、スライド(Zettascale10 の図)には Plane 1〜10 が描かれていました。ここでは数字を断定せず、複数の独立したプレーンで障害の影響を局所化する点を押さえておきます。
Zettascale10 Supercluster
- Zettascale10 のスライドは、RoCE、半径 2 km、50 万 GPU、16 ゼッタフロップスと示されていました。前述の 80 万 GPU とは、スライド上の表記が異なります。
制約をどう乗り越えるか
- 現場で直面する制約として、スライドでは次の 3 つが挙げられていました。
- Stranded Power(使えない電力):データホールに電力の余裕があっても、ラックの組み合わせ次第で使い切れない問題。ラックの構成を最適化して対処します。
- Thermal Incompatibility(熱の非互換):GPU ベンダーごとに要求する冷却条件が異なる問題。TCS 温度が 20°C 程度の低温を要するものから、最大 45°C まで許容するものまであります。
- Cluster Constraints(クラスターの制約):リーフ配下と、2 ホップ以内のスパイン配下に置ける GPU 数の上限。
まとめ
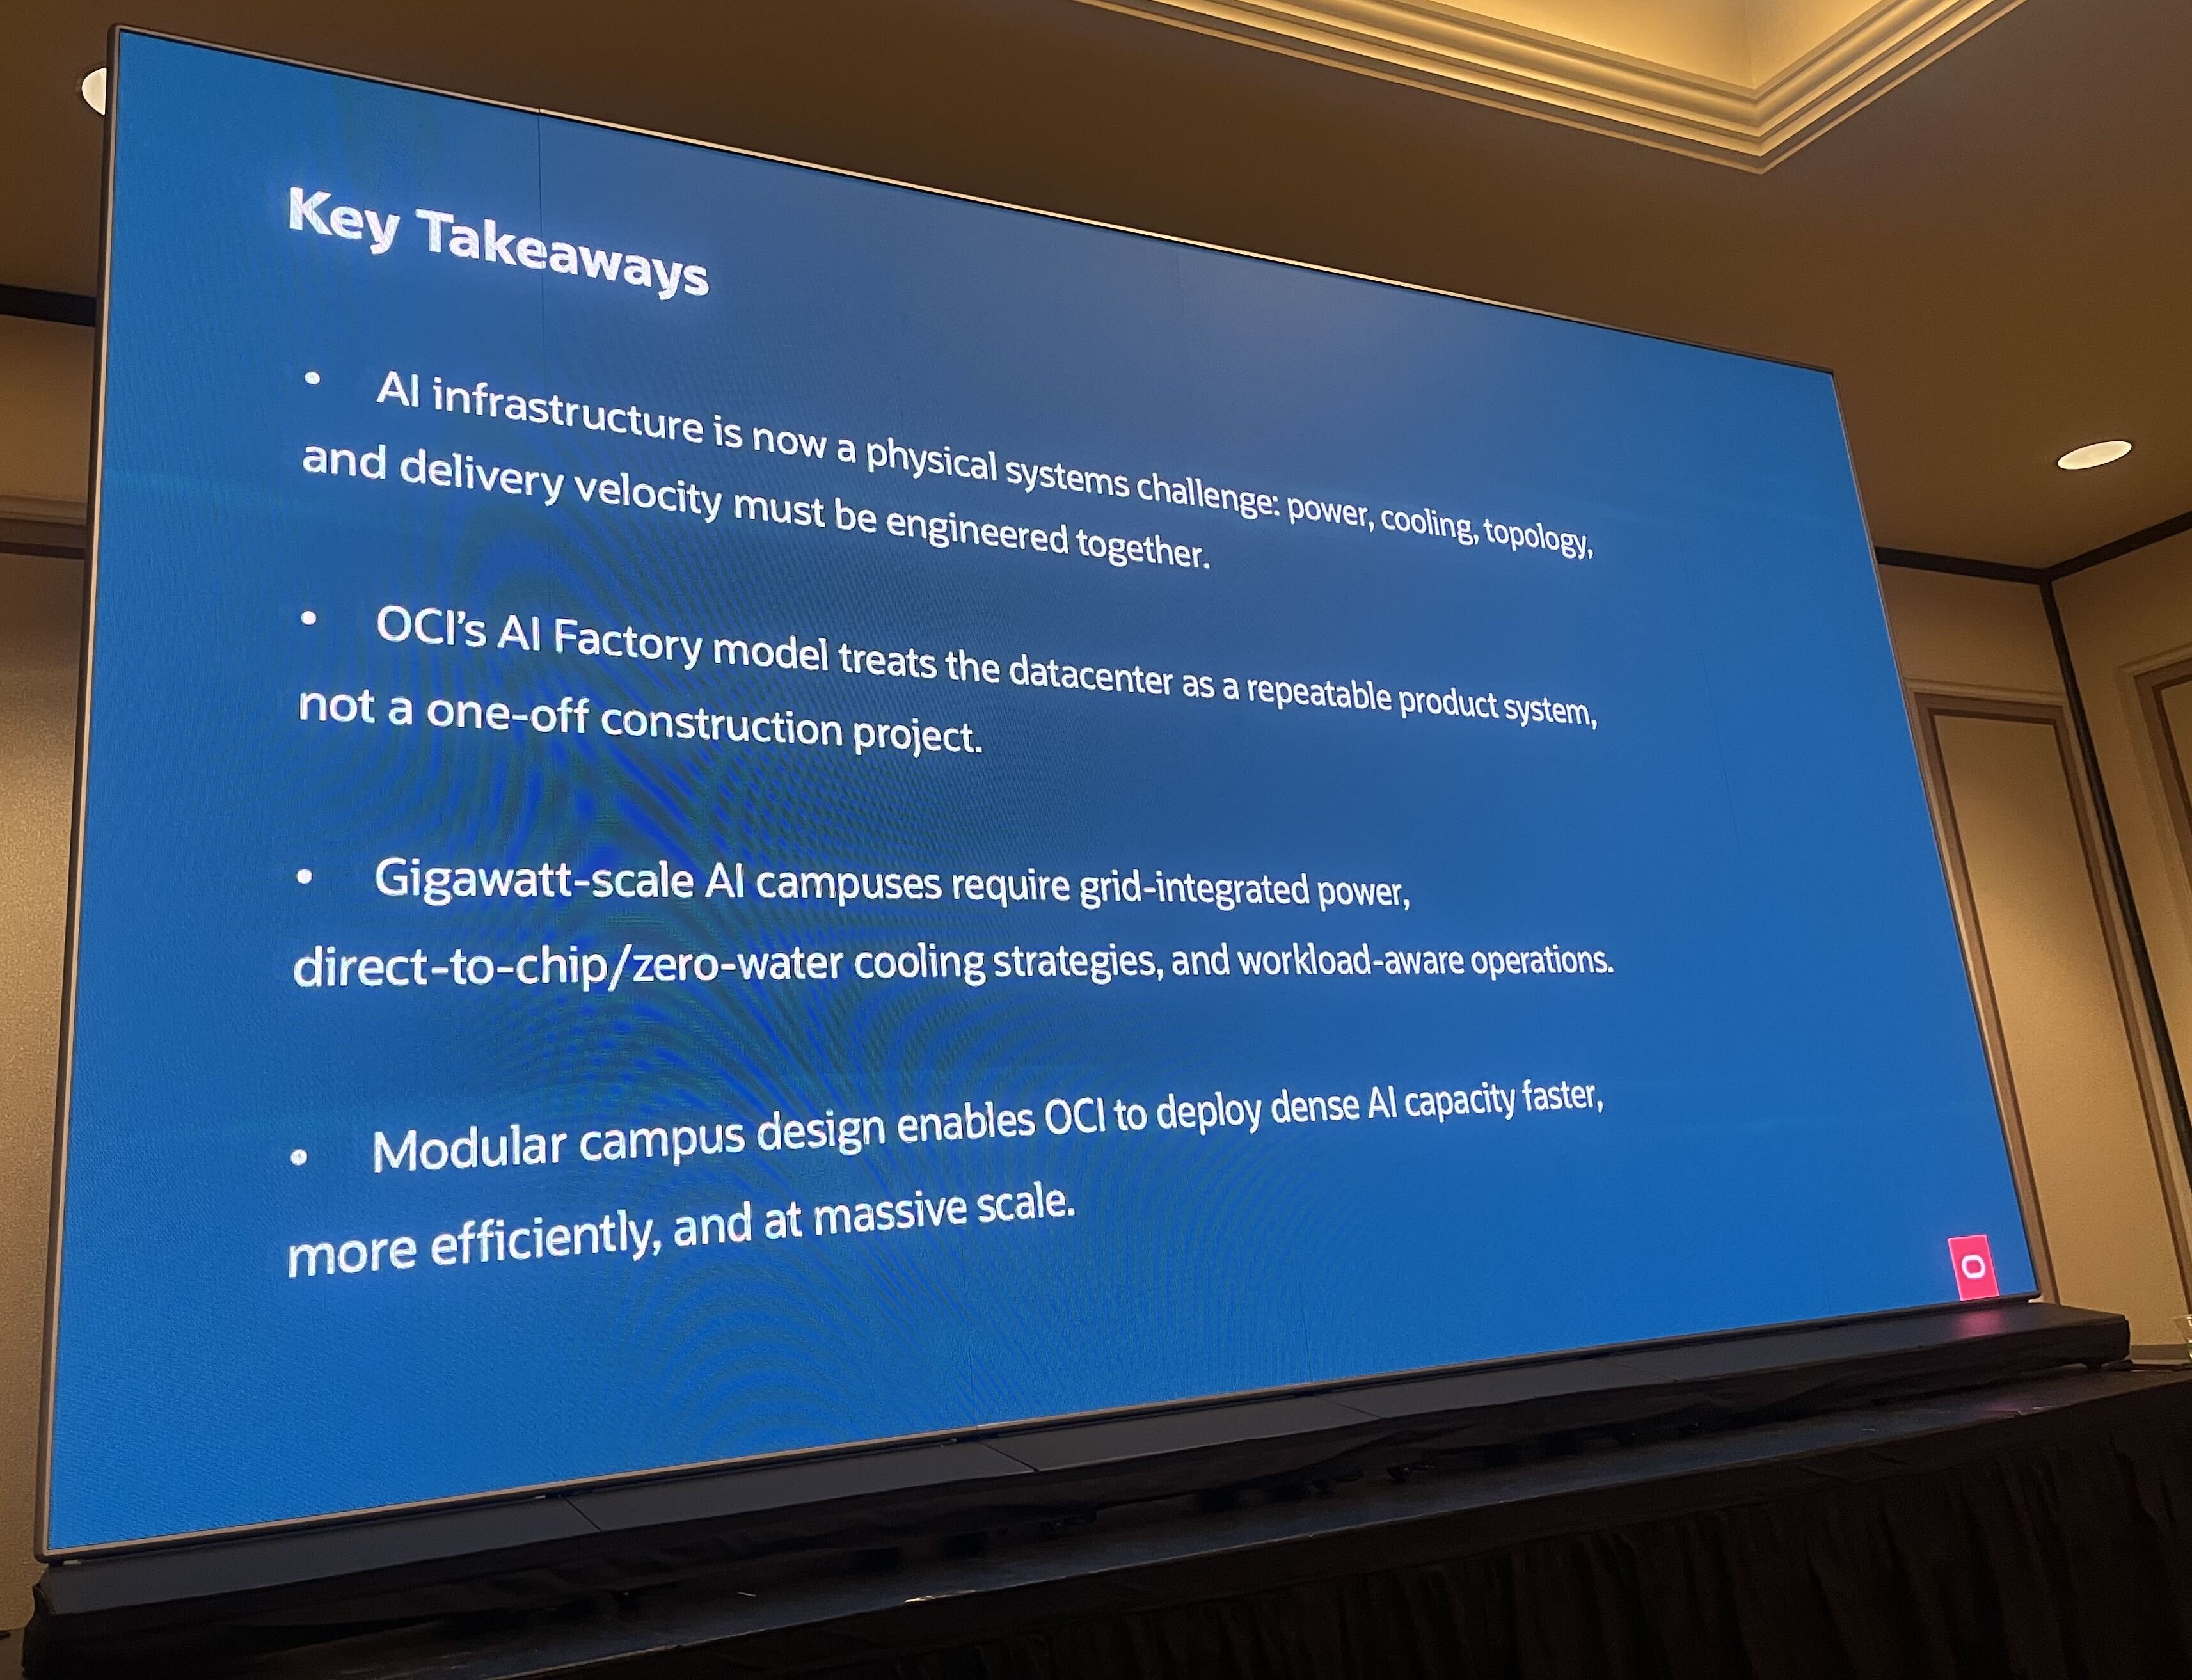
- Key Takeaways では、ギガワット級の AI キャンパスには、電力網と統合された電力、ダイレクトチップ(水を使わない)冷却、ワークロードを意識した運用が必要だと整理されていました。
- 今回のセッションで印象に残ったポイントは次の 3 つです。
- AI インフラは、電力・熱・ネットワーク配置まで含めた物理システムの設計になっている
- 電力は段階的に、冷却は水を使わずに、ネットワークはプレーンを分けて設計している
- 繰り返し作れるモジュール設計が、構築スピードの土台になっている
おわりに
- 直接 IT ではない説明も多いセッションでしたが、AI の計算を動かすインフラと、その土台となる施設まで知ることができ、大変勉強になりました。電力や冷却といった施設にも、最新のテクノロジーが使われていると知り、そのスケールの大きさに興味が湧きました。
- こうした取り組みは、他のクラウドとの違いでもあると理解でき、OCI の魅力がより深まりました。施設の設計まで考えられていることが分かり、安心して任せられるという印象も持ちました。
 簡単30秒