


TL;DR
- セッション「Build a Real AI Data Foundation: Architectural Patterns for AI Lakehouse」で、AI Lakehouse のカタログ(AI Data Catalog)に、AI がデータを探して理解するための機能を足していく方向性が語られた。
- AI がテーブルと列の説明・タグ(アノテーション)を提案してカタログに集め、AI エージェントはカタログ側の絞り込み(Agentic search)で、関係するテーブルだけを受け取る。
はじめに
2026 OCI Top Partner Engineers の今井です。
2026年10月25日〜28日にラスベガスで開催された Oracle AI World 2026 に参加した。本記事では、2026年10月28日 9:00〜9:45(PDT)に行われたセッション「Build a Real AI Data Foundation: Architectural Patterns for AI Lakehouse」を取り上げる。
Oracle Autonomous AI Lakehouse(以降、AI Lakehouse と表記)は、2025年10月に発表されている。今回のセッションは、その AI Lakehouse の上で、既存の Oracle のデータを分析や AI に使うための構成と、AI 向けの機能を説明するものだった。
Oracle のブログで AI Lakehouse の拡張機能の1つとされている Live AI Hub は、別の記事で詳しく紹介しているため、本記事では扱わない。
AI Lakehouse とは?
2025年の発表によると、AI Lakehouse は、Oracle Autonomous AI Database と、ベンダーに依存しない Apache Iceberg を組み合わせたデータ基盤だ。Iceberg のテーブルにも、自然言語から SQL を作る Select AI や AI Vector Search など、Autonomous AI Database の機能を、データを移さずに使えるとしている。2026年の発表では、OCI のほか、AWS、Microsoft Azure、Google Cloud、Oracle Exadata Cloud@Customer、OCI Dedicated Region で使えるとしている。
そのデータの入り口になるのが、カタログの Oracle AI Data Catalog だ。登壇者は、AI Data Catalog を、Oracle のデータベースや Iceberg のテーブルなど、散らばったデータソースをまとめて把握する場所と説明した。
AI Data Catalog は、登録したデータソースの中身を把握して検索できるようにし、データソースをまたぐ問い合わせの土台になる。新しく作った AI Lakehouse のデータベースも、すぐに AI Data Catalog につなげられる。
今回紹介された拡張の多くは、この AI Data Catalog に、AI がデータを探して理解するための機能を足すものだ。
AI Lakehouse の拡張でできること
| できること | 中身 |
|---|---|
| AI にテーブルと列の説明・タグを付けさせる | AI が説明とタグを提案し、人が確認して保存する。保存した内容はカタログに集まる |
| AI エージェントが、関係するテーブルだけを受け取る | カタログ側で上の階層から絞り込み、関係するテーブルだけを返す Agentic search のツールが足される |
| 既存の Oracle Database を、移さずにカタログにつなぐ | オンプレミスの Oracle Database にも対応し、その場のデータを他のデータと組み合わせて問い合わせる。デモでは、Oracle Database を JDBC のカタログとして登録していた |
| オブジェクトストアのデータを速く処理する | よく読むデータをキャッシュし、大きな処理は必要なときだけ作るクラスターで分散させる |
ここで重要なのは、データを1か所に集め直すのではなく、カタログを通して元の場所のデータに AI と SQL を届けるという点だ。登壇者は、データを手元に持ちたい場合には GoldenGate やマテリアライズド・ビューなども選べると説明していた。
さらに性能を上げるために足された仕組みが、Lake Cache と Data Lake Accelerator の2つだ。キャッシュは、データが追加されても中身との整合を保つ。
Data Lake Accelerator を有効にすると、最初のクエリでクラスターを起動し、一定時間使われなければ解放する。リリースノートによると、Data Lake Accelerator 自体は2025年11月から提供されている。
会期中の公式発表では、100 TB の TPC-DS のデータで最大3倍速くなり、クラスターの最大サイズも3倍になったとしている。
発表のポイント
1. AI が付けたアノテーションで、NL2SQL が正しいテーブルを選ぶ
1本目のデモは、「ウォータースポーツ製品の平均小売価格」を自然言語で尋ねるところから始まった。
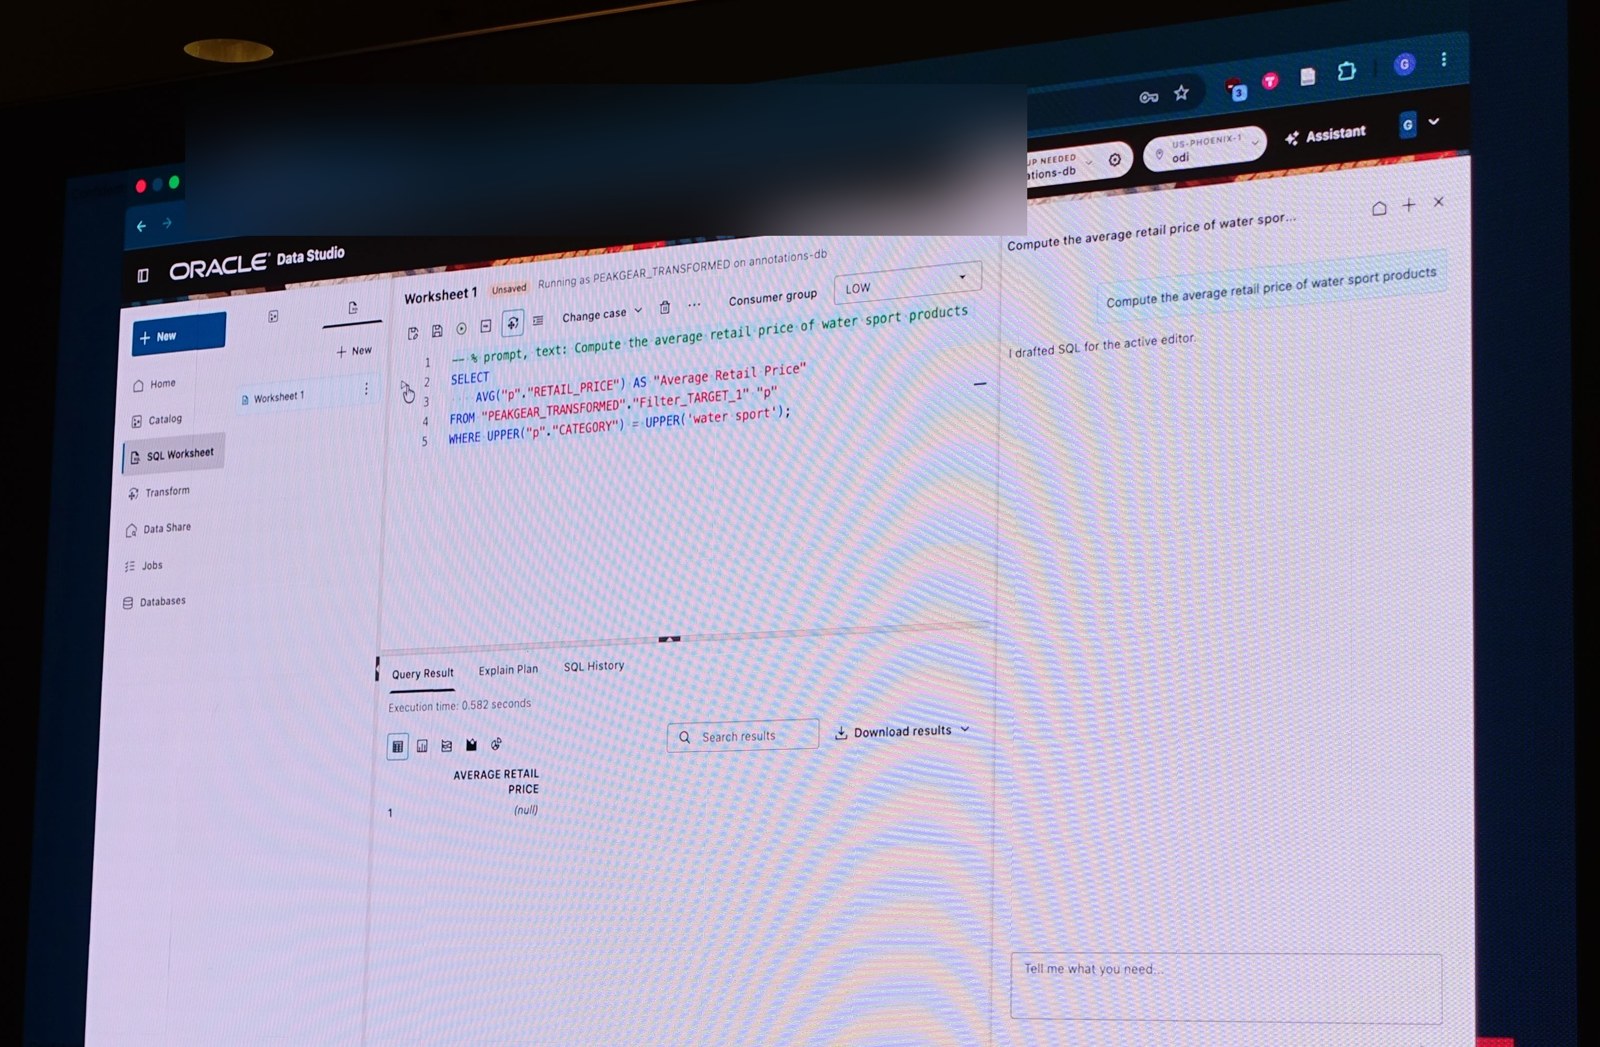
生成された SQL は、Filter_TARGET_1 という名前のテーブルを選び、結果は null だった。データ変換の処理が出力したテーブルは、名前からは中身が分からない。
そこで、Data Studio のデータ変換(Data Transforms)の流れの中で、AI に出力テーブルの説明を作らせる。カタログの画面からも、別のテーブルに AI がテーブルと列の説明・タグを提案でき、人が確認してから保存する。
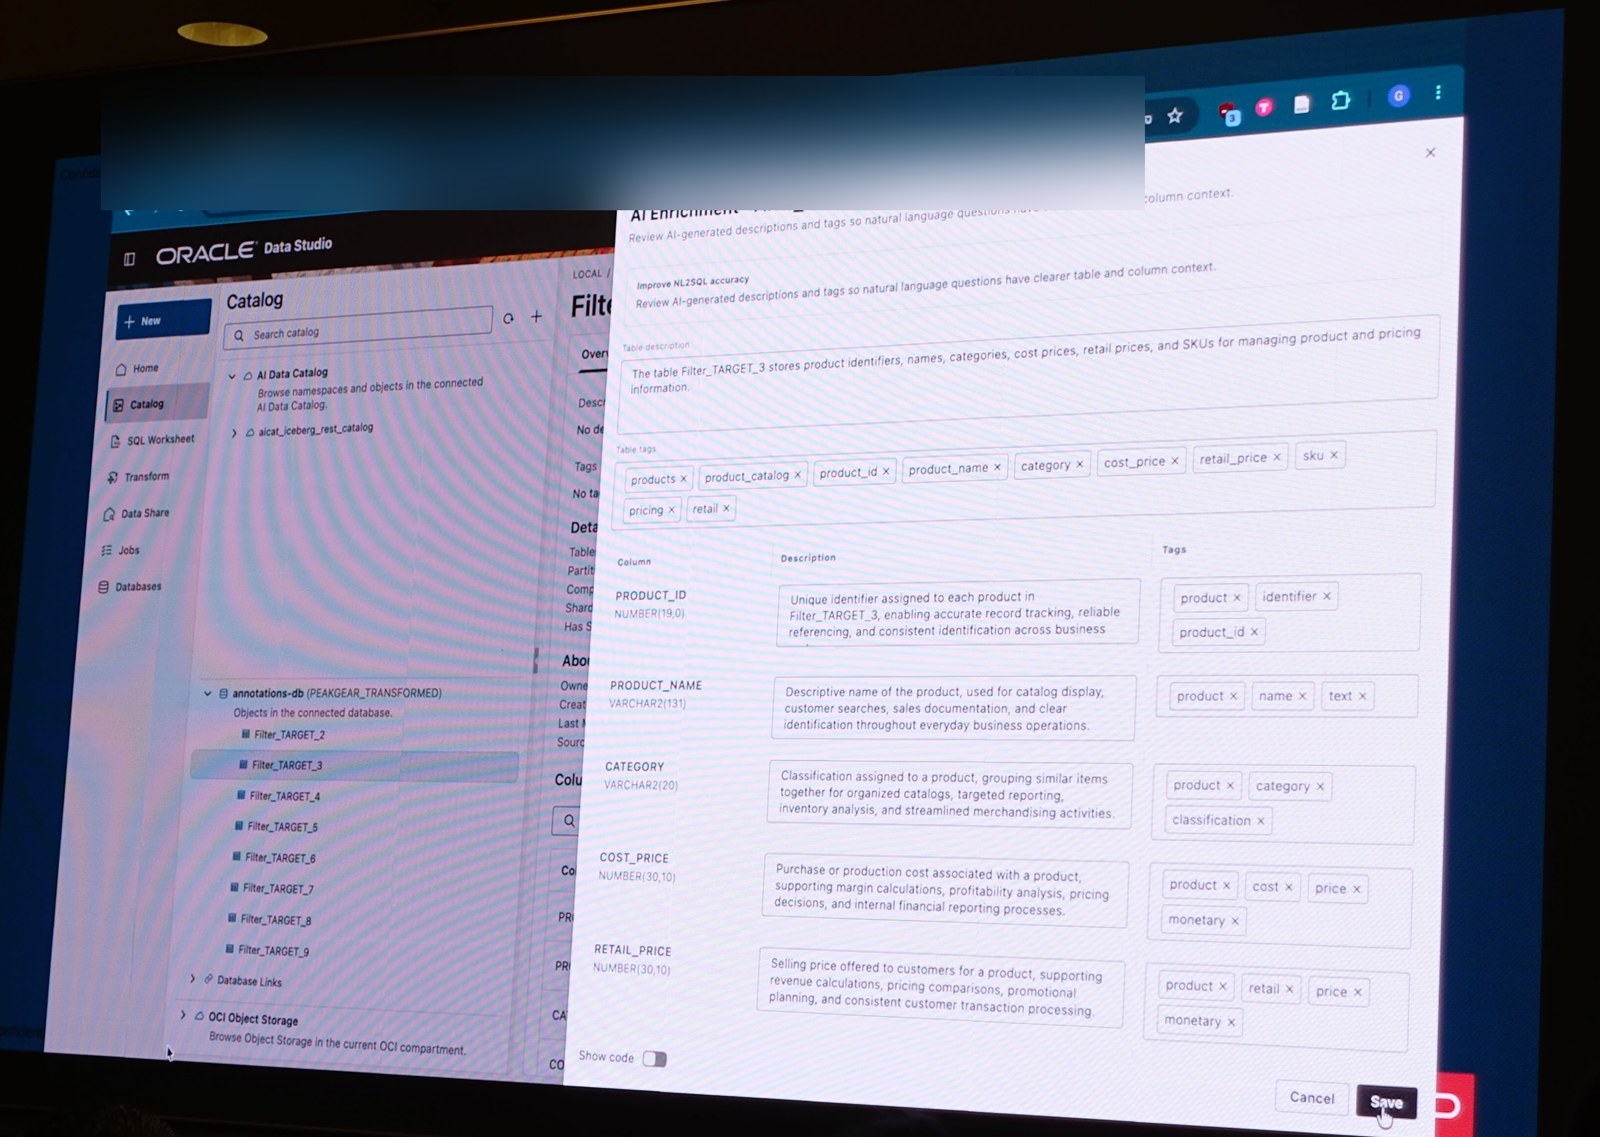
保存した説明とタグは、元の Oracle Database に入り、そのデータベースをカタログに登録すると、カタログからも見えるようになる。同じ質問をやり直すと、今度は正しいテーブルと条件が選ばれた。
アノテーションは、元のデータベースにある場合はカタログと同期し、Iceberg のテーブルのように、アノテーションを自前で持てないデータには、カタログ側で付けられる。リリースノートによると、AI によるアノテーションの生成は、Data Transforms の2026年5月のリリースで追加されている。
2. Agentic search で、大量のテーブルから必要なものだけを渡す
テーブルが何千もあると、AI エージェントが正しいテーブルにたどり着くのは難しくなる。そこで足されるのが、Agentic search のツールだ。
仕組みは、メタデータを名前空間ごとに要約しておき、質問のたびに上の階層から絞り込むというものだ。これらのツールは、Oracle が提供する MCP のパッケージに含まれ、AI Data Catalog につないだエージェントから使えるようになるという。
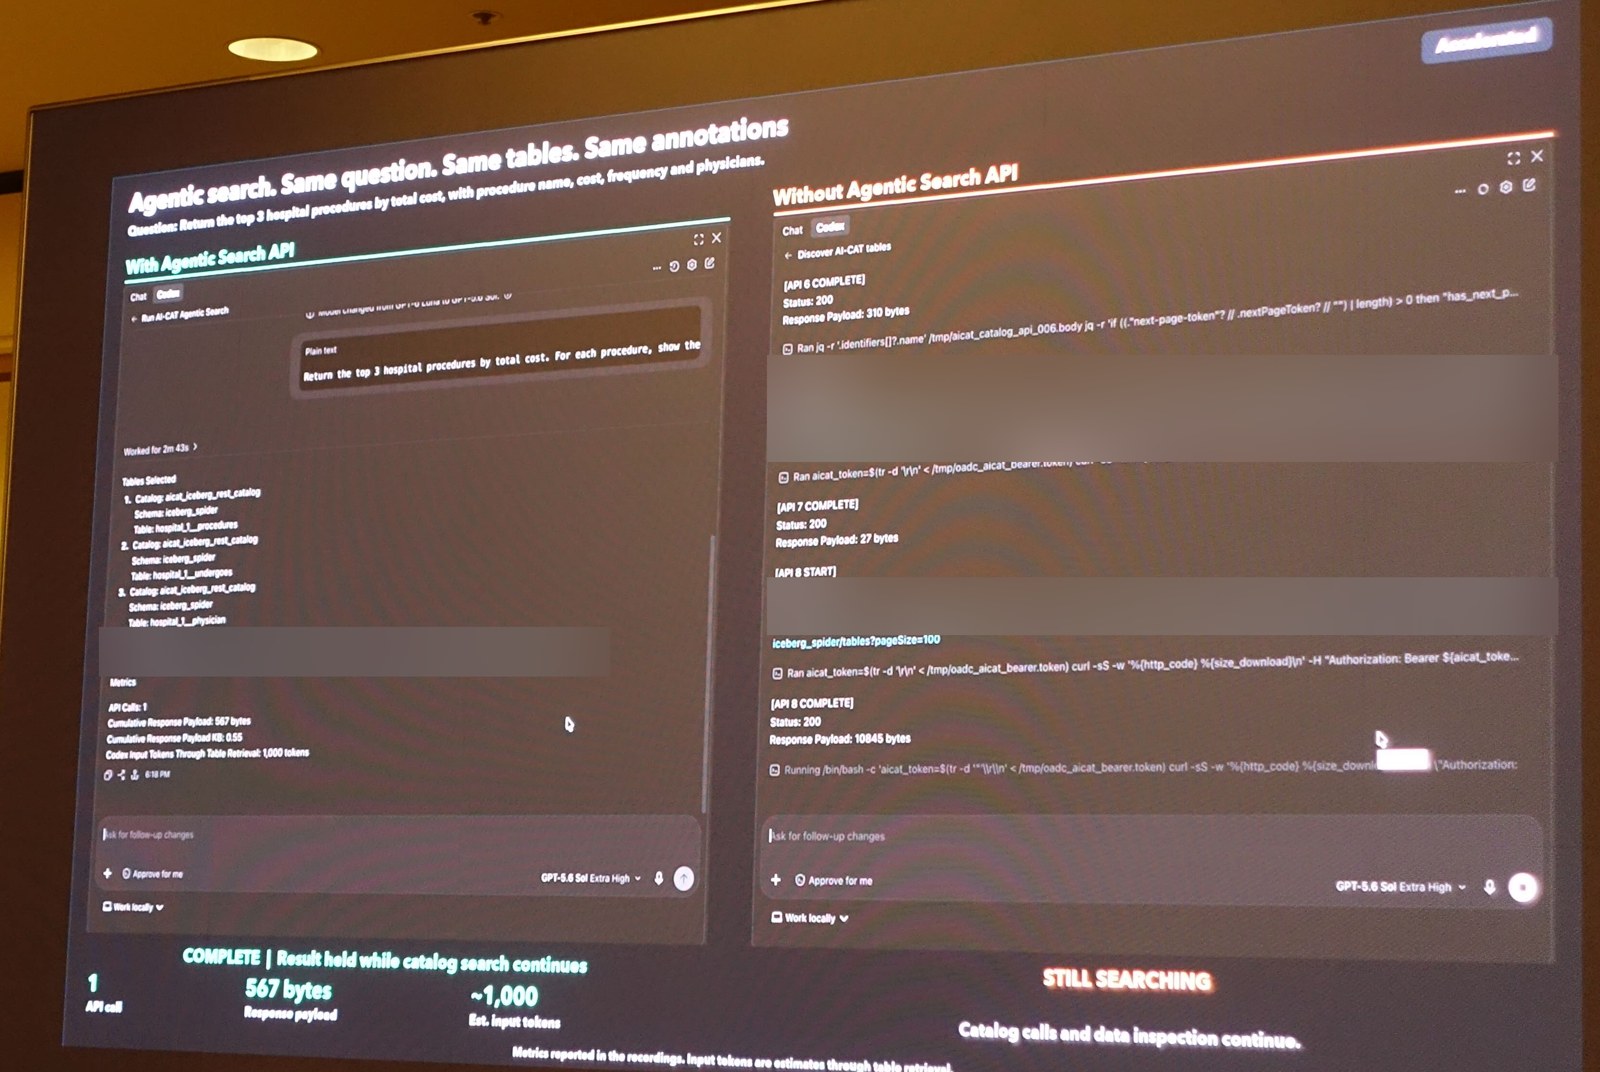
2本目のデモは、病院の手技に関する同じ質問を、Agentic search のあり・なしで並べて実行するものだった。ありの側は API の呼び出し1回で結果を返し、なしの側は検索を続けていた。
登壇者によると、なしの側は100回以上 API を呼び出し、20倍遅かった。検索している間は AI の利用料もかかり続けるため、速さだけでなくコストにも効くと説明していた。
押さえておきたい制約・前提
セッションの最後に登壇者は、紹介した内容はすべて Data Studio から今すぐ使えると述べた。Data Studio の URL は datastudio.oracle.com だ。ただし登壇者は同じセッションの中で、Agentic search を「足していく」もの、カタログの概要表示を Data Studio に「統合される予定」のものとも説明していた。追加料金はかからず、プラットフォームに含まれるとも述べた。
一方、会期中の公式発表では、AI Data Catalog(外部のカタログやデータベースのマウント、メタデータの充実)と、カタログのアノテーションを使う Business Semantic Layer は、どちらも今後12か月以内に提供予定とされている。セッションの「今すぐ使える」とは食い違うため、どの機能をいつから使えるかを含め、詳細は公式の情報を確認いただきたい。
2本目のデモで画面に出ていた数値(API の呼び出し1回など)は、録画での値と注記されていた。
ユースケースの考察
1つ目は、社内で NL2SQL や AI エージェントを試したものの、誤答が多くて使われなくなったケースだ。データ変換の処理が作った Filter_TARGET_1 のような名前のテーブルは、人にも AI にも中身が分からない。AI に説明とタグの下書きを作らせ、業務を知る人が確認して保存するという分担なら、メタデータの整備にかかる手間を小さくできる。
2つ目は、テーブルが多い基盤で AI エージェントを動かすケースだ。エージェントがツールを何度も呼び出してテーブルを探すと、応答が遅くなるうえ、トークンの利用料も増える。探す処理をカタログ側に寄せる Agentic search は、精度だけでなく、運用コストの見積もりにも関わる。
3つ目は、オンプレミスの Oracle Database にある在庫データと、データレイク(Iceberg)のデータを組み合わせるケースだ。すぐには移行できない基幹のデータベースでも、データを移さずにカタログへつなげれば、AI 活用の検証を既存の環境のまま始められる。
Live AI Hub については、別の記事で紹介しているので、あわせて読んでいただきたい。
AI に業務データを使わせるとき、精度を左右するのはモデルより先に、データに付いている意味と探し方だ。まずは誤答が出ている質問を1つ選び、関係するテーブルにアノテーションが付いているかを確かめるところから始めるとよい。
参考
- Oracle Autonomous AI Lakehouse Enables Open, Interoperable Data Access Across Multi-Platform, Multicloud Environments(Oracle News)
- Oracle Advances Autonomous AI Lakehouse with Business Semantic Layer and Expanded Support for Iceberg Data(Oracle News)
- Oracle Autonomous AI Lakehouseのイノベーションにより、企業全体のデータ資産でAIエージェントを活用(Oracle Blogs)
- What’s New in Oracle Data Transforms(Oracle Help Center)
- Data Lake Accelerator(Autonomous AI Database Serverless のリリースノート、2025年11月)
- Use Lake Cache to Improve Performance for External Tables and Mounted Catalog Tables(Oracle Help Center)
- Oracle Data Studio
 簡単30秒