


はじめに
- こんにちは、エンタープライズクラウド事業部の新川です。今週は Oracle AI World 2026 に参加するため、ラスベガスに来ています。さっそくですが、クイズです。
- Q. 256台のサーバー(ノード)で動かしている GPU で、AI の学習を3日間続けていました。そこで、GPU が1台、突然使えなくなってしまいました。このとき、いちばん頼りになるのはどれでしょう?
A) もっと多くの GPU
B) 直近のチェックポイント
C) もっと大きなオブジェクトストレージ
D) とても理解のある CFO
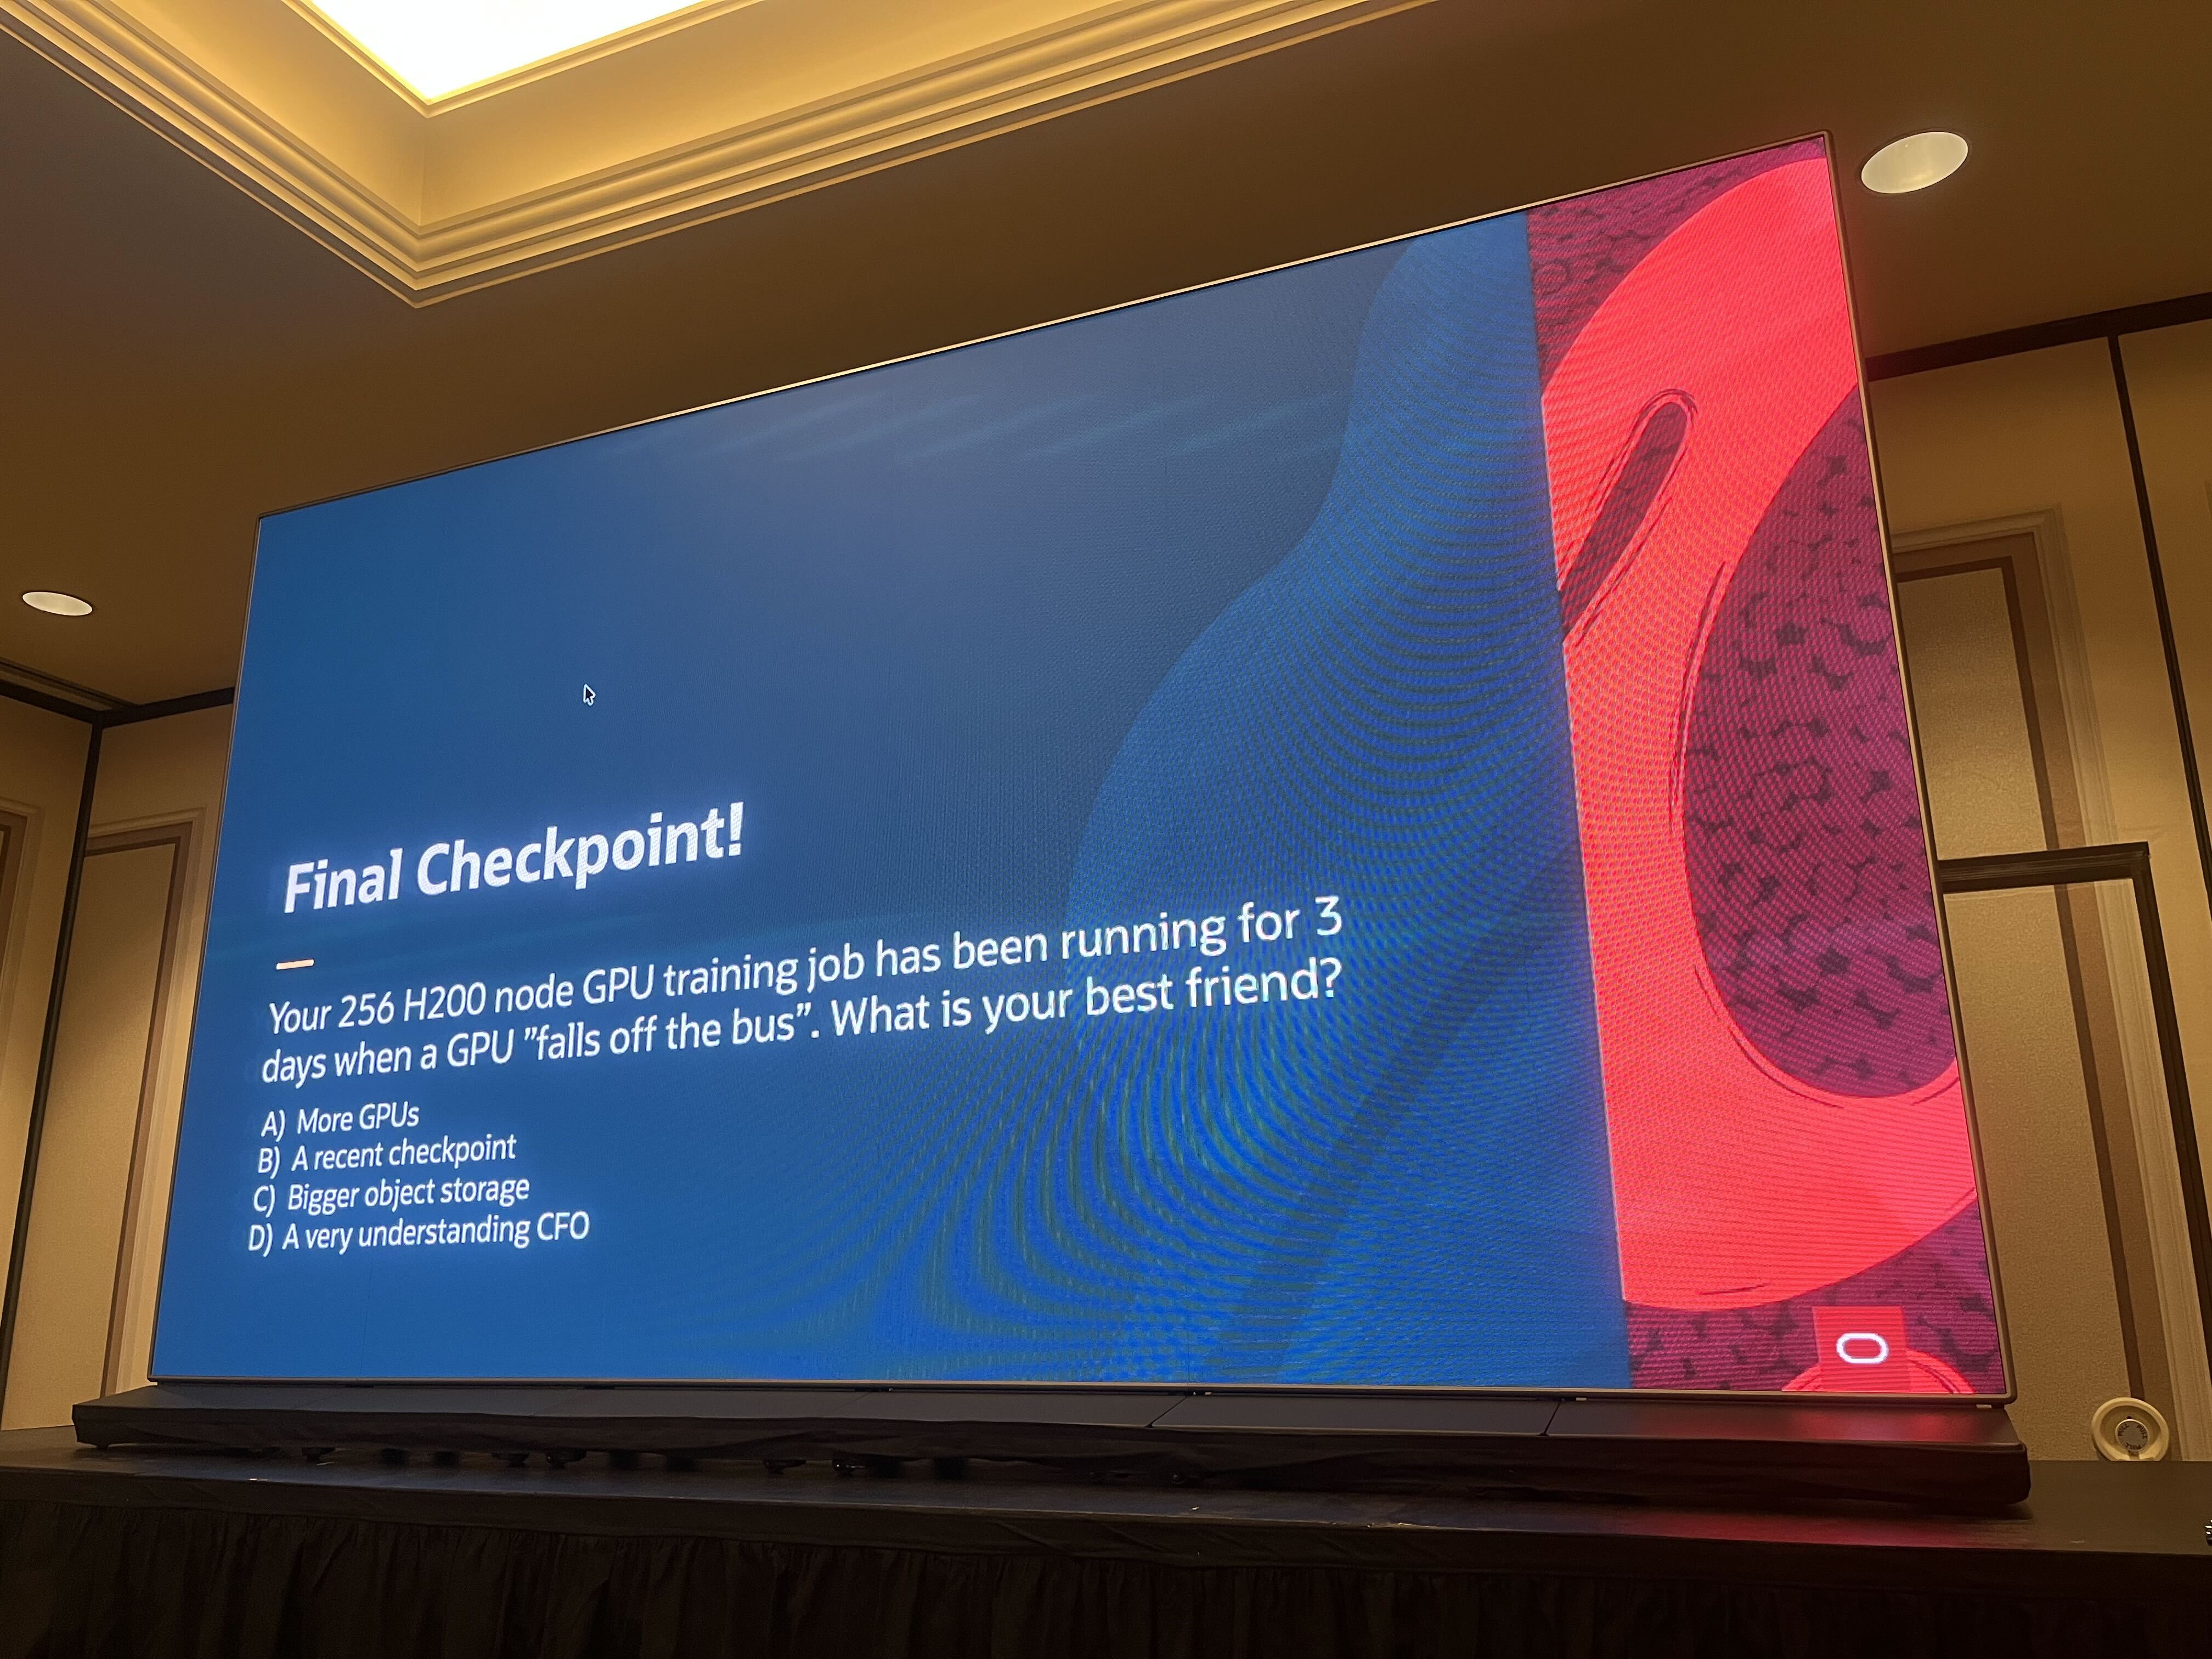
- これは、セッションで登壇者が会場に向けて出したクイズです。会場でも参加者が考えて答える場面があり、盛り上がっていました。皆さんも、一緒に考えてみてください。
- 今回は、セッション「Feed the Beast: Storage Strategies for AI at Scale」(LRN2408)のレポートです。AI というと GPU に目が行きがちですが、実は、GPU にデータを届けるストレージの選び方で、速さもコストも大きく変わります。セッションは、そのことを分かりやすく教えてくれる内容でした。タイトルの「Beast」は、データを大量に食べる GPU のことだと理解しました。
- この記事は、AI の内部の仕組みを解説するものではありません。AI を使ったシステムを作るエンジニアが、データの置き場所(ストレージ)を選ぶときに、押さえておきたい考え方の紹介です。
- ChatGPT のような AI を「使う」だけであれば、ストレージの違いは意識しなくても困りません。一方、GPU を使って AI の学習や調整を行う基盤を設計・運用する方にとっては、性能とコストを左右する大切な判断になります。また、AI の基盤にかかる時間や費用が、なぜストレージで変わるのかを知りたい方にも、役立つ内容です。
- なお、セッションの例は大規模な学習が中心ですが、小さな規模なら、シンプルな構成から始めて、足りなければ足していく、という考え方も紹介されました。専門知識がなくても読めるように、例えを交えて、スライドと一緒に紹介します。
ストレージ選びの基本
まず押さえたい、3つの柱
- 最初に示されたのが、この3つの柱です。
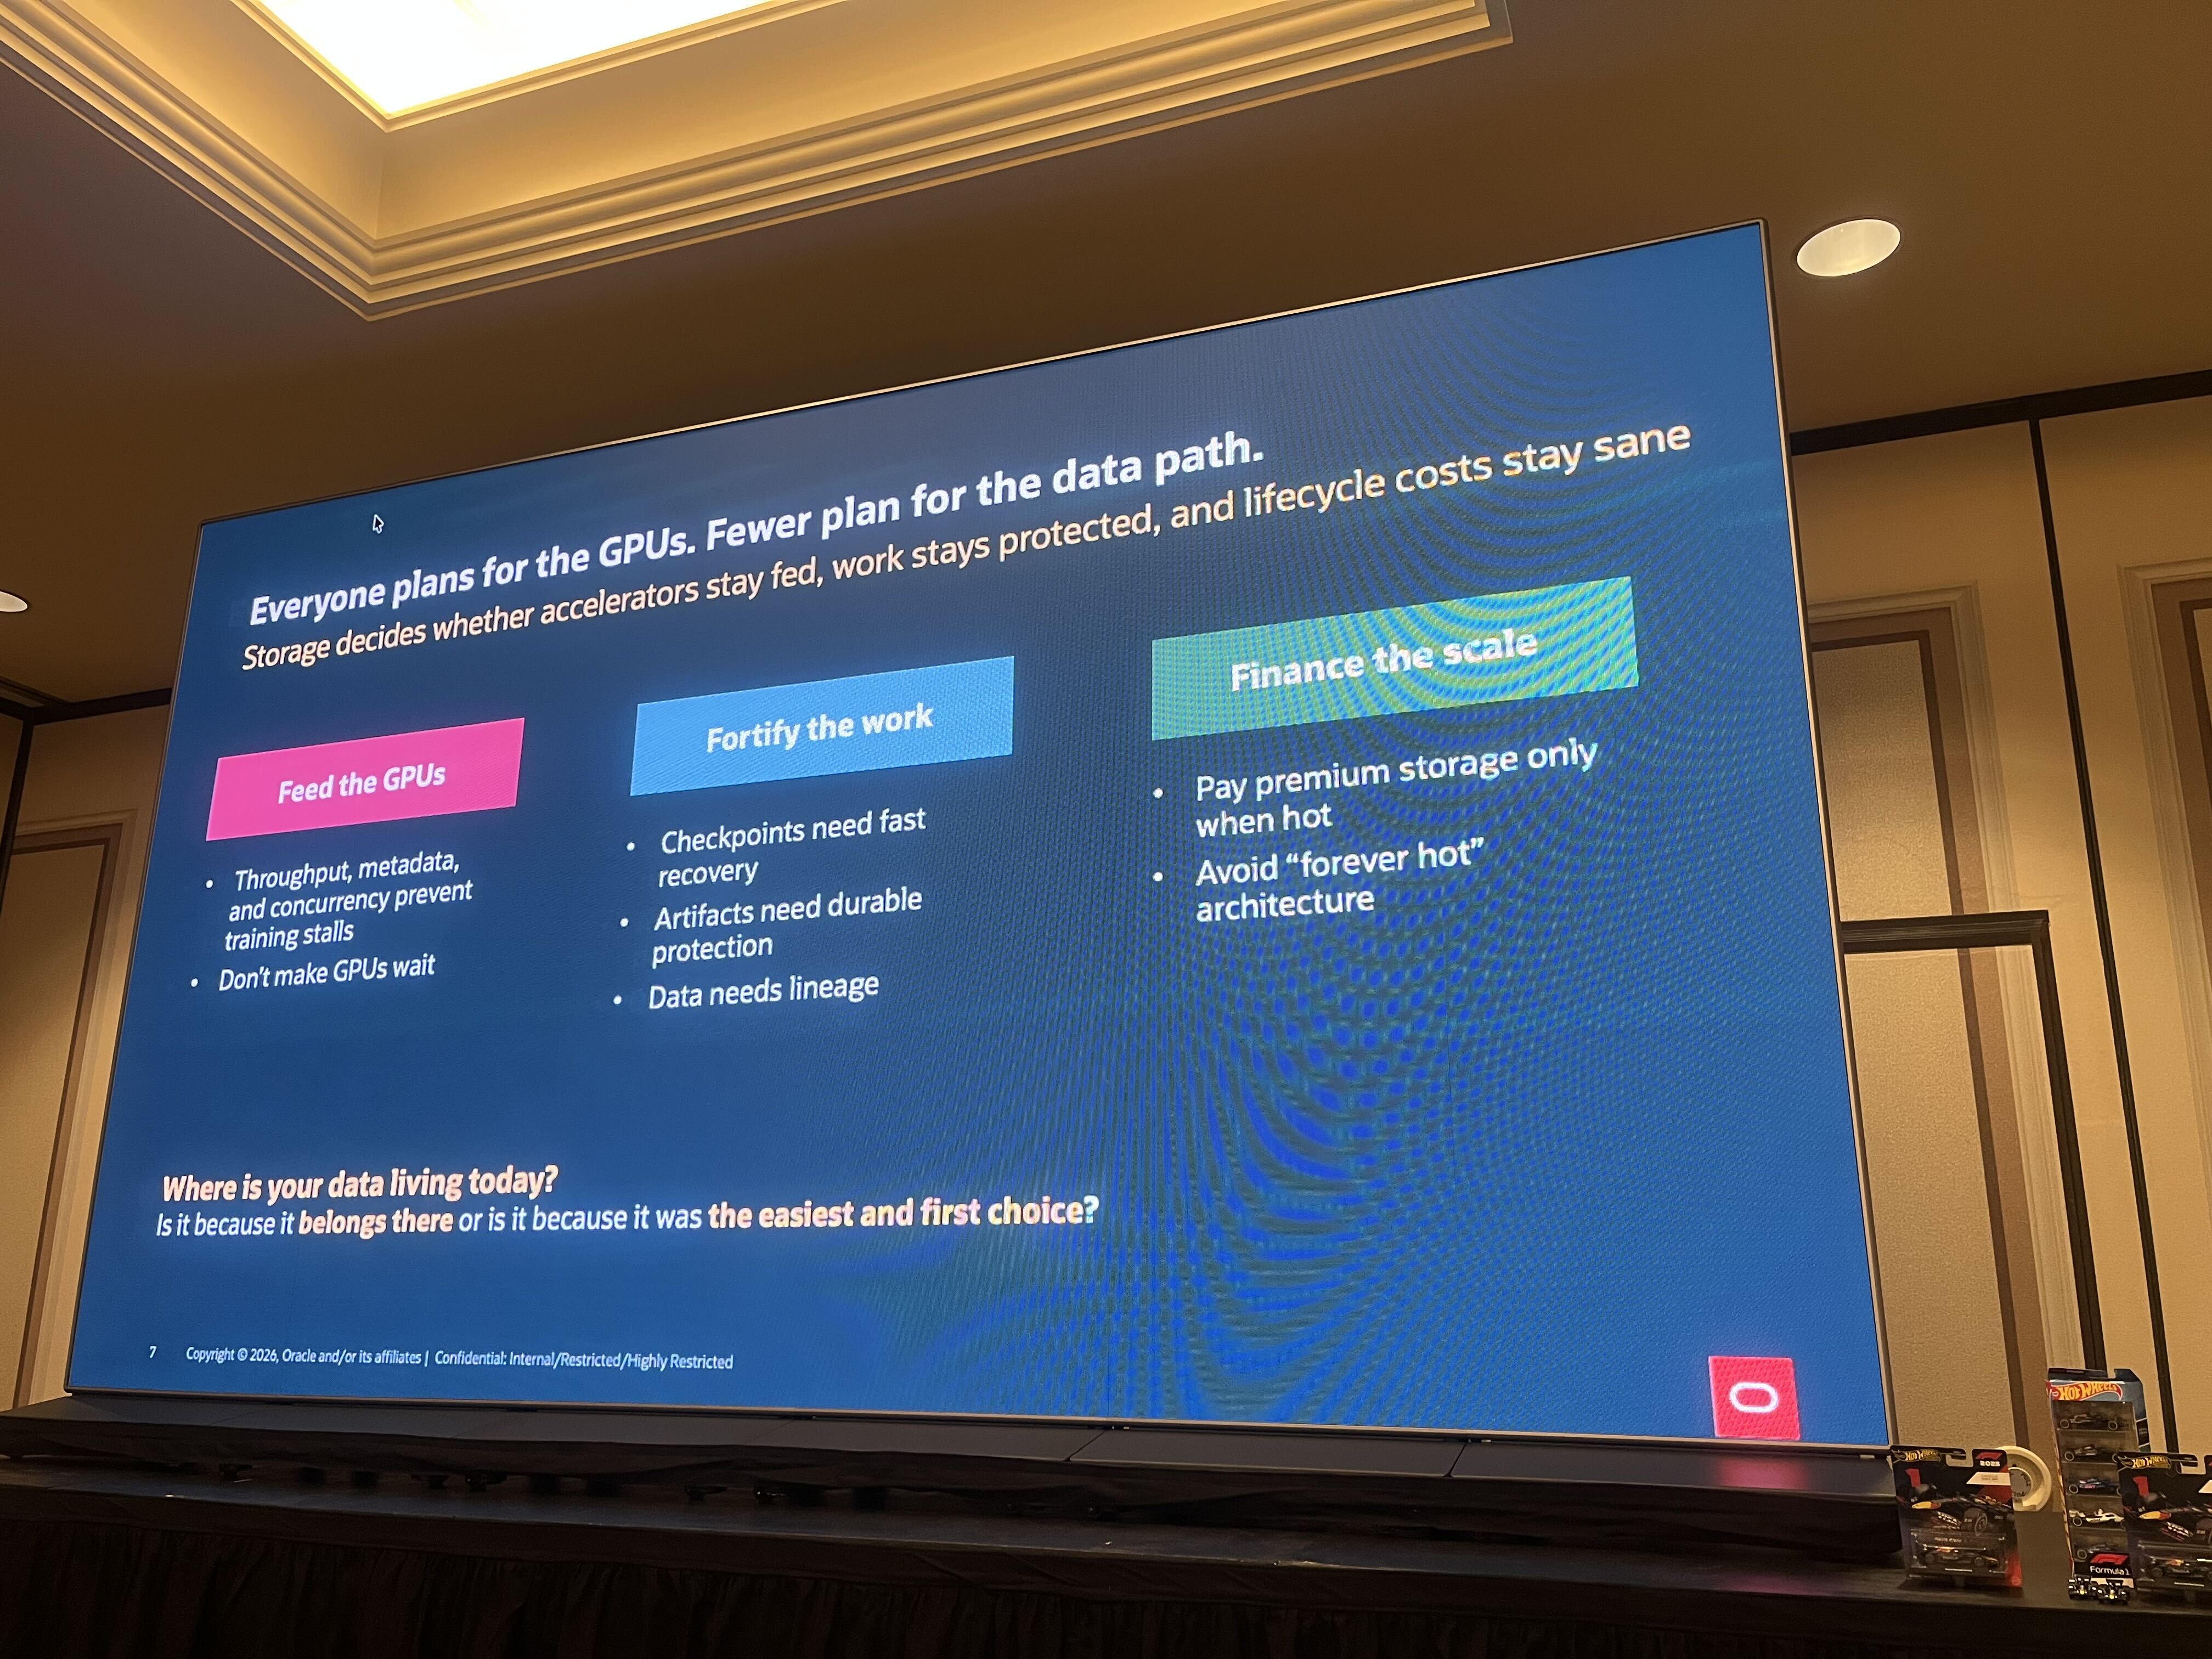
- スライドには、「Everyone plans for the GPUs. Fewer plan for the data path.(GPU の計画は誰もがするが、データの通り道を計画する人は少ない)」とあります。私も、まさにその通りだと思いました。
| 柱 | 意味 | スライドのキーワード |
|---|---|---|
| Feed the GPUs | GPU をデータ待ちにさせない | Don’t make GPUs wait(GPU を待たせない) |
| Fortify the work | 学習の成果と進捗を守る | Checkpoints need fast recovery(チェックポイントは素早く復旧できること) |
| Finance the scale | 規模が大きくなってもコストを抑える | Pay premium storage only when hot(高価な高速ストレージには、よく使う間だけ払う) |
- 高価な GPU が、データを待って遊んでいたらもったいない。そのため、ストレージを「あとで考えるもの」にせず、最初から設計に入れよう、という設計思想です。
AI のライフサイクルに合わせて、ストレージを選ぶ
- AI は、データを集めて、整えて、学習させて、結果を使う、という流れで進みます。段階ごとに、ストレージに求めるものが違います。
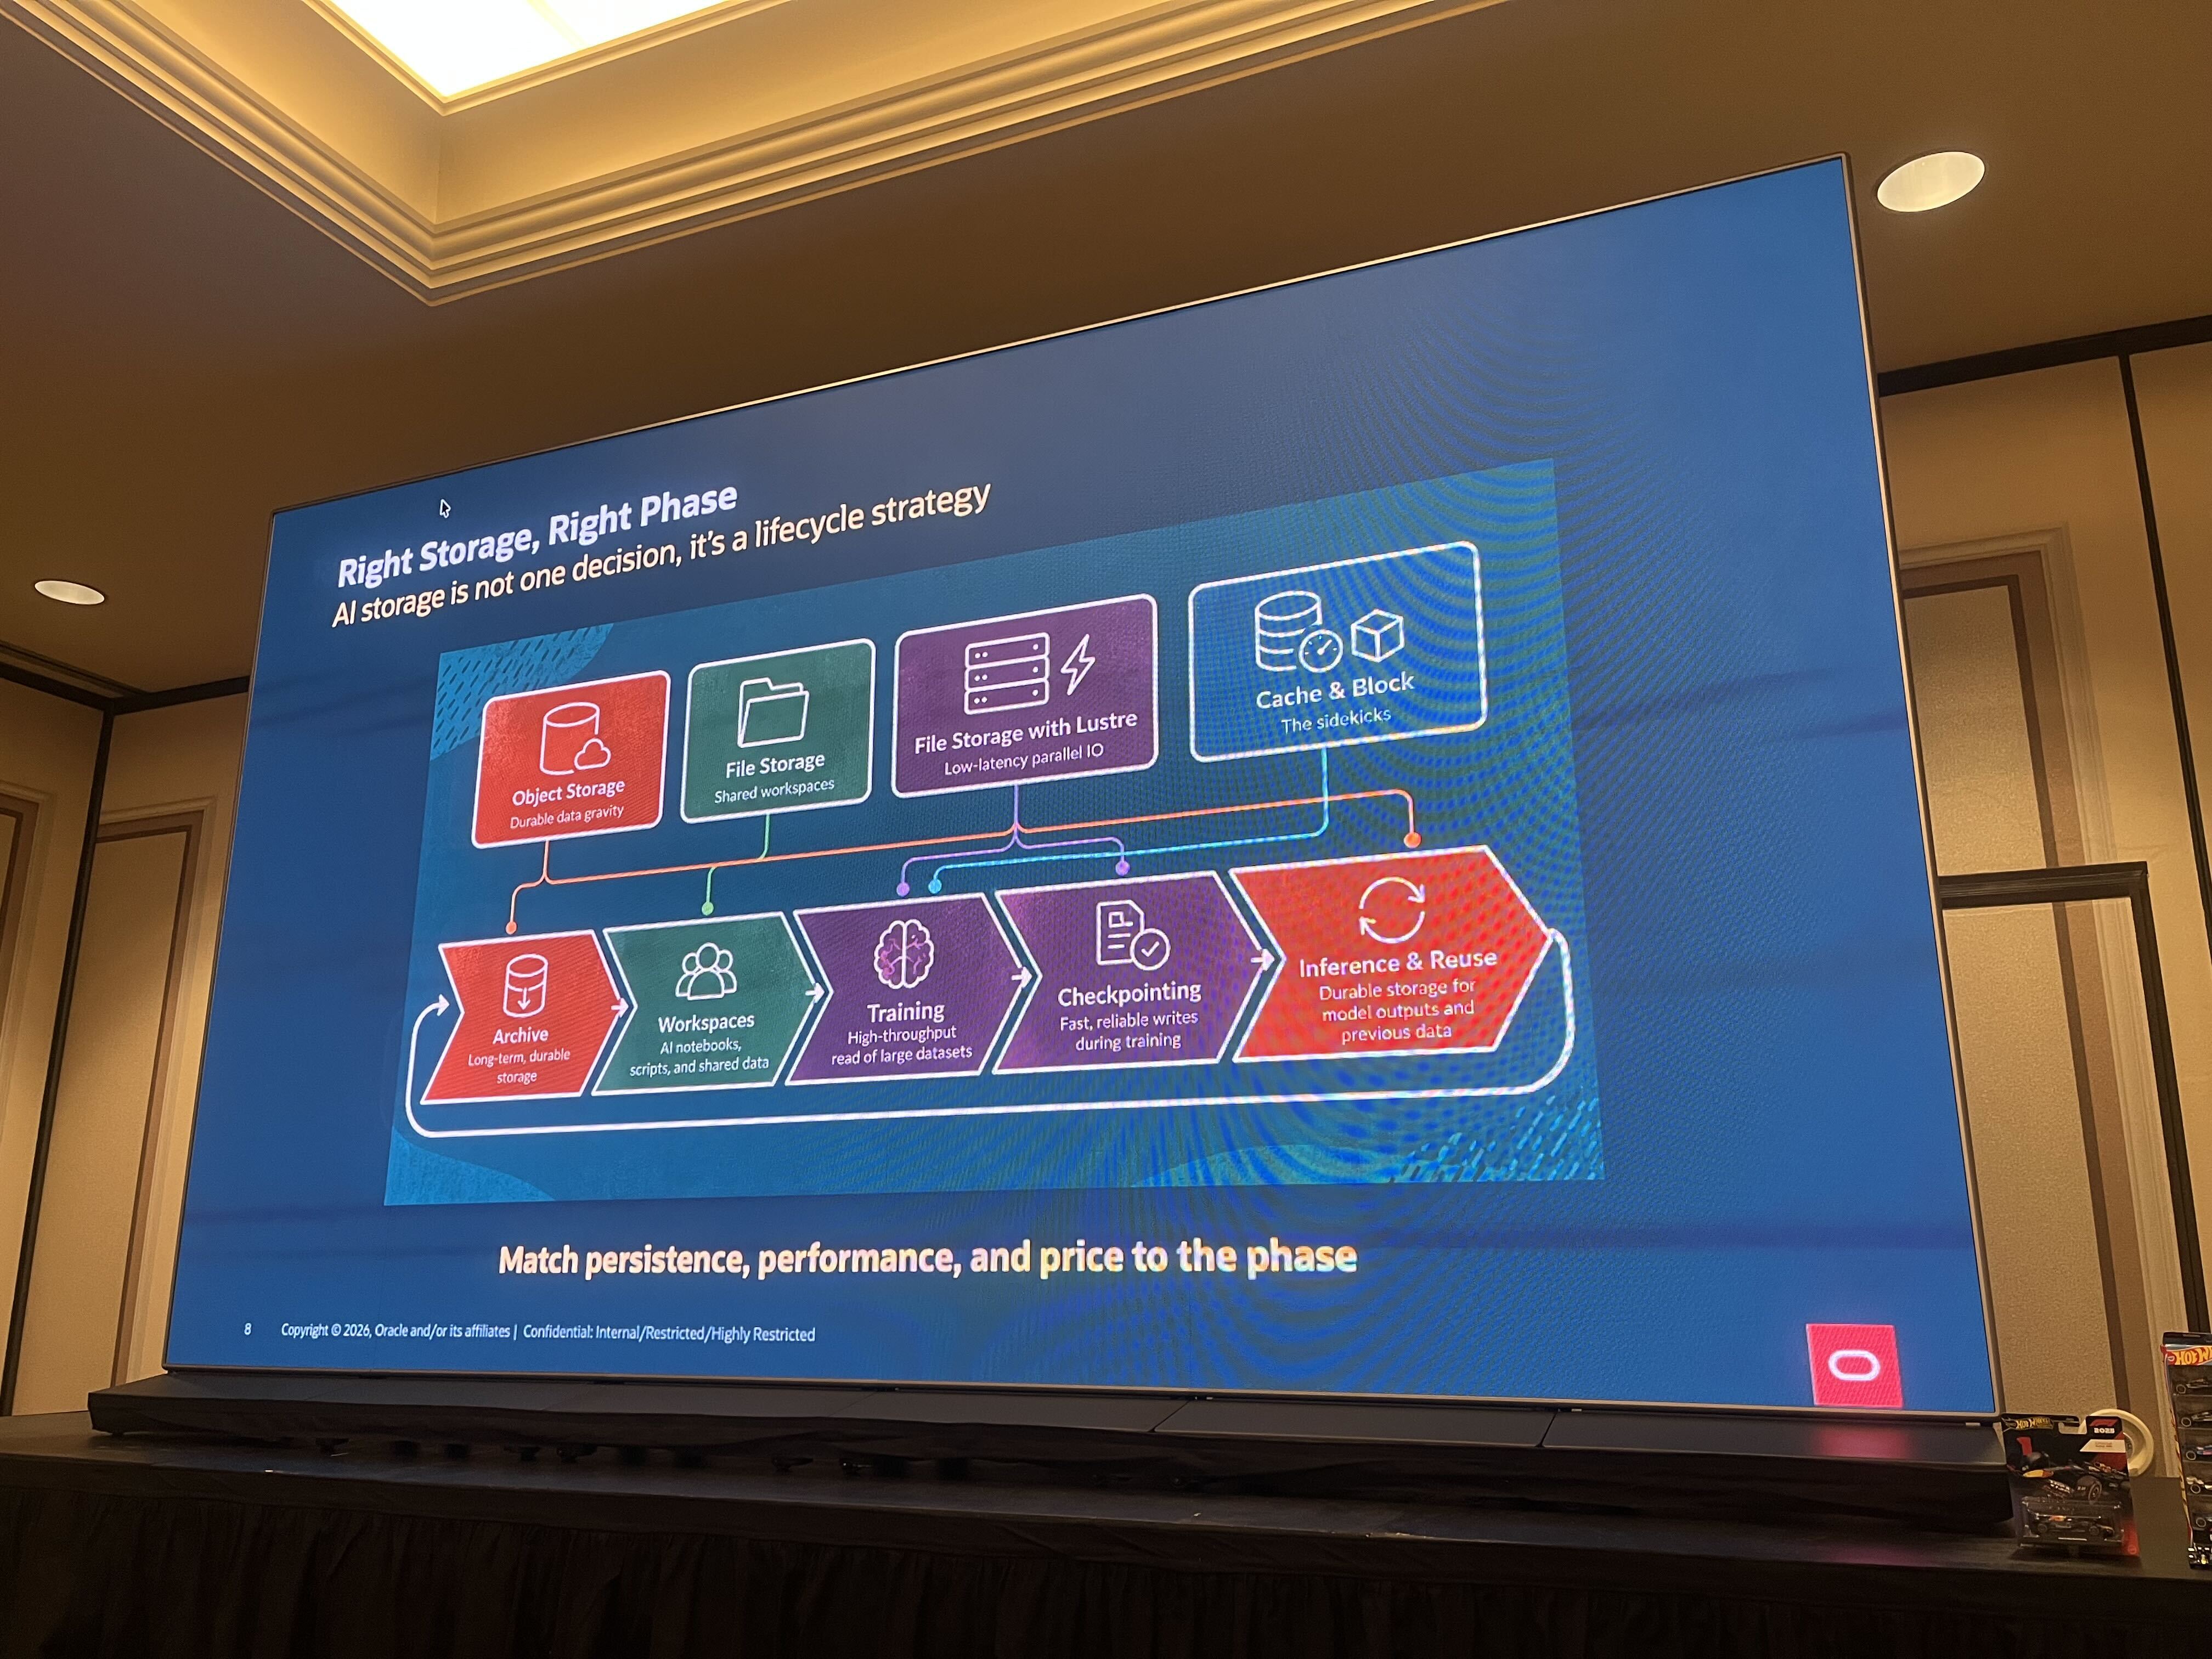
- スライドは、「AI storage is not one decision, it’s a lifecycle strategy(AI のストレージは1回の決定ではなく、ライフサイクル全体の戦略)」と言っています。もう一つのキーワードは、「Match persistence, performance, and price to the phase」です。段階ごとに、耐久性・性能・価格を合わせよう、ということです。
「1つに決める」のは、もったいない
-
よくある失敗として、2つのパターンが紹介されました。
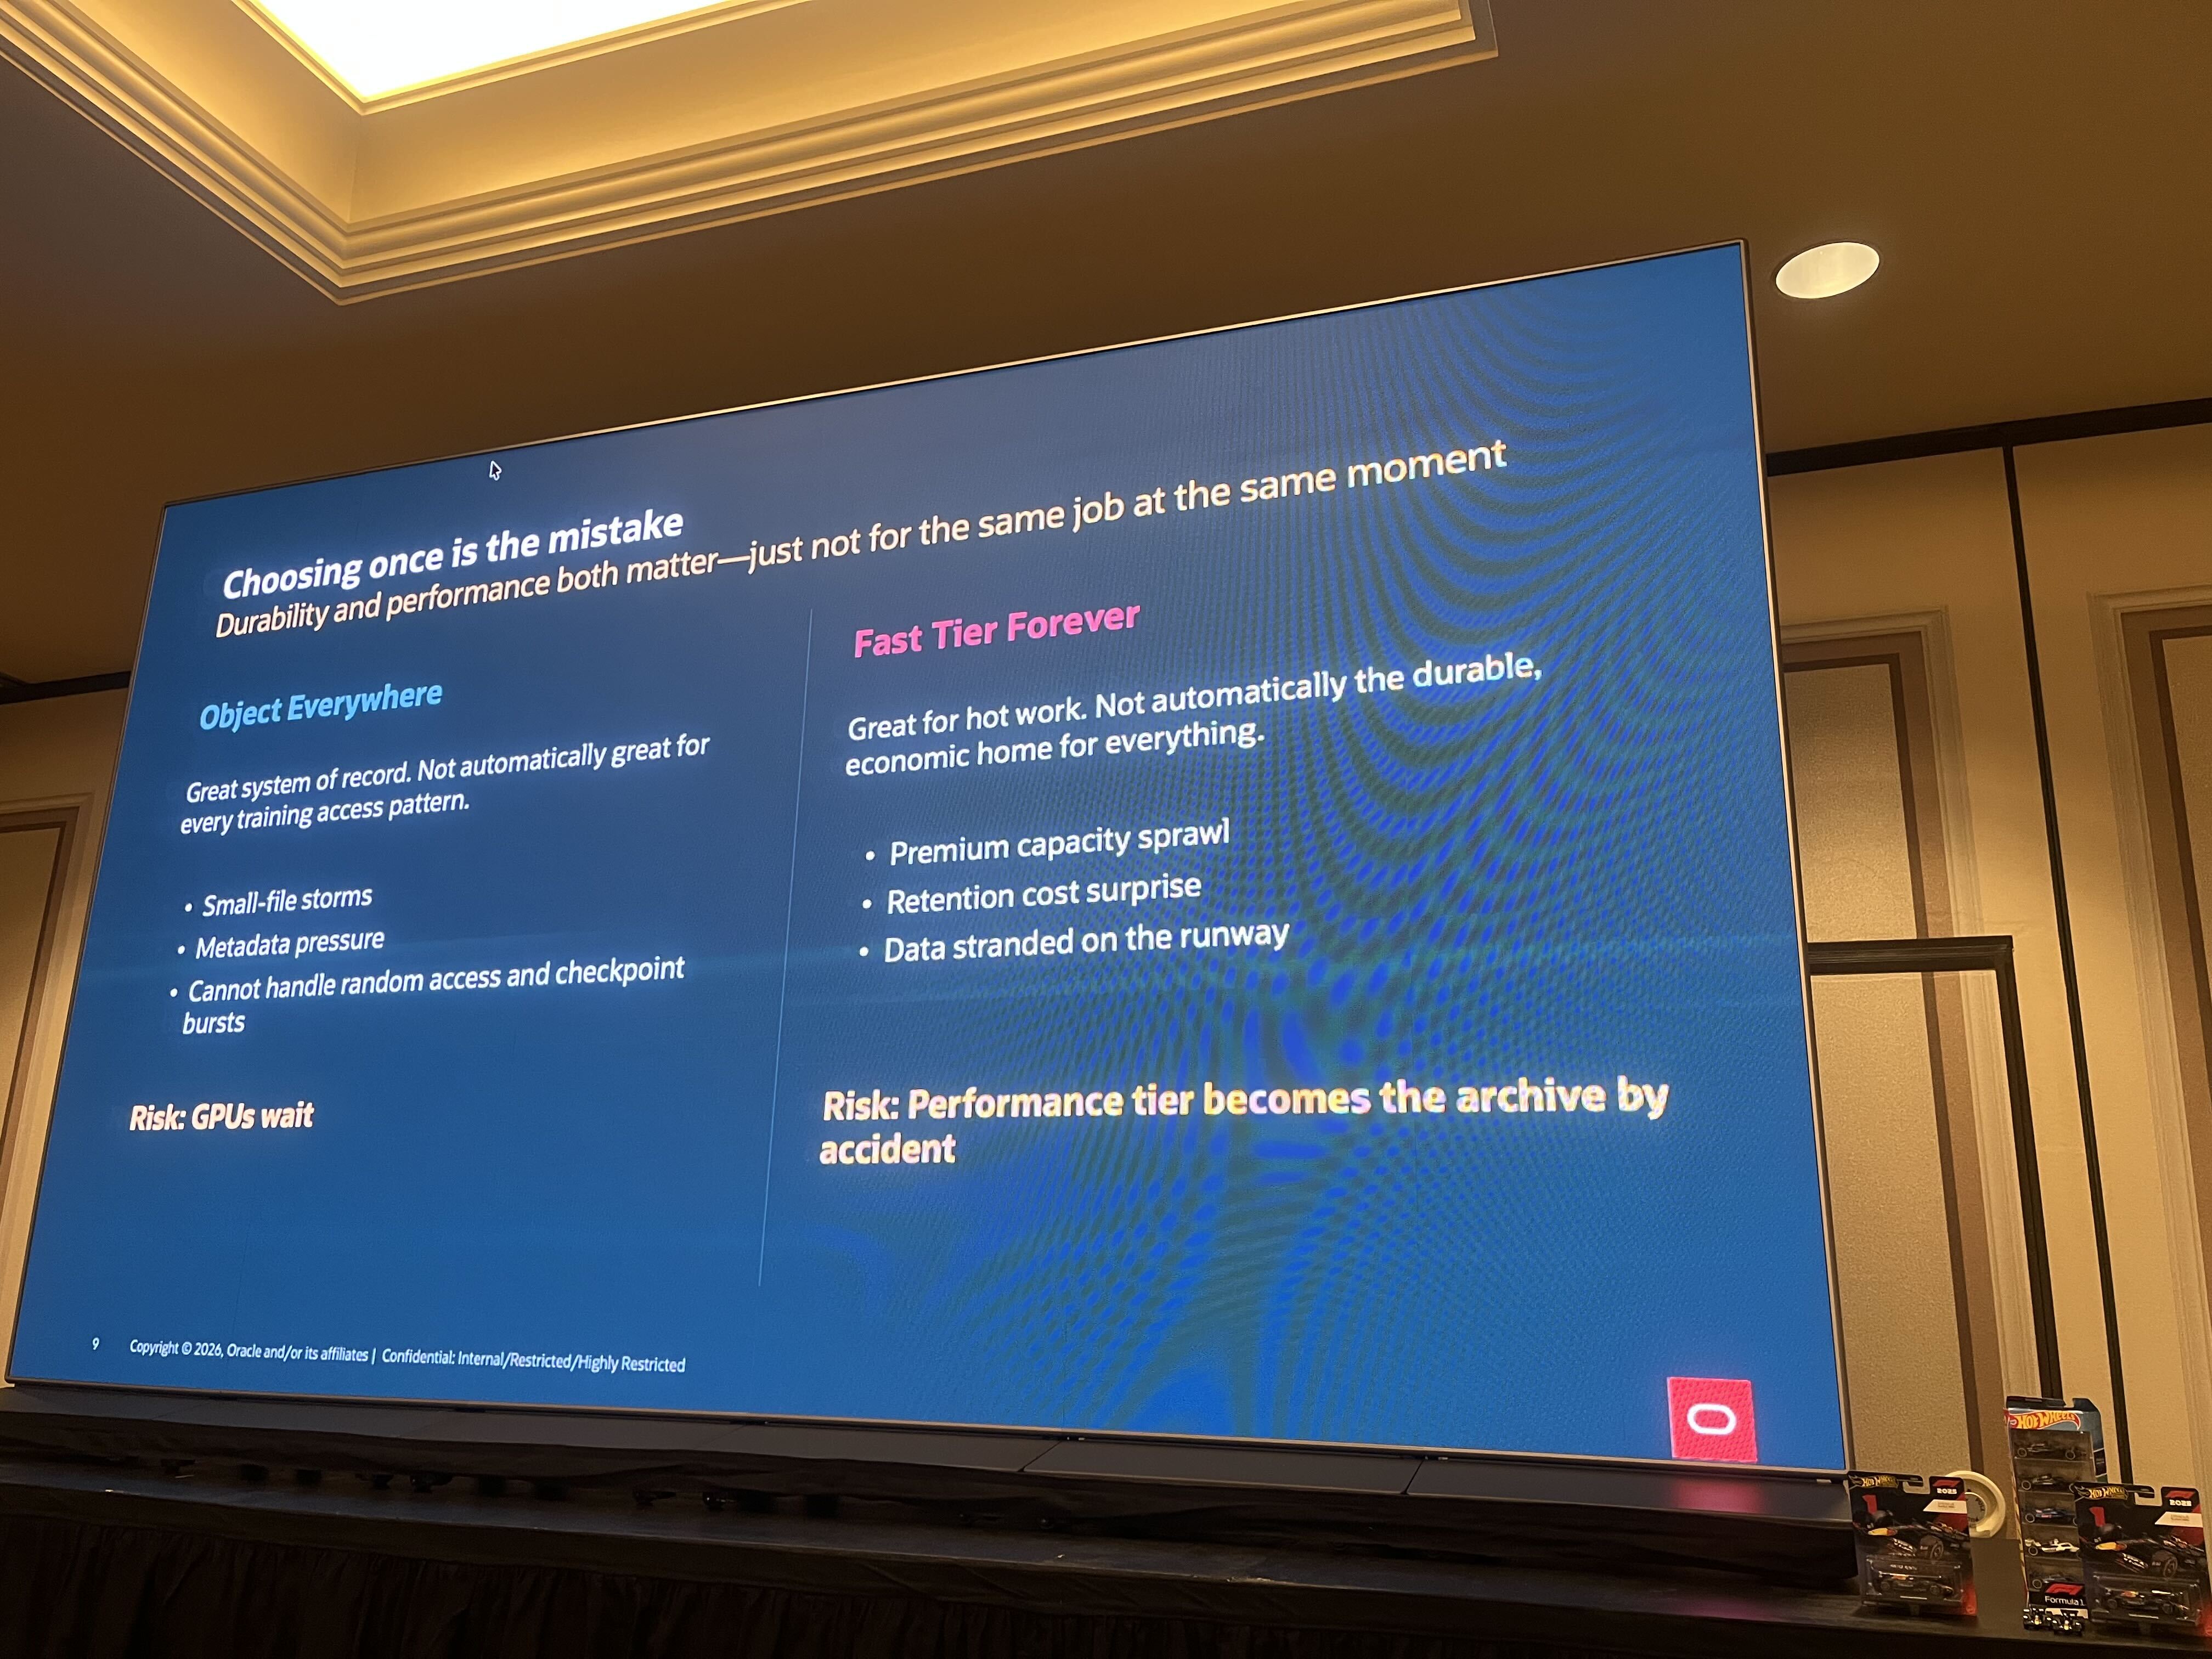
| パターン | 得意なこと | デメリット | リスク |
|---|---|---|---|
| Object Everywhere (何でもオブジェクト) |
大量のデータを安く、確実に保管する | ・小さなファイルが大量にあると処理が重くなる ・管理情報(メタデータ)の処理が集中する ・バラバラに読む(ランダムアクセス)処理や、チェックポイントの一斉書き込みが苦手 |
GPU がデータ待ちになる |
| Fast Tier Forever (ずっと高速ストレージ) |
頻繁に使う作業に向く | ・高価な高速ストレージの容量が増え続ける ・保管し続けた分の請求に驚く |
高速ストレージが、いつの間にか保管庫になってしまう |
- 例えるなら、「倉庫」と「作業台」の違いです。大量の荷物をしまうのは倉庫が得意で、いま使う道具は手元の作業台に置きたい。どちらか一方だけでは、うまくいきません。「耐久性と性能は、どちらも大切。ただし、同じ仕事を同じ瞬間にやらせてはいけない」というスライドの言葉が印象的でした。
OCI のストレージと使い分け
OCI のストレージの顔ぶれ
- では、OCI にはどんなストレージがあるのでしょうか。スライドでは、5つが紹介されました。
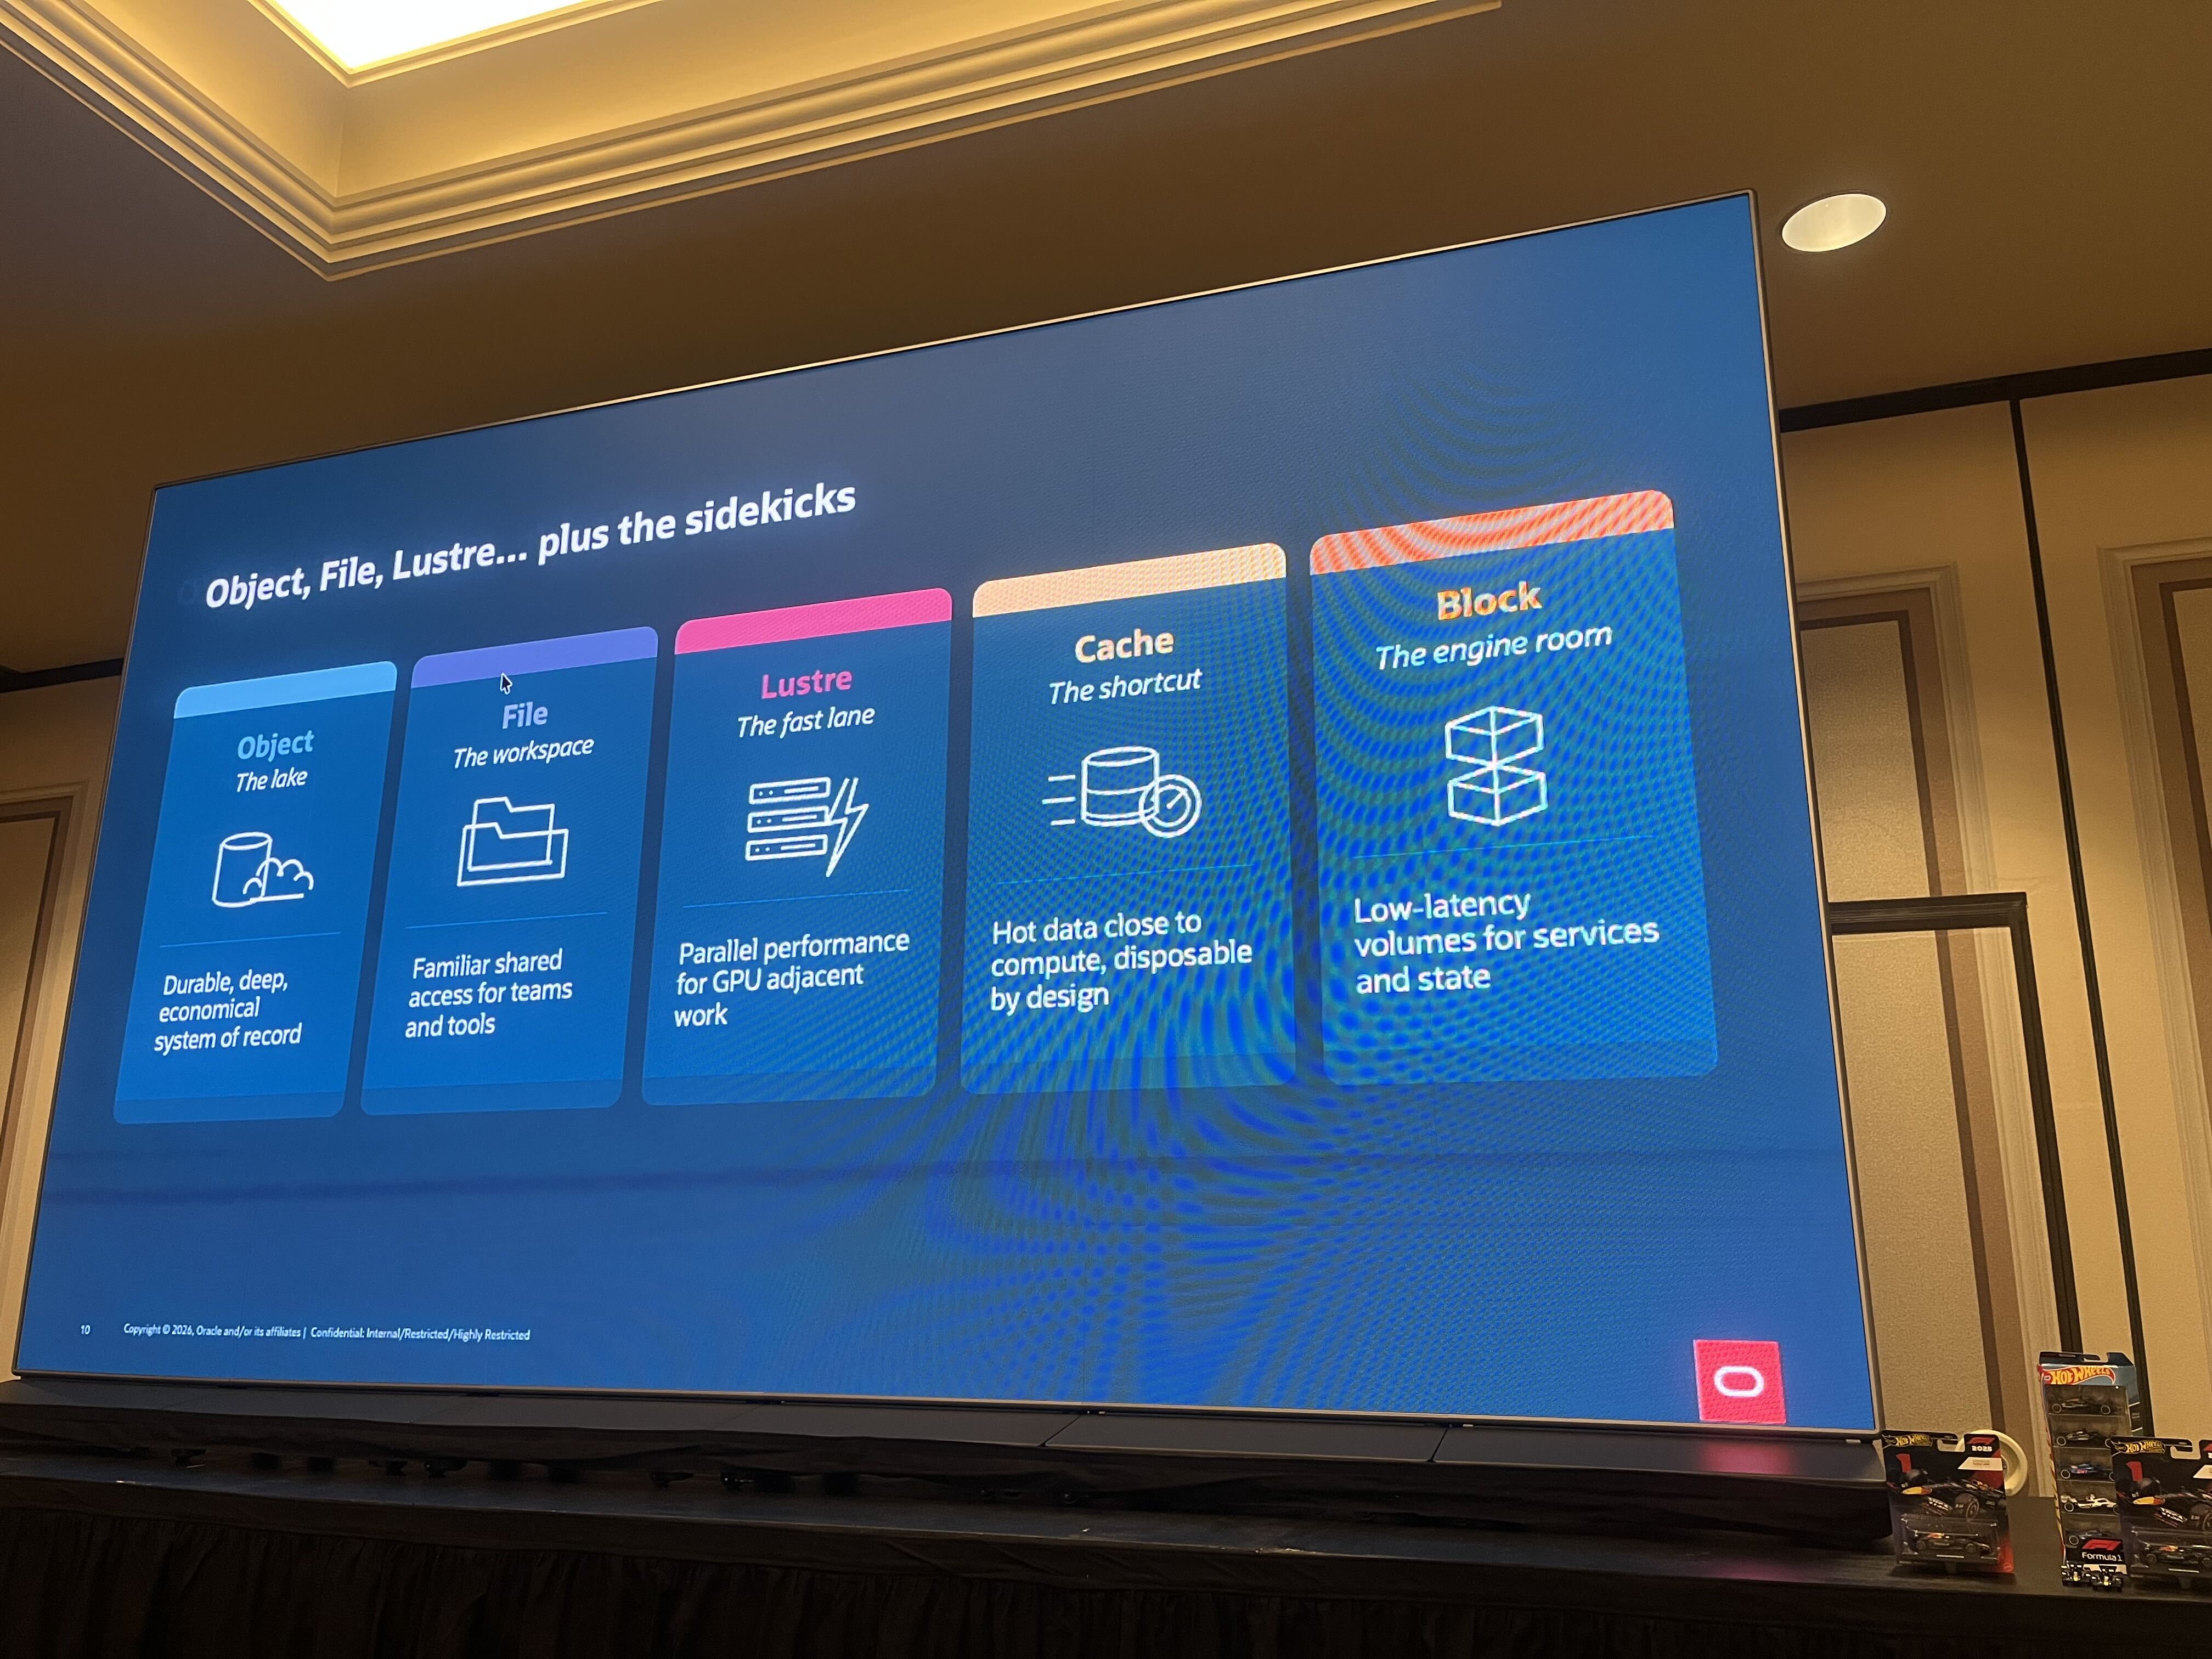
| 種類 | 例え | 役割 |
|---|---|---|
| Object | The lake(湖) | 耐久性が高く、大容量で経済的。データの原本置き場。 |
| File | The workspace(作業場) | チームやツールが共有してアクセスしやすい。 |
| Lustre | The fast lane(追い越し車線) | GPU の近くで、並列に高速処理する。 |
| Cache | The shortcut(近道) | よく使うデータを計算の近くに置く。使い捨てが前提。 |
| Block | The engine room(機関室) | サービスや状態を支える、低遅延のボリューム。 |
- Lustre は、複数のサーバーが同時に読み書きして速くする「並列ファイルシステム」の一種です。
局面ごとの「短い答え」
- では、どの段階でどれを使えばよいのでしょう。
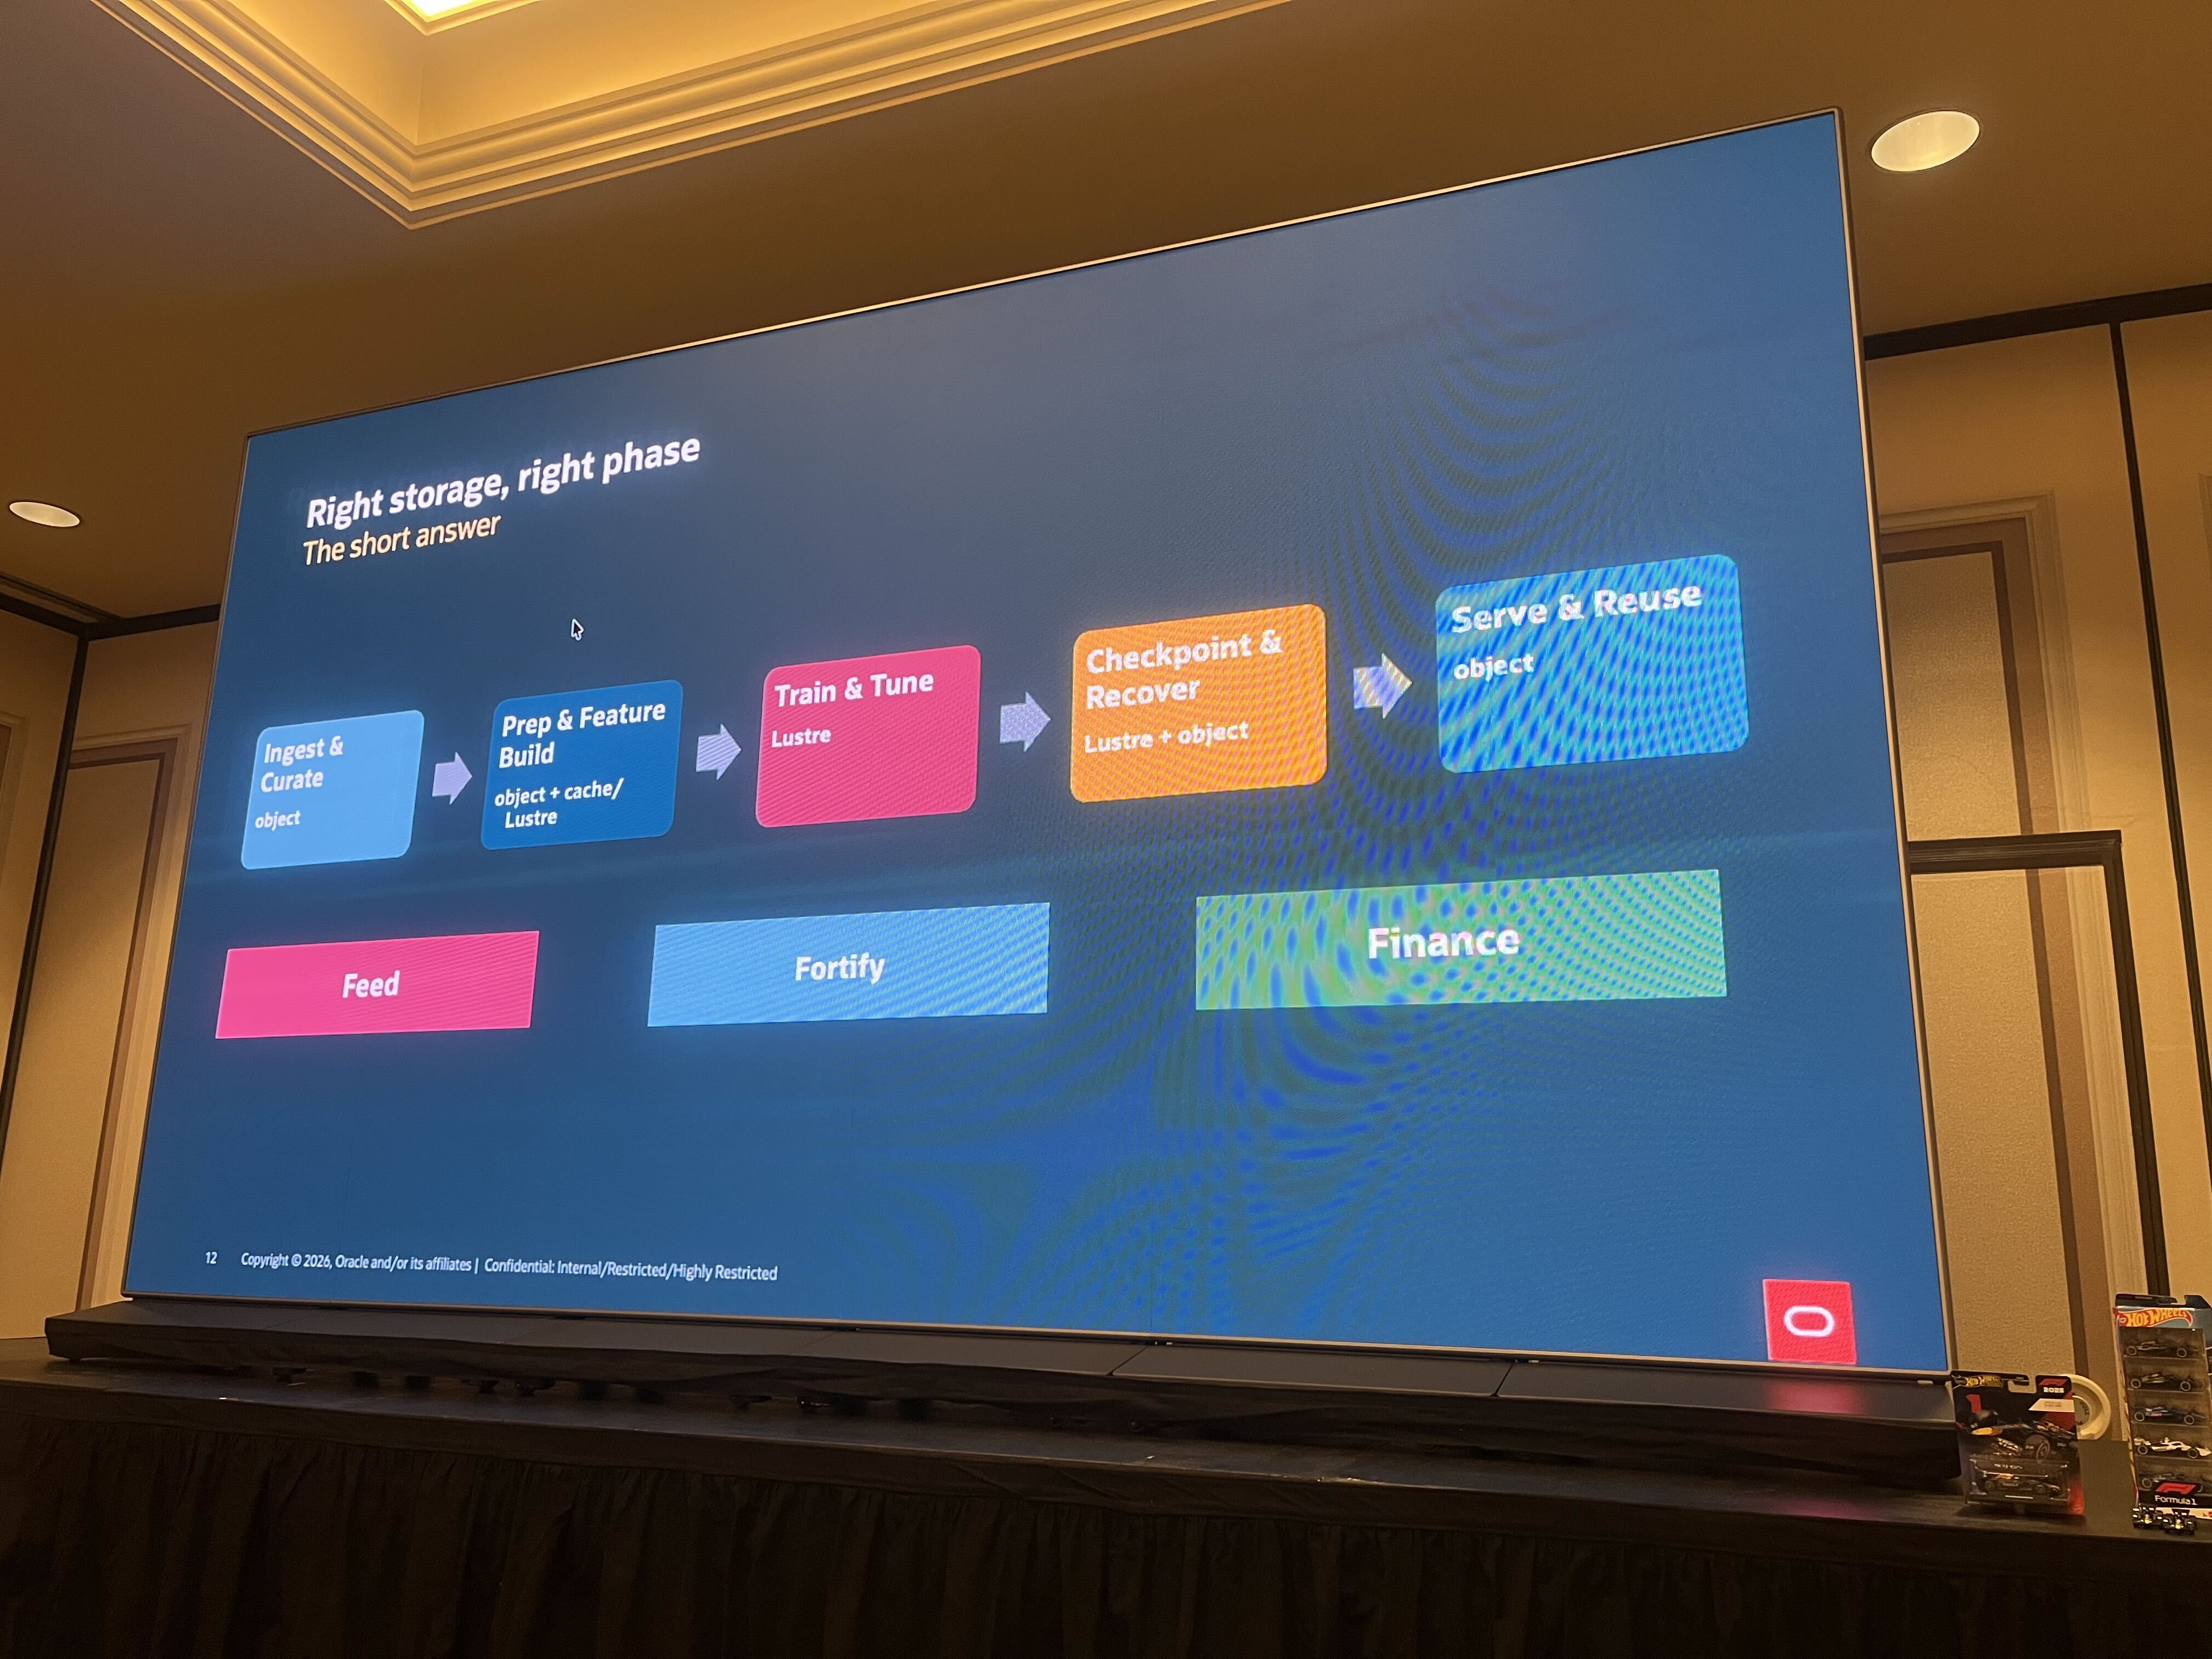
| 段階 | 使うストレージ |
|---|---|
| Ingest & Curate(集めて選ぶ) | Object |
| Prep & Feature Build(前処理) | Object + Cache / Lustre |
| Train & Tune(学習・調整) | Lustre |
| Checkpoint & Recover(保存と復旧) | Lustre + Object |
| Serve & Reuse(提供と再利用) | Object |
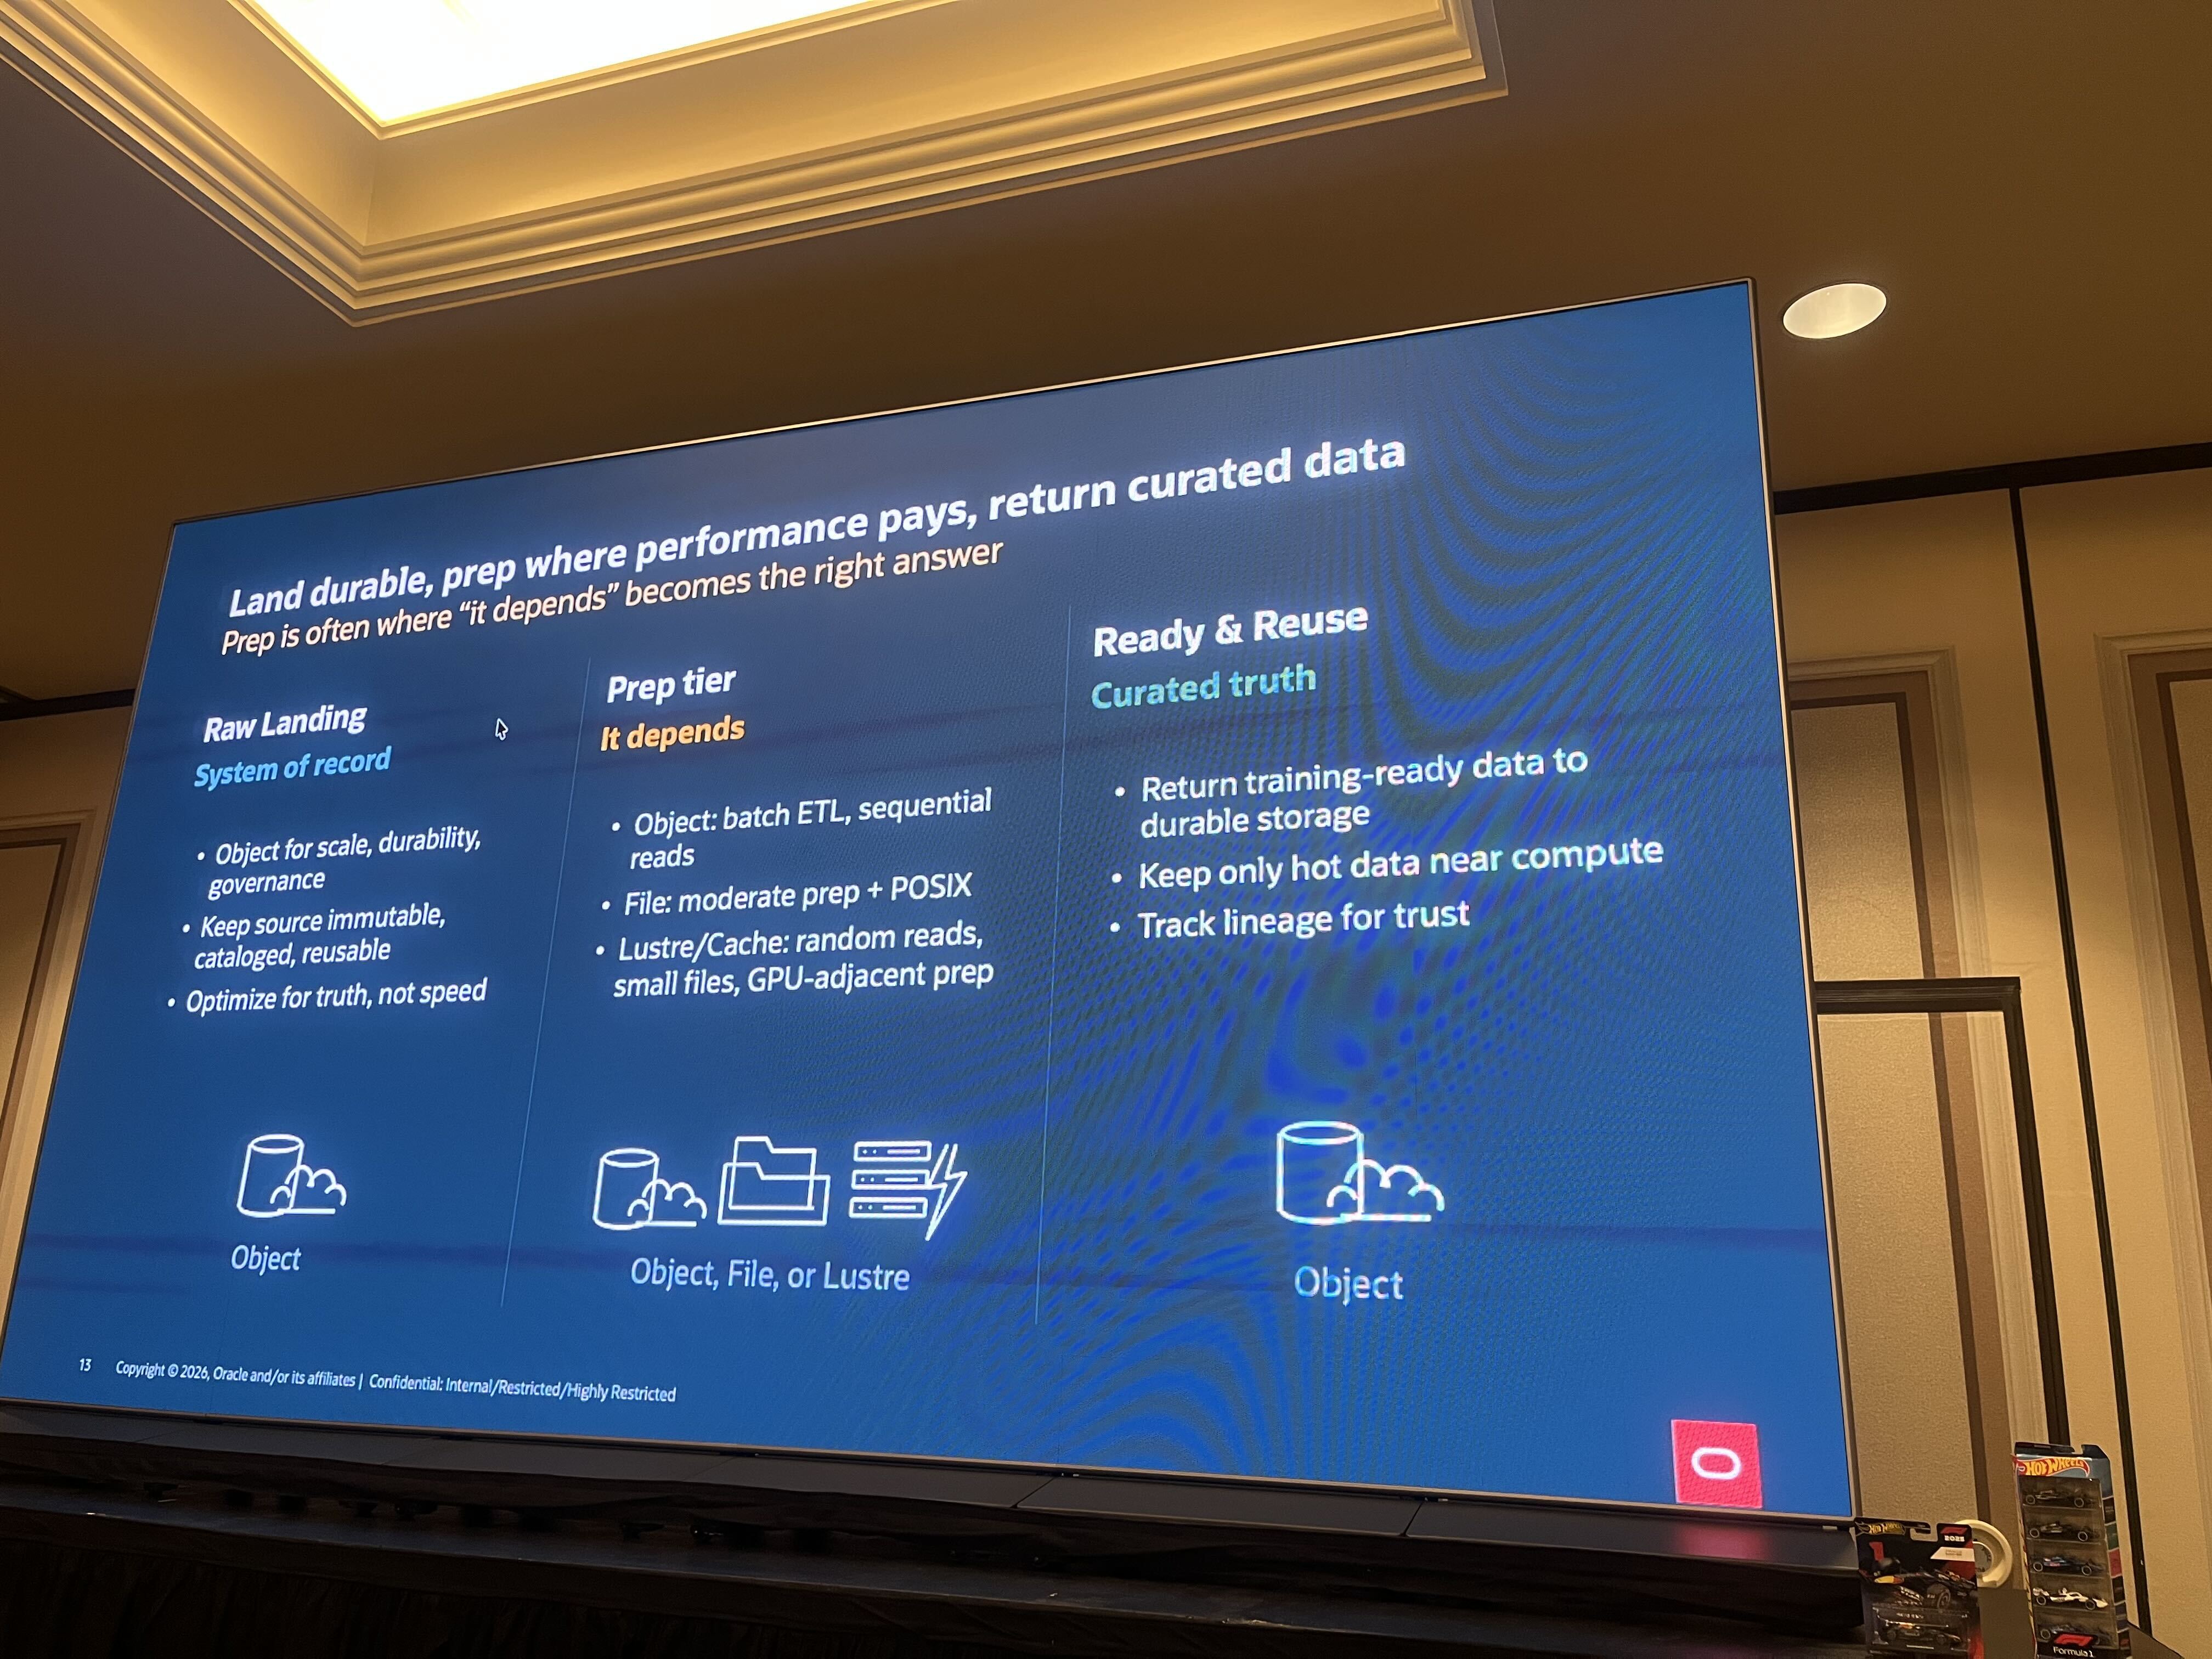
- 上の表で、前処理だけ使うストレージが複数並んでいるのは、データの扱い方によって、向くものが変わるためです。スライドでは「It depends(場合による)」と書かれていました。ここで、前処理の段階を補足します。データは、「生データの着地点」→「前処理」→「整ったデータ」の順に進みます。
- Raw Landing(生データの着地点): Object ストレージを使います。規模、耐久性、管理・統制(ガバナンス)のために使います。元データは変更せず、カタログ化して再利用できるようにします。「速さより、データの正確さと信頼性を優先」とあります。
- Prep tier(前処理): ストレージは処理の内容によって変わります。データを取り出して加工する処理(ETL)のように順番に読む処理は Object、ほどほどの前処理で普通のファイル操作(POSIX)が必要なら File、バラバラに読む処理や小さなファイルが多いなら Lustre / Cache です。
- Ready & Reuse(整ったデータ): Object ストレージに戻します。よく使うデータだけを計算の近くに置き、データの出どころ(リネージ)も追えるようにします。
学習中は、どう GPU に食べさせるか(Feed the GPUs)
- 学習中は、まさに「Feed the GPUs」の場面です。3つのパターンが紹介されました。
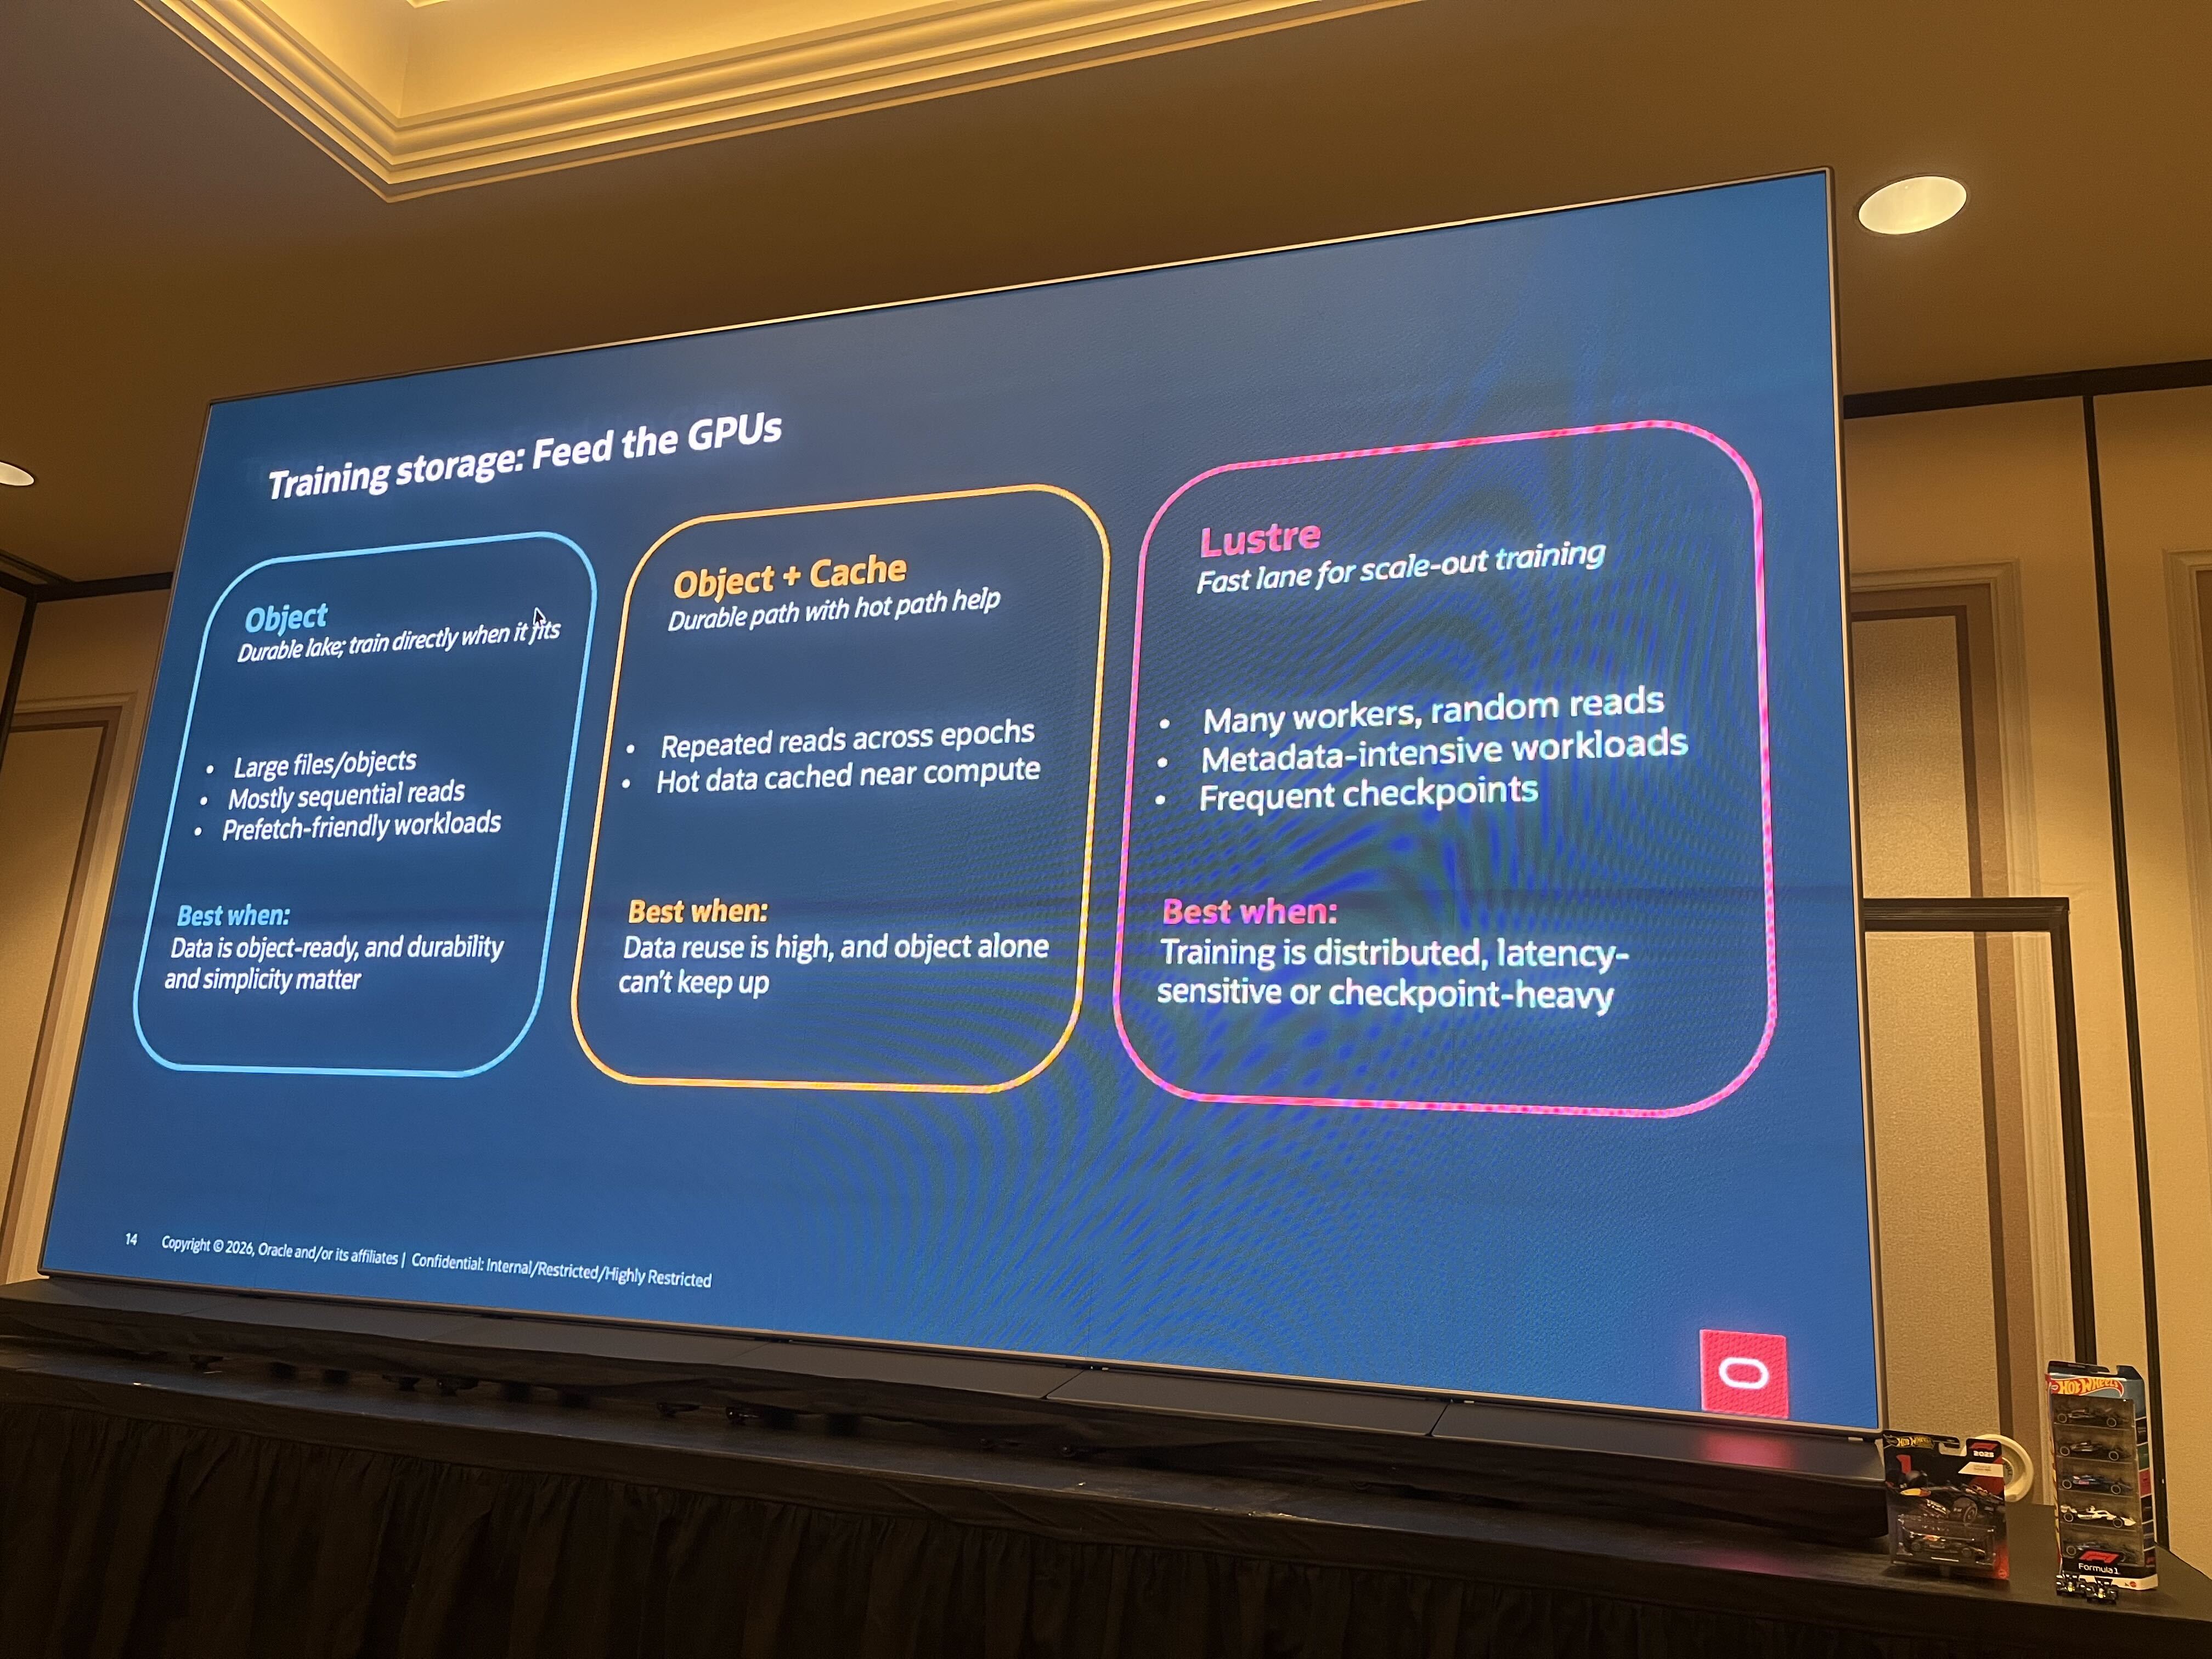
| パターン | 向いているケース |
|---|---|
| Object | データがオブジェクトで扱いやすい形になっていて、耐久性(データを失いにくいこと)とシンプルさを重視したいとき。大きなファイルを順番に読む処理に向く。 |
| Object + Cache | 同じデータを、学習のたび(エポックごと)に繰り返し読むとき。オブジェクトだけでは速度が追いつかない場合。 |
| Lustre | 多数のワーカーがバラバラに読む、管理情報(メタデータ)の処理が多い、チェックポイントが頻繁、といった分散学習や低遅延を重視するとき。 |
- ざっくり言えば、「シンプルに始めて、足りなければ足す」です。まず Object で試し、遅ければ Cache を足し、大規模な分散学習なら Lustre を使います。
チェックポイントは、学習の「セーブ」(Fortify the work)
-
さて、冒頭のクイズの答えは、B) 直近のチェックポイントです。チェックポイントとは、学習の途中経過を保存しておくことです。ゲームのセーブポイントのようなものです。
- スライドの見出しは、「Save the run. Skip the rewind.(学習を守る。巻き戻しは不要に)」。ポイントは、次の3つです。
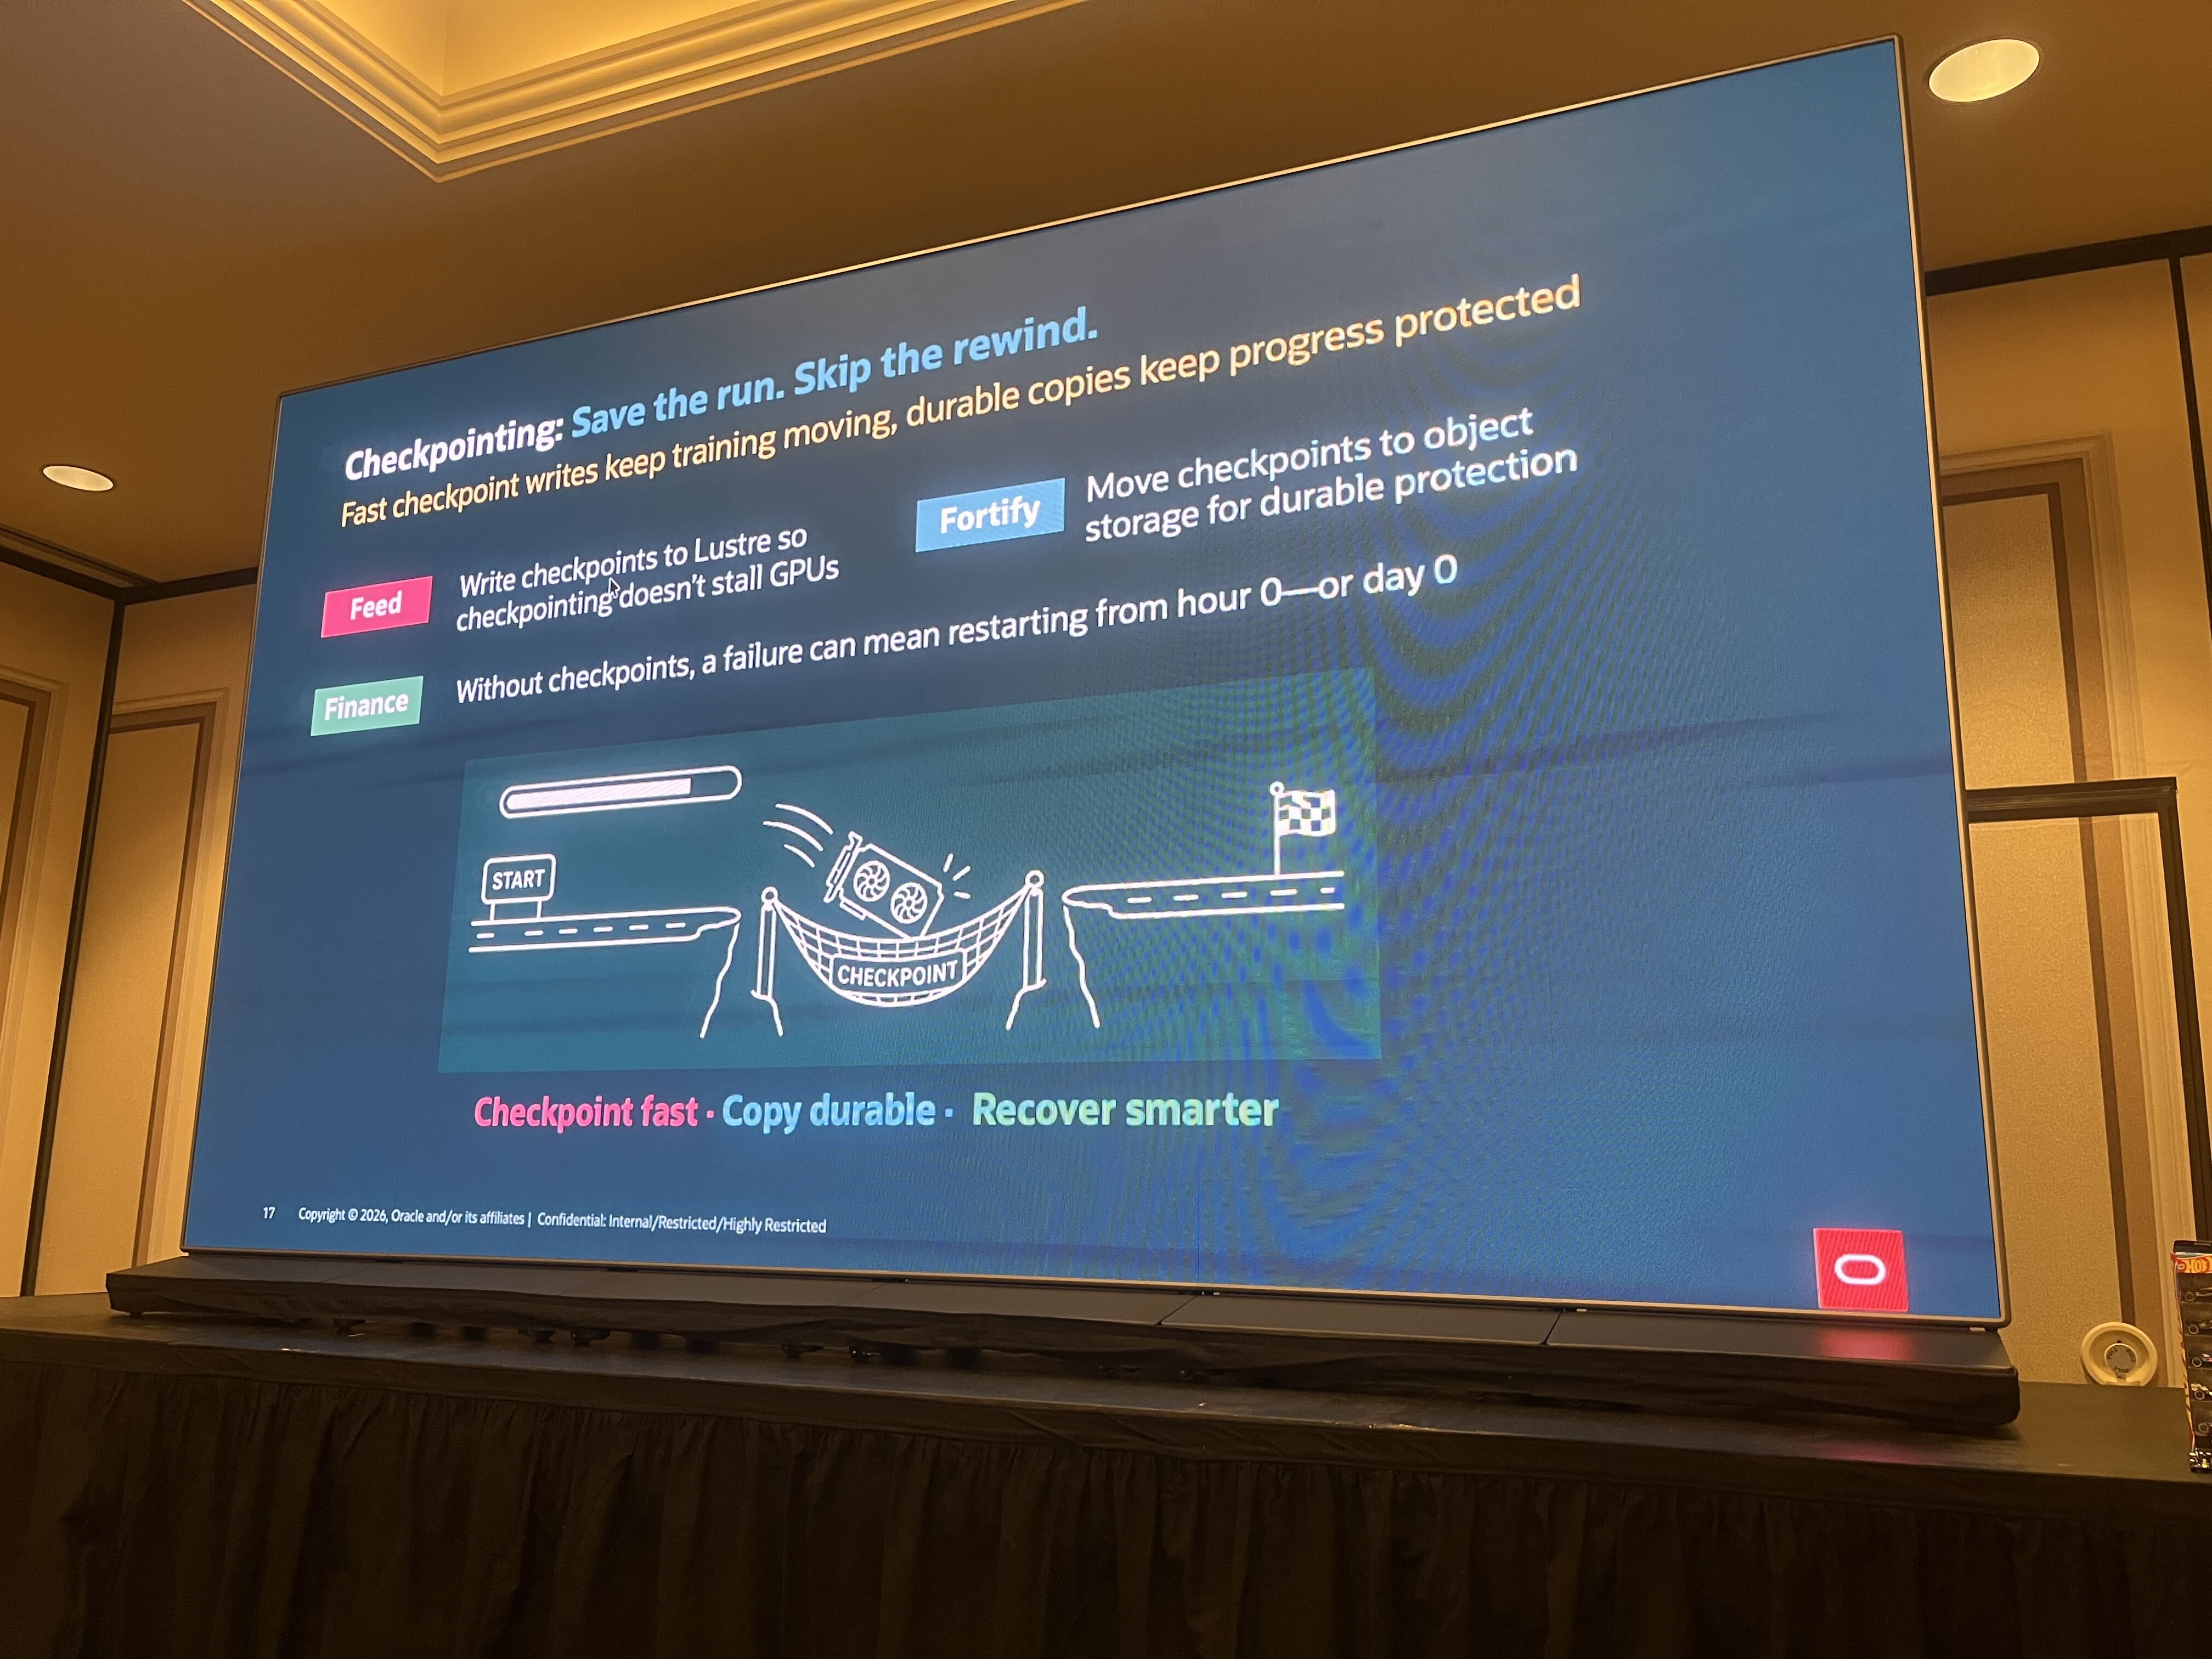
| 柱 | ポイント |
|---|---|
| Feed | チェックポイントを Lustre に書く。GPU を止めずに済む。 |
| Fortify | チェックポイントを Object に移して、確実に守る。 |
| Finance | チェックポイントがないと、障害時にx時間目(x日目)からやり直すことになる。 |
-
キャッチフレーズは、「Checkpoint fast・Copy durable・Recover smarter」。速く書いて、確実な場所にコピーして、賢く復旧する、ということです。3日間回した学習が止まっても、直近のチェックポイントがあれば、そこから再開できます。GPU を増やしても、ストレージを大きくしても、助けにはなりません。
よく使うデータは近くに、使わなくなったら外へ(Finance the scale)
- 最後の柱は、コストです。
-
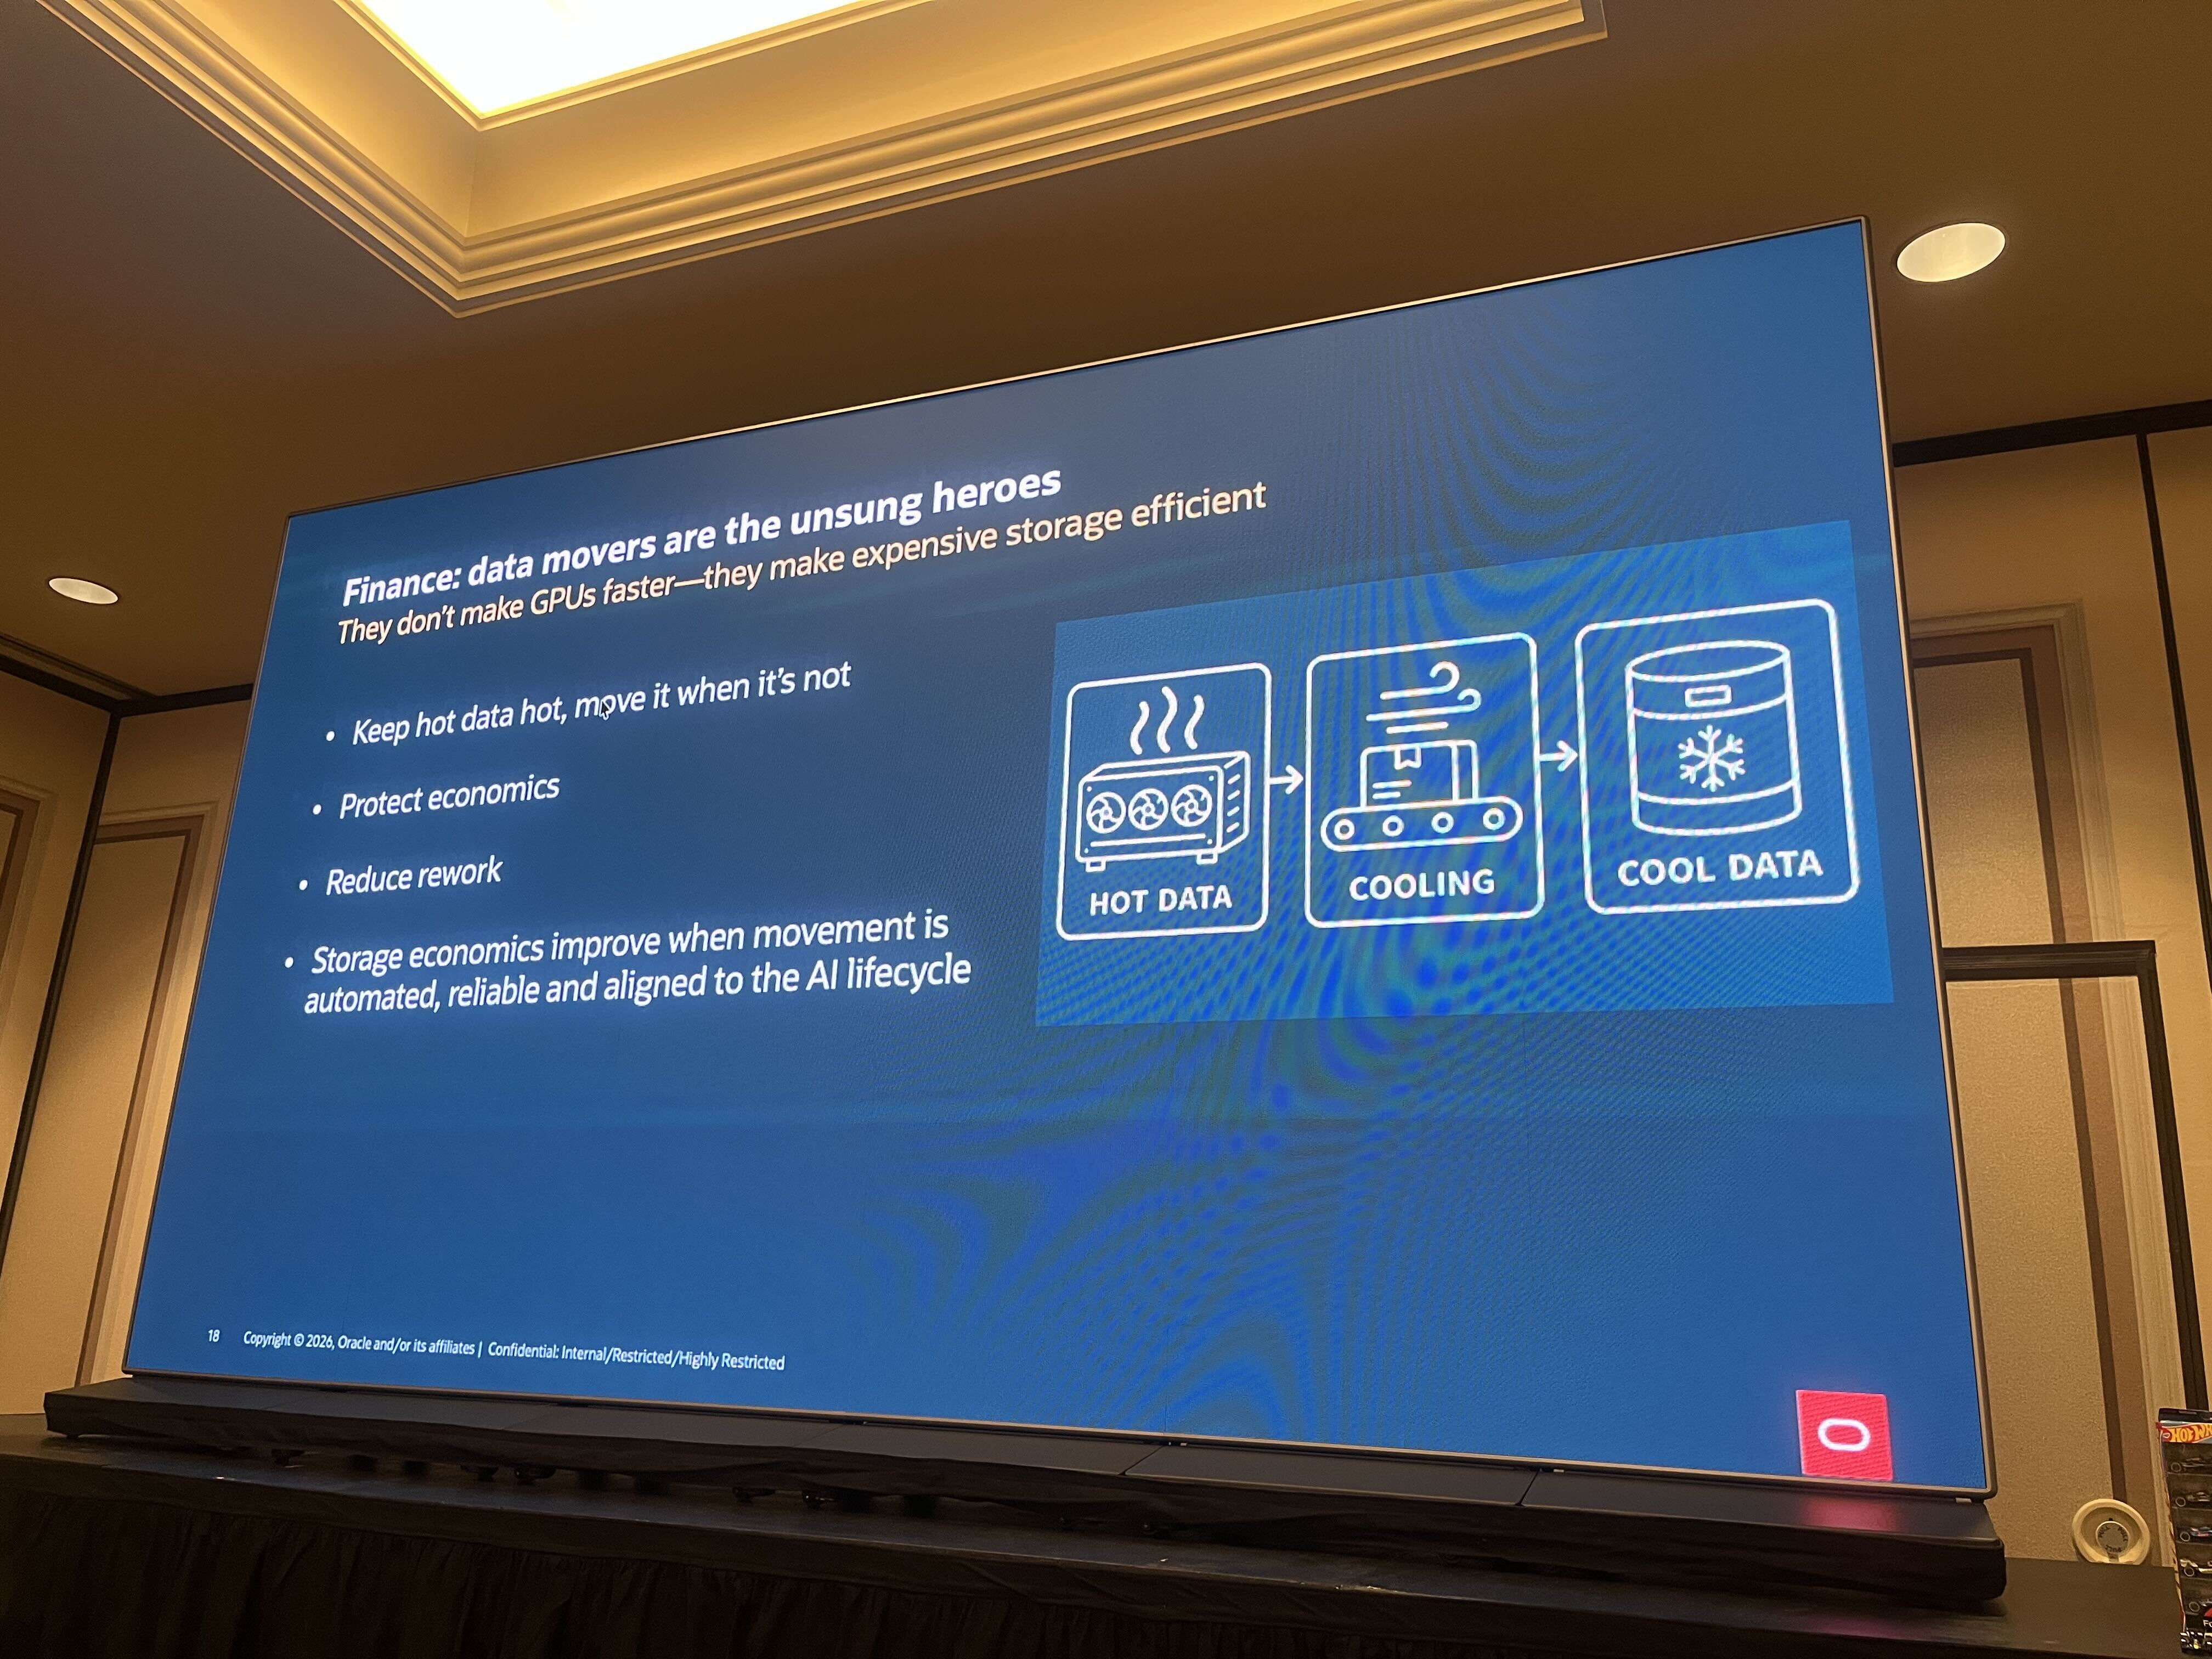
スライドの題は、「data movers are the unsung heroes(データ移動は縁の下の力持ち)」です。「They don’t make GPUs faster – they make expensive storage efficient(GPU を速くはしないが、高価なストレージを効率的にする)」とあります。
-
「よく使うデータ(Hot)」は高速ストレージに置き、使われなくなったら「あまり使わないデータ(Cool)」として、安価なストレージへ動かします。そして、この移動を自動化して、信頼できて、AI のライフサイクルに合わせることでストレージの費用対効果が高まる、という説明でした。
まとめ
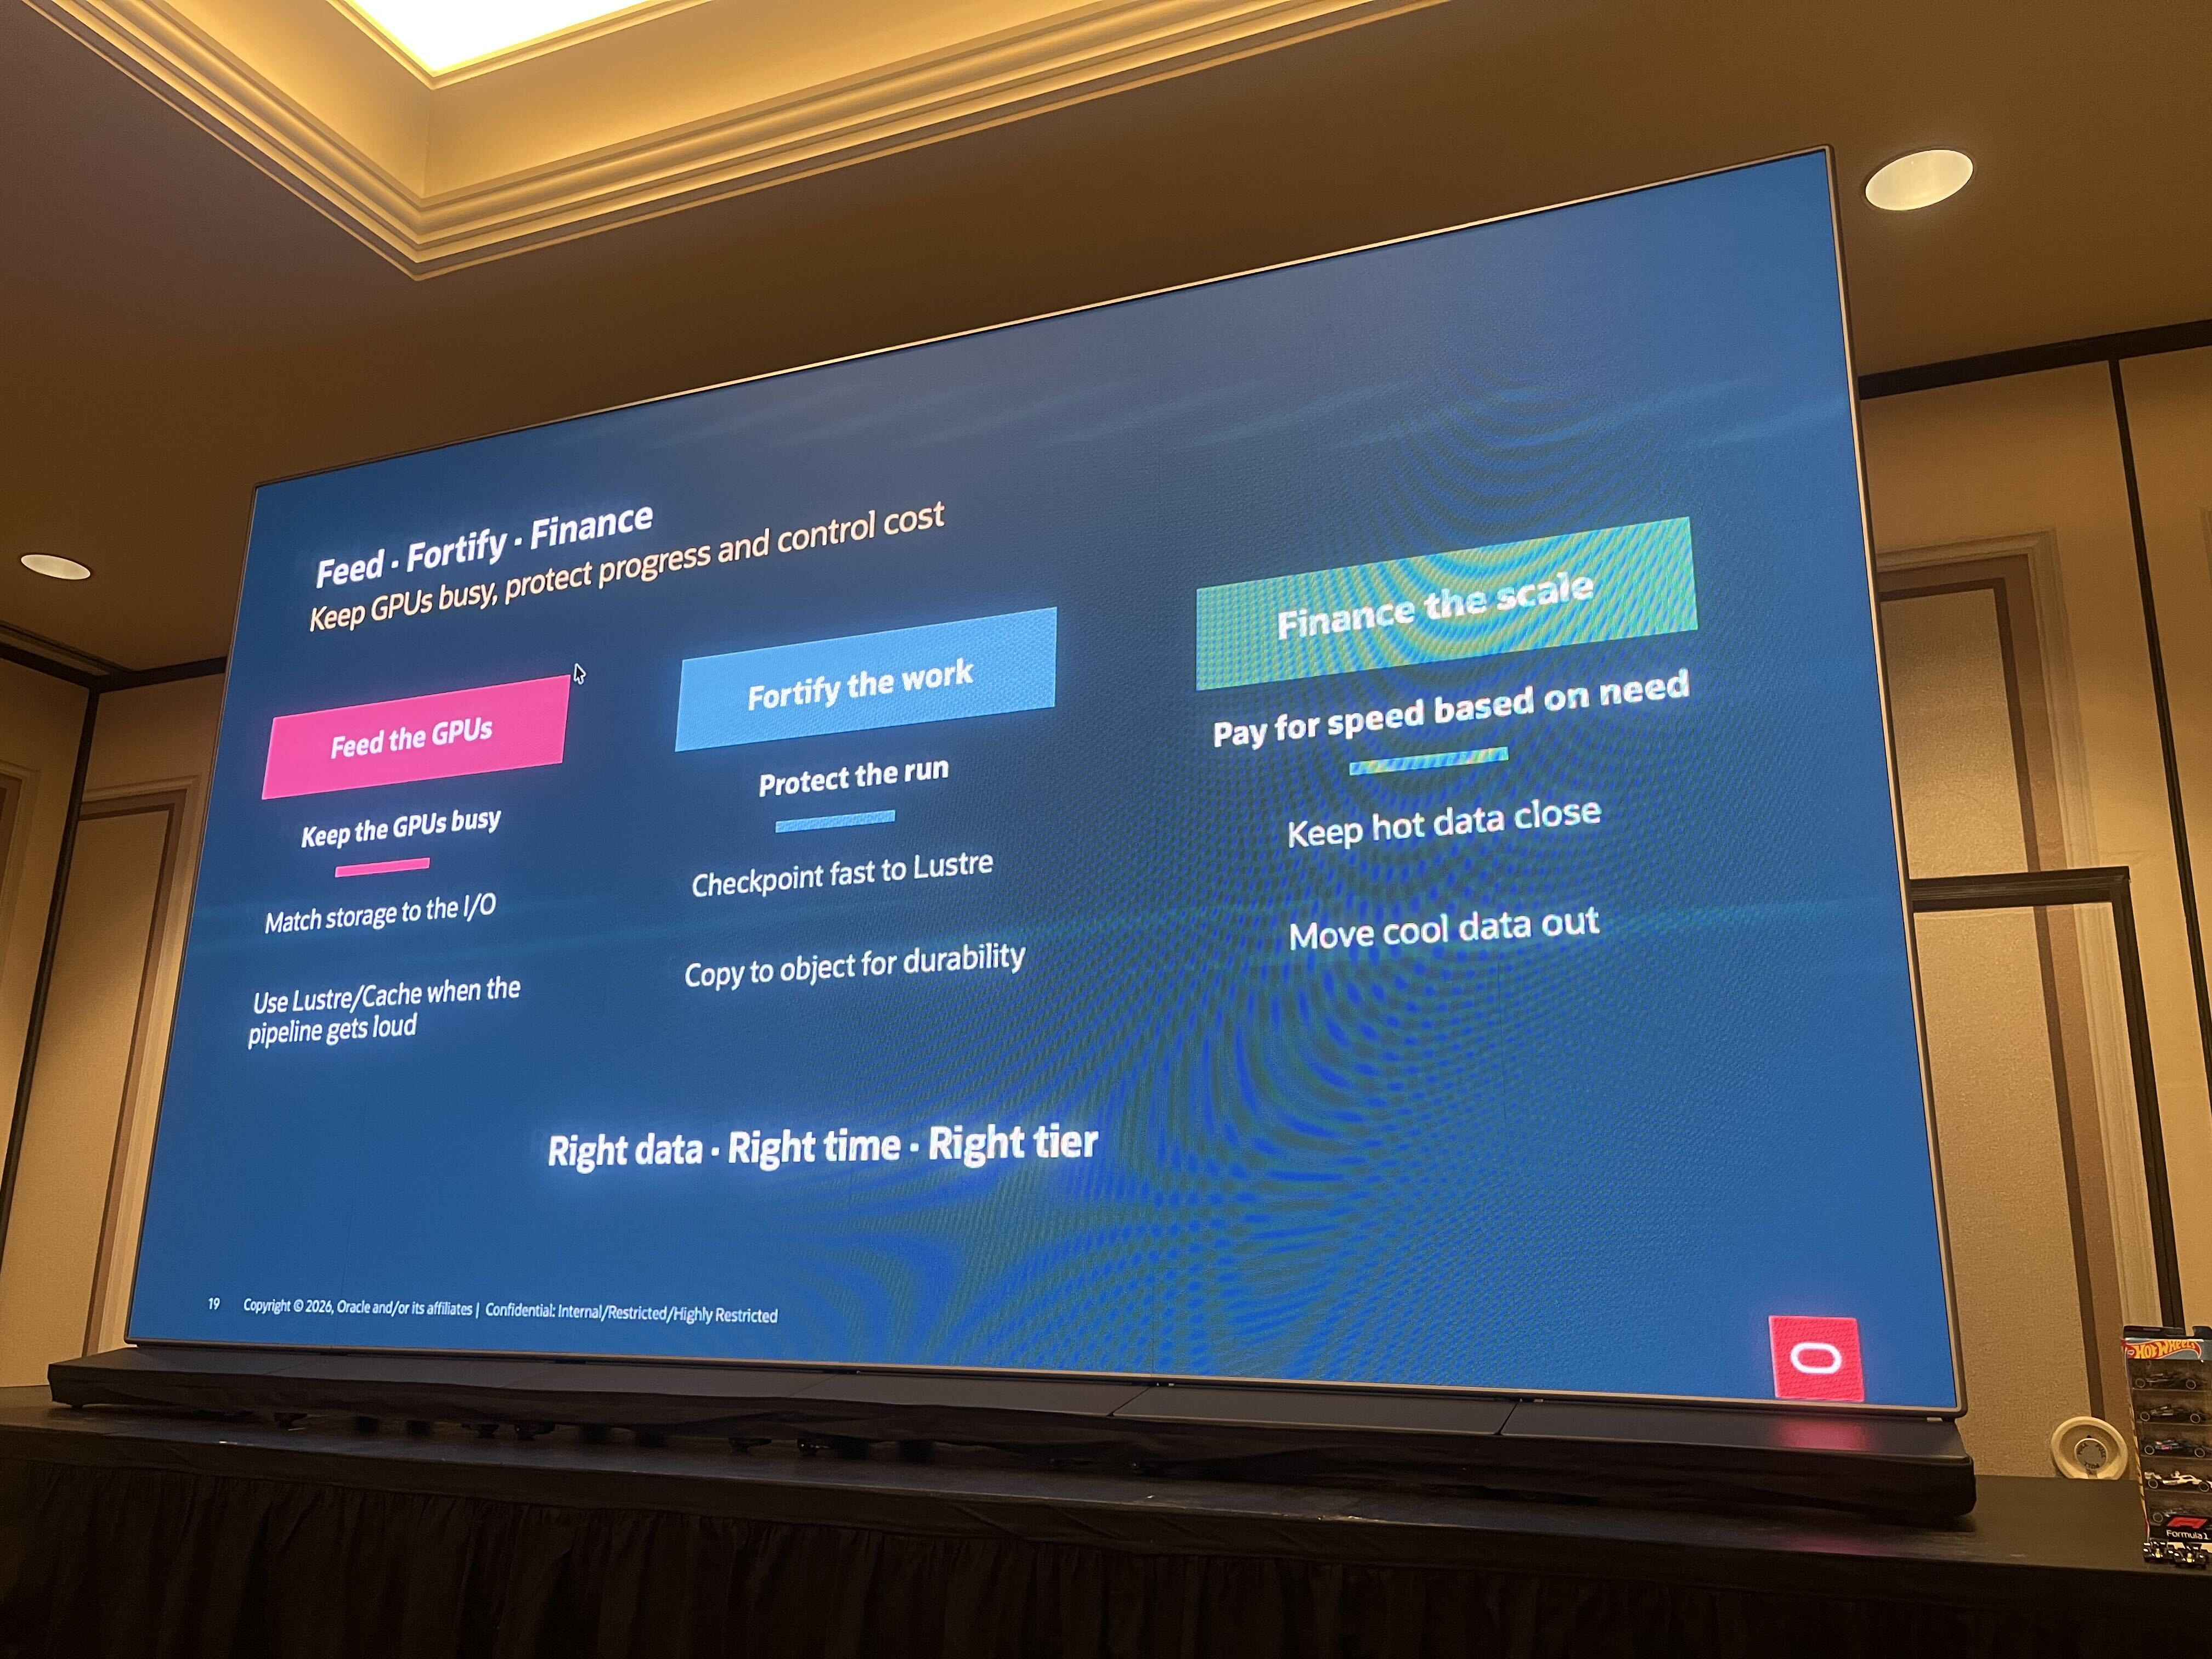
- スライドのキャッチフレーズは、「Right data・Right time・Right tier」。適切なデータを、適切なタイミングで、適切なストレージ(層)に置く、ということです。
| 柱 | ねらい | ポイント |
|---|---|---|
| Feed the GPUs | GPU を忙しく保つ | ストレージを I/O(データの読み書き)に合わせる。必要なときは Lustre / Cache を使う |
| Fortify the work | 成果を守る | Lustre にチェックポイントを速く書き、Object にコピーする |
| Finance the scale | 必要な分だけ払う | よく使うデータは近くに置き、使わなくなったデータは外へ動かす |
おわりに
-
今回のセッションで学んだことを3点にまとめます。
-
ストレージを、最初から設計に入れる。段階ごとに主役の Object・File・Lustre を選び、GPU を待たせない。
-
チェックポイントを速く書き、確実な場所にコピーして、学習の成果を守る。
-
よく使うデータは近くに置き、使わなくなったデータは外へ動かして、コストを抑える。
-
-
オンプレミスを使っていた頃は、データを置くストレージ(キャッシュ、ディスク、テープなど)を、利用者自身が選び、必要に応じて配置し直す必要がありました。クラウドになってからは、そうした管理を意識しなくても、自動的に行われるようになりました。そして AI では、データがどこに格納されているのかが、さらに見えにくくなったと感じます。
-
今回のセッションは、便利に AI を使っている私たちが、普段は意識していないストレージの役割を分かりやすい例えで説明してくれました。とても勉強になりました。
-
AI を使うだけの利用者であれば、ストレージの違いや、段階ごとの使い分けは意識しなくても困りません。しかし、AI を使ったシステムを開発する私たちエンジニアは、その特性を理解して、パフォーマンスとコストを最適にしていきたいところです。多くのエンジニアの方に、この記事を読んでいただき、AI 開発に差をつけていただけるとうれしいです。
 簡単30秒