


TL;DR
- Oracle は 2026年10月26日、Oracle GoldenGate Data Fabric を発表した。セッションでも今週の主要な発表として紹介された。
- 基幹システムでコミットされた変更を、リアルタイムのデータを必要とする AI エージェントに、できるだけ簡単に渡すことに新しく力を入れている。移行・高可用性・分析への取り込みなど、これまで別々に組んでいた GoldenGate の用途も、AI 支援付きの1つの UI でパイプラインとして作れるようになる。変換の処理は保存先や実行エンジンを選んで下流で動かせる。
- 提供状況は、セッションのスライドに “in preview now as part of OCI GoldenGate in Oracle Cloud, Azure and Google Cloud” と書かれていた。東京リージョンの OCI コンソールには「データ・ファブリック」タブが表示されている。詳細は公式の情報を確認いただきたい。
はじめに
OCI Top Partner Engineers 2026 の今井です。
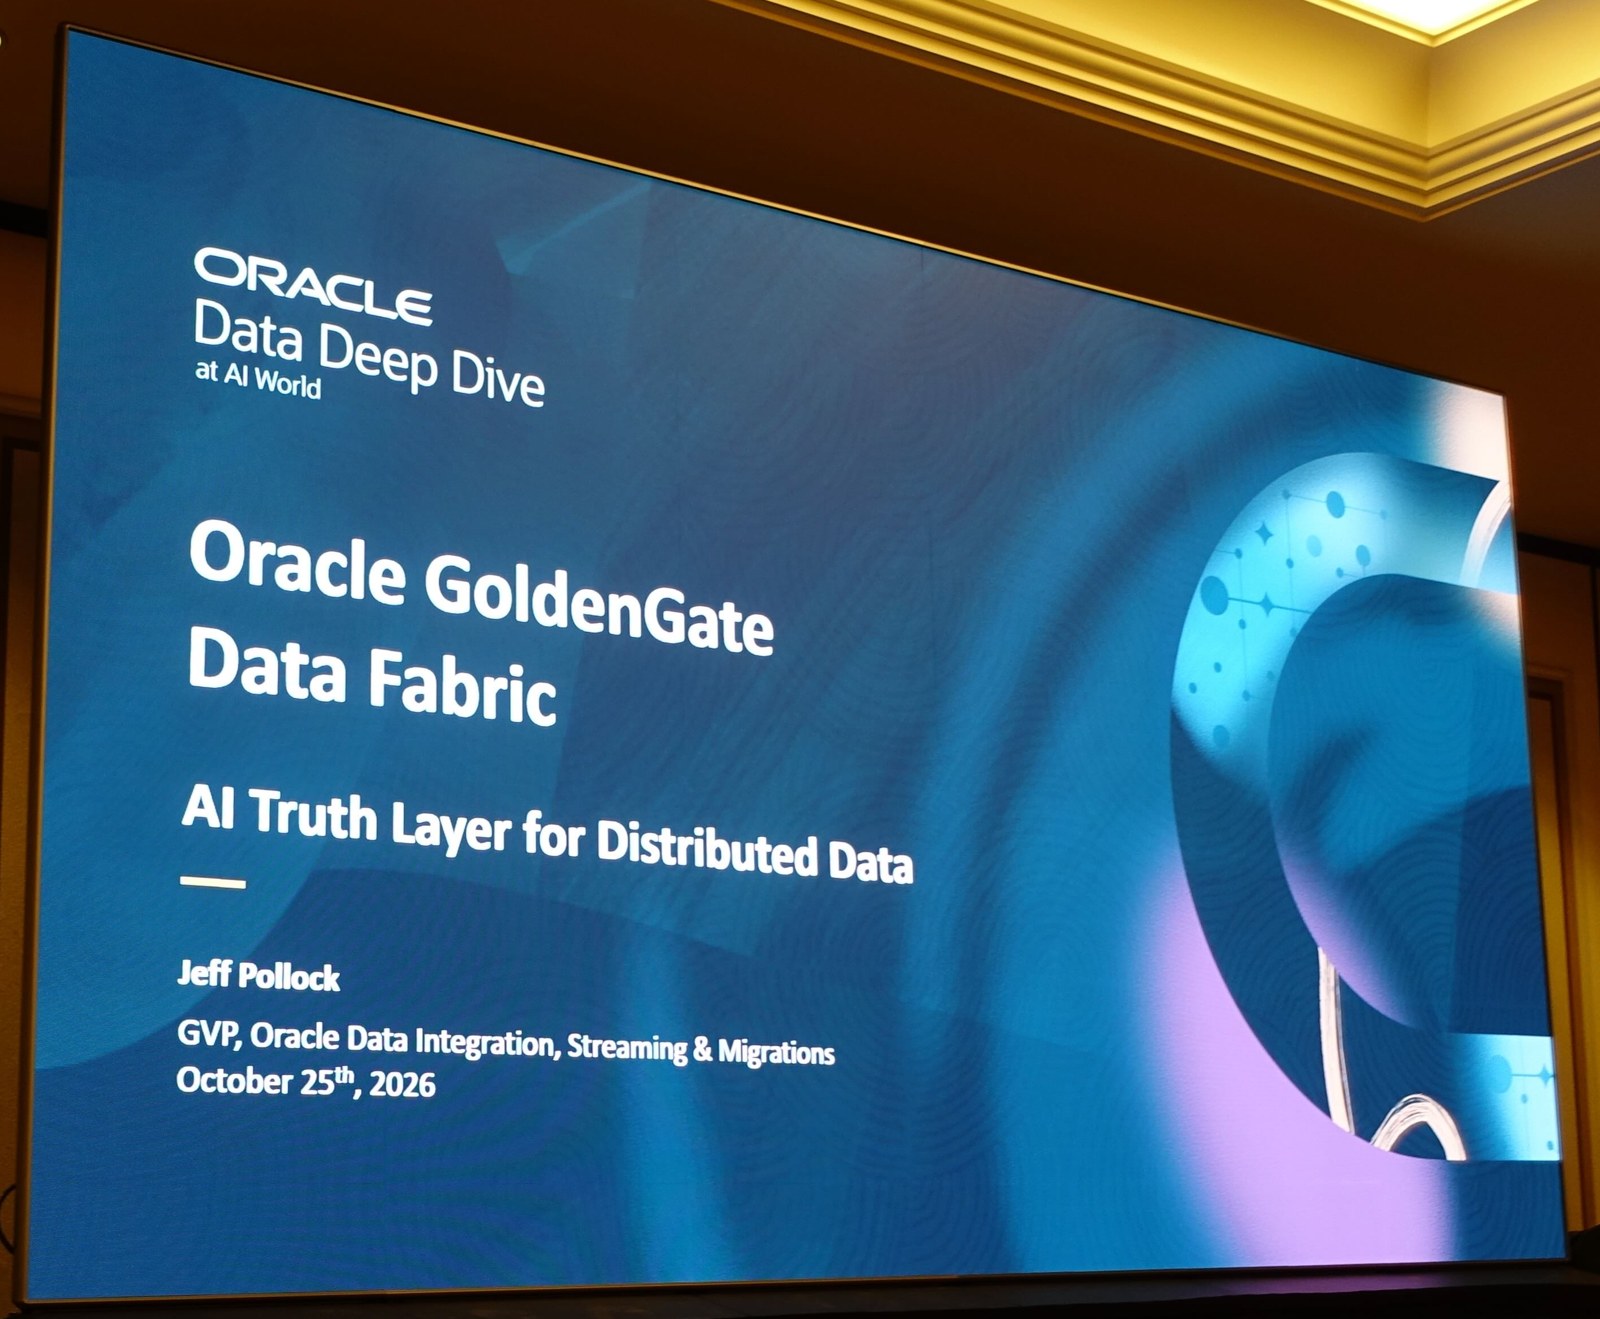
今週は Oracle AI World 2026 に参加するため、ラスベガスに来ている。2026年10月26日のセッション「Building a Data Fabric with GoldenGate, an AI Truth Layer for Data」(LRN6075)で、GoldenGate の新製品が発表された。登壇者は Jeff Pollock 氏(GVP, Oracle Data Integration, Streaming & Migrations)だ。本記事では、発表の要点を現地から速報する。
GoldenGate Data Fabric とは?
GoldenGate Data Fabric は、GoldenGate 製品群の新しい製品領域として発表された。基幹システムでコミットされたトランザクションを捕捉する基本はこれまでどおりで、その上に、捕捉したデータを分析や AI で使える形に整えて届ける機能を足した。
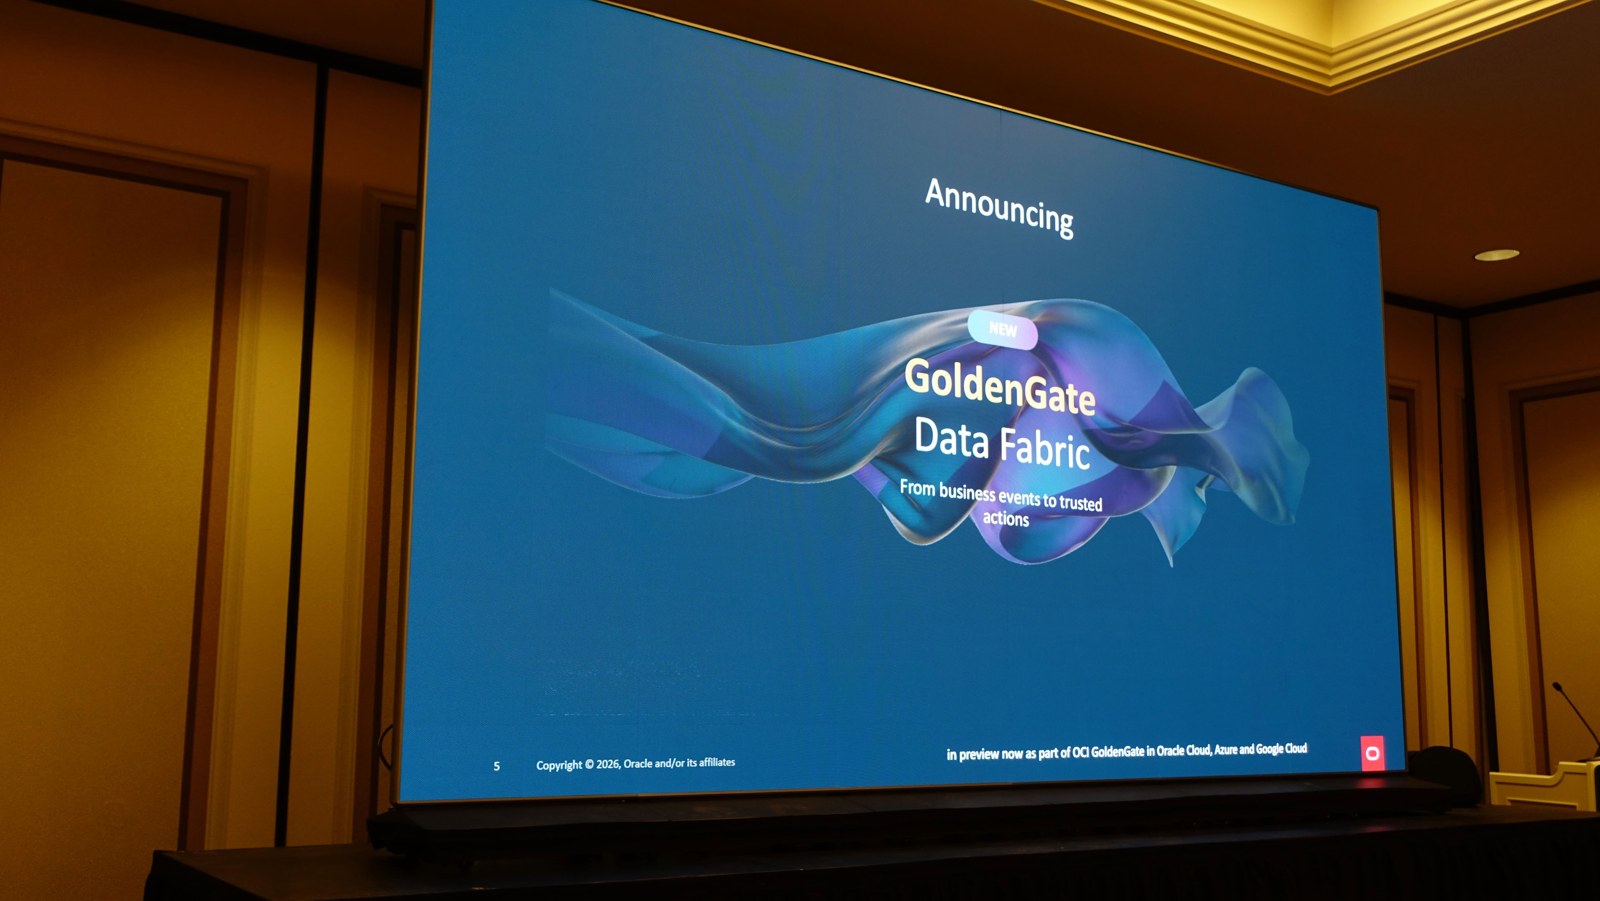
スライドでは、自らを “distributed truth layer for AI” と位置付け、Transactional Fidelity、Governance, Verification and Auditability、Curated AI-ready Data Products の3つの層で説明していた。
GoldenGate Data Fabric でできること
セッションで説明された内容を、利用者の目線でまとめると次のとおりだ。
| できること | 中身 |
|---|---|
| AI エージェントに最新のデータを渡す | 基幹システムでコミットされた変更を、運用データストアや RAG のベクトルストアなどを通じて、リアルタイムのデータを必要とする AI やエージェントにできるだけ簡単に渡す。登壇者は、新しく特に力を入れる分野だと説明した |
| 1つの UI で用途をまとめて作る | 移行、高可用性、マルチクラウド、分析への取り込みなど、代表的な7つの用途を、コマンドラインや別々のツールではなく、AI 支援付きの1つの UI で作れる |
| レシピから始める | パイプラインの作成時に、One-way Database Replication、Active-Active Database Replication、ZeroETL Mirror、Database Migration のレシピを選べる |
| 変換を画面と自然言語で組む | ローコードの画面でパイプラインを組める。スライドの画面では、AI Pipeline Designer の会話欄に指示を書いて変換を追加していた |
| 下流で加工する | Data Fabric のランタイムが、データレイクやクラウドのデータウェアハウスに処理を生成して実行させる。データベースとレイクハウスのどちらにも、Bronze / Silver / Gold のメダリオン構成を作れる。PII のマスキングもこの中で組める |
| 置き場所を選ぶ | 保存先(リレーショナル表か、Iceberg などのオープンなテーブル形式)、実行エンジン(Spark か SQL データベース)、カタログ(Oracle AI Data Catalog と他社のカタログ)を選べる |
| 既存の環境をまとめて見る | オンプレミスとクラウドの GoldenGate デプロイメントを登録し、Extract と Replicat を含む全体のトポロジーを1か所で見て管理できる |
この考え方を表す指標が commit-to-action latency で、基幹システムでのコミットから、信頼できる業務上の対応までの経過時間と定義されている。登壇者は、ETL のサイクルを待たずに、コミットの時点から最小の遅れで意思決定をするエージェントに届けることだと説明した。スライドには「ファブリックがなければ、エージェントは昨夜のバッチで動く」とある。
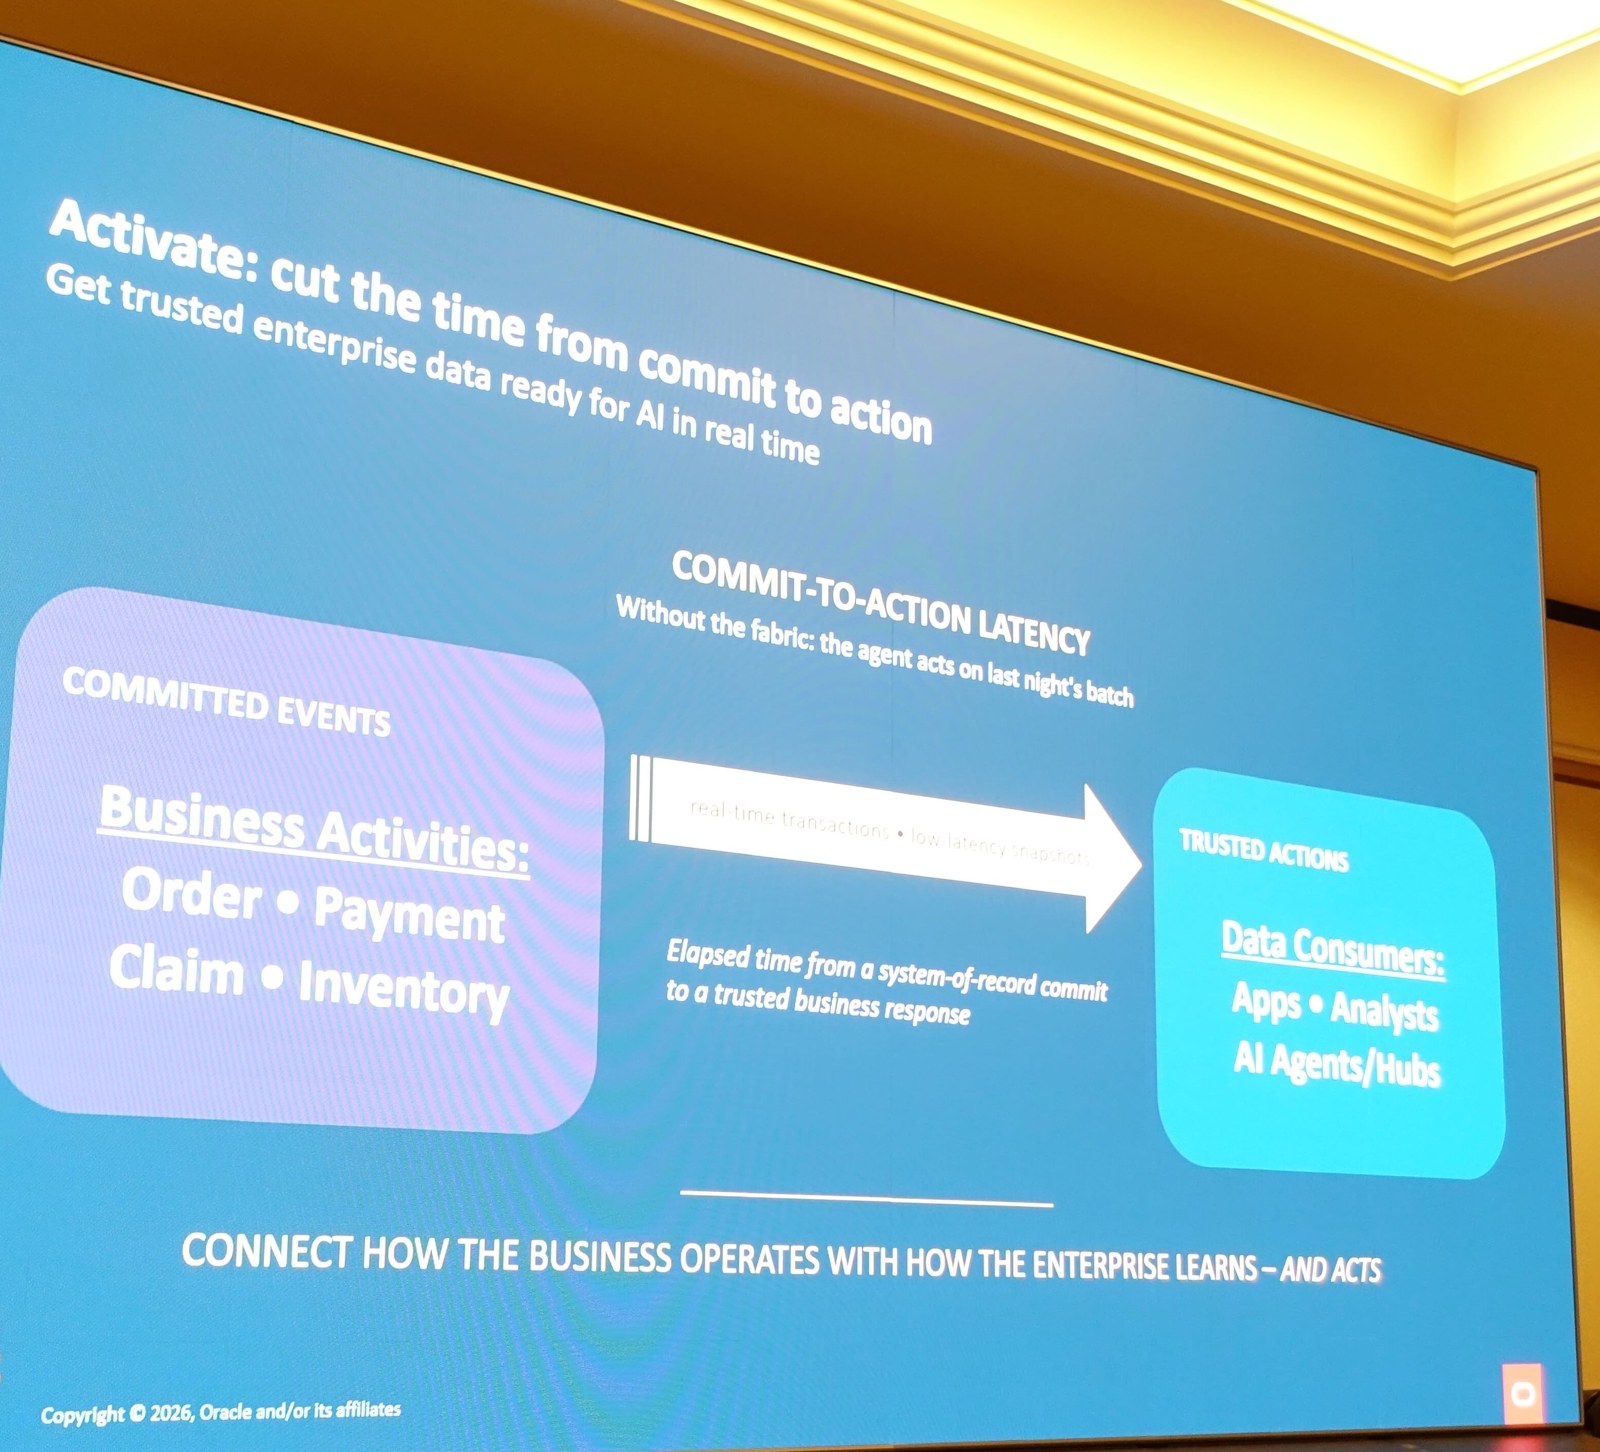
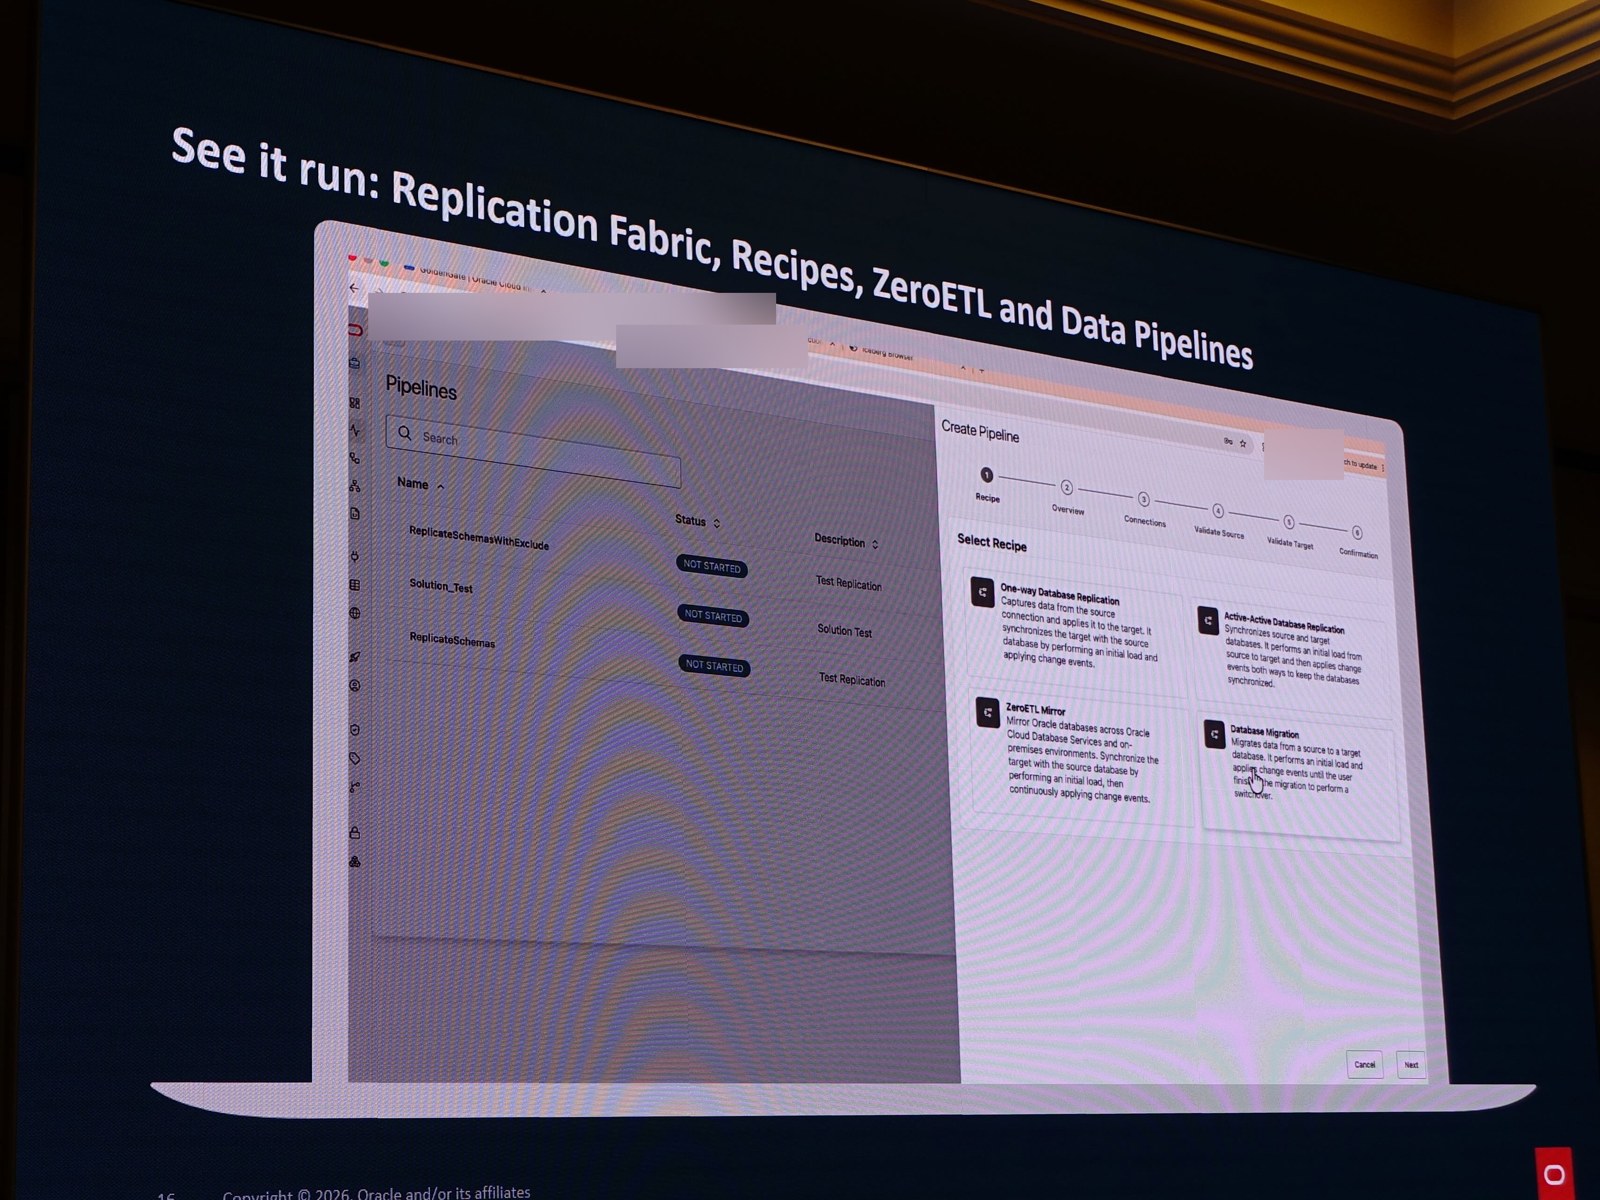
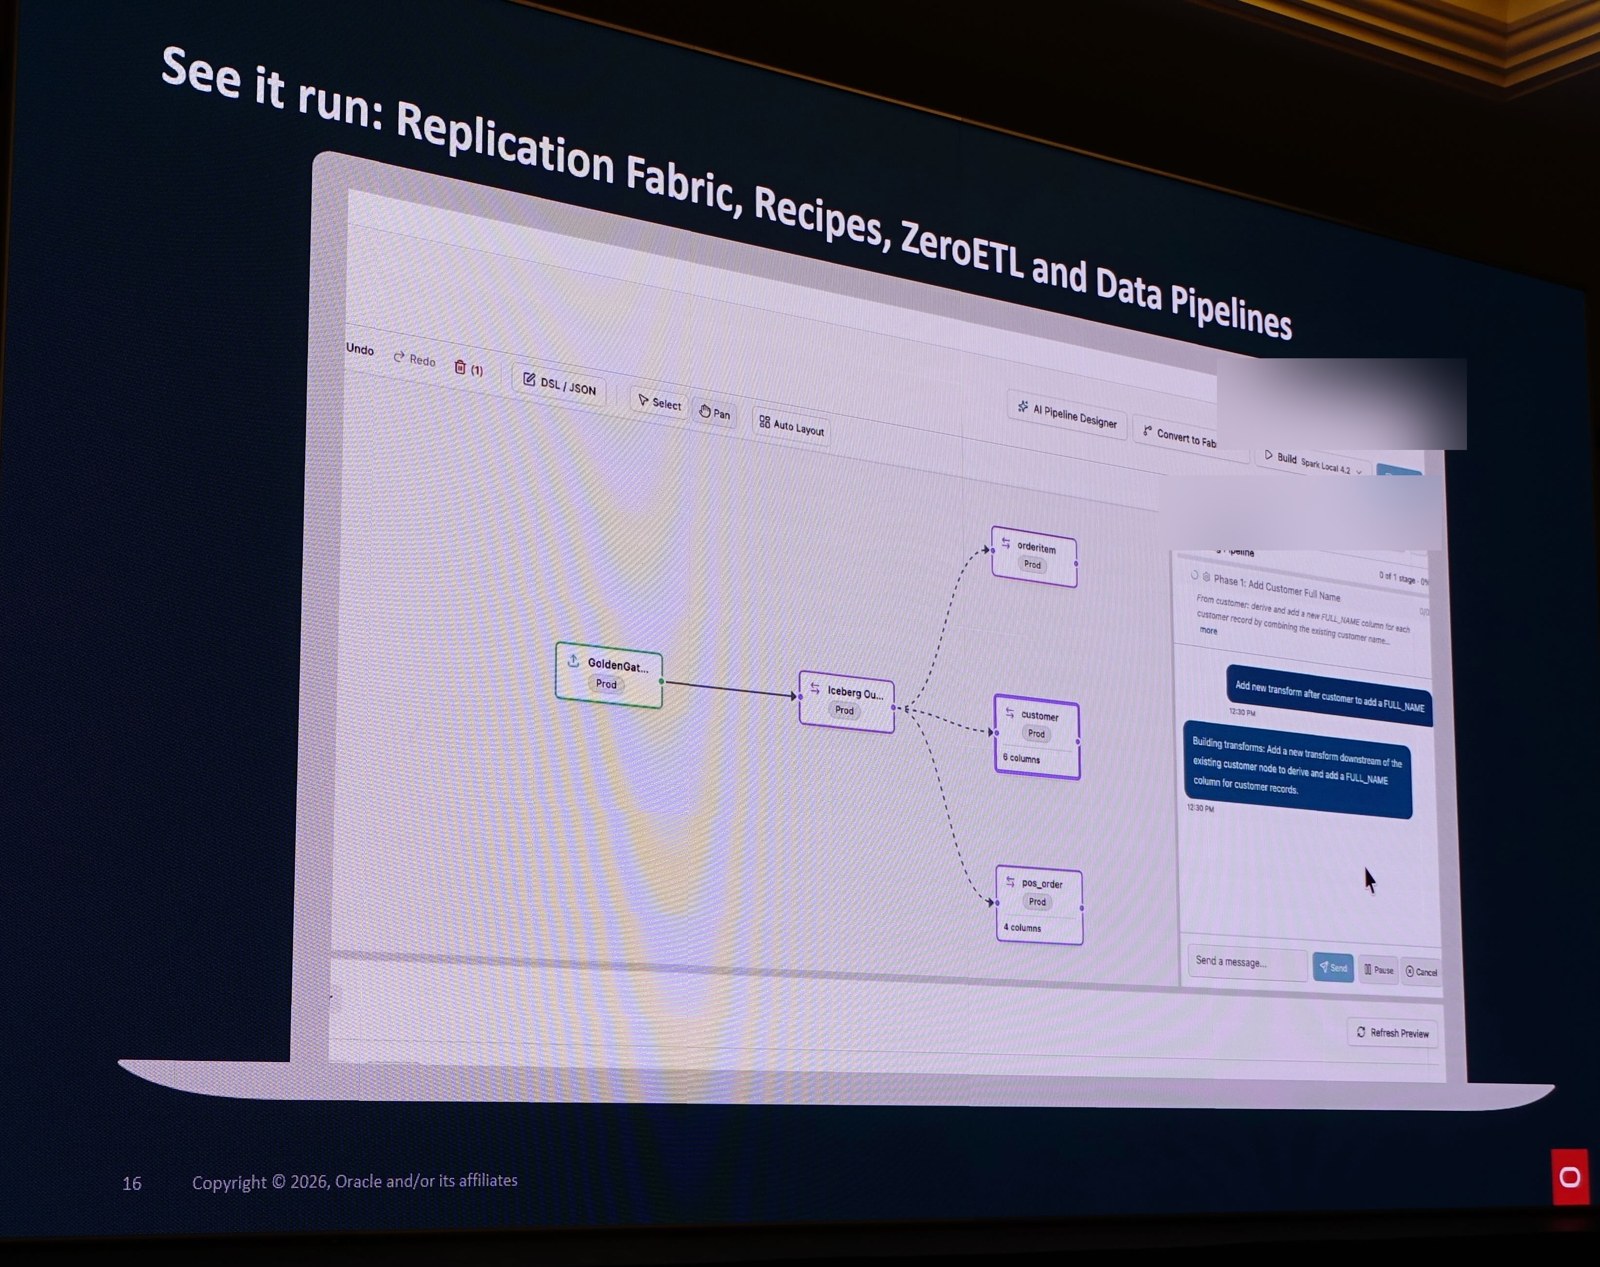
ここで重要なのは、変換の処理がレプリケーションの後段で動く点だ。これまでの低遅延のレプリケーションはそのままに、その先の加工を足せる。
私が東京リージョンの OCI コンソールを確認したところ、GoldenGate の画面に「データ・ファブリック」タブがあり、「ZeroETLミラー」の「パイプラインの作成」と「接続の作成」が表示されていた。スライドで見た画面がこのタブの先にあるかは確かめられていない。
発表のポイント
1. Operate / Activate / Optimize の3つの成果
GoldenGate Data Fabric が目指す成果は、Operate(ミッションクリティカルなデータを遅れなく正しく保つ)、Activate(コミットから業務上の対応までの時間を縮める)、Optimize(ワークロードを経済性で置く)の3つだ。
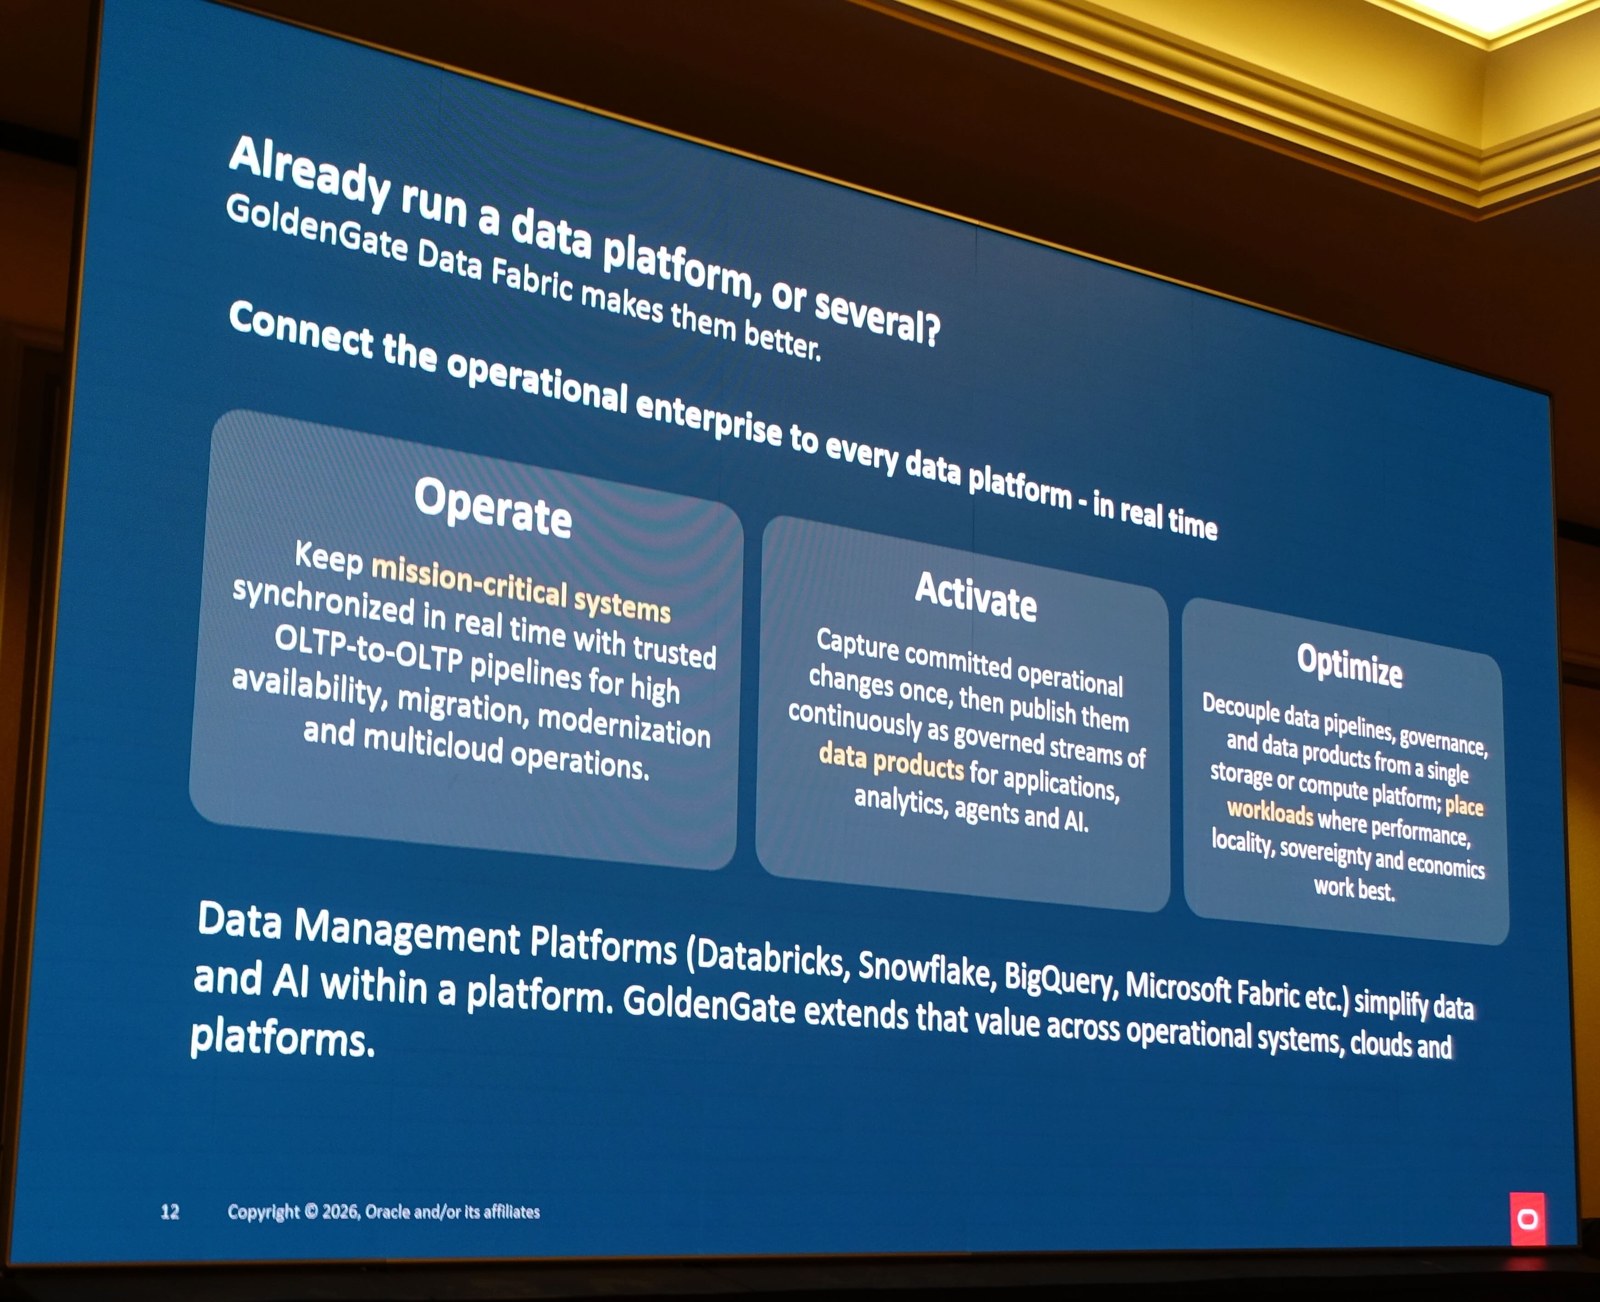
Optimize では、5つのマネージドなプラットフォームで同等の Spark パイプラインを比べた場合のコスト差が、約54%と示された。2026年9月時点の各社の公開オンデマンド定価をもとにした試算で、ベンチマークではなく実際のコストは異なるという注記が付いている。
2. プラットフォームが変わってもファブリックは残った事例
Fortune 100 の顧客の、20年にわたる変遷が紹介された。社名は非公開だった。この間、基幹システムは AWS 上のデータベースへの移行やオンプレミスへの回帰を、分析側は Teradata、Hadoop、オブジェクト・ストレージと Spark への移行を経たが、データを捕捉する層は一度も作り直されなかったという。
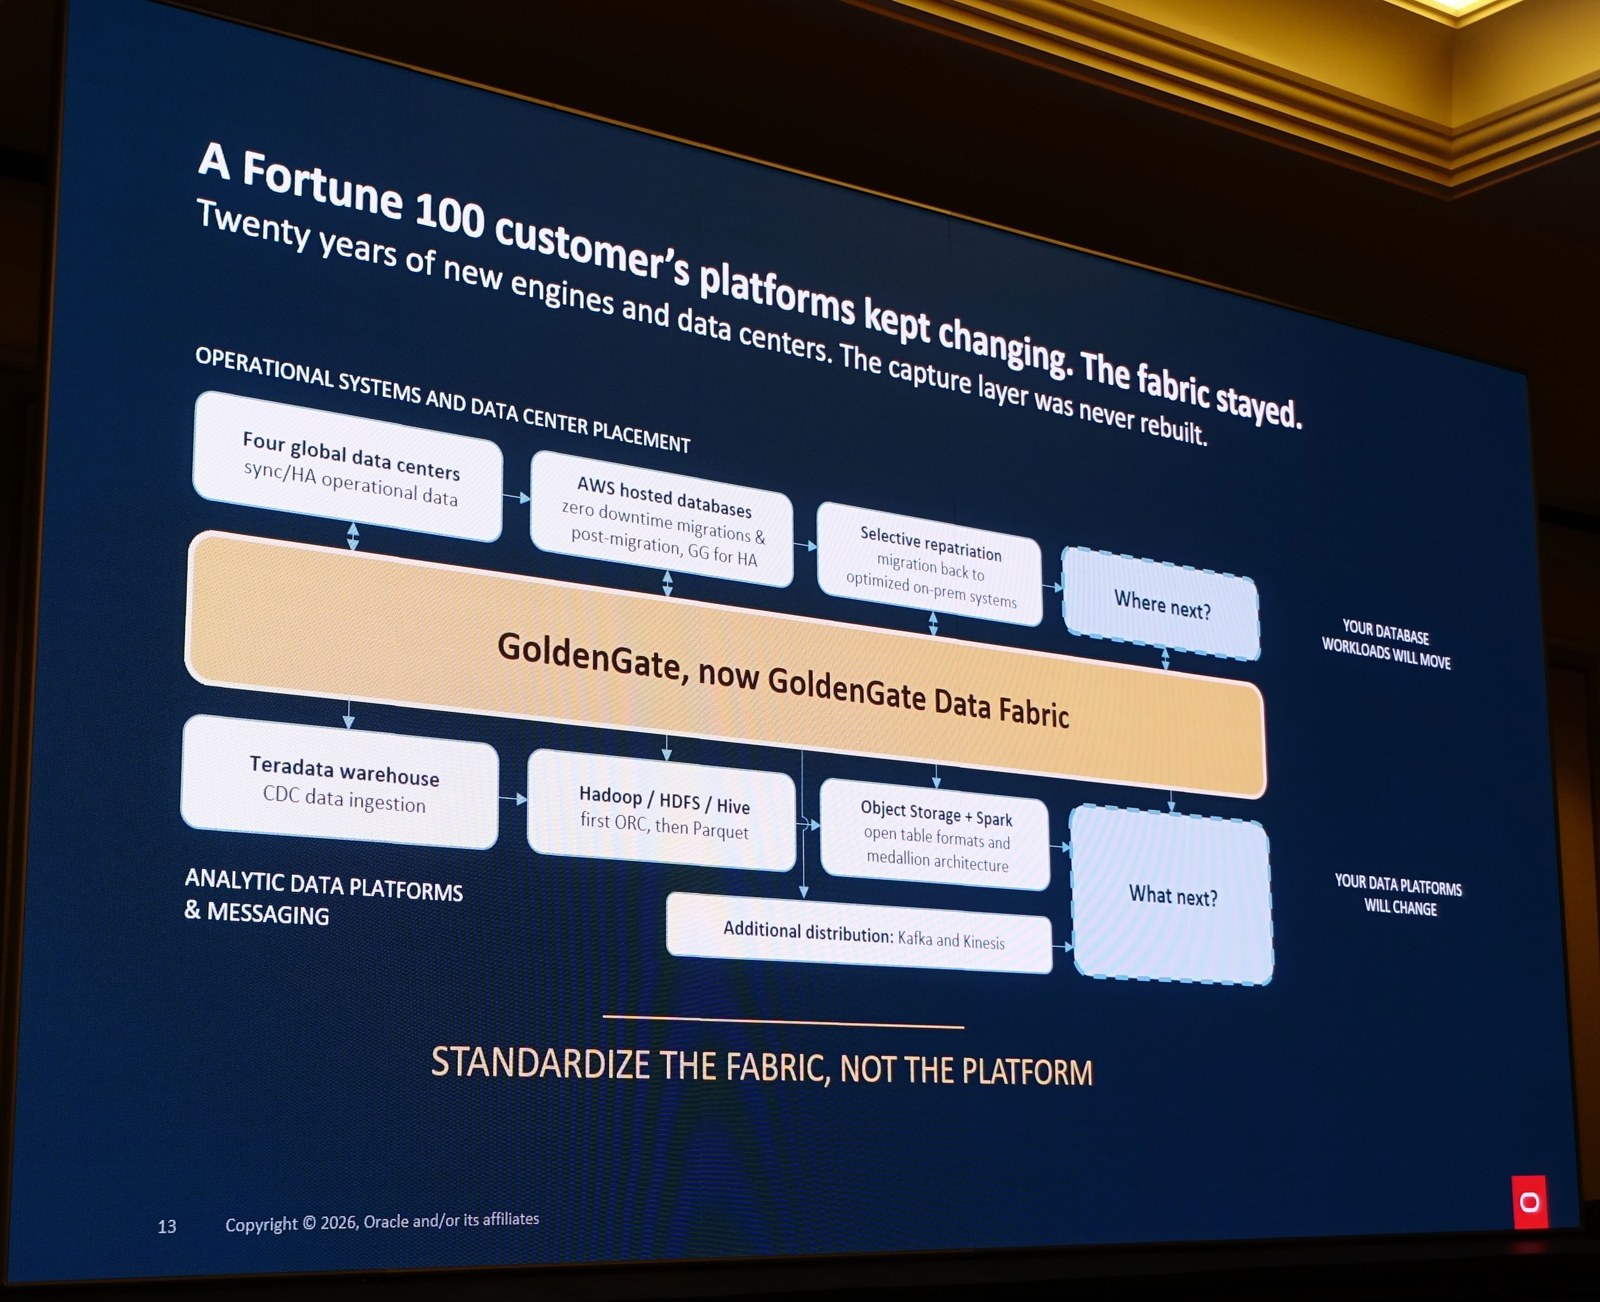
スライドの結びは “STANDARDIZE THE FABRIC, NOT THE PLATFORM” だった。
押さえておきたい制約・前提
セッションのスライドには “in preview now as part of OCI GoldenGate in Oracle Cloud, Azure and Google Cloud” と書かれていた。製品ページの FAQ には、リージョンごとの提供状況、エンドポイント、連携の組み合わせは、導入ごとに確認が必要とある。詳細は公式の情報を確認いただきたい。
考察
データプラットフォームやワークロード(アプリケーションなど)に最適な環境・プロダクトは、これから変わるスピードがどんどん速くなる。様々な生成 AI が台頭しては入れ替わっていることが、その象徴だ。
データウェアハウスやレイクハウスを乗り換えるたびにデータを取り出す仕組みまで作り直していると、作り直しが追いつかない環境は、やがて「負の遺産」「塩漬け」と呼ばれるようになる。データの捕捉と定義をファブリック側に置けば、プラットフォームを替えても取り出し側は残せる。Fortune 100 の事例は、その実例だ。ただし、今度はファブリック自体への依存が生まれるので、他社のカタログを組み込める点などがその依存をどこまで和らげるかは、導入前に見極める必要がある。
次にデータ基盤の乗り換えを検討する案件があれば、まずデータの捕捉の層を GoldenGate Data Fabric に寄せられるかから確かめたい。
参考
- New GoldenGate Data Fabric: trusted AI starts with the data that runs your business(Oracle ブログ):https://blogs.oracle.com/dataintegration/new-goldengate-data-fabric-trusted-ai-starts-with-the-data-that-runs-your-business
- Oracle GoldenGate Data Fabric(製品ページ):https://www.oracle.com/integration/goldengate/datafabric/
 簡単30秒