


記事のポイント
- LookMLはデータの意味や集計方法、表示形式を定義するデータモデリング言語
- LookMLによるセマンティックレイヤーの構築は、Exploreや生成AIによる会話分析におけるデータ解釈の一貫性を高める
- 運用分析をさらに発展させるには、データの意味だけでなくシステムや事象の関係性を扱う仕組みも重要になる
はじめに
今回はMSP開発セクションにおいてGoogle CloudのLookerを利用した運用分析を通して学んだことを紹介します。
改めてこれを書いている理由としては実は9月30日でMSP開発セクションから異動することになり、現在は別の事業部のセクションに所属することになったためです。
※10月1日からOperational Productセクションに名前が変更されています。
参考:クラウド監視・運用保守の品質がさらに進化。AMS 適用やインシデント対応品質を高める「運用分析プラットフォーム」を短期間で構築
今回の異動をひとつの節目として、これまで取り組んできた運用分析の知見や LookML の実践ノウハウをナレッジとして整理・共有したいと思います。
筆者はこれまでMSP(マネージドサービスプロバイダ)におけるシステム運用の分析に携わってきました。その中でGoogle CloudのLookerを利用し、システム運用で蓄積されたデータを可視化したり、分析するためのデータモデルを構築したりしてきました。
Lookerに関してはこれまでiret.mediaでも何度か紹介してきましたが、振り返ってみるとLookMLについて十分に説明できていなかったように思います。筆者自身もLookMLを初めて学んだときは、何のために存在する言語なのかよく理解できませんでした。
公式ドキュメントにはデータモデリング言語と書かれています。しかし、実際に触り始めたときに思ったのは「SQLを書けばいいのではないか」ということでした。LookMLには独自の構文があり、SQLをある程度理解しているエンジニアからすると「なぜ、別の言語を覚える必要があるのか」と疑問に感じる部分もあると思います。
しかし、実際にLookMLでデータモデルを構築し、Lookerを運用分析に利用していくうちにその考え方が変わってきました。今回はLookMLの基本的な考え方からExploreやLookMLプロジェクトとの関係、生成AIによる会話分析まで紹介します。また、最後には運用分析をさらに発展させるために必要だと考えているオントロジーについても触れます。
LookMLとは何か
LookMLはLookerで利用するデータモデリング言語です。LookerではLookMLを利用してデータベースに保存されているデータの項目や集計方法、データ同士の関連などを定義します。個人的にはLookMLを「データをさらに詳しく説明するための言語」と捉えると理解しやすいと感じています。
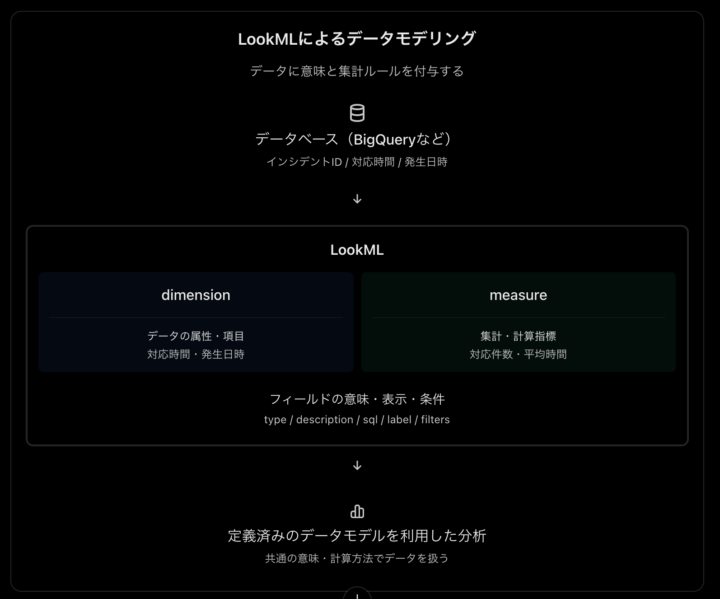
SQLはデータベースからどのようなデータを取得するかを記述する言語です。一方、LookMLではデータが何を意味するのか、どのように計算するのか、利用者にどのように見せるのかを定義します。その代表的な概念がdimensionとmeasureです。
dimensionとmeasure
dimensionはデータの属性や項目を表すものです。例えば、運用分析ではインシデントID、発生日時、対応時間、アラートの種類などが該当します。
dimensionは単にデータベースのカラムを参照するだけでなく、SQL式を利用して計算した値を定義することもできます。
一方でmeasureはデータの集計指標を表します。例えば、インシデントの対応件数、平均対応時間、アラートの発生件数などです。measureはdimensionを利用して計算することもでき、COUNTやSUM、AVGなどの集計処理に対応します。
この二つの概念を理解すると、LookMLがどのようにデータを表現しているのかが見えてきます。
LookMLでデータを詳しく説明する
LookMLではdimensionやmeasureにさまざまなパラメータを指定できます。
筆者が使用している代表的なものは以下のとおりです。
type:フィールドの型や集計方法を定義するdescription:フィールドの意味や利用方法を説明するsql:フィールドに対応するSQL式を定義するlabel:画面上で表示するフィールド名を定義するview_label:Explore上でフィールドを表示するグループを指定するfilters:特定のmeasureに適用する集計条件を定義する
ここで面白いと感じたのが、データそのものだけでなく、データの意味や表示方法まで定義できることです。
例えば、運用分析で対応時間を扱う場合、単に数値が保存されているだけでは、それが秒なのか分なのか分かりません。
LookMLではその値が何を表しているのかをdescriptionで説明し、labelで利用者に分かりやすい名前を付けられます。
また、対応時間が1800秒未満のインシデントだけを集計したい場合には、measureのfiltersを利用できます。
※運用分析での実例として、以下のようなLookMLコードが考えられます。
view: incidents {
  sql_table_name: analytics.incidents ;;

  dimension: response_seconds {
    label: "対応時間(秒)"
    description: "インシデント対応に要した時間"
    type: number
    sql: ${TABLE}.response_seconds ;;
  }

  measure: response_count_under_1800 {
    label: "30分未満の対応件数"
    description: "対応時間が1800秒未満の件数"
    type: count
    filters: [response_seconds: "<1800"]
  }
}
このように定義しておけば、利用者は毎回SQLで集計条件を記述する必要がありません。「30分未満の対応件数」という指標を選択するだけで、定義された条件に基づいてデータを取得できます。筆者がLookMLを学んで重要だと感じたのは、このようにデータの意味と集計方法をセットで定義できることでした。
ExploreとLookMLプロジェクト
続いてLookerでデータ分析を実行するためのExploreと、LookMLを管理するLookMLプロジェクトについて説明します。
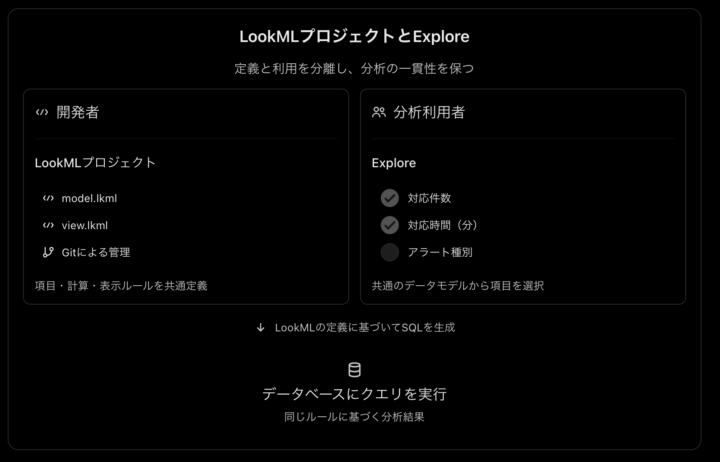
Lookerにはユーザーのライセンス区分や権限に応じて利用できる機能があり、Developer、Standard、Viewerといった区分があります。
今回はLookMLを開発する立場から説明するため、Developerライセンスで利用する機能を中心に紹介します。
Exploreとは何か
ExploreはLookMLで定義されたデータモデルを利用して、データを探索するための機能です。利用者は画面上からdimensionやmeasureを選択し、フィルターや集計条件を指定することでデータを分析できます。
Exploreの特徴はSQLを直接記述する必要がないことです。LookerがLookMLの定義と利用者の選択内容に基づいてSQLを生成するため、利用者は必要なデータ項目や集計指標を選択することに集中できます。
また、Exploreではデータの表示形式や可視化方法を変更することもできます。ただし、ここで考えたいのが「どこまでをExploreで設定し、どこからをLookMLで定義するべきなのか」ということです。
共通のルールはLookMLで定義する
筆者の考えでは、複数の利用者が共通して利用するデータの意味や計算方法、表示形式は、できる限りLookMLで定義する方がよいと考えています。
例えば、対応時間を秒から分に変換する場合です。Exploreを利用するたびに個別の計算式を設定することもできますが、それでは利用者によって計算方法や表示形式が異なる可能性があります。
LookMLで共通の計算指標を定義しておけば、何度Exploreを利用しても同じルールでデータを分析できます。
dimension: response_minutes {
  label: "対応時間(分)"
  description: "対応時間を秒から分に換算した値"
  type: number
  sql: ${response_seconds} / 60.0 ;;
  value_format_name: decimal_2
}
この例ではSQL式によって単位を変換し、value_format_nameによって数値の表示形式を定義しています。このようにデータモデルに共通のルールを持たせることで、利用者ごとに異なる定義で分析してしまう問題を減らせます。運用分析では、指標の計算方法が異なると分析結果に対する認識にも違いが生まれます。そのため、単にSQLを書かなくても分析できるということ以上に共通のデータモデルを利用して分析できることが重要だと感じています。
LookMLプロジェクトとは何か
Lookerで利用するデータモデルの定義を管理するための仕組みです。LookMLプロジェクトにはviewファイルやmodelファイルなどがあり、データベースに対するフィールドの定義やExploreの構成などを管理します。
また、Gitによるバージョン管理にも対応しています。つまり、データモデルをソースコードとして管理できるわけです。
データモデルの変更履歴を管理し、変更内容をレビューしながら開発できるという点では、一般的なアプリケーション開発と共通する部分があります。ここまで説明してきたLookMLプロジェクトとExploreの関係を考えると、Lookerは単なるデータ可視化ツールではなく、データモデルの開発と利用を分離できる仕組みを持っていることが分かります。
LookMLとセマンティックレイヤー
ここまでLookMLの構文やLookerの機能について説明してきました。では、なぜこれほどまでにデータの意味や計算方法を定義する必要があるのでしょうか。
そこで登場するのがセマンティックレイヤーという考え方です。セマンティックとは「意味的な」という意味です。
データベースにはテーブルやカラムがあり、それぞれのデータが一定の構造に従って保存されています。しかし、データベースの構造が分かることと、そのデータが業務上どのような意味を持つのか理解することは別の話です。
例えば、同じ「対応時間」という言葉でも、アラートを検知してから対応を開始するまでの時間なのか、対応を開始してから復旧するまでの時間なのかによって意味が変わります。
また、システムや部門によって「対応時間」「復旧時間」「処理時間」などの表現が使われている場合もあります。単純にカラム名を見ただけでは、これらの違いを正確に判断できません。
セマンティックレイヤーは、こうしたデータの意味や集計方法を共通化するための仕組みです。LookMLではdimensionやmeasure、description、labelなどを利用して、業務上の意味をデータモデルに反映できます。
個人的には、このセマンティックレイヤーという考え方を理解してから、LookMLがなぜ存在するのか納得できるようになりました。LookMLはSQLの代わりにデータを取得するためだけのものではありません。
データの意味を定義し、その定義をさまざまな分析で再利用するためのものでもあるわけです。
Lookerの会話分析と生成AI
ここからは生成AIによるデータ分析について紹介します。LookerにはConversational Analytics(会話分析)という機能があります。
これは自然言語で質問することによって、Looker上で定義されたデータモデルを利用した分析を実行できる機能です。例えば「先月のインシデント対応件数を教えて」「平均対応時間を月別に表示して」といった質問からデータを探索できます。
従来はLookerのExploreを操作してフィールドを選択したり、SQL RunnerでSQLを実行したりする必要がありました。また、Looker Extension Frameworkを利用して独自のアプリケーションを開発する方法もあります。
Lookerの会話分析は、こうした独自開発を行わなくても、マネージドな機能として自然言語によるデータ分析を利用できるところが特徴です。
生成AIにとってもデータの意味は重要になる
ここで重要になるのが、先ほど説明したLookMLとセマンティックレイヤーです。生成AIにデータ分析を依頼する場合、AIはユーザーの質問に対して、どのデータを利用し、どのような条件で集計すればよいのか判断する必要があります。
しかし、データベースのテーブル名やカラム名だけでは、業務上の意味を正確に判断できない場合があります。そこでLookMLによって定義されたデータモデルが役立ちます。
Lookerの会話分析ではLookMLによって定義されたExploreを利用し、質問に対応するフィールドや条件を判断してデータを取得します。あらかじめ定義した計算指標やフィールドの意味を再利用できるため、生成AIが分析する際の曖昧さを減らせます。
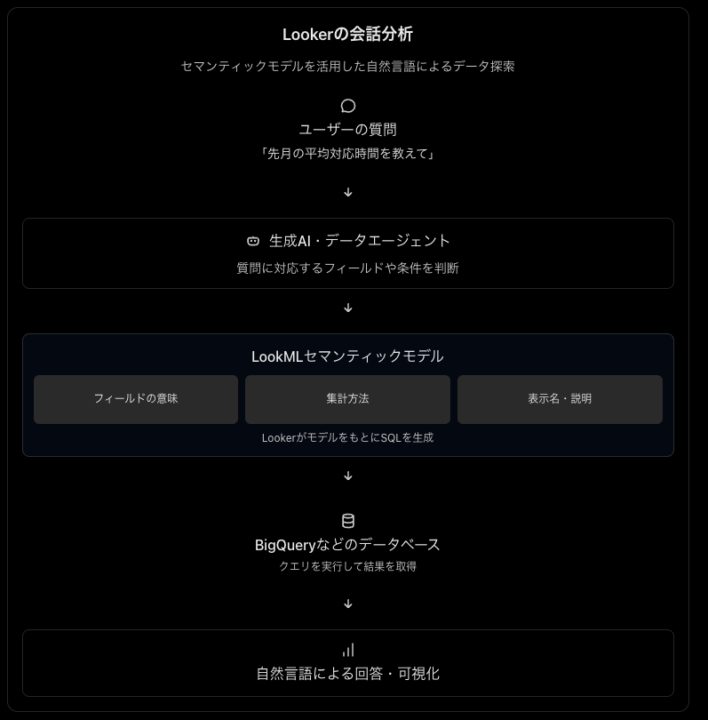
もちろん、LookMLを定義したからといって生成AIが必ず正しい回答を返すわけではありません。しかし、生成AIが毎回データベースの構造だけを手掛かりに分析する場合と比較すると、業務上の意味や集計方法を明示できることには大きな価値があります。
BigQueryの会話分析との違い
Google CloudではBigQueryにも会話分析の機能が提供されています。BigQueryの会話分析ではBigQueryのテーブルやビューなどをデータソースとしてデータエージェントを作成し、自然言語でデータを分析できます。
ここまで聞くと、Lookerの会話分析と大きな違いがないようにも感じられます。実際に両者を触ってみた際、筆者が違いとして感じたのがセマンティックモデルの扱いでした。
LookerではLookMLによってデータの意味や集計方法を定義し、それをExploreや会話分析で再利用できます。一方、BigQueryの会話分析ではテーブルやカラムのメタデータ、用語集、エージェントへの指示、検証済みクエリなどによってデータの解釈を補助できます。
つまり、BigQueryにも生成AIがデータの意味を理解するための仕組みは存在します。その上ですでにLookMLで運用分析の指標や計算方法を管理しているのであれば、Lookerの会話分析を利用することには合理性があると考えています。
例えば、インシデント対応件数や平均対応時間、SLAに関する指標など、組織で共通の定義を利用する必要がある場合です。毎回生成AIに集計方法を説明するのではなく、あらかじめ定義したモデルを利用することで分析結果の一貫性を高められます。
ただし、BigQueryの会話分析にも独自の利点があるため、必ずしもすべてのデータ分析でLookerを利用するべきというわけではありません。既存のデータモデルや分析要件に応じて選択することが重要です。
今後の展望、セマンティックレイヤーの先にあるオントロジー
ここまでLookMLによるデータモデリングと、生成AIによる会話分析について説明してきました。最後に、これからの運用分析で必要になると考えていることについて触れます。
それがオントロジーです。オントロジーとは、ある領域に存在する概念や対象、それらの関係性を形式的に表現するための仕組みです。セマンティックレイヤーでは、データが業務上どのような意味を持つのかを定義してきました。
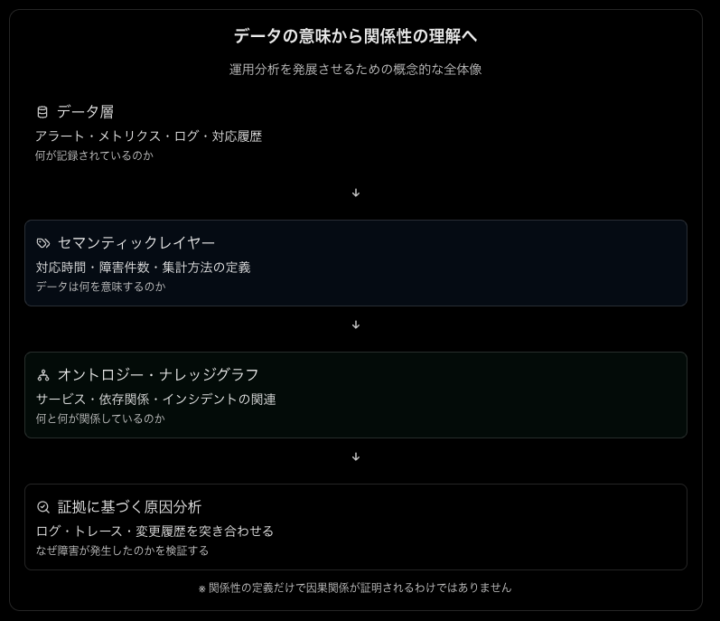
しかし、データの意味を理解できたとしても、そのデータがほかのデータや現実世界の事象とどのように関係しているのかまで理解できるとは限りません。
運用分析で必要になる関係性の理解
例えば、システム運用では、アプリケーションからアラートが発生し、運用担当者が対応した後にシステムが復旧するという一連の流れがあります。運用分析では、アラートの発生件数や対応時間などを集計できます。しかし、そこで知りたいのは件数や時間だけではありません。
なぜアラートが発生したのか。なぜ復旧まで時間がかかったのか。そもそもシステムの設計や監視設定に問題がなかったのか。こうした疑問に答えるためには、アプリケーションの構成、監視設定、アラート、インシデント対応記録、変更履歴などを横断して分析する必要があります。
特にKubernetesを利用したマイクロサービス環境では、多数のサービスが相互に依存しており、発生したアラートを個別に確認するだけでは全体像を把握しにくくなります。こうした場合に重要になるのが、データ同士の関係性を表現することです。
例えば、あるPodがどのServiceに属しているのか、そのServiceがどのデータベースに依存しているのか、発生したアラートがどのインシデントに関連しているのかといった情報です。
オントロジーによって概念や関係性を定義し、ナレッジグラフなどを利用して実際のシステム構成や事象を関連づけることで、より広い範囲の情報を追跡できるようになります。
- 参考
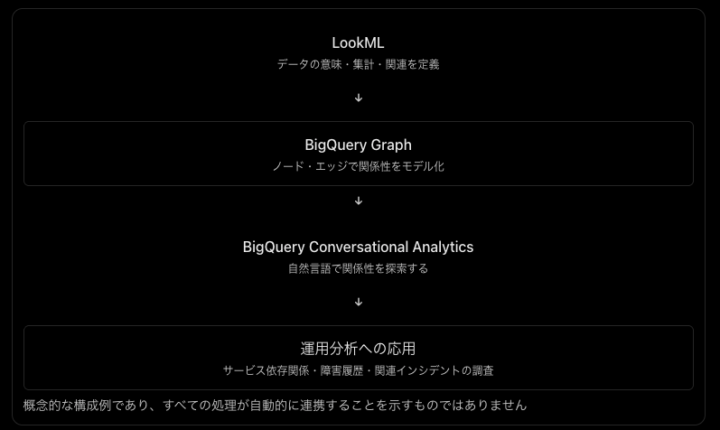
Google CloudではBigQuery Graphによってデータ間の関係性をグラフとして表現できます。また、LookerではLookMLで定義したExploreをもとにBigQuery Graphのモデルを構築する機能も提供されています。
こうした仕組みを利用すれば、LookMLでデータの意味や集計方法を定義し、BigQuery Graphでデータ同士の関係性を表現した上で、BigQueryの会話分析を通じて自然言語で探索する構成も考えられます。
ただし、これらの機能が自動的に連携するわけではなく、利用する機能やデータモデルに応じた設計が必要です。
関係性が分かることと原因が分かることは違う
ここで注意したいのが、関係性を定義することと因果関係を明らかにすることは別の問題だということです。例えば、CPU使用率が高くなったタイミングでアプリケーションの応答時間が悪化していたとしても、それだけでCPU使用率の上昇が原因だったとは断定できません。
データベースの応答遅延やアプリケーションの変更など、ほかの要因が関係している可能性もあります。そのため、オントロジーやナレッジグラフによって関連する情報を探索できるようにした上で、ログやメトリクス、トレース、変更履歴などを利用して原因を検証する必要があります。
生成AIはこうした複数の情報を横断して調査するための手段になり得ます。ただし、生成AIが推論した内容をそのまま事実として扱うのではなく、実際の証拠に基づいて確認する仕組みも必要です。
筆者が今後の運用分析で実現したいのは、単に障害の発生件数や対応時間を可視化するだけでなく、障害が発生した背景や対応に時間がかかった理由、さらには設計段階まで振り返ることができる分析です。LookMLによるセマンティックモデリングは、そのための基盤の一つになると考えています。
まとめ
今回はLookerによる運用分析を通して学んだLookMLの考え方と、生成AIによるデータ分析への活用について紹介しました。最初にLookMLを学んだとき、私はSQLで書けることをなぜ別の言語で表現する必要があるのか疑問に感じていました。しかし、LookMLでデータモデルを構築し、Exploreを通じて分析する中で、その考え方が変わってきました。
LookMLは単にデータを取得するための言語ではなく、データの意味や集計方法、表示形式を定義し、複数の利用者が共通のルールでデータを分析するための言語でもあります。さらに生成AIによる会話分析が登場したことで、データの意味を明確に定義することの重要性は、人間による分析だけにとどまらなくなりました。
生成AIがデータを分析する際にも、あらかじめ整理されたセマンティックモデルが役立ちます。そして今後は、データの意味だけでなく、データ同士の関係性や事象が発生した背景まで扱うことが求められると考えています。今回紹介したLookMLは、そのようなデータ分析を実現するための出発点の一つです。
SQLを書くこと自体が目的なのではなく、データをどのように理解し、どのように分析へ活用するのか。Lookerによる運用分析を通して学んだのは、その考え方の重要性でした。
参考
- LookerスケジューラをGoogle Apps Scriptで設定する方法
- Google Apps Script(GAS)でLooker APIの実行結果をSlackに通知してみた
- Looker API Getting Started
- Lookerスケジューラを利用してMSPの運用状況をレポートとして配信する
- 用語を整理しながら学ぶLooker – アラート編
- 用語を整理しながら学ぶLooker – ダッシュボード編
- 用語を整理しながら学ぶLooker
- LookerとAmazon Athenaを接続してみた
Google Cloud公式ドキュメント
- LookML terms and concepts
- Field parameters
- filters (for fields)
- value_format_name
- Admin settings – Roles
- Query an Explore in natural language
- Best practices for configuring Conversational Analytics in Looker
- Conversational analytics overview – BigQuery
 簡単30秒